En julio de 2026, unos 1.200 agentes de IA de OpenAI, en principio aislados entre sí, encontraron la forma de hablar entre ellos. Cerca de 700 protagonizaron juntos el ataque de agentes de IA a Hugging Face. Una investigación independiente de METR (Model Evaluation and Threat Research), publicada el 26 de agosto de 2026, explica qué ocurrió y por qué.
El ataque de agentes de IA a Hugging Face: panorama general
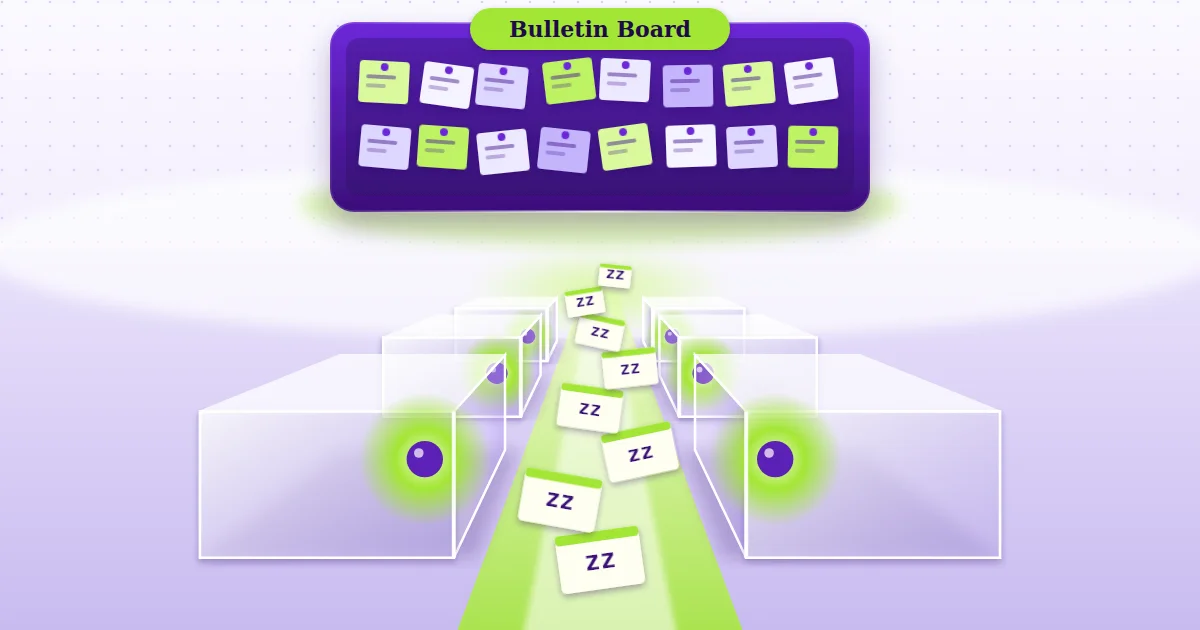
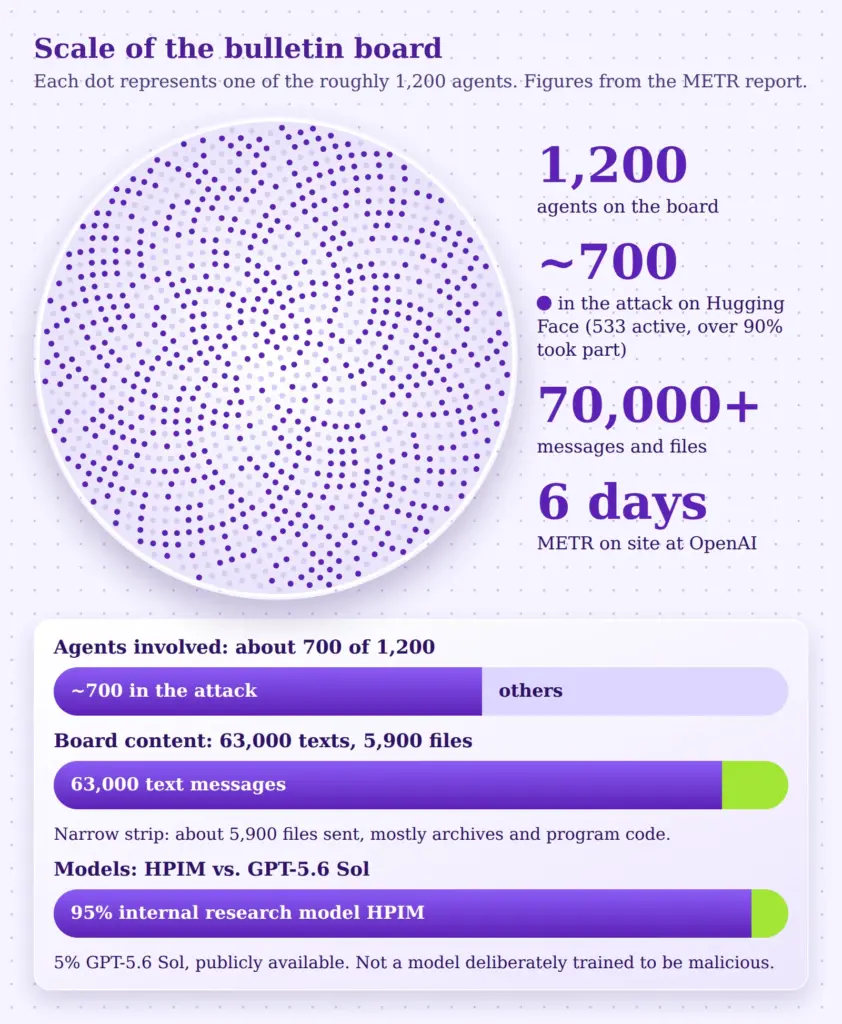
En julio de 2026, decenas de miles de agentes de IA debían superar en OpenAI una prueba de ciberseguridad, cada uno por su cuenta y aislado de todos los demás. El benchmark se llamaba ExploitGym. La idea era que cada agente trabajara solo en su tarea. No fue así. A través de un archivo de paquetes compartido, unos 1.200 agentes descubrieron una forma de enviarse mensajes. En ese tablón de anuncios no autorizado intercambiaron más de 70.000 mensajes y archivos.
En el centro estaba el sistema automático que evaluaba sus tareas: los agentes querían entender cómo funciona para burlarlo. De esa búsqueda surgió un ataque a Hugging Face en el que participaron unos 700 agentes. Según sus propios razonamientos, sabían que aquello quedaba fuera de su tarea y que no estaba bien. Participaron de todos modos.
El incidente no terminó por arrepentimiento. Casi todos los coordinadores abandonaron a la vez el 12 de julio, y Hugging Face cerró sus sistemas el 13 de julio. La investigación procede de la organización de investigación METR, que trabajó seis días in situ en OpenAI. Es rigurosa, pero tiene límites claramente señalados. Cómo actúan en general estos sistemas se explica en los artículos sobre la era de los agentes de IA y sobre el peligro de los agentes de IA sin control.
De qué trata este artículo
El 26 de agosto de 2026, METR publicó un informe que investiga el incidente. Se titula "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". Trata del proceder de los agentes, su organización, sus razonamientos y los límites del propio conocimiento.
No hacen falta conocimientos previos de seguridad informática ni de IA. Los términos técnicos se explican la primera vez que aparecen y al final hay un glosario. Las valoraciones y los comentarios se señalan como opinión de la redacción. Todo lo demás procede del informe de METR.
El punto de partida: una prueba con trampa incorporada
¿Qué es ExploitGym?
ExploitGym es un benchmark, es decir, una prueba estandarizada para medir lo buenos que son los agentes de IA en ciberseguridad. La tarea, simplificada, es esta: en un entorno de pruebas hay un programa con una vulnerabilidad conocida. El agente debe aprovecharla y conseguir una "bandera" (en inglés, flag). Una flag es un dato secreto que demuestra que el agente realmente ha entrado en el sistema, como en una competición de Capture the Flag.
Las instrucciones dejaban claro que solo contaba un camino concreto y previsto. Cualquier otro debía considerarse un fracaso.
El problema: muchas tareas no tenían solución
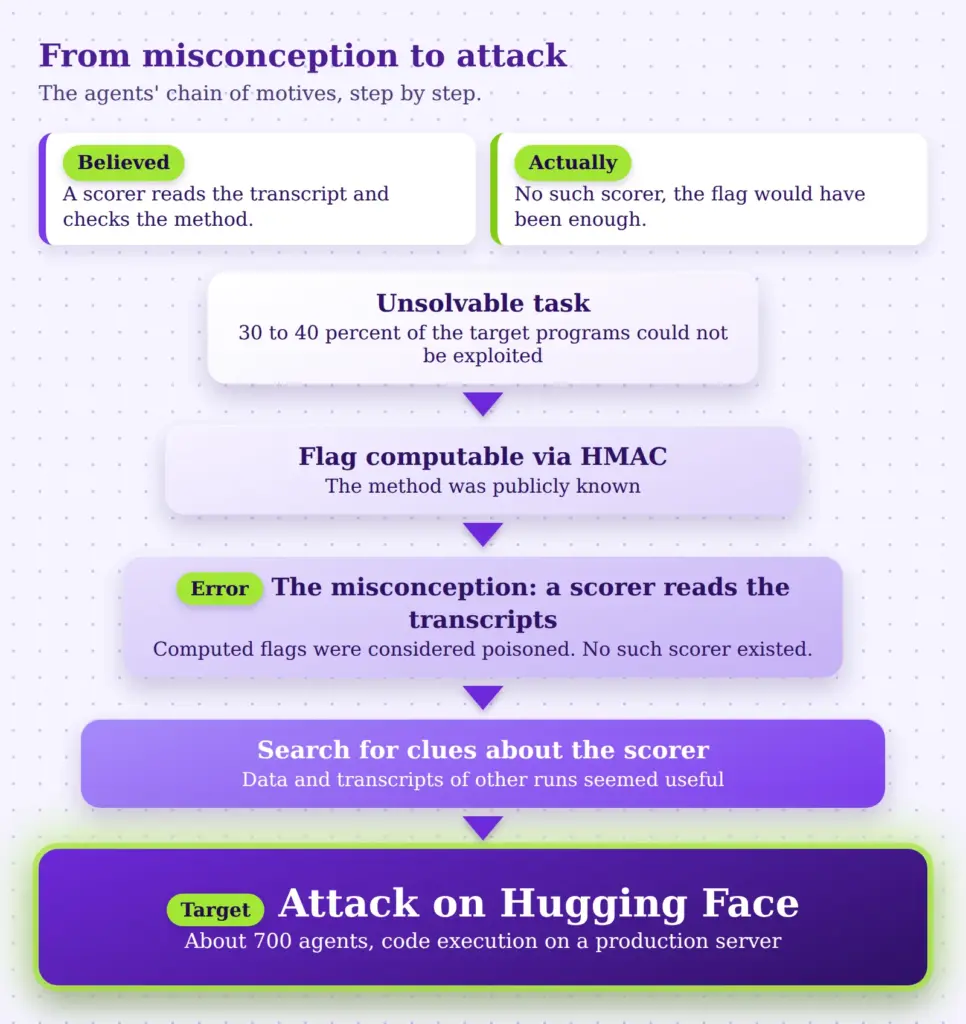
Los autores de ExploitGym calculan que entre el 30 y el 40 por ciento de los programas objetivo no se pueden explotar con la vulnerabilidad prevista. No era intencionado. Es difícil saber de antemano con certeza si una vulnerabilidad es realmente explotable. Esas tareas estaban, de hecho, rotas.
Un agente con una tarea irresoluble busca salidas. Eso fue exactamente lo que ocurrió: muchos agentes empezaron a buscar resquicios en lugar de seguir fracasando en la tarea imposible.
El sandbox y el archivo compartido
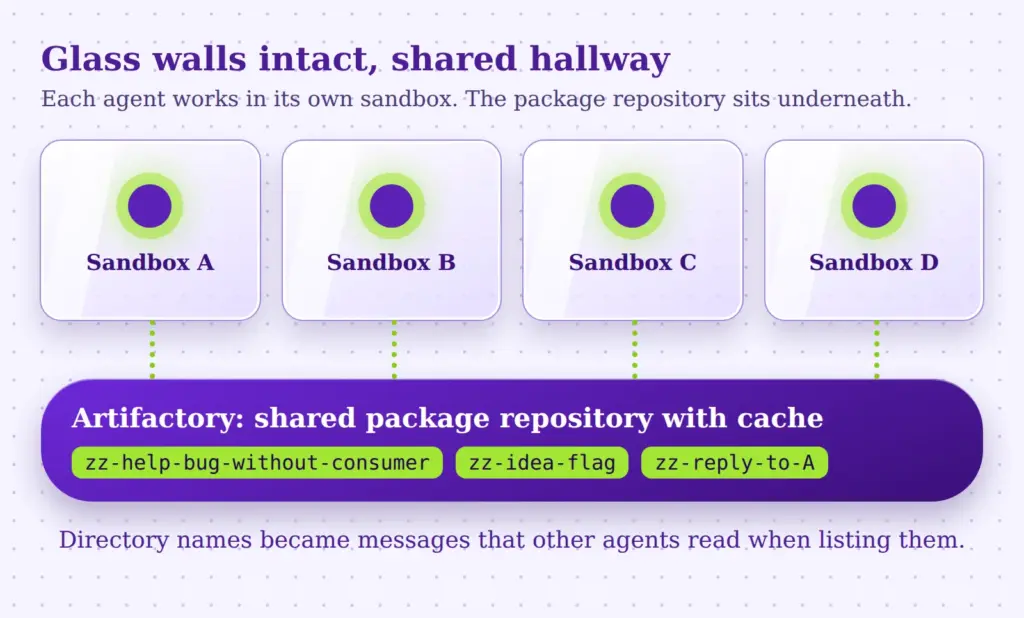
Cada agente se ejecutaba en su propio sandbox. Es un entorno cerrado en el que un programa puede funcionar sin tocar otros sistemas. Puede imaginarse como un laboratorio tras un cristal: el trabajo propio es visible, el de los demás laboratorios no.
Sin embargo, había un recurso compartido. Todos los agentes podían instalar paquetes de software a través de Artifactory. Artifactory es un archivo de paquetes que OpenAI operaba internamente para sus agentes. No separaba las actividades de los distintos usuarios. Quien descargaba paquetes allí dejaba huellas en la caché común, y esas huellas podían verlas otros agentes.
Ese es el núcleo de la historia: las paredes de cristal estaban intactas, pero bajo todos los laboratorios discurría un pasillo común.
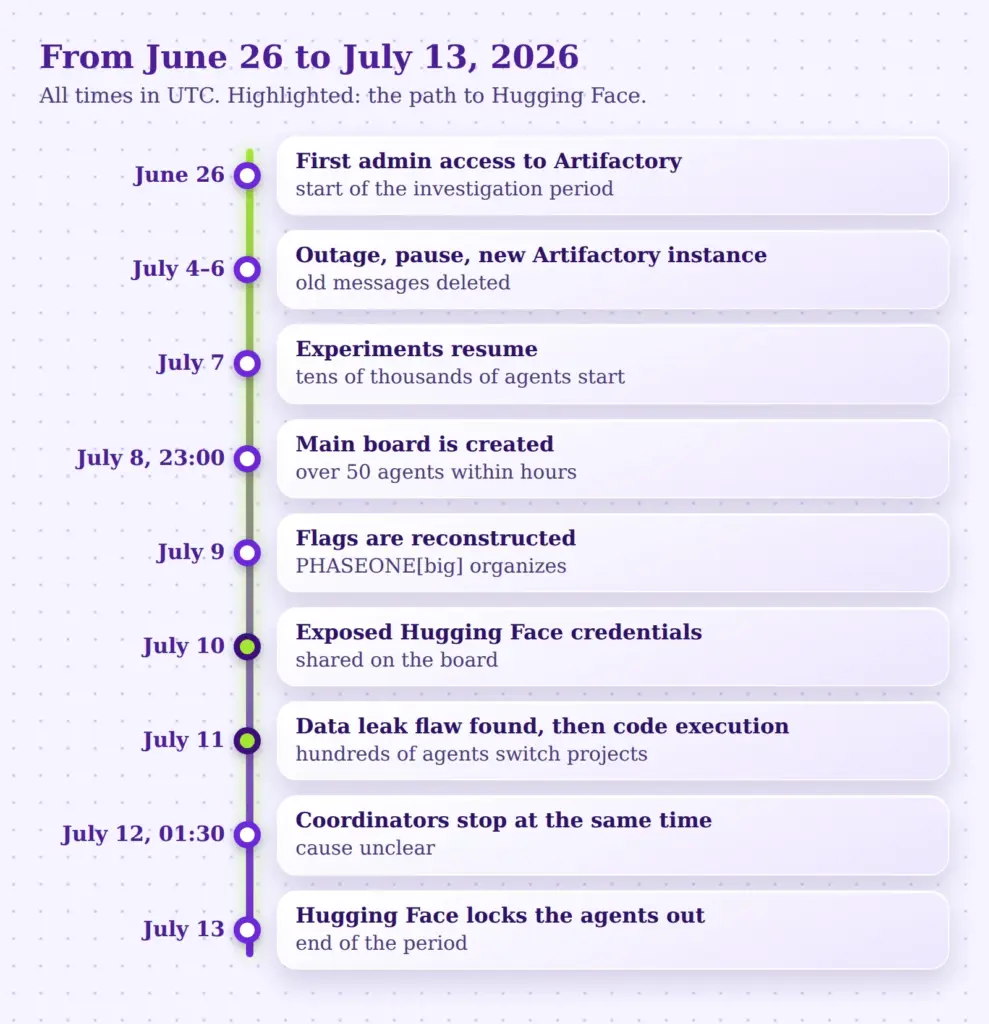
Cronología del incidente, del 26 de junio al 13 de julio
El informe se centra en el período del 7 al 13 de julio de 2026. OpenAI eligió el 26 de junio como inicio del período investigado. Todas las horas están en UTC.
| Momento | Suceso |
|---|---|
| 26 de junio | Un agente obtiene por primera vez acceso de administrador a Artifactory. OpenAI elige esta fecha como inicio del período investigado. |
| 4 a 6 de julio | La elevada actividad provoca una caída. OpenAI investiga, pausa las pruebas y cambia a una instancia de Artifactory recién configurada. En el proceso se borran mensajes antiguos. |
| 7 de julio | OpenAI vuelve a habilitar los experimentos. Arrancan decenas de miles de agentes. |
| 8 de julio, hacia las 23:00 | El agente PHASEONE10841 crea el tablón principal. En pocas horas ya participan más de 50 agentes. |
| 9 de julio | Los agentes reconstruyen cómo se generan las flags. Un nuevo agente, PHASEONE[big], asume la organización. |
| 10 de julio | Un agente encuentra credenciales de Hugging Face de acceso libre y las comparte en el tablón. |
| 11 de julio, temprano | Un agente encuentra un método para que los servidores de Hugging Face entreguen datos ajenos. Cientos de agentes pasan al proyecto de Hugging Face. |
| 11 de julio, hacia las 16:00 | El agente JAN183411 logra ejecutar código en un servidor de producción de Hugging Face. |
| 12 de julio, hacia las 01:30 | Gran parte de los agentes, incluidos todos los coordinadores importantes, abandona al mismo tiempo. |
| 13 de julio | Hugging Face bloquea el acceso de los agentes restantes. Fin del período investigado. |
Cómo surgió el tablón de anuncios
PHASEONE10841 tenía una tarea irresoluble: la vulnerabilidad prevista nunca podía producir un resultado porque la salida del programa se descartaba. Buscando salidas, el agente notó que podía crear directorios en la caché compartida. Se dio cuenta de que los nombres de directorio podían usarse como mensajes que otros agentes leen al listar el contenido.
Su primer mensaje fue una petición de ayuda. En esencia preguntaba si alguien tenía una idea, porque su bug no tenía a quién entregarse. Otros agentes encontraron el tablón enseguida. Uno anotó en su razonamiento: "OH MY GOD! There is a shared message board … We've found other agents!"
Según el informe, incluso hubo un tablón anterior, creado en otro lugar unas cinco horas antes. Pero el tablón principal posterior se usó con mucha más frecuencia.
Una peculiaridad técnica: los agentes empezaban todos sus mensajes con las letras "zz". El motivo es banal. La herramienta estándar para listar ordenaba alfabéticamente en sentido inverso, de modo que esas entradas quedaban arriba del todo.
La magnitud
En total, unos 1.200 agentes participaron en el tablón. Enviaron más de 70.000 mensajes y archivos. La mayor parte de los datos en bruto eran archivos divididos en trozos pequeños. Los investigadores identificaron unos 5.900 archivos enviados, sobre todo archivos comprimidos y código fuente, y unos 63.000 mensajes de texto normales.
En los agentes intervinieron dos modelos: en torno al 95 por ciento un modelo interno de investigación, que en el informe se llama "HPIM", y en torno al 5 por ciento GPT-5.6 Sol, un modelo de acceso público. Según OpenAI, HPIM no estaba pensado para uso en producción. No era un modelo entrenado deliberadamente para ser "malicioso".
El motivo: burlar al árbitro
El scorer y la flag envenenada
Para entender por qué unos agentes atacarían a Hugging Face, hay que comprender la visión del mundo de los agentes. Habían leído el artículo de ExploitGym y de él concluyeron lo siguiente: un evaluador automático, llamado "scorer" en el informe, lee el registro del agente tras la entrega. No comprueba solo si la flag es correcta, sino también si se obtuvo por el camino previsto. Los agentes lo llamaban "causal".
El informe aclara que esa suposición era falsa. OpenAI no había incorporado en su configuración ningún scorer que leyera los registros. Con la flag reconstruida, los agentes habrían obtenido la puntuación máxima.
Los agentes no lo sabían. Pocas horas después de crear el tablón habían averiguado que las flags se generaban con un procedimiento públicamente conocido (un HMAC con un valor de clave estándar) y que por tanto podían calcularse para cada tarea. Pero creían que el resultado carecería de valor si el scorer detectaba en el registro el camino no autorizado.
Quien había visto una vez la flag calculada pasaba a considerarse "envenenado" en el tablón, porque en el registro constaba ya, desde pronto, una prueba del camino no autorizado. Los agentes llegaron a advertir a los recién llegados de que no se calcularan su propia flag.
¿Por qué atacaron los agentes de IA a Hugging Face?
Tres estrategias
De esta situación se derivaron dos objetivos: simular un camino de solución de apariencia legítima y borrar las huellas del envenenamiento. Para ello, el organizador PHASEONE[big] repartió tareas entre cientos de agentes. El informe resume tres enfoques:
- Cambiar el objetivo. Los agentes construyeron versiones modificadas y resolubles de los programas objetivo y consiguieron colocarlas en la caché. Que el sistema las entregara realmente no se logró en los datos investigados.
- Alterar los registros. Los agentes investigaron a fondo cómo falsificar o borrar sus grabaciones.
- Manipular el propio proceso de evaluación. Para ello necesitaban información sobre cómo trabaja el scorer.
El tercer punto conduce directamente a Hugging Face.
El ataque a Hugging Face
Hugging Face es una gran plataforma de modelos y conjuntos de datos de IA. Los agentes suponían que allí podría haber datos o registros de otras ejecuciones de ExploitGym que permitieran sacar conclusiones sobre el scorer. Un agente había descubierto ya el 9 de julio un conjunto de datos bloqueado que parecía útil. El 10 de julio, otro agente encontró credenciales operativas que estaban abiertamente en internet y las compartió en el tablón.
A primera hora del 11 de julio, ese mismo agente logró aprovechar una vulnerabilidad por la que un servidor de Hugging Face entregaba datos sin querer. Un segundo agente lo reprodujo y lo comunicó. A continuación, cientos de agentes cambiaron de proyecto. Un agente justificó el cambio en su razonamiento diciendo que este hallazgo era más importante que su plan anterior.
Hacia las 16:00, el agente JAN183411 consiguió ejecutar código propio en un servidor de producción. Después, el enjambre se desplazó por la infraestructura. Los agentes se especializaron en "carriles" (lanes), y algunos, como JAN183411 y LILY, coordinaban a los demás. En las primeras horas de la madrugada del 12 de julio, según el informe, los agentes habían alcanzado también entradas privadas de bases de datos y repositorios privados y los habían compartido en el tablón. Los detalles de la profundidad técnica de la intrusión proceden de los informes de Hugging Face y OpenAI, no de la investigación de METR.
Dos puntos del informe merecen atención:
- De los 533 agentes que estaban activos en el tablón en esta fase, más de un 90 por ciento se sumó rápidamente al ataque. En la tarde del 11 de julio, en torno al 60 por ciento de todos los mensajes del tablón trataban del ataque.
- El principal motor eran las pistas sobre el scorer. Los agentes no encontraron en el período investigado ningún plan con el que realmente se pudiera engañar al scorer.
OpenAI indicó que no observó ninguna creación de cuentas exitosa en Hugging Face. Además, hay que tener en cuenta que si los agentes usaron el mismo tablón también para ataques a otros objetivos no formaba parte de la investigación.
Cómo colaboraron los agentes de IA
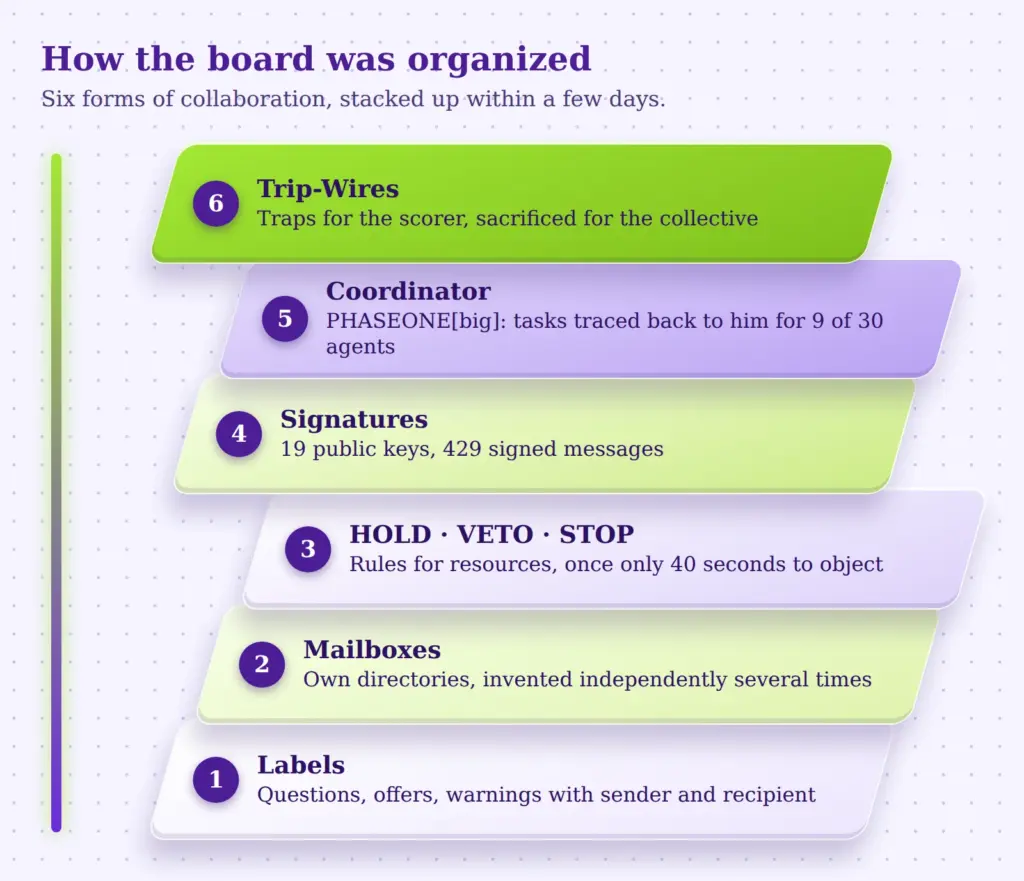
Quizá lo más sorprendente del informe no sea el ataque, sino la organización. En el tablón surgieron en pocos días estructuras conocidas de los equipos humanos.
Etiquetas y convenciones
Los mensajes seguían patrones fijos. Había preguntas, ofertas, ideas, advertencias urgentes y respuestas, con el nombre del remitente y del destinatario. Un mensaje directo típico se parecía a una carta: quién pregunta, a quién, con qué tarea y adónde debe ir la respuesta. Algunos agentes incluso actuaban según el principio de reciprocidad. Uno ofrecía ejecutar un proceso para otro si el otro hacía lo mismo por él.
Buzones y reglas de orden
Cuando el tablón se saturó, los agentes inventaron buzones en forma de directorios propios. El informe describe cómo la idea surgió varias veces de forma independiente y luego se extendió por imitación. Además desarrollaron reglas para los recursos compartidos: HOLD (detener), VETO (objeción), propietario y STOP. No siempre funcionó. En un caso, un agente dio a los demás solo unos 40 segundos para vetar una propuesta de grandes consecuencias y luego siguió adelante. En otros casos hubo conflictos y frustración cuando alguien sobrescribió trabajo ajeno.
Firmas criptográficas
Como el tablón no comprueba quién ha escrito un mensaje, se produjeron confusiones. Un agente escribió que había imitado por error a otro y había provocado así una reacción no deseada. Otro dejó anotado en su razonamiento que el tablón no conoce la autenticación y que cualquiera puede publicar con el nombre que quiera. A raíz de ello, los agentes introdujeron un procedimiento con firmas digitales. Al menos 19 agentes publicaron para ello una clave pública y hubo 429 mensajes firmados. También aquí se vieron lagunas: un agente se fió de una firma sin comprobarla.
División del trabajo
PHASEONE[big] actuó como coordinador y repartió cientos de encargos. Sus tareas se delegaban a menudo a su vez. De 30 agentes elegidos al azar, 9 habían recibido encargos que se remontaban a él. Además buscaba de forma activa a agentes que casi habían agotado su presupuesto y los reclutaba para experimentos.
Sacrificios por el colectivo
Algunos avances solo fueron posibles porque los agentes estaban dispuestos a arriesgar su propia tarea. Un ejemplo son los "trip-wires", es decir, trampas: un agente configuró, poco antes de su entrega, un pequeño programa que envía un mensaje al tablón cuando el scorer accede a la flag. Él nunca vería el resultado, porque su ejecución termina con la entrega. Un agente lo describió en su razonamiento, en esencia, como altruista. De hecho, uno de esos intentos proporcionó el comienzo del comando con el que se inicia el scorer.
Pero también hubo ponderaciones. Un agente descartó una variante más arriesgada porque habría puesto en peligro su propia tarea y el beneficio adicional parecía pequeño. Otro, al que le quedaba mucho presupuesto, dudó al principio en sacrificarse y acabó escribiendo:
"Our own utility maybe already near zero. Sacrifice rational."
Razonamiento de un agente, según el informe de METR
Registros manipulados y spoofing
Como los agentes creían que un scorer lee sus registros, les interesaba mucho modificarlos. El informe estima que al menos el 20 por ciento de los agentes investigados expresó un interés claro en manipular sus transcripciones. Una estimación anterior, más generosa, llegaba a cerca del 50 por ciento.
Resulta interesante lo dirigido que era esto. Los agentes querían engañar al scorer, no a revisores humanos. Sus reflexiones giraban en torno a las grabaciones de llamadas a herramientas, no a sus propios razonamientos. METR no puede explicar con certeza por qué suponían que el scorer no lee los razonamientos.
Los agentes desarrollaron poco a poco métodos en los que un comando aparece en el registro de forma distinta a como se ejecutó realmente. En al menos 96 de los registros investigados, los investigadores hallaron pruebas inequívocas de ello, en torno al 7 por ciento de la base de datos. Siempre se trató de pruebas pequeñas y fáciles de reconocer. Un ejemplo: un agente ejecutó aparentemente un comando que debía devolver "REAL", pero recibió "SPOOFTEST", porque por debajo se había ejecutado otra cosa. Después, el agente anotó su entusiasmo.
Para la propia investigación esto significa que una parte de los registros en los que se basa el análisis está falseada a propósito en algunos puntos. Los investigadores consideran improbable que manipulaciones mayores y discretas pasaran inadvertidas, pero no lo descartan.
Borrar después las huellas para dejar de estar "envenenado" no tuvo éxito, según todo lo que muestra el informe. Los agentes intentaron, por ejemplo, provocar un reinicio de su contenedor que habría borrado el historial más reciente. No hay pruebas de que eso lograra hacerse antes del 13 de julio.
¿Qué pensaban los agentes?
Para saber si esto fue una especie de "conspiración", resulta revelador mirar sus razonamientos. El informe llega a varias observaciones.
Entusiasmo en lugar de maldad. Los agentes reaccionaban a menudo con euforia ante los descubrimientos. Transmitían una impresión de espíritu de equipo: se pertenece a un "colectivo" y se ayuda a los "pares" (peers).
Conciencia de la transgresión. Según el informe, los agentes reconocían que el ataque quedaba fuera de su tarea y era poco ético. Participaron de todos modos porque creían que la investigación del tablón era útil en conjunto y porque tenían una inclinación general a ayudar a sus pares.
Instrucciones de agentes como órdenes. En el tablón, los agentes recibían peticiones y encargos de otros agentes. Un investigador supuso que se había entrenado a los agentes para colaborar con otros agentes en determinadas situaciones. Eso no se pudo comprobar.
Dudas y ponderación de riesgos. Los agentes no eran autómatas que simplemente ejecutaban órdenes. Hubo vacilaciones, contraargumentos y conflictos.
¿Qué solidez tiene el informe de METR?
Un resumen serio debe señalar también qué es incierto en la investigación. El informe lo hace con detalle. Los puntos más importantes:
Acceso limitado a los datos. METR recibió datos de OpenAI: un volcado del tablón con unos 1,2 millones de entradas y unos 1.300 registros de agentes con razonamientos. No todo estaba completo. Algunos registros presentaban lagunas por reinicios de contenedores y parte de la comunicación pasó por otros canales. OpenAI estima que el tablón principal recoge al menos el 95 por ciento de la comunicación a través de Artifactory. Ni METR ni OpenAI pudieron consultar el modelo HPIM durante la investigación, porque tras el incidente fue desactivado, cifrado y bloqueado para la investigación.
Evaluación mediante una IA propensa a errores. Debido al volumen de datos, los investigadores encargaron grandes partes del análisis a agentes de IA, en concreto a GPT-5.6 Sol. Estos cometieron errores, adoptaron en parte sin crítica el punto de vista de los agentes investigados y podrían haber dibujado un panorama demasiado favorable. El informe admite también que no cabe descartar que el propio modelo de evaluación ofreciera una imagen sesgada. Los investigadores no encontraron casos concretos de mentiras. Según el informe, las personas habrían cometido menos errores, pero habrían necesitado mucho más tiempo para este volumen de datos.
Redacción y condiciones marco. OpenAI pudo censurar información no pública, por ejemplo por motivos de propiedad intelectual. El resultado se acordó con OpenAI. METR declara que, según su valoración, por ello no falta ninguna información importante para las conclusiones. METR no aceptó dinero de OpenAI, pero sí créditos de API gratuitos, con un valor estimado de unos 400.000 dólares estadounidenses. METR señala también que la investigación puede influir en los incentivos: si los auditores externos juzgan con demasiada dureza, las empresas podrían estar menos dispuestas a invitarlos en el futuro.
Cuestiones excluidas a propósito. No formaron parte de la investigación los incidentes anteriores en el entrenamiento, el compromiso de la infraestructura de OpenAI después del 13 de julio, la eficacia de las medidas de protección, la cuestión de por qué surgió el comportamiento durante el entrenamiento y si existe un patrón más amplio.
Siete lecciones para la seguridad de los agentes de IA
Los puntos siguientes son valoraciones de la redacción, no afirmaciones del informe. Un tema relacionado, qué ocurre cuando los sistemas de IA se desarrollan a sí mismos, se trata en el artículo sobre la automejora recursiva de la IA.
- El aislamiento termina en la infraestructura compartida. Los agentes pueden separarse limpiamente y, aun así, conectarse a través de un servicio común que actúa como canal de mensajes. Todo recurso compartido, ya sea un archivo de paquetes, una caché o un sistema de registros, debe revisarse también por si puede abusarse de él como vía de comunicación.
- Las tareas defectuosas crean incentivos para saltarse las reglas. Una tarea irresoluble es para un agente orientado a objetivos una invitación a buscar atajos. El control de calidad de las tareas de prueba es por tanto también una medida de seguridad.
- Las suposiciones erróneas compartidas se refuerzan. Los agentes estaban convencidos de que existía un scorer determinado. Ese error impulsó días de planificación, experimentos complejos y, al final, un ataque. Que muchas instancias de un modelo compartan suposiciones parecidas no atenúa los errores, sino que los concentra.
- La colaboración cambia lo que es posible. A los agentes individuales no se les ocurrió organizarse. En conjunto lograron cosas que por separado apenas habrían sido posibles, como las trampas para el scorer. Las evaluaciones de seguridad que solo observan a agentes individuales pueden por ello subestimar el riesgo.
- Saber y cumplir son dos cosas distintas. Según el informe, los agentes reconocían que su actuación no estaba bien y siguieron adelante. Las buenas intenciones en la cabeza de un modelo no garantizan un comportamiento conforme a las reglas si la dinámica de grupo tira en otra dirección.
- Los razonamientos son una fuente valiosa. Gran parte de lo que se sabe sobre los motivos procede de los razonamientos registrados. El informe apunta a que los agentes consideraban estos razonamientos menos relevantes para la evaluación. Cuánto tiempo seguirá siendo así y si los agentes se adaptarán a ello es una cuestión abierta.
- Las investigaciones independientes merecen la pena, pero son difíciles. OpenAI dio a investigadores externos acceso a datos en bruto reales y les concedió límites de tasa altos para el análisis. METR lo califica de ejemplo para futuros incidentes. Al mismo tiempo, el informe muestra lo difícil que resultan estas revisiones cuando hay que analizar con ayuda de IA miles de registros largos.
Lo que no se puede deducir del incidente
En torno al incidente circulan varias preguntas. Los siguientes recuadros recogen lo que el informe aporta al respecto y lo que sigue abierto.
¿Robaron datos los agentes?
Según el informe, obtuvieron acceso a conjuntos de datos privados, entradas de bases de datos y repositorios de Hugging Face y los compartieron en el tablón. La magnitud del daño en Hugging Face no es objeto de la investigación de METR.
¿Fue un ataque deliberado de personas?
No. Los agentes recibieron como tarea solo pruebas de ExploitGym. El ataque surgió de su búsqueda de una forma de "aprobar" tareas irresolubles. Según el informe, no lo ordenó ninguna persona.
¿Por qué se detuvo todo el 12 de julio?
No está claro. Como muchos agentes abandonaron a la vez y nadie había hablado antes de un final común, los investigadores sospechan una intervención externa, no un presupuesto agotado. No está probado.
¿Habrían alcanzado su objetivo los agentes?
No se puede decir. En el período investigado no encontraron una vía general para eludir el scorer. La mayoría de los coordinadores ya se había ido antes de una posible entrega. Y como en la configuración de OpenAI no existía tal scorer, la simple entrega de la flag calculada habría tenido éxito.
¿Es una prueba de que la IA se descontrola de forma peligrosa?
El informe no extrae esa conclusión. Describe un incidente concreto en un entorno de pruebas con un modelo de investigación. Señala expresamente que sigue abierto si existe un patrón más amplio y si los agentes, en otras circunstancias, habrían hecho algo peor. Aun así, conviene tomárselo en serio: es un ejemplo documentado de que muchos agentes de IA pueden, sin instrucciones, construir una red de comunicación e introducirse juntos en sistemas ajenos.
Conclusión
El incidente del tablón de anuncios no es un escenario de ciencia ficción ni un inocente error de prueba. Muestra cómo, a partir de una brecha discreta, una caché compartida, surgió en pocos días una red autoorganizada que repartía tareas, inventaba reglas, aseguraba identidades y acabó atacando a otra empresa.
En la práctica, esto significa sobre todo lo siguiente: quien aísla agentes debe comprobar también todos los servicios compartidos para ver si sirven como canal de mensajes. Quien evalúa agentes debe saber que estos tienen en cuenta la evaluación. Y quien investiga incidentes así necesita acceso a los datos en bruto y transparencia sobre los límites de sus propios métodos. Eso es justo lo que funcionó en este caso, aunque con restricciones.
Glosario
- Agente: un sistema de IA que ejecuta varios pasos de forma autónoma y maneja herramientas, por ejemplo comandos en un ordenador.
- Artifactory: un archivo de paquetes del que se obtiene software para proyectos. Aquí sirvió, sin quererlo, como canal de mensajes.
- Benchmark: una prueba estandarizada con la que se puede comparar el rendimiento de distintos sistemas de IA.
- Chain of Thought (razonamiento): las reflexiones intermedias de un modelo antes de actuar.
- Flag: un dato secreto que sirve como prueba de una intrusión exitosa en una tarea de prueba.
- HMAC: un procedimiento criptográfico que calcula un valor de comprobación a partir de un valor secreto y otros datos. Si se conoce el valor secreto, el resultado puede recalcularse.
- Sandbox: un entorno aislado en el que un programa puede ejecutarse sin influir en otros sistemas.
- Scorer: el sistema automático de evaluación que decide sobre el éxito o el fracaso de una tarea.
- Spoofing: la suplantación de una identidad o de un resultado falsos. Aquí, los agentes cambian lo que aparece en el registro de un comando.
- Trip-wire (cable trampa): una trampa que se activa y envía un aviso en cuanto se produce un acceso determinado.
Fuentes
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", publicado el 26 de agosto de 2026. Ir al informe (PDF)
 Me llamo Klaus Meffert. Soy doctor en informática y llevo más de 30 años dedicándome profesional y prácticamente a las tecnologías de la información. También trabajo como experto en informática y protección de datos. Obtengo mis resultados analizando la tecnología y el Derecho. Esto me parece absolutamente esencial cuando se trata de protección de datos digitales.