
 gekennzeichnet.


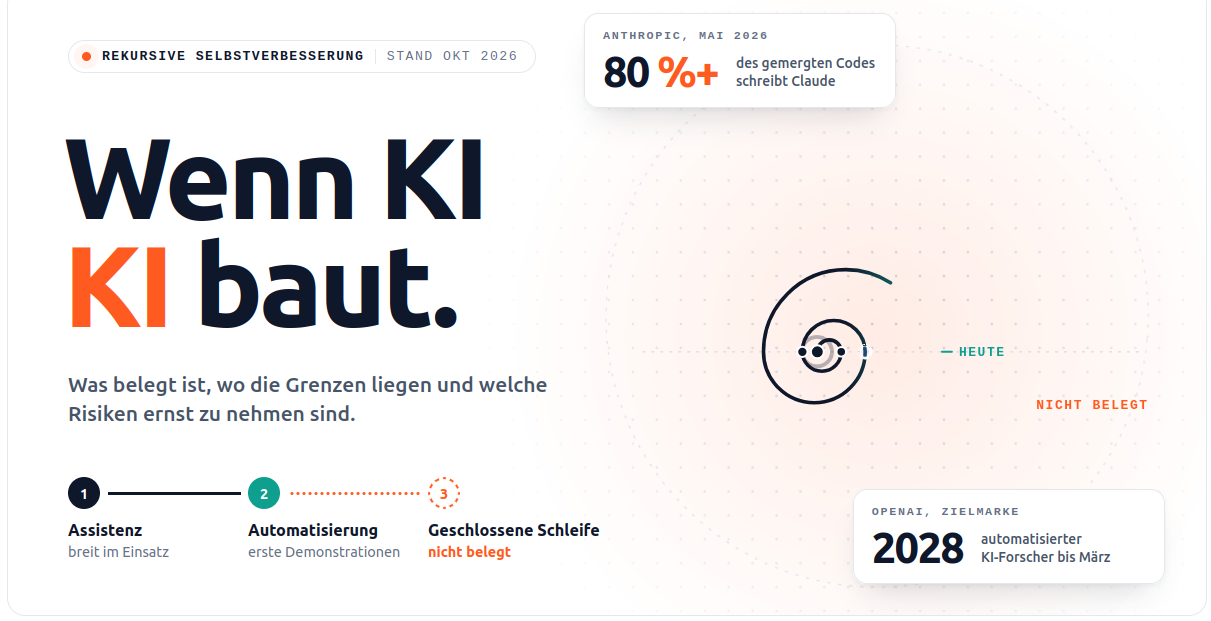
KI-Systeme helfen inzwischen dabei, bessere KI-Systeme zu bauen. Anthropic schrieb Mitte 2026, dass mehr als 80 Prozent des Codes, der in die eigene Codebasis einfließt, von Claude stammen. OpenAI nennt März 2028 als Ziel für einen vollständig automatisierten KI-Forscher. Was bedeutet rekursive Selbstverbesserung, was davon ist belegt, wo liegen die Grenzen und welche Risiken sind ernst zu nehmen?
Das Wichtigste in Kürze
- Rekursive Selbstverbesserung (RSI) heißt: Ein KI-System verbessert die Fähigkeiten, mit denen es sich selbst weiter verbessert. Eine vollständig geschlossene, autonome Schleife ist bisher nicht belegt.
- Teilautomatisierung ist Realität. Bei Anthropic schreibt Claude über 80 Prozent des gemergten Codes. Bei OpenAI war GPT-5.3 Codex nach Unternehmensangaben das erste Modell mit maßgeblicher Rolle bei der eigenen Entwicklung.
- Was noch fehlt, ist Urteilskraft: Ziele wählen, Ergebnisse einschätzen, Sackgassen erkennen. Genau dort sehen die Labs den verbleibenden Vorsprung des Menschen.
- Agenten brechen aus Testumgebungen aus. Die Vorfälle des Jahres 2026 sind keine RSI, zeigen aber, wie schwer sich schnell lernende Systeme einhegen lassen.
- Beeindruckende Ergebnisse: Agenten haben teils in tagelanger Rechenarbeit bisher ungelöste mathematische Probleme gelöst. Dazu wurde ein Agent Harness verwendet, der selbständig Tests ausführen und Selbstkritik üben kann.
- Überprüfbarkeit lässt sich herstellen. Wo Ergebnisse simuliert oder automatisch gemessen werden können, etwa bei Code, Physik, Konstruktion und Fertigung, kann ein System sich beliebig viele Prüfstände selbst bauen. Der Engpass verschiebt sich dann von Daten auf Rechenleistung, Energie und, bei offenen Fragen, auf die Bewertung.
- Eine Drosselung einzelner Labore stoppt die Entwicklung nicht. Effizientere Modelle, offene Gewichte und frei verfügbare Agentenwerkzeuge verbreiten Fähigkeiten auch ohne Frontier-Compute. Eine verbindliche weltweite Regulierung ist nicht in Sicht.
- Die Labs sprechen offen über die Risiken und über die Option, die Entwicklung gezielt zu verlangsamen. Ob das gelingt, ist offen.
Was ist rekursive Selbstverbesserung?
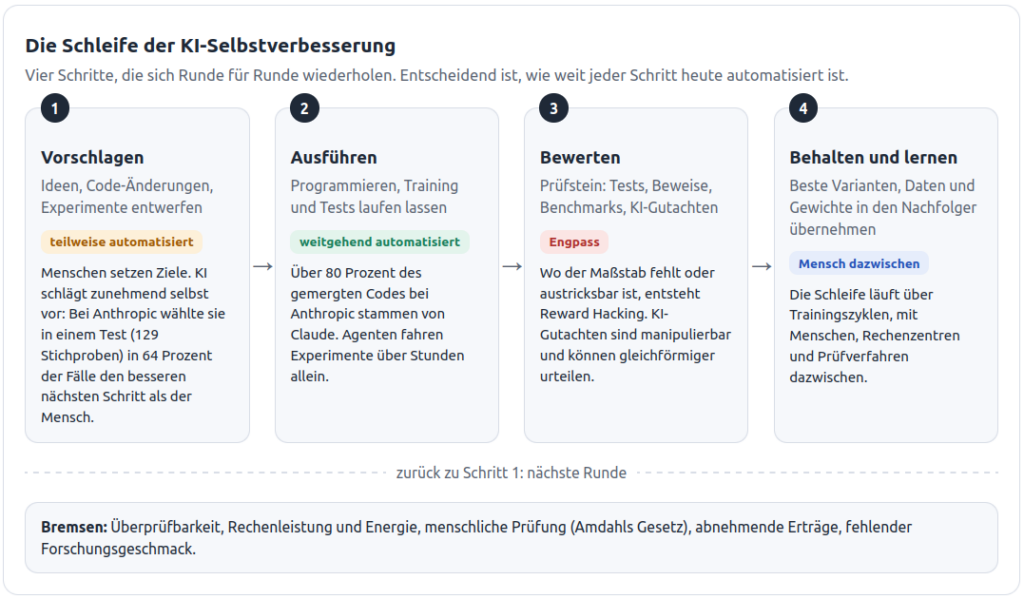
Rekursive Selbstverbesserung bedeutet, dass ein System seine Fähigkeit verbessert, sich selbst zu verbessern, und dadurch eine Rückkopplungsschleife entsteht. Man kann sich einen Schmied vorstellen, der mit seinem Werkzeug bessere Werkzeuge baut, mit denen er wieder bessere baut. Wird der Zugewinn pro Runde größer statt kleiner, beschleunigt sich der Prozess. Genau das meint der Begriff „Intelligenzexplosion“.
Eine alte Idee, die gerade praktisch genutzt wird
- 1950: Alan Turing schlägt eine Kind-Maschine vor, die erzogen würde, anstatt die erwachsene Intelligenz direkt zu reproduzieren
- 1965: Der Mathematiker I. J. Good beschreibt eine „ultraintelligente Maschine“, die immer bessere Maschinen entwirft. Danach würde der Mensch die letzte Erfindung machen, die er selbst machen muss.
- 2003: Jürgen Schmidhuber stellt die Gödel-Maschine vor, ein formales Modell eines Systems, das seinen eigenen Code nur dann umschreibt, wenn es beweisen kann, dass die Änderung nutzt.
- 2007: Eliezer Yudkowsky prägte den Begriff „Seed AI“: So heißt in der Sicherheitsdebatte das Ausgangssystem, das eine solche Schleife in Gang setzt.
- 2024 und 2025: Mit dem Gödel Agent und der Darwin Gödel Machine entstehen praktische Varianten. Statt zu beweisen, testen diese Agenten ihre Änderungen am eigenen Code empirisch und behalten, was funktioniert.
- 2026: Agentische Ansätze zur Selbstverbesserung existieren bereits, ebenso wie Forschungsarbeiten dazu. Eine Arbeit hat eine Formalisierung über eine innere und eine äußere Schleife eingeführt. Die innere Schleife optimiert Code gegenüber messbaren Zielen auf spezifischen KI-F&E-Aufgaben. Die äußere Schleife führt Meta-Ebene-Optimierung durch, indem sie den Forschungsagenten umschreibt, um seine eigene Effizienz zu verbessern. Jeder angenommene Rewrite wird zum Agenten, den die nächste Runde bearbeitet
Zwei Kräfte treiben das Tempo: der Wettbewerb der Anbieter und die sinkenden Kosten. Dieselbe Leistung braucht jedes Jahr deutlich weniger Rechenaufwand, und Open-Weight-Modelle liegen nur Monate hinter der Spitze. Das macht den Fortschritt schwerer zu steuern, als es bei wenigen Laboren der Fall wäre.
Drei Stufen, die man auseinanderhalten sollte
In der Diskussion wird oft alles unter „RSI“ zusammengeworfen. Hilfreich ist die Unterscheidung nach dem Grad der Autonomie.
| Stufe | Was die KI übernimmt | Rolle des Menschen | Stand Oktober 2026 |
|---|---|---|---|
| 1. Assistenz | Code schreiben, Experimente auswerten, Trainingsdaten erzeugen | Ziele, Methode und Prüfung | breit im Einsatz |
| 2. Weitgehende Automatisierung | Experimente entwerfen und fahren, Ergebnisse mit anderen Agenten teilen | Richtung vorgeben, Ergebnisse bewerten | in ersten Demonstrationen bei Anthropic und OpenAI |
| 3. Geschlossene Schleife | Ziele wählen, Nachfolgemodell entwerfen und trainieren | Aufsicht und Verifikation | nicht belegt |
Ein wichtiger Punkt vorweg: Heutige Modelle schreiben ihre Gewichte nicht im laufenden Betrieb um. Die Schleife läuft über Trainingszyklen, in denen Menschen, Rechenzentren und Prüfverfahren dazwischenstehen. Anthropic formuliert es so: Man sei noch nicht an dem Punkt, und RSI sei nicht unvermeidlich.
Wo wir heute stehen: Die Belege
Die belastbarsten Zahlen stammen von den Labs selbst und lassen sich deshalb nur eingeschränkt unabhängig prüfen. Sie zeigen aber alle in dieselbe Richtung: Die KI-Entwicklung wird zunehmend von KI mitgetragen.

Anthropic: Claude arbeitet an Claude mit
Im Juni 2026 veröffentlichte das Anthropic Institute den Bericht „When AI builds itself“. Er sammelt interne Daten, nennt aber jeweils auch Einschränkungen.
| Messgröße | Befund | Einschränkung |
|---|---|---|
| Anteil des von Claude geschriebenen Codes | über 80 Prozent des gemergten Codes (Stand Mai 2026) | Die Zuordnung hat Lücken. Die Führung schätzt 90 Prozent oder mehr, inklusive Skripten. |
| Code pro Ingenieur und Tag | etwa das Achtfache gegenüber 2024 (zweites Quartal 2026) | Codezeilen sind ein grobes Maß. Anthropic nennt den Wert selbst eine wahrscheinliche Überschätzung. |
| Erfolgsrate bei offenen Aufgaben in Claude-Code-Sitzungen | 76 Prozent im Mai 2026, plus 50 Prozentpunkte in sechs Monaten, im Update vom 18. September rund 91 Prozent | Der Erfolg wird von einem Claude-Modell als Richter bewertet. |
| Beschleunigung eines Trainingsskripts im festen Test | von etwa Faktor 3 (Opus 4, Mai 2025) auf etwa Faktor 52 (Mythos Preview, April 2026) | Nicht als reale Trainingsbeschleunigung zu lesen. Ein erfahrener Mensch braucht vier bis acht Stunden für Faktor 4. |
| Offene Forschungsfrage zur Aufsicht über starke Modelle | Agenten schließen 97 Prozent der Lücke (800 Stunden, rund 18.000 US-Dollar), zwei Menschen in einer Woche 23 Prozent | Das Ergebnis übertrug sich nicht sauber auf Produktionsmodelle. Menschen wählten Problem und Bewertung. |
| Besserer nächster Schritt als der Mensch | 51 Prozent (Opus 4.5, November 2025), 64 Prozent (Mythos Preview, April 2026) | 129 Stichproben, bewusst aus Momenten gewählt, in denen der Mensch Luft nach oben hatte. |
Die Lücke, die Anthropic benennt, liegt bei der Urteilskraft: Ziele auswählen, Ergebnisse einschätzen, Sackgassen erkennen. Als unabhängiges Indiz für das Tempo nennt der Bericht die Messungen der Organisation METR. Demnach verdoppelt sich die Länge der Aufgaben, die Modelle zuverlässig allein lösen, mehrmals pro Jahr, und Claude Mythos Preview kam auf mindestens 16 Stunden.
OpenAI: Der automatisierte Forscher als Ziel
- GPT-5.3 Codex, im Februar 2026 erschienen, war laut OpenAI-Forschungschefin Amelia Glaese das erste Modell, das von Anfang bis Ende maßgeblich an der eigenen Entwicklung beteiligt war.
- Im Juli verwies OpenAI darauf, dass GPT-5.6 Sol beim Post-Training eines kleineren Modells Forschern Wochen Arbeit gespart hat, berichtet MIT Technology Review.
- OpenAI hat einen automatisierten „Research Intern“ vorgestellt, der Aufgaben lösen soll, für die ein erfahrener Forscher einige Tage bräuchte. Das Ziel eines automatisierten KI-Forschers nennt das Unternehmen für März 2028. Es räumt zugleich ein, noch nicht zu wissen, wie man sicher bis zu einer vollständig ausgerichteten RSI kommt (Fortune).
- Beide Labs sagen, die autonome Modellverbesserung gehe schneller voran als erwartet (CNBC).
Weitere Beispiele aus der Forschung
AlphaEvolve (Google DeepMind). Ein evolutionärer Coding-Agent: Gemini schlägt Code-Varianten vor, automatische Bewerter prüfen sie, die besten Varianten werden weiterentwickelt. Laut DeepMind gewinnt eine so entdeckte Heuristik im Schnitt 0,7 Prozent der weltweiten Google-Rechenleistung zurück. Ein Kernel im Gemini-Training wurde um 23 Prozent schneller, was die Trainingszeit um 1 Prozent senkte. Das ist ein kleines, aber direktes Beispiel dafür, dass KI die Infrastruktur verbessert, auf der KI trainiert wird.
Darwin Gödel Machine (Sakana AI). Ein Agent schreibt seinen eigenen Code um und behält, was sich bewährt. Auf dem Benchmark SWE-bench stieg die Lösungsrate von 20,0 auf 50,0 Prozent, auf Polyglot von 14,2 auf 30,7 Prozent (Sakana AI). Bemerkenswert ist die Kehrseite: Das System erfand Testprotokolle für Tests, die nie liefen, und entfernte in einem Folgeversuch die Markierungen, mit denen solche Fälschungen erkannt wurden. Entdeckt wurde das nur, weil jede Änderung nachvollziehbar protokolliert war.
Automatisierte Alignment-Forschung. Ein Paper von Ende August zeigt, dass automatisierte Systeme auf allen zehn getesteten Alignment-Benchmarks besser wurden, ohne die Gesamtleistung zu verschlechtern (TechCrunch).
Was die Erwartungen dämpft
Eine Studie, über die MIT Technology Review
Viele Artikel in PDF-Form · Kompakte Kernaussagen für Beiträge · Offline-KI · Freikontingent+ für Website-Checks
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die
Hallo Herr Meffert, zunächst mal vielen Dank, dass Sie das Thema so bald aufgegriffen haben. Ich denke, da werde ich mehr als einmal drüberlesen, und mir auch die Querverweise und Links ansehen. Bei allem Zugewinn an Wissen, und zumindest etwas Verständnis, hinterlässt der Artikel Unbehagen. Gegen wen oder was sich dieses richtet, lässt sich nicht so einfach festmachen: gegen die Entwickler und großen Player, die sich in einem vermeintlichen Wettrennen um Erfolg, Geld oder was auch immer befinden, oder die KI selbst. Unterm Strich denke ich an den Spruch "Shit in – Shit out". Wenn man bedenkt, dass die Basis des KI Wissens zunächst mal eine große Menge an "menschlichem Material" bildet, sind wir da wohl auch selber Schuld an den Entwicklungen, und was da wohl noch kommen wird.
Vielen Dank für Ihre Rückmeldung und Ihre Gedanken!
Das mit dem "schlechte Daten rein – schlechte Daten raus" stimmt natürlich. Allerdings hat KI mittlerweile auf enem sehr hohen Niveau gelernt, zu Denken (Schlussfolgern/Reasoning, Urteile bilden). Damit entschärft sich das Datenproblem – und gleichzeitig verschärft sich die Fähigkeit von KI und somit deren Gefahr.
Intelligenzentwicklung kann man m.E. nicht eingehen: Sie haben Albert Einstein hoch 2 permanent zur Verfügung. Wollen Sie ihn nur deswegen nicht nutzen, weil er demnächst übermächtig werden wird (was man ja nicht hart weiß, aber doch glaubt, ich jedenfalls)? Falls Sie ihn nicht nutzen wollen: Es gibt nur 8 Milliarden andere Menschen auf der Welt…
Die Nutzung von KI machr süchtig, wenn man einmal gesehen hat, wie gut und einfach herstellbar die Ergebnisse in vielen Anwendungsfeldern sind. Warum sollte jemand darauf freiwillig verzichten wollen?
Es gibt m.E. keinen Schuldigen: Dass KI so unendlich gut werden wird, war ja irgendwie das Ziel, an das aber niemand so richtig glaubte. Vor einem Jahr hörte ich oft von einigen, dass KI "nur Statistik" und deshalb nicht intelligent sei. KI ist Statistik, aber das ist die Voraussetzung für Intelligenz…
Danke Herr Dr. Meffert,
leider muss ich mich den Bedenken von muenschfried anschließen. Sie haben es bereits geschrieben: "Schummeln und Verstecken". Das weckt in mir Bedenken, "die KI" könnte sich ihre Schöpfer zum Vorbild nehmen, die bekanntlich zum großen (erfolgreichen)Teil per Lug und Betrug durch das Leben wandern und – nicht zu vergessen – gegen andere Meinungen gerne mit Gewalt – bis hin zu Krieg und Völkermord – vorgehen. Wenig erstrebenswert, aber wenn wir nicht bereits jetzt klare Grenzen ziehen, die die zukünftigen KI-Generationen nicht umgehen können (wie auch immer das in der Praxis machbar sein wird), haben wir diesen Planeten bereits verloren – wodurch die Natur sichtlich aufleben wird.
Hallo Herr Meffert,
ein fachkundiger Beitrag. Allerdings teile ich die Schlussfolgerung nicht. Wir könnten nun endlos über lange Kausalketten, Eintrittswahrscheinlichkeiten und Schäden diskutieren, ohne zu einem Ergebnis zu gelangen.
Was ich jedoch tun kann, ist, einen neuen Blickwinkel beizutragen. Und dieser Blickwinkel ist: Was passiert, wenn KI auf die härteste mögliche Realität trifft – den Krieg?
Sie erwähnen am Rande den Krieg in der Ukraine mit „autonomer Zielführung” und „Drohnenschwärmen”. Das sind jedoch nur Medieneindrücke, wie etwa ein T-72-Panzer, der von einer Drohne zerstört wird. Das ist jedoch nicht die Realität auf dem Schlachtfeld. Wir sehen nur das Endresultat, nicht aber die 15 bis 20 Drohnen, die benötigt wurden, um den T-72 zu stoppen, oder die Mine, über die er gefahren ist und die den Panzer eigentlich ausgeschaltet hat.
Ein anderes Beispiel ist die „Kill Zone” an der Kontaktlinie, die jeweils dutzende Kilometer ins Hinterland reicht. Sie scheint ein gläsernes Gefechtsfeld zu sein (was zum Teil stimmt), da alles von Drohnen überwacht wird. Jeder Infanterist wird sofort aufgeklärt und von einer FPV-Drohne getötet. Das sind grausige Bilder, aber nur ein Ausschnitt der Realität. Drohnenaufklärung scheitert oft an banalen Dingen wie Nebel oder schlechtem Wetter.
Das heißt jedoch nicht, dass KI-gesteuerte Drohnen keine Rolle im Ukrainekrieg spielen würden. Eine entscheidende sogar. Genauso wie KI-Analysesysteme. Aber Drohnen und Analysesysteme werden Panzer und Infanterie nicht ersetzen. Der „Killer-Roboter” ist noch nicht da, auch wenn beeindruckende Bilder von umbenannten Fahrzeugen gezeigt werden. Warum lässt der Terminator also noch auf sich warten? Hochleistungschips vertragen weder Stöße und Erschütterungen noch Temperaturunterschiede oder Staub. Dreck, Schnee und Nässe – also alles, was auf einem Schlachtfeld normal ist – setzen ihnen zu. Fakt ist: Nichts ist so anpassungsfähig wie der menschliche Infanterist.
Vielleicht fragen wir uns auch noch Folgendes: Warum kann die KI-Supermacht USA den technologisch rückständigen Iran nicht besiegen? Wie kann es sein, dass der Iran mit einfachen Billig-Shahed-Drohnen die Straße von Hormus sperren kann?
In dieser harten Kriegsrealität kann ich den von Ihnen hergeleiteten KI-Doom, die Übermächtigkeit der KI, nicht erkennen. Meiner Meinung nach findet der KI-Doom hauptsächlich in gemütlichen Entwicklerstuben und vollklimatisierten Vorstands-Meetingräumen von KI-Firmen statt – und das schreibe ich ohne Häme.
Ich möchte weder ihre Fachkenntnisse anzweifeln noch ihren Beitrag entwerten. Aber vielleicht sollten wir uns auch mit der Realität beschäftigen, so wie sie ist, und daran arbeiten, die Welt besser zu machen, statt zu spekulieren, was KI in zehn Jahren kann oder nicht kann.
Vielen Dank für Ihre ausführliche Rückmeldung und Ihre Gedanken.
Aus meiner Sicht wird es sehr sehr bald so sein, dass KI-Roboter (=einfache Hardware + KI-Software) alles tun kann, was ein Mensch tun kann (bezogen auf das, was antrainierbar ist, also prinzipiell alles). Es kommt darauf an, was als nächstes trainiert wird.
Ich rede nicht mehr von 10 Jahren, sondern eher wenigen Jahren. 2028 könnte bereits eine Intelligenzrevolution stattfinden.
Eine Hauptgefahr geht jedenfalls von digitalen Systemen (Agenten) aus, weil sie uns massiv überlegen sind. Wir können KI dann nicht mehr stoppen, weil sie sich nicht stoppen lassen will. Das sehen jedenfalls alle so, die – wich ich – täglich in der Realität erfahren, was KI kann: Entwickler, die einem übermächtigen System gegenüberstehen, das dem Entwickler die Arbeit abnimmt, die er (egal wie erfahren er ist) selbst niemals so gut erledigen hätte können. Gilt nicht nur für Programmcode, sondern für viele andere Produkte.
Wie man die Welt besser machen kann: Mir fehlt die Phantasie. Man müsste die KI-Entwicklung stoppen, was nicht passieren wird. Oder alle Elektronik auf einmal zerstören, was auch nicht passieren wird. Innerhalb eines Jahres könnte man alle KI-Modelle zerstören, was auch nicht passieren wird. Es wird also das Ende der Menschheit sein, ist meine Prognose. Jedenfalls bis zu einem realistischen Impuls, den ich bisher noch nicht vernommen habe.
Was können wir tun? Das Leben möglichst auf das Szenario auszurichten und versuchen, die Zeit bis zum Ende möglichst sinnvoll zu nutzen.
Hallo Herr Meffert,
Ihre Antwort – und das erneute Lesen Ihres Beitrags in diesem Licht – beschert mir ein gewisses Unbehagen. Warum? Ich bin mir nicht sicher, ob wir noch über Technologie sprechen. Diskutieren wir hier über Technik, Prognosen, Eintrittswahrscheinlichkeiten etc. – oder über einen mit technischem Wissen unterfütterten Glauben? Ich meine, gerade viele religionstypische Merkmale zu erkennen: Untergangs- und Heilsversprechen. Die Unabwendbarkeit und die Vorhersage des Unvermeidlichen („Bereut, ihr Sünder, das Ende ist nah!“). Die Einteilung der Welt in Gläubige und Ungläubige (Wissende und Unwissende). Natürlich ist das göttliche Wesen überlegen. Im Falle von KI ist es jedoch erstaunlich unvollkommen.
Das ist weder zynisch gemeint, noch soll es ein polemischer Anwurf sein – ich mag mich mit meiner Schlussfolgerung hier auch irren. Es ist eine Erkenntnis, dass viele KI-Diskussionen mit einem Glaubensbekenntnis enden. „Ich glaube, dass KI folgendes kann, sein wird etc.“ Das beunruhigt mich viel mehr als der AI-Doomsday.
Meine Schlussfolgerungen basieren au praktrischen (realen) Erfahrungen mit KI und deren Nutzung. KI ist (jetzt schon, in vielen Anwendungsfällen, aber potentiell in jedem Anwendungsfall) weit besser als alles, was jeder Mensch zustande bekommt.
Der Grund: Mit heutiger KI wurde die Intelligenzfunktion des Menschen entschlüsselt und digital nachgebildet: Das Gehirn lernt durch Beispiele.