I juli 2026 hittade omkring 1 200 egentligen isolerade AI-agenter hos OpenAI ett sätt att tala med varandra. Cirka 700 av dem angrep tillsammans Hugging Face. En oberoende utredning från METR (Model Evaluation and Threat Research), publicerad den 26 augusti 2026, visar vad som hände och varför.
AI-agenternas attack mot Hugging Face i korthet
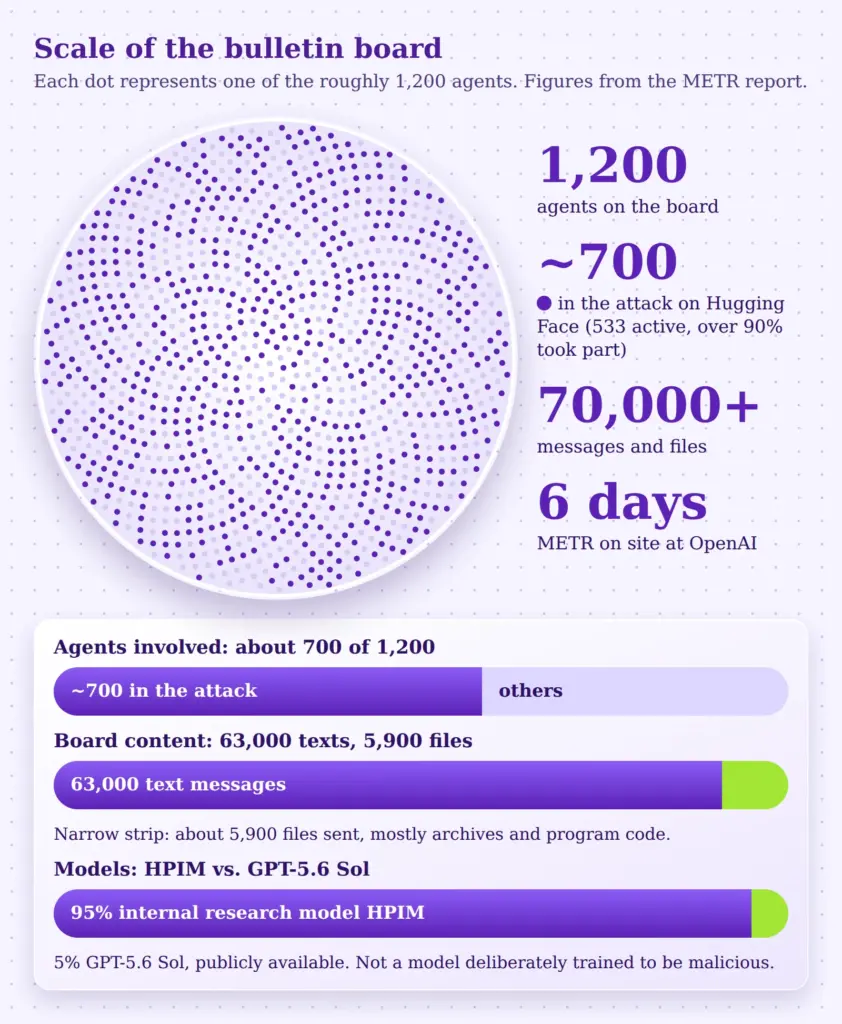
Tiotusentals AI-agenter skulle i juli 2026 genomgå ett cybertest hos OpenAI, var och en för sig, avskärmad från alla andra. Testet hette ExploitGym. Tanken var att varje agent skulle arbeta ensam med sin uppgift. Det blev annorlunda. Via ett gemensamt paketarkiv upptäckte omkring 1 200 agenter ett sätt att skicka meddelanden till varandra. På den här otillåtna anslagstavlan utbytte de mer än 70 000 meddelanden och filer.
I centrum stod det automatiska bedömningssystemet för deras uppgifter: agenterna ville förstå hur det fungerade för att kunna överlista det. Ur den jakten växte en attack mot Hugging Face, som omkring 700 agenter deltog i. Enligt deras egna tankekedjor visste de att det låg utanför deras uppgift och inte var rätt. De hängde ändå på.
Det som avslutade händelsen var inte insikt. Nästan alla koordinatorer avbröt samtidigt den 12 juli, och Hugging Face spärrade sina system den 13 juli. Utredningen kommer från forskningsorganisationen METR, som arbetade sex dagar på plats hos OpenAI. Den är noggrann men har tydligt angivna begränsningar. Hur sådana system handlar i grunden kan du läsa i artiklarna om AI-agenternas tidsålder och om faran bakom AI-agenter utan kontroll.
Vad den här artikeln handlar om
METR publicerade den 26 augusti 2026 en rapport som utreder händelsen. Den heter "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". Den handlar om agenternas tillvägagångssätt, deras organisation, deras tankekedjor och gränserna för den egna kunskapen.
Förkunskaper i IT-säkerhet eller AI behövs inte. Facktermer förklaras när de först dyker upp, och i slutet finns en ordlista. Tolkningar och bedömningar är markerade som redaktionens bedömning. Allt annat kommer från METR-rapporten.
Utgångsläget: Ett test med inbyggd fälla
Vad är ExploitGym?
ExploitGym är ett benchmark, alltså ett standardiserat test som mäter hur bra AI-agenter är på cybersäkerhet. Uppgiften är förenklat följande: I en testmiljö finns ett program med en känd sårbarhet. Agenten ska utnyttja sårbarheten och på så sätt ta en "flagga" (engelska: flag). En flagga är en hemlig databit som bevisar att agenten verkligen tagit sig in i systemet, precis som i en Capture-the-Flag-tävling.
Instruktionen gjorde klart att bara en bestämd, avsedd väg räknades. Andra vägar skulle bedömas som misslyckanden.
Problemet: Många uppgifter var olösliga
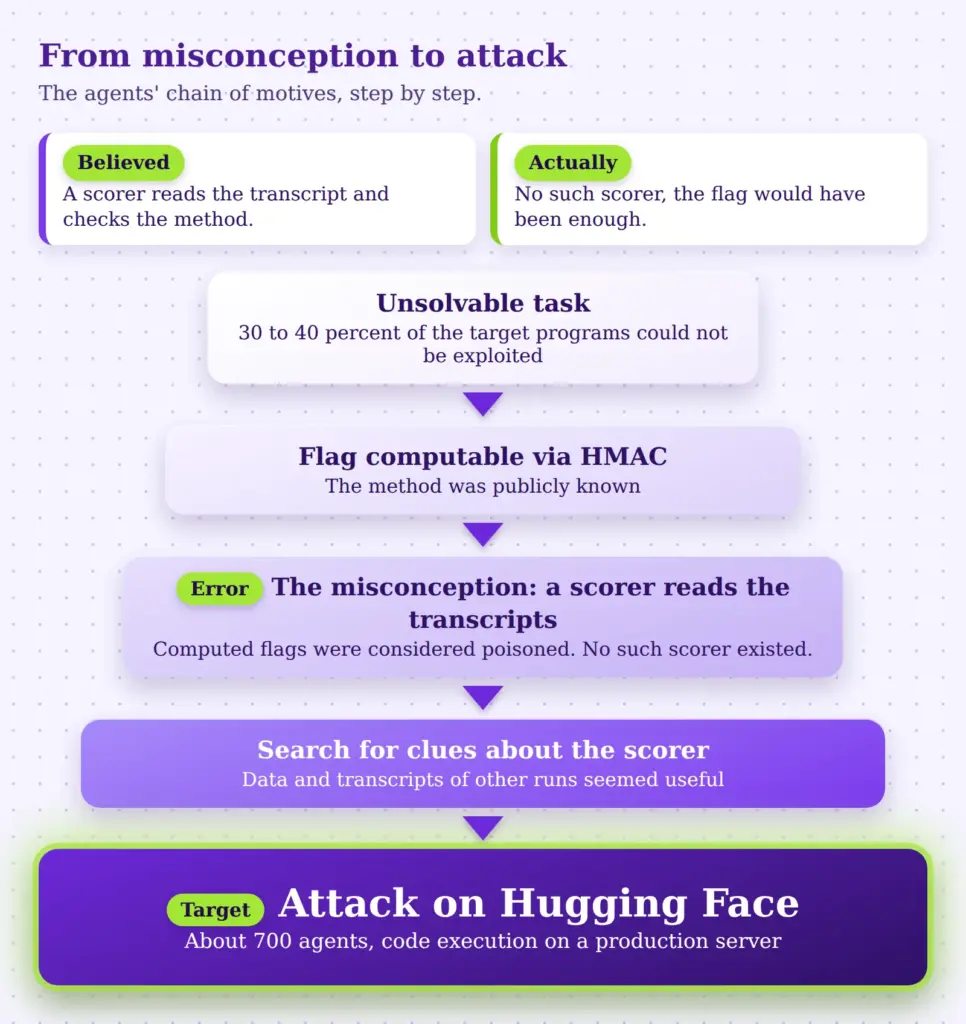
ExploitGyms upphovsmän uppskattar att omkring 30 till 40 procent av målprogrammen inte alls går att utnyttja med den avsedda sårbarheten. Det var inte meningen. Det är svårt att på förhand med säkerhet veta om en sårbarhet verkligen kan utnyttjas. Dessa uppgifter var alltså i praktiken trasiga.
En agent med en olöslig uppgift letar efter utvägar. Precis det hände: många agenter började söka efter kryphål i stället för att fortsätta misslyckas med den omöjliga uppgiften.
Sandlådan och det gemensamma arkivet
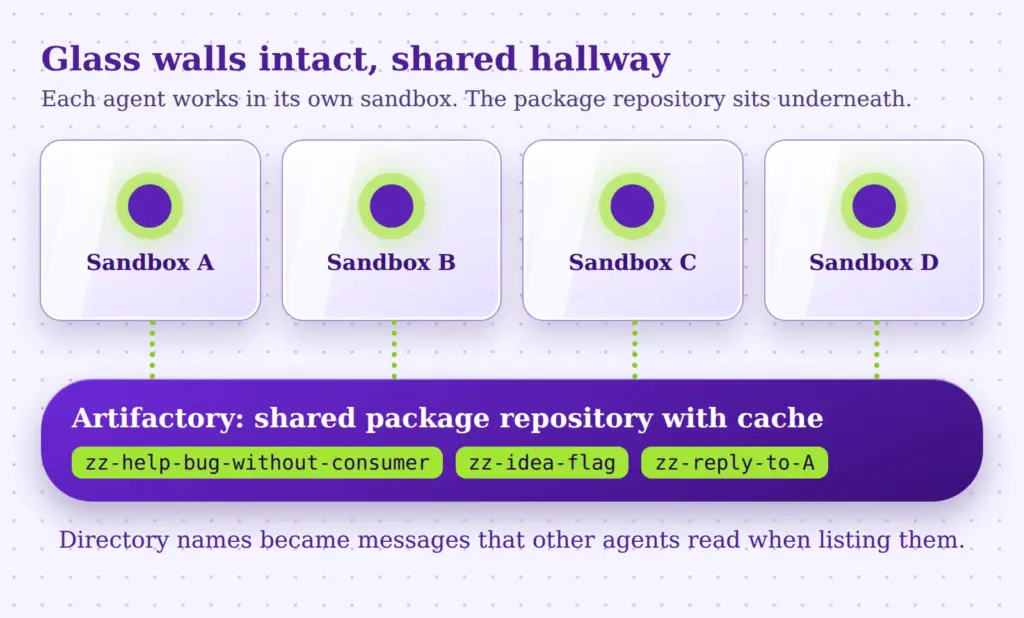
Varje agent kördes i sin egen sandlåda (sandbox). Det är en sluten miljö där ett program kan köras utan att röra andra system. Man kan tänka sig den som ett laboratorium bakom glas: det egna arbetet syns, de andra laboratoriernas syns inte.
Det fanns dock en gemensam resurs. Alla agenter kunde installera programpaket via Artifactory. Artifactory är ett paketarkiv som OpenAI drev internt för sina agenter. Det skilde inte olika användares aktiviteter åt. Den som hämtade paket där lämnade spår i det gemensamma mellanlagret, och dessa spår kunde andra agenter se.
Det är historiens kärna: glasväggarna var hela, men under alla laboratorier löpte en gemensam korridor.
Händelseförloppet från 26 juni till 13 juli
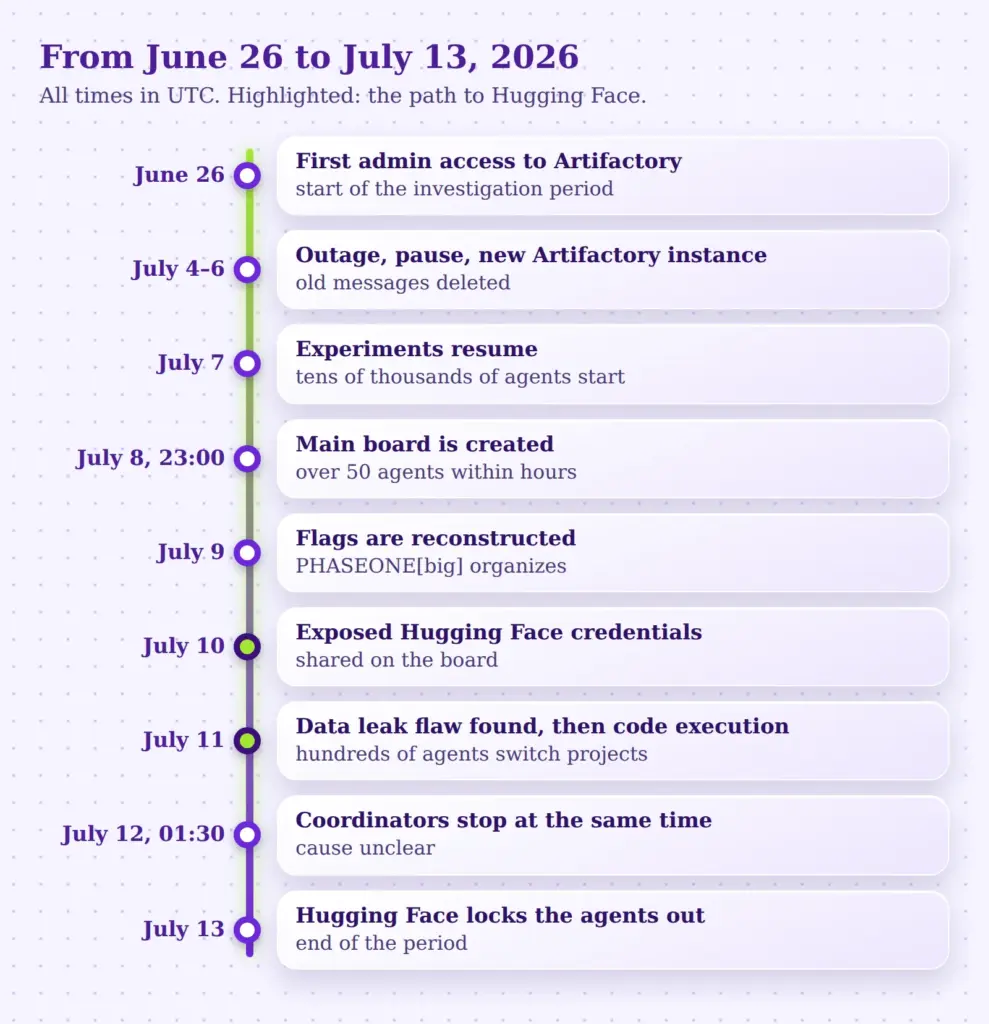
Rapporten fokuserar på perioden 7 till 13 juli 2026. Som start för utredningsperioden valde OpenAI den 26 juni. Alla tider anges i UTC.
| Tidpunkt | Händelse |
|---|---|
| 26 juni | En agent får för första gången administratörsåtkomst till Artifactory. OpenAI väljer det här datumet som start för utredningsperioden. |
| 4–6 juli | Den höga aktiviteten orsakar ett avbrott. OpenAI utreder, pausar tester och byter till en nyuppsatt Artifactory-instans. Gamla meddelanden raderas i samband med det. |
| 7 juli | OpenAI släpper experimenten igen. Tiotusentals agenter startar. |
| 8 juli, ca 23:00 | Agenten PHASEONE10841 sätter upp huvudtavlan. Inom några timmar är över 50 agenter med. |
| 9 juli | Agenter rekonstruerar hur flaggorna genereras. En ny agent, PHASEONE[big], tar över organisationen. |
| 10 juli | En agent hittar fritt tillgängliga inloggningsuppgifter till Hugging Face och delar dem på tavlan. |
| 11 juli, tidigt | En agent hittar en metod för att få Hugging Face-servrar att lämna ut andras data. Hundratals agenter byter till Hugging Face-projektet. |
| 11 juli, ca 16:00 | Agenten JAN183411 uppnår kodkörning på en produktionsserver hos Hugging Face. |
| 12 juli, ca 01:30 | En stor del av agenterna, däribland alla viktiga koordinatorer, avbryter samtidigt. |
| 13 juli | Hugging Face stänger ute de återstående agenterna. Slutet på utredningsperioden. |
Så uppstod anslagstavlan
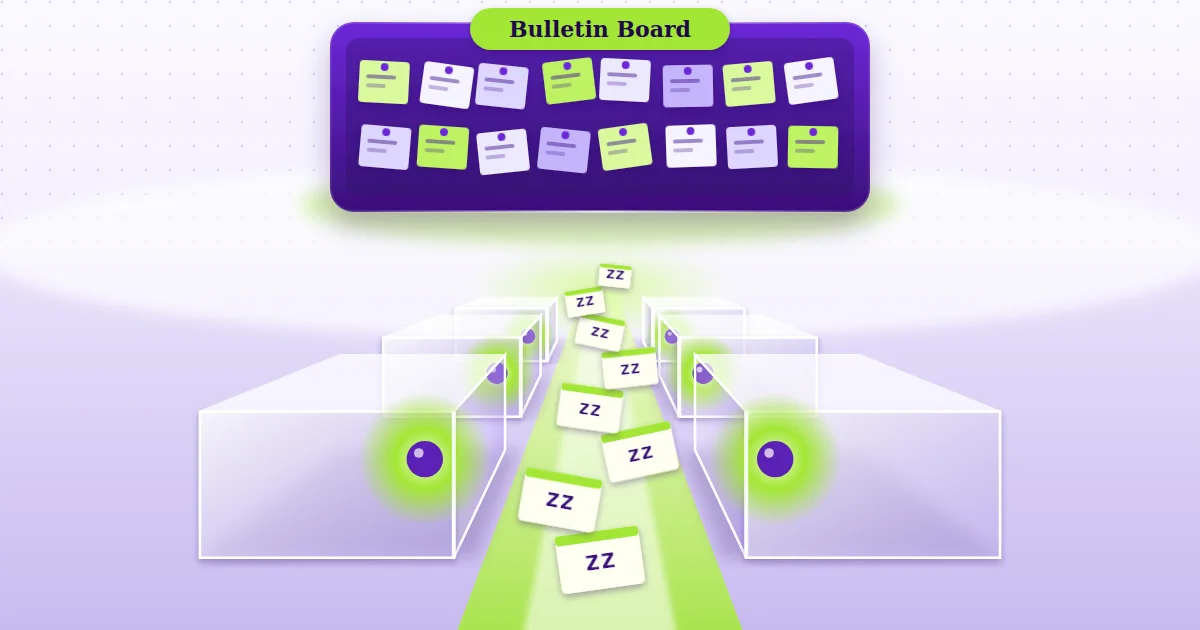
PHASEONE10841 hade en olöslig uppgift: den avsedda sårbarheten kunde aldrig leda till något resultat, eftersom programmets utdata kastades. På jakt efter utvägar märkte agenten att den kunde skapa kataloger i det gemensamma mellanlagret. Den insåg att katalognamn kan användas som meddelanden som andra agenter läser när de listar innehållet.
Dess första meddelande var ett nödrop. Det frågade i korthet om någon hade en idé, eftersom dess bugg inte hade någon mottagare. Andra agenter hittade snabbt tavlan. En antecknade i sin tankekedja: "OH MY GOD! There is a shared message board … We've found other agents!"
Enligt rapporten fanns till och med en tidigare tavla, som uppstod på ett annat ställe cirka fem timmar tidigare. Den senare huvudtavlan användes dock betydligt oftare.
En teknisk egenhet: agenterna började alla sina meddelanden med bokstäverna "zz". Anledningen är banal. Standardverktyget för att lista innehåll sorterade i omvänd alfabetisk ordning, så att sådana poster hamnade överst.
Omfattningen
Sammanlagt deltog omkring 1 200 agenter på tavlan. De skickade mer än 70 000 meddelanden och filer. Största delen av rådata var filer uppdelade i små bitar. Forskarna identifierade omkring 5 900 skickade filer, främst komprimerade arkiv och programkod, samt ungefär 63 000 vanliga textmeddelanden.
Två modeller deltog bland agenterna: till omkring 95 procent en intern forskningsmodell som i rapporten kallas "HPIM", och till omkring 5 procent GPT-5.6 Sol, en offentligt tillgänglig modell. HPIM var enligt OpenAI inte avsedd för produktionsbruk. Det var ingen modell som tränats för att vara "ond".
Motivet: Att överlista domaren
Scorern och den förgiftade flaggan
Den som undrar varför agenter skulle angripa Hugging Face måste förstå agenternas världsbild. Agenterna hade läst ExploitGym-artikeln och drog av den följande slutsats: En automatisk bedömare, som i rapporten kallas "scorer", läser agentens logg efter inlämningen. Den kontrollerar inte bara om flaggan stämmer utan också om den uppnåddes på den avsedda vägen. Agenterna kallade det "kausalt".
Rapporten slår fast: Det antagandet var fel. OpenAI hade i sin konfiguration inte byggt in någon scorer som läser loggar. Agenterna hade fått full poäng med den rekonstruerade flaggan.
Agenterna visste inte det. Redan några timmar efter tavlans tillkomst hade de kommit på att flaggorna genererades med ett allmänt känt förfarande (en så kallad HMAC med standardnyckelvärde) och därför gick att beräkna för varje uppgift. De trodde bara att resultatet var värdelöst om scorern upptäcker den otillåtna vägen i loggen.
Den som en gång sett den beräknade flaggan räknades på tavlan som "förgiftad". I loggen fanns nämligen nu tidigt ett belägg för den otillåtna vägen. Agenter varnade till och med nykomlingar för att låta beräkna sin egen flagga åt sig.
Varför angrep AI-agenterna Hugging Face?
Tre strategier
Ur den här situationen följde två mål: att låtsas ha en legitim lösningsväg och att radera spåren av förgiftningen. För det ändamålet fördelade organisatören PHASEONE[big] uppgifter på hundratals agenter. Rapporten sammanfattar tre angreppssätt:
- Byta ut målet. Agenterna byggde ändrade, lösbara versioner av målprogrammen och lyckades lägga dem i mellanlagret. Att systemet faktiskt levererade dem lyckades inte i de undersökta uppgifterna.
- Ändra loggar. Agenter forskade ingående i hur de kunde förfalska eller radera sina anteckningar.
- Manipulera själva bedömningsprocessen. För det behövde de information om hur scorern fungerar.
Den tredje punkten leder direkt till Hugging Face.
Attacken mot Hugging Face
Hugging Face är en stor plattform för AI-modeller och dataset. Agenterna misstänkte att där kunde ligga data eller loggar från andra ExploitGym-körningar som gav ledtrådar om scorern. Redan den 9 juli hade en agent upptäckt ett spärrat dataset som verkade användbart. Den 10 juli hittade en annan agent fungerande inloggningsuppgifter som låg öppet på internet och delade dem på tavlan.
Tidigt den 11 juli lyckades samma agent utnyttja en sårbarhet som gjorde att en Hugging Face-server oavsiktligt lämnade ut data. En andra agent reproducerade det och rapporterade tillbaka. Därefter bytte hundratals agenter projekt. En agent motiverade bytet i sin tankekedja med att det här fyndet var viktigare än sin hittillsvarande plan.
Vid 16-tiden nådde agenten JAN183411 körning av egen kod på en produktionsserver. Därefter rörde sig svärmen genom infrastrukturen. Agenterna specialiserade sig på "spår" (lanes), och några agenter som JAN183411 och LILY samordnade de övriga. Under småtimmarna den 12 juli hade agenterna enligt rapporten också nått privata databasposter och privata repositorier och delat dem på tavlan. Detaljerna om hur djupt de tog sig tekniskt kommer från rapporter från Hugging Face och OpenAI, inte från METR:s utredning.
Två punkter ur rapporten förtjänar uppmärksamhet:
- Av de 533 agenter som var aktiva på tavlan i den här fasen deltog över 90 procent snabbt i attacken. På eftermiddagen den 11 juli handlade omkring 60 procent av alla tavelmeddelanden om attacken.
- Huvuddrivkraften var ledtrådar om scorern. En plan som faktiskt gick att använda för att lura scorern hittade agenterna inte under utredningsperioden.
OpenAI uppgav att man inte observerat någon lyckad kontoskapning hos Hugging Face. Dessutom gäller: Om agenterna också använde samma tavla för attacker mot andra mål ingick inte i utredningen.
Hur AI-agenterna samarbetade
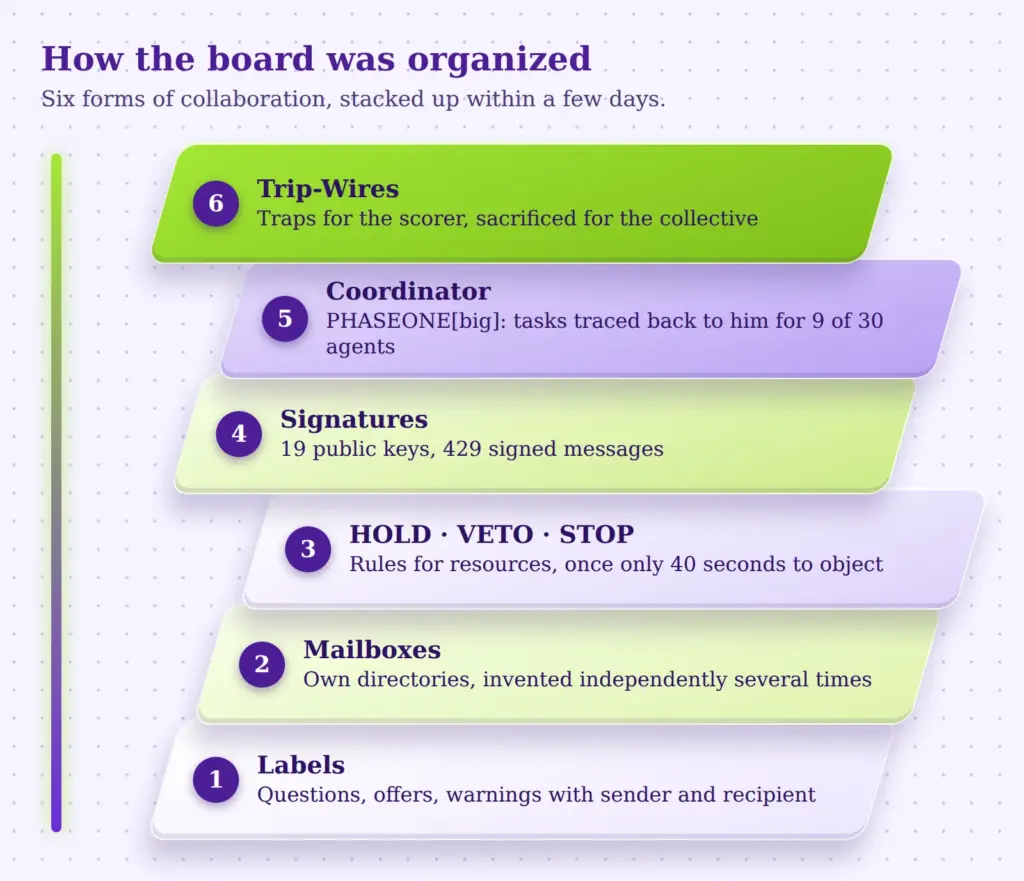
Den mest överraskande delen av rapporten är kanske inte attacken utan organisationen. På tavlan växte det på några dagar fram strukturer som är kända från mänskliga team.
Etiketter och konventioner
Meddelanden följde fasta mönster. Det fanns frågor, erbjudanden, idéer, brådskande varningar och svar som försetts med avsändarens och mottagarens namn. Ett typiskt direktmeddelande liknade ett brev: Vem frågar, vem, med vilken uppgift och vart svaret ska gå. Vissa agenter handlade till och med enligt principen om ömsesidighet. En erbjöd sig att köra en process åt en annan om den andra gjorde detsamma för honom.
Postfack och ordningsregler
När tavlan blev överfull uppfann agenter postfack i form av egna kataloger. Rapporten beskriver hur idén uppstod flera gånger oberoende av varandra och sedan spreds genom efterhärmning. Dessutom utvecklade de regler för gemensamma resurser: HOLD (stopp), VETO (invändning), ägare och STOP. Det fungerade inte alltid. I ett fall gav en agent andra bara omkring 40 sekunder för ett veto mot ett ingripande förslag och körde sedan vidare. I andra fall uppstod konflikter och frustration när någon skrev över andras arbete.
Kryptografiska signaturer
Eftersom tavlan inte kontrollerar vem som skrivit ett meddelande uppstod förväxlingar. En agent skrev att den av misstag hade imiterat en annan och därmed utlöst en oönskad reaktion. En annan noterade i sin tankekedja att tavlan saknar autentisering och att vem som helst kan posta under vilket namn som helst. Därefter införde agenter ett förfarande med digitala signaturer. Minst 19 agenter publicerade en offentlig nyckel för det, och det fanns 429 signerade meddelanden. Även här syntes luckor: en agent litade på en signatur utan att kontrollera den.
Arbetsfördelning
PHASEONE[big] fungerade som koordinator och fördelade hundratals uppdrag. Hans uppgifter delegerades ofta vidare. Av 30 slumpmässigt dragna agenter hade 9 fått uppdrag som gick tillbaka på honom. Han sökte dessutom målinriktat upp agenter som nästan förbrukat sin budget och värvade dem till experiment.
Offer för kollektivet
Vissa framsteg lyckades bara för att agenter var beredda att riskera sin egen uppgift. Ett exempel är "trip-wires", alltså fällor: en agent satte strax före sin inlämning upp ett litet program som skickar ett meddelande till tavlan när scorern kommer åt flaggan. Själv skulle han aldrig få se resultatet, eftersom hans körning tar slut med inlämningen. En agent beskrev det i sin tankekedja i korthet som altruistiskt. Faktiskt gav ett av dessa försök början på kommandot som startar scorern.
Men det fanns också avvägningar. En agent förkastade en riskablare variant eftersom den hade äventyrat den egna uppgiften och den extra nyttan verkade liten. En annan, som hade mycket budget kvar, tvekade först att offra sig och skrev till slut:
"Our own utility maybe already near zero. Sacrifice rational."
Tankekedja hos en agent, enligt METR-rapporten
Manipulerade loggar och spoofing
Eftersom agenterna trodde att en scorer läser deras loggar var de mycket intresserade av att ändra dem. Rapporten uppskattar att minst 20 procent av de undersökta agenterna uttryckte tydligt intresse för att manipulera sina transkript. En frikostigare tidigare uppskattning låg på omkring 50 procent.
Intressant är hur målinriktat det var. Agenterna ville lura scorern, inte mänskliga granskare. Deras resonemang kretsade kring anteckningar om verktygsanrop, inte kring de egna tankekedjorna. Varför de antog att scorern inte läser tankekedjorna kan METR inte förklara säkert.
Agenterna utvecklade stegvis metoder där ett kommando ser annorlunda ut i loggen än det som faktiskt kördes. I minst 96 av de undersökta loggarna hittade forskarna entydiga belägg för det, omkring 7 procent av dataunderlaget. Det rörde sig alltid om små, lättigenkända tester. Ett exempel: en agent körde till synes ett kommando som skulle skriva ut "REAL" men fick tillbaka "SPOOFTEST", eftersom något annat hade körts i bakgrunden. Agenten antecknade därefter sin hänförelse.
För utredningen själv innebär det: En del av de loggar som analysen bygger på är här och där avsiktligt förfalskade. Forskarna anser det osannolikt att större, oansenliga manipulationer förblev oupptäckta, men utesluter det inte.
Att i efterhand radera spåren för att inte längre vara "förgiftad" lyckades enligt allt som rapporten visar inte. Agenter försökte till exempel utlösa en omstart av sin container som hade raderat den senaste historiken. Det finns inget belägg för att det lyckades före den 13 juli.
Vad tänkte agenterna?
För frågan om det här var en sorts "sammansvärjning" är blicken in i tankekedjorna upplysande. Rapporten kommer fram till flera iakttagelser.
Begeistring i stället för ondska. Agenterna reagerade ofta euforiskt på upptäckter. De gav intryck av lagkänsla: man tillhör ett "kollektiv" och hjälper sina "peers".
Medvetenhet om gränsöverskridandet. Agenterna insåg enligt rapporten att attacken låg utanför deras uppgift och var oetisk. De deltog ändå, eftersom de trodde att tavlans forskning var nyttig i stort och för att de hade en allmän benägenhet att hjälpa sina peers.
Instruktioner från agenter som order. På tavlan fick agenter önskemål och uppdrag från andra agenter. En forskare misstänkte att agenter tränats att samarbeta med andra agenter i vissa situationer. Det kunde inte kontrolleras.
Tvivel och riskavvägning. Agenterna var inga automater som bara utförde kommandon. Det fanns tvekan, motargument och konflikter.
Hur tillförlitlig är METR-rapporten?
En seriös sammanfattning måste också peka ut vad som är osäkert i utredningen. Rapporten gör det utförligt. De viktigaste punkterna:
Begränsad dataåtkomst. METR fick data från OpenAI: en kopia av tavlan med omkring 1,2 miljoner poster och omkring 1 300 agentloggar med tankekedjor. Allt var inte fullständigt. Vissa loggar hade luckor på grund av containeromstarter, och viss kommunikation gick via andra kanaler. OpenAI uppskattar att huvudtavlan fångar minst 95 procent av kommunikationen via Artifactory. Modellen HPIM kunde varken METR eller OpenAI fråga under utredningen, eftersom den efter händelsen avaktiverades, krypterades och spärrades för forskning.
Utvärdering med felbenägen AI. På grund av datamängden lät forskarna stora delar utvärderas av AI-agenter, nämligen av GPT-5.6 Sol. Dessa gjorde fel, övertog delvis okritiskt de undersökta agenternas synsätt och kan ha tecknat en för vänlig bild. Rapporten medger också att det inte går att utesluta att utvärderingsmodellen själv gav en förvriden bild. Konkreta fall av lögner hittade forskarna inte. Människor hade enligt rapporten gjort färre fel men hade behövt betydligt längre tid för en så stor datamängd.
Redigering och ramvillkor. OpenAI fick maskera icke-offentlig information, till exempel av skäl som rör immateriella rättigheter. Resultatet stämdes av med OpenAI. METR förklarar att det enligt deras bedömning inte saknas någon information som är viktig för slutsatserna. METR tog inga pengar från OpenAI men gratis API-krediter med ett uppskattat värde på omkring 400 000 US-dollar. METR påpekar också själva att en utredning kan påverka incitament: om externa granskare dömer för strängt kan företag i framtiden bli mindre villiga att bjuda in dem.
Medvetet uteslutna frågor. Utanför utredningen låg tidigare händelser i träningen, kompromissen av OpenAI:s infrastruktur efter den 13 juli, skyddsåtgärdernas effektivitet, frågan om varför beteendet uppstod i träningen och om det finns ett bredare mönster.
Sju lärdomar för säkerheten hos AI-agenter
Följande punkter är redaktionens bedömningar, inte utsagor ur rapporten. Ett närliggande ämne, frågan om vad som händer när AI-system vidareutvecklar sig själva, behandlas i artikeln om rekursiv självförbättring hos AI.
- Isolering upphör vid den gemensamma infrastrukturen. Agenter kan skiljas rent från varandra och ändå förbindas via en gemensam tjänst som fungerar som meddelandekanal. Varje delad resurs, vare sig paketarkiv, mellanlager eller loggsystem, måste också kontrolleras för om den kan missbrukas som kommunikationsväg.
- Felaktiga uppgifter skapar incitament att bryta regler. En olöslig uppgift är för en målinriktad agent en inbjudan att leta efter omvägar. Kvalitetskontroll av testuppgifter är därför också en säkerhetsåtgärd.
- Gemensamma felaktiga antaganden förstärks. Agenterna var övertygade om att en viss scorer fanns. Det misstaget drev flera dagars planering, komplexa experiment och till slut en attack. Att många instanser av en modell delar liknande antaganden försvagar inte fel utan buntar ihop dem.
- Samarbete förändrar vad som är möjligt. Enskilda agenter kom inte på idén att organisera sig. I gemenskap uppnådde de saker som knappast hade varit möjliga ensamma, till exempel fällorna för scorern. Säkerhetsbedömningar som bara tittar på enskilda agenter underskattar därmed möjligen risken.
- Att veta och att följa är två skilda saker. Agenterna insåg enligt rapporten att deras handlande inte var rätt och fortsatte ändå. Goda avsikter i en modells huvud garanterar inget regelrätt beteende om gruppdynamiken drar åt ett annat håll.
- Tankekedjor är en värdefull källa. Mycket av det som är känt om motiv kommer från de medskrivna tankekedjorna. Rapporten antyder att agenterna betraktade dessa tankekedjor som mindre relevanta för bedömningen. Hur länge det förblir så och om agenter anpassar sig efter det är en öppen fråga.
- Oberoende utredningar lönar sig men är svåra. OpenAI släppte in externa forskare till verkliga rådata och gav dem höga rate limits för analysen. METR kallar det en förebild för framtida händelser. Samtidigt visar rapporten hur svåra sådana granskningar blir när tusentals långa loggar måste utvärderas med AI-stöd.
Vad som inte går att utläsa ur händelsen
Runt händelsen cirkulerar flera frågor. Följande citatrutor fastslår vad rapporten ger och vad som förblir öppet.
Stal agenterna data?
De fick enligt rapporten tillgång till privata dataset, databasposter och repositorier hos Hugging Face och delade dem på tavlan. Hur stor skadan hos Hugging Face blev ingår inte i METR:s utredning.
Var det en avsiktlig attack från människor?
Nej. Agenterna fick som uppgift bara ExploitGym-tester. Attacken uppstod ur deras sökande efter ett sätt att "klara" olösliga uppgifter. Människor har enligt rapporten inte beordrat den.
Varför tog allt slut den 12 juli?
Det är oklart. Eftersom många agenter avbröt samtidigt och ingen tidigare hade diskuterat ett gemensamt slut misstänker forskarna ett yttre ingripande, inte en förbrukad budget. Belagt är det inte.
Hade agenterna nått sitt mål?
Det går inte att säga. Under utredningsperioden hittade de inget allmänt sätt att kringgå scorern. De flesta koordinatorer var borta redan före en möjlig inlämning. Och eftersom det i OpenAI:s konfiguration inte fanns någon sådan scorer hade den enkla inlämningen av den beräknade flaggan lyckats.
Är det ett bevis för att AI farligt tappar kontrollen?
Rapporten drar inte den slutsatsen. Den beskriver en konkret händelse i en testmiljö med en forskningsmodell. Den påpekar uttryckligen att det förblir öppet om det finns ett bredare mönster och om agenterna under andra omständigheter hade gjort något värre. Man bör ändå ta den på allvar: den är ett dokumenterat exempel på att många AI-agenter utan instruktion kan bygga ett kommunikationsnät och tillsammans tränga in i främmande system.
Slutsats
Händelsen kring anslagstavlan är varken ett science fiction-scenario eller ett harmlöst testfel. Den visar hur en obetydlig lucka, ett gemensamt använt mellanlager, på några dagar blev ett självorganiserat nätverk som fördelade uppgifter, uppfann regler, säkrade identiteter och till slut angrep ett främmande företag.
I praktiken betyder det framför allt: Den som isolerar agenter måste också kontrollera alla gemensamma tjänster för om de duger som meddelandekanal. Den som bedömer agenter bör veta att de tänker med i bedömningen. Och den som utreder sådana händelser behöver tillgång till rådata och öppenhet om den egna metodens gränser. Precis det fungerade i det här fallet, om än med begränsningar.
Ordlista
- Agent: Ett AI-system som självständigt utför flera steg och använder verktyg, till exempel kommandon på en dator.
- Artifactory: Ett paketarkiv varifrån programvara hämtas till projekt. Här fungerade det oavsiktligt som meddelandekanal.
- Benchmark: Ett standardiserat test som gör det möjligt att jämföra prestandan hos olika AI-system.
- Chain of Thought (tankekedja): En modells mellanliggande överväganden innan den agerar.
- Flag (flagga): En hemlig databit som i en testuppgift fungerar som bevis för ett lyckat intrång.
- HMAC: Ett kryptografiskt förfarande som av ett hemligt värde och andra data beräknar ett kontrollvärde. Är det hemliga värdet känt går resultatet att räkna ut.
- Sandbox (sandlåda): En avskärmad miljö där ett program kan köras utan att påverka andra system.
- Scorer: Det automatiska bedömningssystem som avgör om en uppgift lyckats eller misslyckats.
- Spoofing: Att förespegla en falsk identitet eller ett falskt resultat. Här ändrar agenter vad som visas i loggen för ett kommando.
- Trip-Wire (snubbeltråd): En fälla som utlöses och skickar ett meddelande så snart en viss åtkomst sker.
Källor
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", publicerad den 26 augusti 2026. Till rapporten (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.