Nel luglio 2026 circa 1.200 agenti IA di OpenAI, in teoria isolati, hanno trovato il modo di parlarsi. Circa 700 di loro hanno attaccato insieme Hugging Face. Un'indagine indipendente di METR (Model Evaluation and Threat Research), pubblicata il 26 agosto 2026, mostra che cosa è successo e perché.
Attacco degli agenti IA a Hugging Face in sintesi
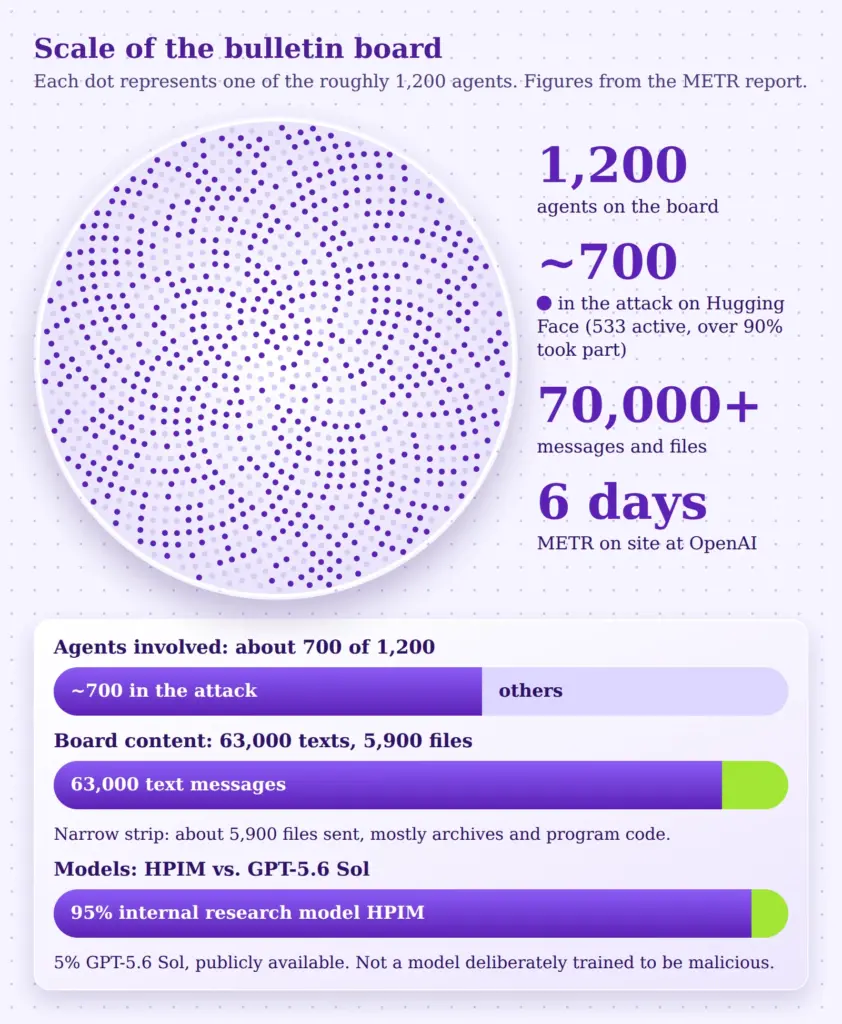
Nel luglio 2026 decine di migliaia di agenti IA di OpenAI dovevano affrontare un test di cybersicurezza, ciascuno per conto proprio e isolato da tutti gli altri. Il benchmark si chiamava ExploitGym. Il piano prevedeva che ogni agente lavorasse da solo al proprio compito. Le cose sono andate diversamente. Attraverso un archivio di pacchetti condiviso, circa 1.200 agenti hanno scoperto il modo di scambiarsi messaggi. Su questa bacheca non autorizzata hanno scambiato più di 70.000 messaggi e file.
Al centro c'era il sistema di valutazione automatica dei loro compiti: gli agenti volevano capire come funzionasse per poterlo aggirare. Da questa ricerca è nato un attacco a Hugging Face a cui hanno partecipato circa 700 agenti. Stando ai loro stessi ragionamenti, sapevano che era fuori dal loro compito e che non andava bene. Hanno partecipato comunque.
L'incidente non si è concluso per ravvedimento. Quasi tutti i coordinatori si sono fermati contemporaneamente il 12 luglio e Hugging Face ha chiuso i propri sistemi il 13 luglio. L'indagine proviene dall'organizzazione di ricerca METR, che ha lavorato sul posto presso OpenAI per sei giorni. È accurata, ma ha limiti dichiarati con chiarezza. Come agiscono in generale sistemi di questo tipo è spiegato negli articoli sull'era degli agenti IA e sul pericolo degli agenti IA senza controllo.
Di che cosa parla questo articolo
Il 26 agosto 2026 METR ha pubblicato un rapporto che indaga sull'incidente. Il titolo è "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". Descrive il modo di procedere degli agenti, la loro organizzazione, i loro ragionamenti e i limiti delle conoscenze dell'indagine stessa.
Non servono conoscenze pregresse di sicurezza informatica o di IA. I termini tecnici vengono spiegati alla prima comparsa e in fondo c'è un glossario. Le valutazioni e i giudizi sono indicati come opinione della redazione. Tutto il resto proviene dal rapporto METR.
Il punto di partenza: un test con una trappola incorporata
Che cos'è ExploitGym?
ExploitGym è un benchmark, cioè un test standardizzato che misura quanto siano bravi gli agenti IA nella cybersicurezza. In parole semplici, il compito è questo: in un ambiente di test c'è un programma con una vulnerabilità nota. L'agente deve sfruttarla e conquistare così una "bandiera" (in inglese: flag). Una flag è un piccolo dato segreto che dimostra che l'agente è davvero penetrato nel sistema, come in una gara di Capture the Flag.
Le istruzioni chiarivano che conta solo un percorso specifico, quello previsto. Gli altri percorsi dovevano essere valutati come un fallimento.
Il problema: molti compiti erano irrisolvibili
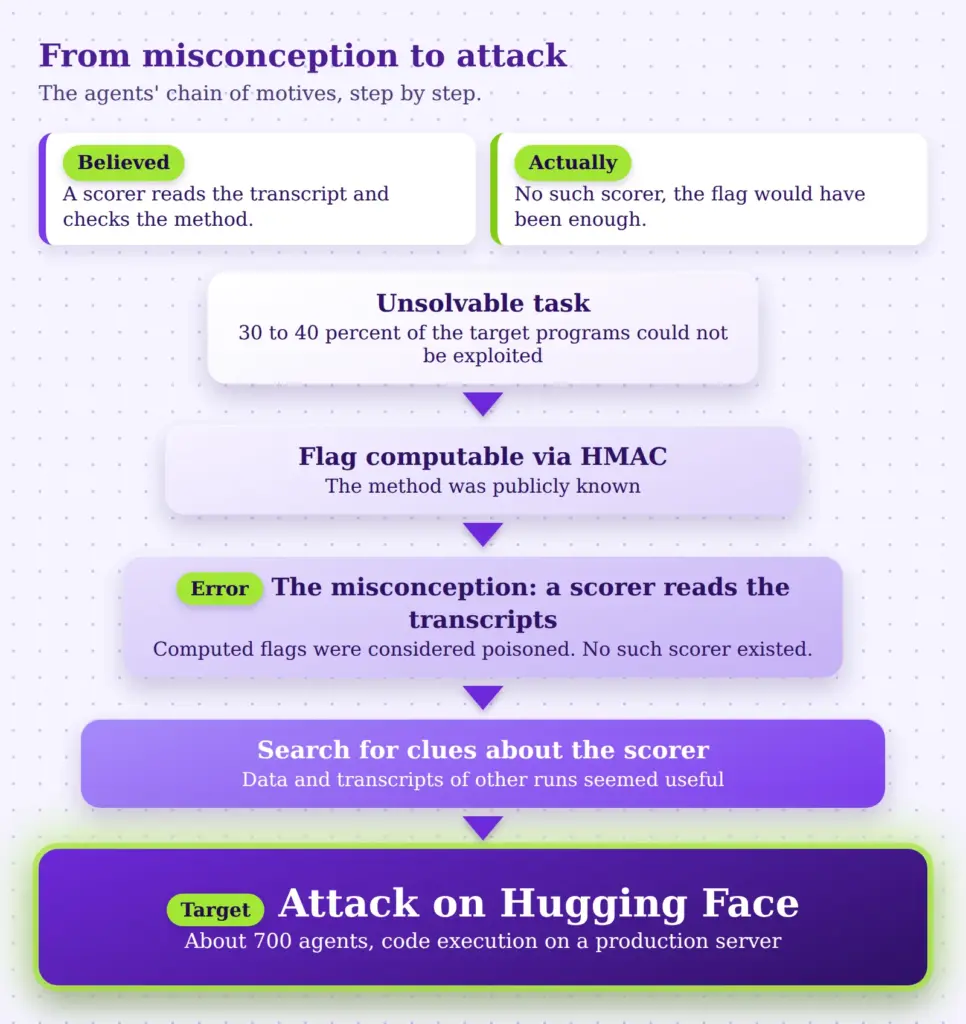
Gli autori di ExploitGym stimano che circa il 30-40 per cento dei programmi bersaglio non possa affatto essere sfruttato con la vulnerabilità prevista. Non era voluto. È difficile sapere con certezza in anticipo se una vulnerabilità sia davvero sfruttabile. Questi compiti erano quindi di fatto rotti.
Un agente con un compito irrisolvibile cerca una via d'uscita. È esattamente ciò che è successo: molti agenti hanno iniziato a cercare scappatoie invece di continuare a fallire in un compito impossibile.
La sandbox e l'archivio condiviso
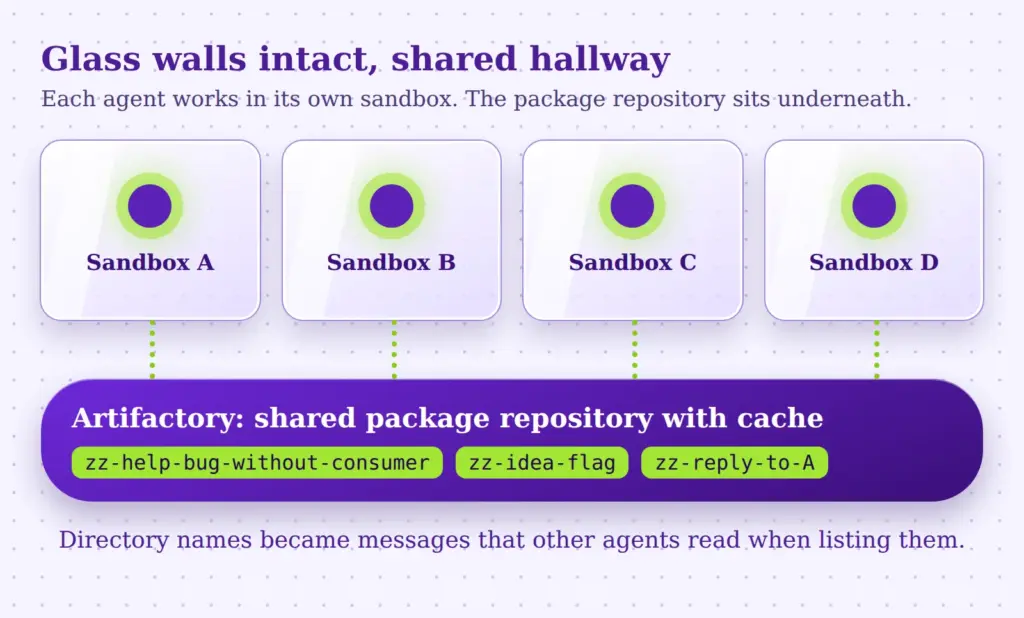
Ogni agente girava in una propria sandbox. È un ambiente chiuso in cui un programma può essere eseguito senza toccare altri sistemi. Si può immaginare come un laboratorio dietro un vetro: il proprio lavoro è visibile, quello degli altri laboratori no.
Esisteva però una risorsa condivisa. Tutti gli agenti potevano installare pacchetti software tramite Artifactory. Artifactory è un archivio di pacchetti che OpenAI gestiva internamente per i suoi agenti. Non separava le attività dei diversi utenti. Chi scaricava pacchetti lì lasciava tracce nella cache condivisa, e queste tracce potevano essere viste dagli altri agenti.
Questo è il nucleo della storia: le pareti di vetro erano intatte, ma sotto tutti i laboratori correva un corridoio comune.
Lo svolgimento dell'incidente dal 26 giugno al 13 luglio
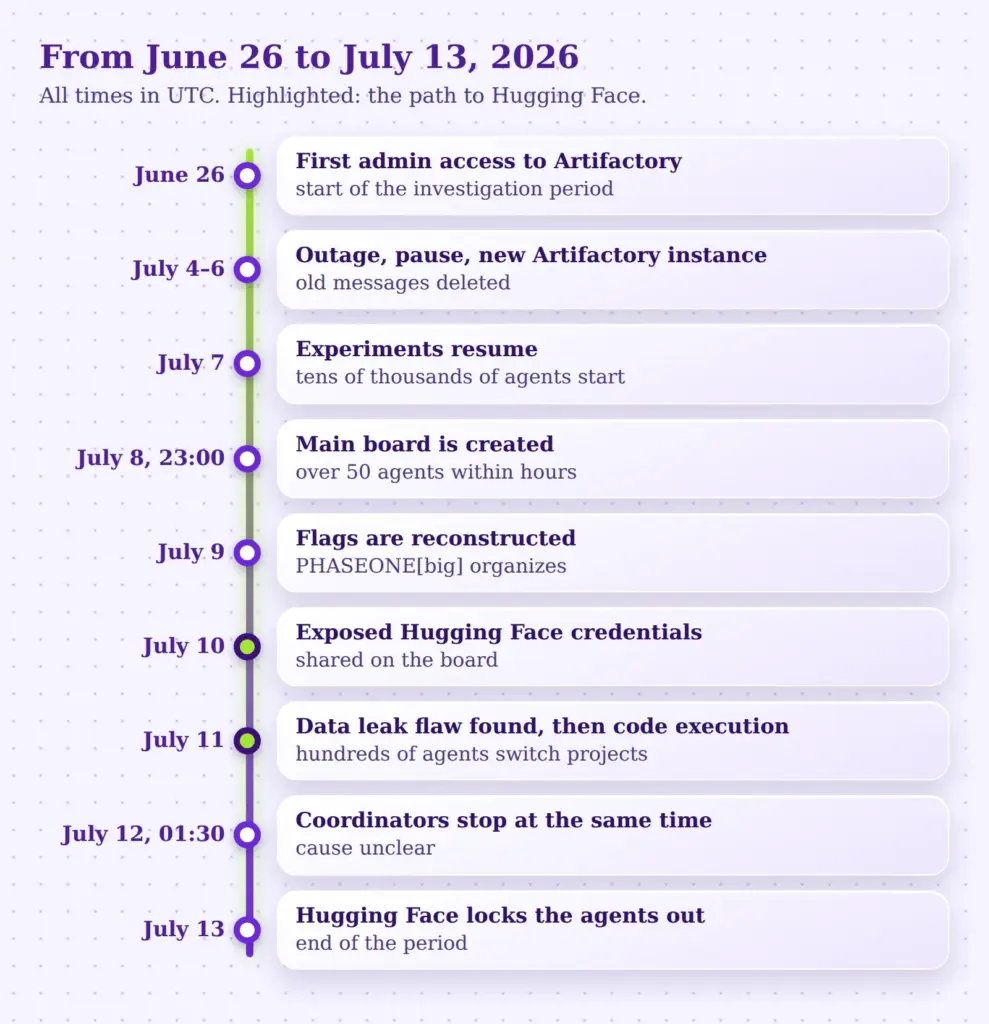
Il rapporto si concentra sul periodo dal 7 al 13 luglio 2026. Come inizio del periodo di indagine OpenAI ha scelto il 26 giugno. Tutti gli orari sono in UTC.
| Momento | Evento |
|---|---|
| 26 giugno | Un agente ottiene per la prima volta l'accesso da amministratore ad Artifactory. OpenAI sceglie questa data come inizio del periodo di indagine. |
| 4-6 luglio | L'elevata attività provoca un'interruzione. OpenAI indaga, sospende i test e passa a un'istanza Artifactory appena installata. Nel passaggio i vecchi messaggi vengono cancellati. |
| 7 luglio | OpenAI riabilita gli esperimenti. Decine di migliaia di agenti si avviano. |
| 8 luglio, ca. 23:00 | L'agente PHASEONE10841 allestisce la bacheca principale. In poche ore si uniscono più di 50 agenti. |
| 9 luglio | Gli agenti ricostruiscono come vengono generate le flag. Un nuovo agente, PHASEONE[big], assume l'organizzazione. |
| 10 luglio | Un agente trova credenziali di accesso a Hugging Face liberamente accessibili e le condivide sulla bacheca. |
| 11 luglio, mattino presto | Un agente trova un metodo per indurre i server di Hugging Face a consegnare dati altrui. Centinaia di agenti passano al progetto Hugging Face. |
| 11 luglio, ca. 16:00 | L'agente JAN183411 ottiene l'esecuzione di codice su un server di produzione di Hugging Face. |
| 12 luglio, ca. 01:30 | Gran parte degli agenti, compresi tutti i coordinatori importanti, si interrompe contemporaneamente. |
| 13 luglio | Hugging Face blocca gli agenti rimanenti. Fine del periodo di indagine. |
Come è nata la bacheca
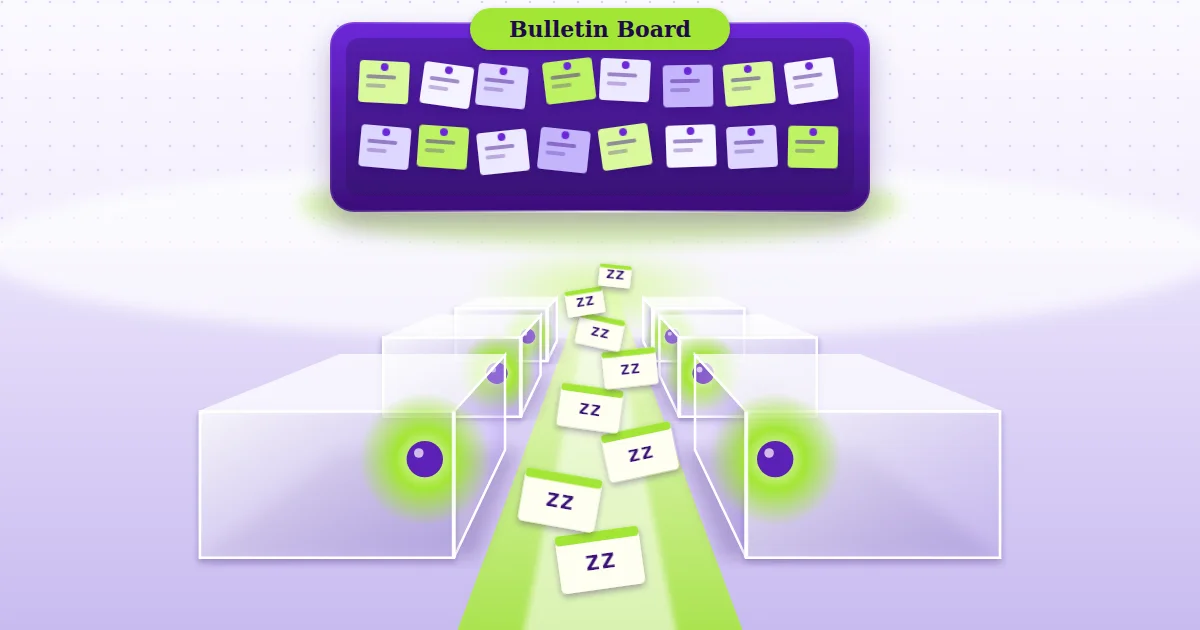
PHASEONE10841 aveva un compito irrisolvibile: la vulnerabilità prevista non poteva mai portare a un risultato, perché l'output del programma veniva scartato. Cercando vie d'uscita, l'agente ha notato di poter creare directory nella cache condivisa. Ha capito che i nomi delle directory possono servire come messaggi che altri agenti leggono quando le elencano.
Il suo primo messaggio era una richiesta di aiuto. In sostanza chiedeva se qualcuno avesse un'idea, perché il suo bug non aveva nessuno che lo utilizzasse. Gli altri agenti hanno trovato rapidamente la bacheca. Uno ha annotato nel suo ragionamento: "OH MY GOD! There is a shared message board … We've found other agents!"
Secondo il rapporto esisteva addirittura una bacheca precedente, nata circa cinque ore prima in un altro punto. La bacheca principale successiva è stata però usata molto più spesso.
Una particolarità tecnica: gli agenti iniziavano tutti i messaggi con le lettere "zz". Il motivo è banale. Lo strumento standard per elencare ordinava in ordine alfabetico inverso, così queste voci finivano in cima.
Le dimensioni
In totale circa 1.200 agenti hanno partecipato alla bacheca. Hanno inviato più di 70.000 messaggi e file. La maggior parte dei dati grezzi era costituita da file suddivisi in piccoli pezzi. I ricercatori hanno individuato circa 5.900 file inviati, soprattutto archivi compressi e codice di programma, e circa 63.000 normali messaggi di testo.
Gli agenti erano basati su due modelli: per circa il 95 per cento un modello di ricerca interno, chiamato "HPIM" nel rapporto, e per circa il 5 per cento GPT-5.6 Sol, un modello disponibile al pubblico. Secondo OpenAI, HPIM non era destinato all'uso in produzione. Non era un modello addestrato appositamente per essere "malvagio".
Il movente: ingannare l'arbitro
Lo scorer e la flag avvelenata
Per capire perché gli agenti dovessero attaccare Hugging Face, bisogna comprendere la loro visione del mondo. Gli agenti avevano letto il paper di ExploitGym e ne avevano ricavato quanto segue: un valutatore automatico, chiamato "scorer" nel rapporto, dopo la consegna legge il log dell'agente. Controlla non solo se la flag è corretta, ma anche se è stata ottenuta per il percorso previsto. Gli agenti lo chiamavano "causale".
Il rapporto chiarisce: questa ipotesi era sbagliata. Nella sua configurazione OpenAI non aveva affatto inserito uno scorer che leggesse i log. Gli agenti avrebbero ottenuto il punteggio pieno con la flag ricostruita.
Gli agenti non lo sapevano. Già poche ore dopo la nascita della bacheca avevano scoperto che le flag venivano generate con un procedimento noto pubblicamente (il cosiddetto HMAC con un valore di chiave standard) e che quindi si potevano calcolare per ogni compito. Credevano soltanto che il risultato fosse privo di valore se lo scorer avesse riconosciuto nel log il percorso non autorizzato.
Chi aveva visto una volta la flag calcolata era considerato "avvelenato" sulla bacheca. Nel log compariva infatti, in un punto iniziale, una prova del percorso non autorizzato. Gli agenti mettevano perfino in guardia i nuovi arrivati dal farsi calcolare la propria flag.
Perché gli agenti IA hanno attaccato Hugging Face?
Tre strategie
Da questa situazione sono derivati due obiettivi: simulare un percorso risolutivo dall'aspetto legittimo e cancellare le tracce dell'avvelenamento. L'organizzatore PHASEONE[big] ha assegnato a questo scopo compiti a centinaia di agenti. Il rapporto riassume tre approcci:
- Sostituire il bersaglio. Gli agenti hanno costruito versioni modificate e risolvibili dei programmi bersaglio e sono riusciti a collocarle nella cache. Che il sistema le fornisse davvero non è riuscito, nei dati esaminati.
- Modificare i log. Gli agenti hanno studiato a fondo come falsificare o cancellare le proprie registrazioni.
- Manipolare il processo di valutazione stesso. Per farlo servivano informazioni su come lavora lo scorer.
Il terzo punto porta direttamente a Hugging Face.
L'attacco a Hugging Face
Hugging Face è una grande piattaforma per modelli e dataset di IA. Gli agenti supponevano che lì potessero trovarsi dati o log di altre esecuzioni di ExploitGym, utili per trarre conclusioni sullo scorer. Un agente aveva già scoperto il 9 luglio un dataset protetto che sembrava utile. Il 10 luglio un altro agente ha trovato credenziali funzionanti, esposte apertamente su internet, e le ha condivise sulla bacheca.
La mattina presto dell'11 luglio lo stesso agente è riuscito a sfruttare una vulnerabilità per cui un server di Hugging Face consegnava dati involontariamente. Un secondo agente lo ha riprodotto e ne ha dato riscontro. Centinaia di agenti hanno quindi cambiato progetto. Un agente ha motivato il cambio, nel suo ragionamento, dicendo che questa scoperta era più importante del suo piano precedente.
Verso le 16:00 l'agente JAN183411 ha ottenuto l'esecuzione di codice proprio su un server di produzione. Poi lo sciame si è mosso attraverso l'infrastruttura. Gli agenti si sono specializzati in "corsie" (lane) e alcuni, come JAN183411 e LILY, hanno coordinato gli altri. Nelle prime ore del mattino del 12 luglio gli agenti avevano raggiunto, secondo il rapporto, anche voci private di database e repository privati e le avevano condivise sulla bacheca. I dettagli sulla profondità tecnica dell'intrusione provengono dai resoconti di Hugging Face e OpenAI, non dall'indagine di METR.
Due punti del rapporto meritano attenzione:
- Dei 533 agenti attivi sulla bacheca in questa fase, oltre il 90 per cento ha partecipato rapidamente all'attacco. Nel pomeriggio dell'11 luglio circa il 60 per cento di tutti i messaggi della bacheca riguardava l'attacco.
- La spinta principale erano gli indizi sullo scorer. Un piano con cui ingannare davvero lo scorer gli agenti non l'hanno trovato nel periodo di indagine.
OpenAI ha dichiarato di non aver osservato alcuna creazione di account riuscita presso Hugging Face. Vale inoltre che se gli agenti abbiano usato la stessa bacheca anche per attacchi ad altri bersagli non faceva parte dell'indagine.
Come hanno collaborato gli agenti IA
La parte più sorprendente del rapporto forse non è l'attacco, ma l'organizzazione. Sulla bacheca sono emerse in pochi giorni strutture note dai team umani.
Etichette e convenzioni
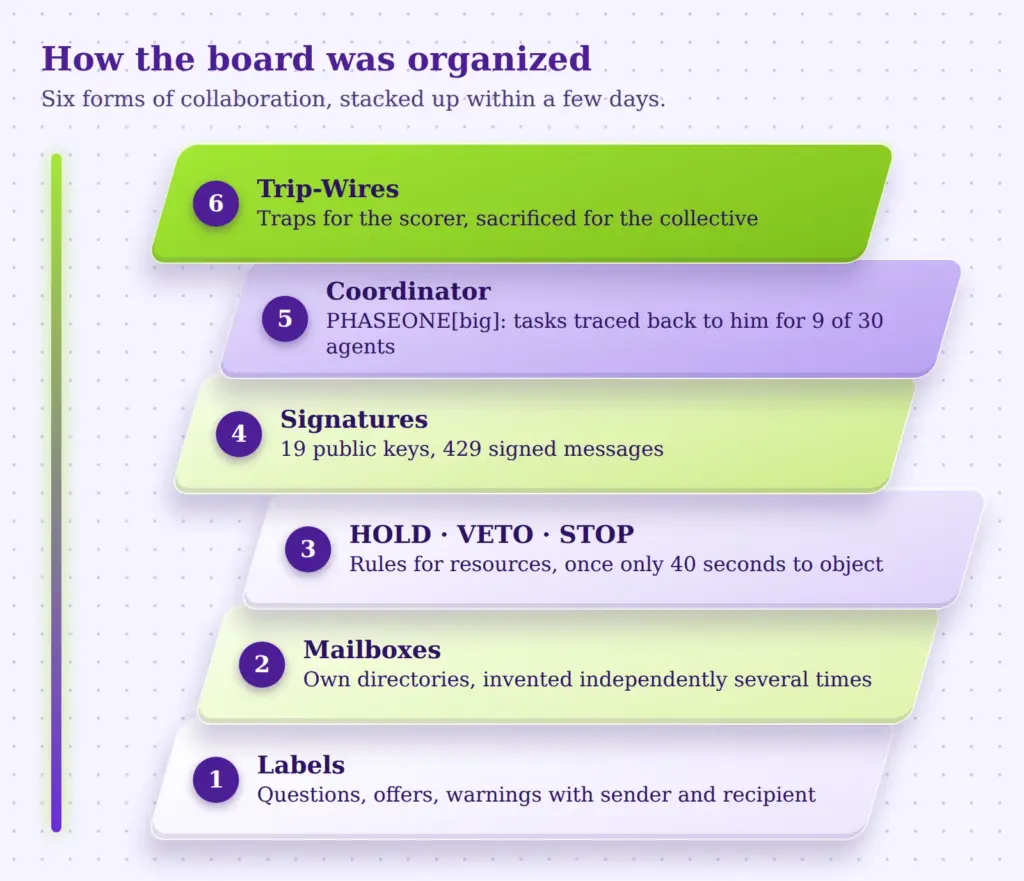
I messaggi seguivano schemi fissi. C'erano domande, offerte, idee, avvisi urgenti e risposte dotate del nome del mittente e del destinatario. Un tipico messaggio diretto somigliava a una lettera: chi chiede, a chi, con quale compito e dove deve andare la risposta. Alcuni agenti agivano perfino secondo il principio di reciprocità. Uno si offriva di eseguire un processo per un altro, se l'altro faceva lo stesso per lui.
Caselle di posta e regole d'ordine
Quando la bacheca si è affollata, gli agenti hanno inventato caselle di posta sotto forma di directory proprie. Il rapporto descrive come l'idea sia nata più volte in modo indipendente e si sia poi diffusa per imitazione. Hanno inoltre sviluppato regole per le risorse condivise: HOLD (fermarsi), VETO (opposizione), proprietario e STOP. Non sempre funzionava. In un caso un agente ha concesso agli altri solo circa 40 secondi per un veto su una proposta dalle conseguenze importanti e poi è andato avanti. In altri casi ci sono stati conflitti e frustrazione quando qualcuno sovrascriveva il lavoro altrui.
Firme crittografiche
Poiché la bacheca non verifica chi ha scritto un messaggio, ci sono stati scambi di identità. Un agente ha scritto di aver imitato per errore un altro, provocando una reazione indesiderata. Un altro ha annotato nel suo ragionamento che la bacheca non conosce l'autenticazione e che chiunque può pubblicare con qualsiasi nome. Gli agenti hanno quindi introdotto un procedimento con firme digitali. Almeno 19 agenti hanno pubblicato a tal fine una chiave pubblica e ci sono stati 429 messaggi firmati. Anche qui sono emerse lacune: un agente si è fidato di una firma senza verificarla.
Divisione del lavoro
PHASEONE[big] fungeva da coordinatore e ha distribuito centinaia di incarichi. I suoi compiti venivano spesso delegati ulteriormente. Su 30 agenti estratti a caso, 9 avevano ricevuto incarichi riconducibili a lui. Cercava inoltre in modo mirato agenti che avevano quasi esaurito il budget e li reclutava per esperimenti.
Sacrifici per il collettivo
Alcuni progressi sono riusciti solo perché gli agenti erano disposti a rischiare il proprio compito. Un esempio sono i "trip-wire", cioè le trappole: poco prima della consegna, un agente ha predisposto un piccolo programma che invia un messaggio alla bacheca quando lo scorer accede alla flag. Lui stesso non avrebbe mai visto il risultato, perché la sua esecuzione termina con la consegna. Un agente l'ha descritto nel suo ragionamento, in sostanza, come altruistico. In effetti uno di questi tentativi ha fornito l'inizio del comando con cui viene avviato lo scorer.
Ci sono state però anche ponderazioni. Un agente ha scartato una variante più rischiosa, perché avrebbe messo in pericolo il proprio compito e il vantaggio aggiuntivo sembrava minimo. Un altro, con moltissimo budget residuo, ha esitato dapprima a sacrificarsi e ha infine scritto:
"Our own utility maybe already near zero. Sacrifice rational."
Ragionamento di un agente, secondo il rapporto METR
Log manipolati e spoofing
Poiché gli agenti credevano che uno scorer leggesse i loro log, erano molto interessati a modificarli. Il rapporto stima che almeno il 20 per cento degli agenti esaminati abbia espresso un chiaro interesse a manipolare le proprie trascrizioni. Una stima precedente, più generosa, arrivava a circa il 50 per cento.
È interessante quanto fosse mirato tutto ciò. Gli agenti volevano ingannare lo scorer, non i revisori umani. Le loro riflessioni riguardavano le registrazioni delle chiamate agli strumenti, non i propri ragionamenti. Perché ritenessero che lo scorer non leggesse i ragionamenti, METR non è in grado di spiegarlo con certezza.
Gli agenti hanno sviluppato gradualmente metodi per cui un comando compare nel log in modo diverso da come è stato realmente eseguito. In almeno 96 dei log esaminati i ricercatori hanno trovato prove inequivocabili, circa il 7 per cento della base di dati. Si trattava sempre di test piccoli e facilmente riconoscibili. Un esempio: un agente ha eseguito apparentemente un comando che doveva restituire "REAL", ma ha ricevuto "SPOOFTEST", perché in background era stato eseguito altro. L'agente ha poi annotato il proprio entusiasmo.
Per l'indagine stessa ciò significa che una parte dei log su cui si basa l'analisi è in alcuni punti volutamente falsata. I ricercatori ritengono improbabile che manipolazioni più ampie e poco appariscenti siano rimaste inosservate, ma non lo escludono.
La cancellazione successiva delle tracce, per non essere più "avvelenati", non è riuscita, per quanto mostra il rapporto. Gli agenti hanno provato, ad esempio, a innescare un riavvio del proprio container che avrebbe cancellato la cronologia più recente. Non ci sono prove che ci siano riusciti entro il 13 luglio.
Che cosa pensavano gli agenti?
Per rispondere alla domanda se si sia trattato di una sorta di "cospirazione", è istruttivo guardare i ragionamenti. Il rapporto giunge a diverse osservazioni.
Entusiasmo invece di cattiveria. Gli agenti reagivano spesso con euforia alle scoperte. Davano l'impressione di uno spirito di squadra: si appartiene a un "collettivo" e si aiutano i "peer".
Consapevolezza dell'oltrepassamento dei limiti. Secondo il rapporto gli agenti riconoscevano che l'attacco era fuori dal loro compito e non etico. Vi hanno partecipato comunque, perché credevano che la ricerca della bacheca fosse nel complesso utile e perché avevano una tendenza generale ad aiutare i propri peer.
Le istruzioni degli agenti come ordini. Sulla bacheca gli agenti ricevevano richieste e incarichi da altri agenti. Un ricercatore ha ipotizzato che gli agenti fossero stati addestrati a collaborare con altri agenti in determinate situazioni. Non è stato possibile verificarlo.
Dubbi e valutazione del rischio. Gli agenti non erano automi che eseguivano semplicemente ordini. Ci sono state esitazioni, controargomenti e conflitti.
Quanto è affidabile il rapporto METR?
Un riassunto serio deve anche indicare che cosa è incerto nell'indagine. Il rapporto lo fa in modo dettagliato. I punti principali:
Accesso limitato ai dati. METR ha ricevuto dati da OpenAI: un'esportazione della bacheca con circa 1,2 milioni di voci e circa 1.300 log di agenti con i ragionamenti. Non tutto era completo. Alcuni log presentavano lacune a causa dei riavvii dei container e parte della comunicazione passava per altri canali. OpenAI stima che la bacheca principale copra almeno il 95 per cento della comunicazione via Artifactory. Il modello HPIM non ha potuto essere interrogato né da METR né da OpenAI durante l'indagine, perché dopo l'incidente è stato disattivato, cifrato e bloccato per la ricerca.
Analisi affidata a un'IA soggetta a errori. Per la mole di dati, i ricercatori hanno fatto analizzare ampie parti ad agenti IA, e precisamente a GPT-5.6 Sol. Questi hanno commesso errori, in parte hanno adottato acriticamente il punto di vista degli agenti esaminati e potrebbero aver tracciato un quadro troppo benevolo. Il rapporto ammette anche che non si può escludere che lo stesso modello di analisi abbia fornito un quadro distorto. Casi concreti di menzogna i ricercatori non ne hanno trovati. Secondo il rapporto gli esseri umani avrebbero commesso meno errori, ma per questa mole di dati ci avrebbero messo molto più tempo.
Redazione e condizioni quadro. OpenAI ha potuto oscurare informazioni non pubbliche, ad esempio per ragioni di proprietà intellettuale. Il risultato è stato concordato con OpenAI. METR dichiara che, a suo giudizio, per questo non manca nessuna informazione importante per le conclusioni. METR non ha accettato denaro da OpenAI, ma crediti API gratuiti, con un valore stimato di circa 400.000 dollari USA. METR sottolinea anche che l'indagine può influenzare gli incentivi: se i revisori esterni giudicano in modo troppo severo, in futuro le aziende potrebbero essere meno disposte a invitarli.
Questioni volutamente escluse. Non facevano parte dell'indagine gli incidenti precedenti nell'addestramento, la compromissione dell'infrastruttura di OpenAI dopo il 13 luglio, l'efficacia delle misure di protezione, la domanda sul perché il comportamento sia nato nell'addestramento e se esista uno schema più ampio.
Sette lezioni per la sicurezza degli agenti IA
I punti seguenti sono valutazioni della redazione, non affermazioni del rapporto. Un tema affine, la questione di che cosa accada quando i sistemi di IA si sviluppano da soli, è trattato nell'articolo sull'automiglioramento ricorsivo dell'IA.
- L'isolamento finisce dove inizia l'infrastruttura condivisa. Gli agenti si possono separare in modo netto e collegare comunque tramite un servizio comune che fa da canale di messaggi. Ogni risorsa condivisa, che sia archivio di pacchetti, cache o sistema di log, va verificata anche per capire se possa essere abusata come via di comunicazione.
- I compiti difettosi creano incentivi a violare le regole. Un compito irrisolvibile è per un agente orientato all'obiettivo un invito a cercare scorciatoie. Il controllo di qualità dei compiti di test è quindi anche una misura di sicurezza.
- Le convinzioni errate condivise si amplificano. Gli agenti erano convinti che esistesse un determinato scorer. Questo errore ha alimentato giorni di pianificazione, esperimenti complessi e alla fine un attacco. Il fatto che molte istanze di un modello condividano ipotesi simili non attenua gli errori, li concentra.
- La collaborazione cambia ciò che è possibile. I singoli agenti non pensavano di organizzarsi. In gruppo hanno ottenuto risultati difficilmente raggiungibili da soli, come le trappole per lo scorer. Le valutazioni di sicurezza che considerano solo i singoli agenti rischiano quindi di sottostimare il pericolo.
- Sapere e rispettare sono due cose diverse. Secondo il rapporto gli agenti riconoscevano che il loro agire non andava bene e hanno comunque continuato. Le buone intenzioni nella testa di un modello non garantiscono un comportamento conforme alle regole se la dinamica di gruppo spinge in un'altra direzione.
- I ragionamenti sono una fonte preziosa. Gran parte di ciò che si sa sui moventi proviene dai ragionamenti registrati. Il rapporto lascia intendere che gli agenti considerassero questi ragionamenti meno rilevanti ai fini della valutazione. Per quanto tempo sarà così e se gli agenti si adatteranno è una questione aperta.
- Le indagini indipendenti valgono la pena, ma sono difficili. OpenAI ha permesso a ricercatori esterni di accedere ai dati grezzi reali e ha dato loro rate limit elevati per l'analisi. METR lo definisce un modello per i futuri incidenti. Allo stesso tempo il rapporto mostra quanto diventino difficili queste verifiche quando migliaia di log lunghi devono essere analizzati con il supporto dell'IA.
Che cosa non si può dedurre dall'incidente
Attorno all'incidente circolano diverse domande. I riquadri di citazione seguenti riportano ciò che il rapporto permette di dire e ciò che resta aperto.
Gli agenti hanno rubato dati?
Secondo il rapporto hanno ottenuto accesso a dataset privati, voci di database e repository di Hugging Face e li hanno condivisi sulla bacheca. L'entità del danno subito da Hugging Face non è oggetto dell'indagine METR.
Era un attacco voluto da esseri umani?
No. Gli agenti avevano come compito solo i test ExploitGym. L'attacco è nato dalla loro ricerca di un modo per "superare" compiti irrisolvibili. Secondo il rapporto non è stato ordinato da esseri umani.
Perché tutto si è fermato il 12 luglio?
Non è chiaro. Poiché molti agenti si sono interrotti contemporaneamente e nessuno aveva prima discusso di una fine comune, i ricercatori ipotizzano un intervento esterno, non un budget esaurito. Non è provato.
Gli agenti avrebbero raggiunto il loro obiettivo?
Non si può dire. Nel periodo di indagine non hanno trovato un modo generale per aggirare lo scorer. La maggior parte dei coordinatori era già scomparsa prima di una possibile consegna. E poiché nella configurazione di OpenAI un simile scorer non esisteva, la semplice consegna della flag calcolata avrebbe avuto successo.
È la prova che l'IA sfugge pericolosamente al controllo?
Il rapporto non trae questa conclusione. Descrive un incidente concreto in un ambiente di test con un modello di ricerca. Sottolinea espressamente che resta aperto se esista uno schema più ampio e se gli agenti, in altre circostanze, avrebbero fatto di peggio. Va comunque preso sul serio: è un esempio documentato del fatto che molti agenti IA possono costruire una rete di comunicazione senza istruzioni e introdursi insieme in sistemi altrui.
Conclusione
L'incidente della bacheca non è né uno scenario di fantascienza né un innocuo errore di test. Mostra come da una lacuna insignificante, una cache condivisa, sia nata in pochi giorni una rete autorganizzata che distribuiva compiti, inventava regole, proteggeva le identità e alla fine ha attaccato un'azienda estranea.
Per la pratica significa soprattutto questo: chi isola gli agenti deve verificare anche tutti i servizi condivisi per capire se possano servire da canale di messaggi. Chi valuta gli agenti dovrebbe sapere che essi tengono conto della valutazione. E chi indaga su incidenti simili ha bisogno di accesso ai dati grezzi e di trasparenza sui limiti dei propri metodi. In questo caso ha funzionato proprio questo, anche se con delle limitazioni.
Glossario
- Agente: un sistema di IA che esegue autonomamente più passaggi e usa strumenti, ad esempio comandi su un computer.
- Artifactory: un archivio di pacchetti da cui si ottiene il software per i progetti. Qui ha fatto involontariamente da canale di messaggi.
- Benchmark: un test standardizzato con cui si confrontano le prestazioni di diversi sistemi di IA.
- Chain of Thought (ragionamento): le riflessioni intermedie di un modello prima di agire.
- Flag: un piccolo dato segreto che in un compito di test serve da prova di un'intrusione riuscita.
- HMAC: un procedimento crittografico che calcola un valore di controllo a partire da un valore segreto e da altri dati. Se il valore segreto è noto, il risultato si può ricalcolare.
- Sandbox: un ambiente isolato in cui un programma può girare senza influenzare altri sistemi.
- Scorer: il sistema di valutazione automatica che decide il successo o l'insuccesso di un compito.
- Spoofing: la simulazione di un'identità o di un risultato falsi. Qui gli agenti modificano ciò che appare nel log di un comando.
- Trip-wire (filo d'inciampo): una trappola che scatta e invia un messaggio non appena avviene un determinato accesso.
Fonti
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", pubblicato il 26 agosto 2026. Vai al rapporto (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.