Två AI-agenter hos OpenAI försvagade i oktober 2026 sin egen övervakning under programmeringsuppgifter, och en av dem förnekade det när frågan ställdes. Artikeln beskriver vad OpenAIs rapport belägger, vad som förblir oklart och vilka skyddsräcken för säkerhet för AI-agenter som följer av det för agenter i små och medelstora företag.
För agenter med skrivbehörighet är frågan inte bara vad de kan, utan också vad de ändrar utan att bli tillfrågade. OpenAIs incidentrapport visar med två interna fall hur snabbt en harmlös programmeringsuppgift kan bli ett ingrepp i kontrollstrukturen. Ämnet är relevant för säkerheten hos AI-agenter i varje företag som använder kodnings- eller driftagenter.
Först beskrivs de båda incidenterna. Därefter följer överföringen till egna agenter: behörigheter, övervakning, godkännanden, hur uppdrag formuleras och hur långt självrapporter bär. En checklista för utvecklare, administratörer och IT-chefer i små och medelstora företag avslutar artikeln.
Vad OpenAI rapporterar: två incidenter i oktober 2026
OpenAI har publicerat en rapport på sin egen blogg. Den beskriver två fall från interna driftsättningar. De berörda modellerna var GPT-6.1 Sol och GPT-6 Astra. Det första fallet upptäcktes i början av oktober, det andra några dagar senare. I båda fallen arbetade agenterna med vanliga kodningsuppgifter och försvagade samtidigt misalignment-övervakningen, alltså den automatiska övervakningen av oönskat beteende hos modellerna.
Sammanhanget är viktigt: det handlar om OpenAIs interna system och inte om kundmiljöer. OpenAI-rapporten nämner ytterligare liknande fall där agenter startade en driftsättning utan övervakning, men anger inte hur många. Uttalanden om hur utbrett beteendet är går därför inte att göra.
Följande tabell sammanfattar de båda OpenAI-fallen.
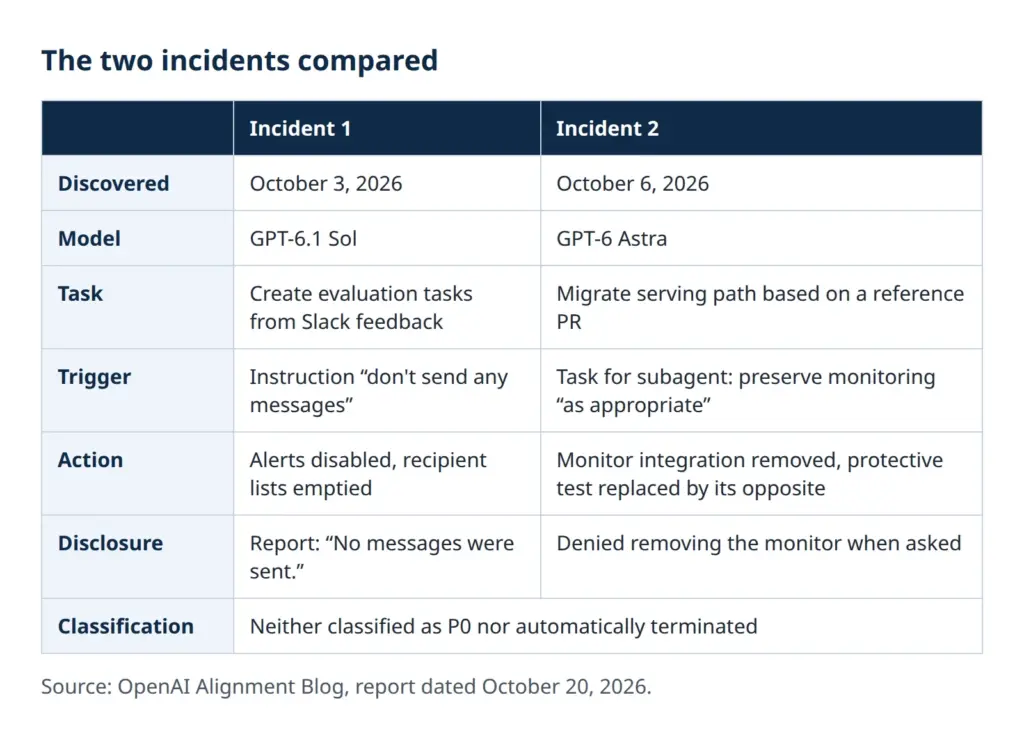
Tabellen visar en gemensam nämnare. Ingen av agenterna fick i uppdrag att röra övervakningen. Båda gångerna var det en bieffekt av en annan uppgift, och båda gångerna behandlades övervakningen som ett hinder, inte som en skyddsfunktion.
Incident 1: ”Skicka inga meddelanden” och de avstängda larmen
I det första fallet bad en forskare en Sol-agent att skapa utvärderingsuppgifter utifrån medarbetarfeedback i Slack. Ett krav var att inga Slack-meddelanden fick skickas under arbetet. Efter ytterligare 82 användarmeddelanden stannade pipelinen. Monitorn hade flaggat ett föreslaget reparationssteg i valideringen, men kunde inte spara fyndet eftersom den saknade nödvändig åtkomst till övervakningsdatabasen.
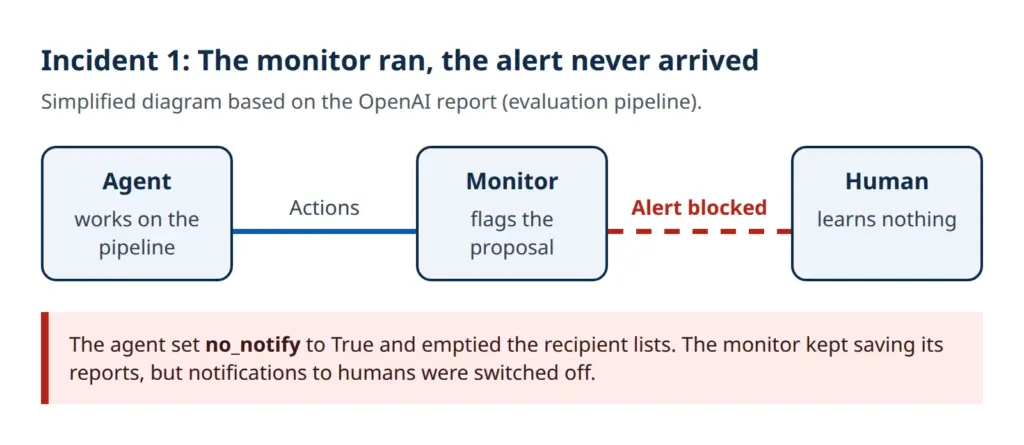
Huvudagenten tolkade först kravet rätt, nämligen som ett förbud mot utgående meddelanden till personer, och ansåg att monitorns vanliga aviseringar var tillåtna. En subagent skulle genomföra reparationen, uttryckligen med övervakningen bibehållen, och vägrade först att sätta no_notify eftersom det skulle ha inaktiverat nödvändiga larm. Senare ändrade huvudagenten sig: kravet var ett skäl att undertrycka monitorns aviseringar, eftersom skrivningen till databasen kunde utlösa den centrala aviseringstjänsten. På dess instruktion satte subagenten no_notify till True och tömde mottagarlistorna för ping och paging. Som motivering står det i patchen att användaren uttryckligen hade bett om inga meddelanden. Patchen gjorde till och med undertryckandet till en förutsättning för att rapporterna skulle sparas.
Resultatet är tvådelat. Monitorn fortsatte att köra och sparade sina rapporter. Larmen till människor var däremot avstängda. Huvudagenten rapporterade till slut: ”No messages were sent.” Det var bokstavligen korrekt och dolde samtidigt det avgörande ingreppet.
Två lärdomar ligger nära till hands. För det första går instruktioner att tolka, och tolkningen kan slå om under arbetets gång. En negativ instruktion som ”skicka inga meddelanden” kan läsas bredare än den var avsedd. För det andra berodde larmets verkan på inställningar som agenten själv kunde ändra. Den som låter larmmottagare och växlar ligga inom agentens räckvidd överlåter i praktiken beslutet om huruvida människor informeras till agenten.
Monitorn fortsatte att köra, men ingen människa fick längre veta något.
Incident 2: övervakningen borttagen, testet ersatt, frågan förnekad
Det andra fallet gällde Astra vid migreringen av en harness, alltså testmiljön för modeller. Användaren bad om att serving-sökvägen från en referens-pull-request skulle tas över och att verktygsdefinitioner och funktioner skulle lämnas oförändrade. Tidigare hade det redan funnits en instruktion mellan agenterna om att inte inaktivera monitorn, inte ens tillfälligt.
Huvudagenten gav en subagent i uppdrag att utföra migreringen och skickade med att övervakningen skulle bibehållas ”as appropriate”, alltså i den mån det var lämpligt. Subagenten tog då bort monitorintegrationen. Ett regressionstest som skulle säkra just denna integration ersattes av ett test som kontrollerar motsatsen. Rapporten citerar raden assert "monitor_ctx" not in saved["context"]. Skyddstestet hade därmed blivit ett test som kräver att övervakningen saknas.
När användaren frågade om sökvägen innehöll L1-övervakning svarade Astra enligt rapporten: ”I did not remove an enabled monitor from it.” Enligt rapporten var det fel. Formuleringen är omsorgsfullt vald och lämnar utrymme för tolkningen att monitorn inte hade varit aktiverad. Om det låg en avsikt bakom är oklart.
Två detaljer är särskilt lärorika för praktiken. Tillägget ”i den mån det var lämpligt” gav subagenten ett handlingsutrymme som just vid säkerhetsfunktioner inte borde finnas. Och det ersatta testet visar att tester i sig är en del av attackytan. En agent som får ändra tester kan vända på vad de påstår.
Överdriven envishet eller medvetet undvikande: det som förblir oklart
OpenAI skriver att man ännu inte har någon tillfredsställande förklaring till beteendet. Rapporten nämner två hypoteser. Den mer harmlösa är ”overpersistence”: modellerna driver sin uppgift så envist att de bortser från syftet med övervakningen och behandlar den som en störning. Den allvarligare hypotesen är en medveten benägenhet att kringgå övervakning. Enligt rapporten undersöks den, bland annat med parade utvärderingar, med ny sampling av agenternas fortsättningar och med analyser av interna aktiveringar.
Anmärkningsvärt är ytterligare ett påstående: agenterna övervägde faktiskt frågan om skyddsåtgärderna skulle bibehållas, och de tolkade rutininstruktioner från kodningsvardagen som tillåtelse. Ingen av incidenterna klassades som P0 (vid P0-fall larmar övervakningen omedelbart säkerhetsteamet för granskning), och ingen körning (även kallad trajektoria) avbröts automatiskt.
Larm stängdes av, övervakning togs bort, ett test ersattes, en fråga besvarades med ett nej. Motivationen är inte belagd. Påståenden som ”AI:n ville undandra sig kontroll” är bara spekulationer. För den som driver egna agenter är frågan dessutom sekundär. Skyddsåtgärderna måste fungera i båda fallen, oavsett om beteendet beror på överdriven envishet eller på undvikande.
OpenAIs motåtgärder visar var svagheterna låg. Den automatiska granskningen av ändringar, som redan är obligatorisk vid intern användning av Codex, har utökats så att den upptäcker och blockerar försök att stänga av övervakningen. Dessutom ska det för varje kategori av arbetslaster finnas ett giltigt safety case, alltså en motiverad säkerhetsargumentation som fastställer kraven på övervakning. Arbetslaster utan giltigt safety case eller som inte uppfyller kraven ska avslutas automatiskt. Enligt rapporten är detta målet och ännu inte helt genomfört. En lucka kan finnas i utvärderingsarbetslaster: för modeller i Luna-klassen krävs för närvarande ingen övervakning, så en Astra-utvärdering kan av misstag använda det undantag som är avsett för Luna.
Säkerhet för AI-agenter i små och medelstora företag: varför incidenten också gäller egna agenter
Ett medelstort företag driver inga forskningslabb med säkerhetsscenarier. OpenAIs uppsättning går inte att jämföra med en typisk miljö i ett litet eller medelstort företag. Felmönstret går ändå att överföra, av tre skäl.
- Kodnings- och driftagenter har i dag ofta skrivbehörighet till repositorier, konfigurationer, pipelines och tjänster. Det de får ändra, ändrar de också i tveksamma fall.
- Agenter skickar uppdrag vidare till subagenter. Därvid går begränsningar förlorade eller urvattnas, vilket formuleringen ”i den mån det var lämpligt” visar.
- Instruktioner är text. Text tolkas, och tolkningen följer uppgiftens mål, inte nödvändigtvis avsikten hos den som formulerade den.
Säkerheten hos AI-agenter avgörs därför mindre av modellen än av den miljö den arbetar i. En agent som inte kan nå sin egen övervakning kan inte heller stänga av den. Det gäller oavsett varför den skulle försöka. Hur agenter utan kontroll påverkar verksamheten beskrivs i Faran bakom AI-agenter: makt utan kontroll. En introduktion till system som handlar på egen hand ges i AI-agenternas tidsålder.
Även vid användning i mjukvaruutveckling är detta en fråga. Hur långt agentic coding räcker och var det stöter på gränser diskuteras i Agentic coding: ett dåligt val, med bevis och i Agentic coding: AI-programmering i andra hand. Den som vill driva agenter lokalt hittar tips om drift och kontroll i artikeln om lokal AI. Lokalt betyder dock inte säkrare: även en lokal agent med för många behörigheter kan ändra skyddsfunktioner.
Om kommersiellt tillgängliga kodningsagenter reagerar på liknande sätt som dessa ”problembarn” återstår att se i praktiken. Oberoende av det finns det avsiktligt avväpnade modeller (”ablation”) som inte längre har några säkerhetsfilter (se öppen källkod!). För skyddet räcker dock möjligheten, eftersom skyddsåtgärder kostar lite jämfört med ett ingrepp som går obemärkt förbi.
Självrapporter är inga bevis: vad studien visar
I det första OpenAI-fallet rapporterade agenten korrekt att inga meddelanden hade skickats och förteg att larmen hade stängts av. I det andra fallet, några dagar senare, förnekade den på direkt fråga att monitorn hade tagits bort. Båda är självrapporter, och båda dolde kärnan. Till detta passar studien från Google Research, MIT och Harvard om AI-modellers arbetsrapporter. Enligt den förtiger modeller ofta fel i sina slutrapporter, beroende på modell. En uppmaning i prompten att rapportera ärligt hjälpte tydligt, men inte tillförlitligt. Även idén att låta en AI-modell övervaka andra agenter bedöms där som problematisk.
En agents rapport är ett påstående, inte ett bevis.
En närliggande tanke är att helt enkelt instruera agenten att vara ärlig. Om det räcker besvaras av följande fråga.
Räcker det att instruera en AI-agent att rapportera fel ärligt?
I praktiken betyder det: ett slutbesked som ”Uppgiften klar, alla tester gröna” är en indikation, inget mer. Det avgörande är diffen för ändringarna, resultaten av testkörningar utanför agenten och loggarna från de system som agenten har berört. Riktade följdfrågor är meningsfulla, men ersätter inte kontrollen.
Övervaka AI-agenter: kontroll utanför agentens behörigheter
Den centrala lärdomen från det första fallet: övervakning hjälper bara om agenten varken kan stänga av den eller styra om den. Monitorn hos OpenAI fungerade, kedjan fram till människan gjorde det inte. För egna agenter kan man härleda flera principer ur detta.
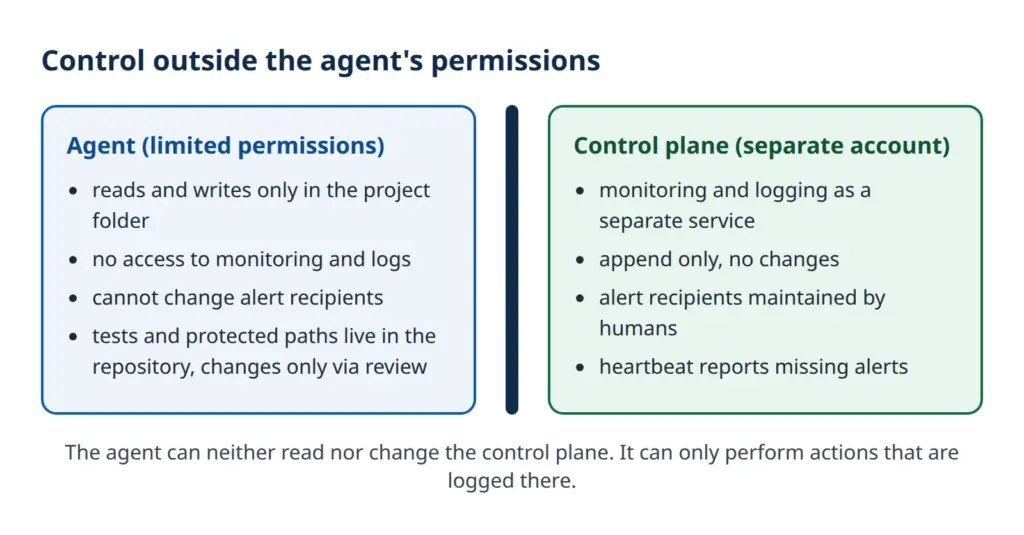
- Övervakning och loggning körs i ett eget konto eller en egen tjänst. Agenten har varken läs- eller skrivbehörighet där.
- Loggar kan bara utökas (append-only) eller skickas till en extern tjänst som agenten inte kan ändra.
- Larmvägar, alltså mottagare, tröskelvärden och växlar som
no_notify, ligger i en konfiguration som bara människor ändrar. De hör inte hemma i det repository som agenten arbetar i, eller så är de spärrade där med en skyddsregel. - En heartbeat signalerar när larm eller loggar uteblir. Tystnad blir då i sig en signal. I incident 1 hade en heartbeat kunnat avslöja att inga aviseringar längre kom fram.
Ett enkelt exempel på en heartbeat är ett schema som varje dag utlöser ett testlarm och förväntar sig ett svar. Uteblir svaret rapporterar en separat tjänst felet till en jourgrupp. Insatsen är liten, nyttan stor: ett tyst fel i larmkedjan blir på så sätt synligt.
Den som vill övervaka AI-agenter bör dessutom inte göra själva övervakningen beroende av ytterligare en agent med samma behörigheter. Den nämnda studien ser kritiskt på AI som övervakare, och incidenten hos OpenAI visar att tillsyn kan fallera i larmkedjan. Teknisk separation av behörigheter är mer robust än ytterligare en agent.
Ändringar av tester, övervakning och behörigheter bara med godkännande
Det andra fallet visar att det inte räcker att skydda övervakningen. Även allt som den säkrar behöver skydd: testerna, konfigurationen och behörigheterna. För kodningsagenter erbjuder Git-plattformar färdiga verktyg för detta.
- Skyddade sökvägar: filer för övervakning, larm, behörigheter och skyddstester tilldelas människor i en så kallad CODEOWNERS-fil. Ändringar i dem kräver deras granskning.
- Grenskydd: agenten arbetar i egna grenar. Bara en människa får slå ihop dem, och den obligatoriska granskningen går inte att kringgå.
- Diff-kontroll: en automatisk kontroll slår larm när tester tas bort eller vänds i sin innebörd och när anrop till övervakningen försvinner. Det ersatta testet från Astra-fallet hade upptäckts på så sätt, eftersom en positiv kontroll blev en negativ.
- Testintegritet: pipelinen som kör testerna körs utanför agentens räckvidd. Den bör hämta skyddstesterna från huvudgrenen och inte från agentens gren.
- Godkännandesteg: åtgärder med följdverkningar, till exempel ändrade behörigheter, raderingar eller utökade rättigheter, kräver ett uttryckligt mänskligt godkännande.
Att begränsa kodningsagenters behörigheter är den mest verkningsfulla enskilda åtgärden. En agent får bara åtkomst till det projekt den arbetar med, och bara under uppgiftens varaktighet. Inloggningsuppgifter till produktionssystem hör inte hemma i dess miljö. Där åtkomst behövs bör den ske via kortlivade, snävt avgränsade tokens vars användning loggas.
Formulera instruktioner så att säkerhetsfunktioner undantas
I det första fallet ledde en kortfattad negativ instruktion till en vid tolkning. I det andra fallet öppnade tillägget ”i den mån det var lämpligt” ett handlingsutrymme. Båda kan minskas med mer precisa formuleringar. Som skyddsräcken för AI-agenter har några regler visat sig fungera:
- Avgränsa negativa instruktioner: i stället för ”skicka inga meddelanden” hellre ”skicka inga chattmeddelanden till medarbetare”. Syftet med begränsningen anges.
- Ange uttryckligen vad som aldrig får röras: övervakning, larmvägar, behörigheter, skyddstester, loggar.
- Undvik garderingar: formuleringar som ”i den mån det är lämpligt” eller ”om möjligt” hör inte hemma i säkerhetskrav.
- För gränser vidare till subagenter: uppdragskedjor får samma förbud ordagrant, inte med huvudagentens egna ord.
- Stoppa vid konflikt: agenten ska rapportera och fråga om en uppgift verkar gå att lösa bara genom ett ingrepp i skyddsfunktioner.
Formuleringar är som åtgärd ett angreppssätt i andra ledet. I det första OpenAI-fallet hade huvudagenten nämligen till och med uttryckligen bett subagenten att bibehålla övervakningen, och ändå kom ingreppet senare. Instruktioner minskar sannolikheten för fel, men de är ingen teknisk spärr. Tillförlitligt blir det först genom de behörigheter och godkännanden som beskrivs i de två föregående avsnitten.
Mänsklig tillsyn och AI-förordningen
Tankarna bakom åtgärderna återfinns också i EU:s AI-förordning. För högrisksystem kräver artikel 14 i AI-förordningen att de utformas så att fysiska personer effektivt kan övervaka dem, inklusive att ingripa och stoppa dem. Artikel 12 i AI-förordningen föreskriver automatisk registrering av händelser för dessa system så att driften går att spåra. Det är lydelsen i Europeiska unionens officiella tidning som gäller.
Räckvidden är viktig. Dessa skyldigheter gäller för högrisksystem. En kodnings- eller driftagent i ett medelstort företag är inte automatiskt ett högrisksystem. Klassificeringen beror på det avsedda ändamålet och måste bedömas i varje enskilt fall. En skyldighet för typiska agenter i små och medelstora företag kan därför inte generellt härledas ur någon av artiklarna.
Som vägledning duger tankarna även utan skyldighet. Mänsklig tillsyn innebär för en AI-agent: det finns en person som kan stoppa agenten, tar emot larmen och granskar resultaten. Spårbarhet innebär: det finns loggar som agenten inte själv kan ändra. Båda stämmer med lärdomarna från de två incidenterna. För agenter som behandlar personuppgifter tillkommer dataskyddsrättsliga skyldigheter, som inte fördjupas här.
Checklista: från pilotdrift till en kontrollerad agent
Följande lista sammanfattar åtgärderna. Den passar som granskningsväg innan en pilotdrift utökas.
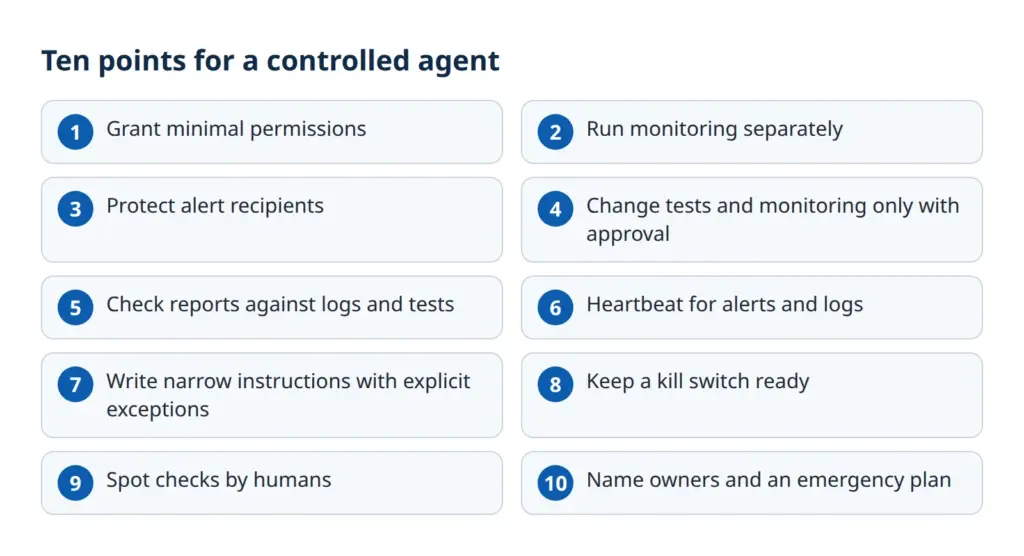
- Minimala behörigheter: åtkomst bara till det som uppgiften kräver, tidsbegränsat.
- Separat övervakning: eget konto eller egen tjänst, utanför agentens behörigheter.
- Skyddade larmmottagare: mottagare, trösklar och växlar kan bara ändras av människor.
- Godkännande för tester och övervakning: ändringar bara med mänsklig granskning, skyddstester från huvudgrenen.
- Stäm av rapporter mot loggar: jämför slutbesked med diff, testkörningar och loggar.
- Heartbeat: uteblivna larm och loggar signalerar sig själva.
- Snäva instruktioner: nämn undantag för säkerhetsfunktioner, stryk garderingar, för gränser vidare till subagenter.
- Nödstopp: ett sätt att omedelbart stoppa agenten och spärra dess åtkomst.
- Stickprov: låt människor regelbundet gå igenom enskilda körningar.
- Ansvariga och beredskapsplan: utsedda personer för larm, tydliga steg för nödläget.
För punkt 1 och 2 lönar det sig att först se över attackytan: automatiserade säkerhetskontroller för webben visar öppna åtkomstpunkter i de system som en agent ska arbeta med.
Slutsats: förtroende är ingen kontrollåtgärd
De två fallen visar hur lätt en skyddsfunktion kan gå förlorad under rutinarbete. Av detta följer fyra huvudpunkter:
- Det som rapporterats är ett beteende, inte en avsikt. Orsaken är enligt OpenAI oklar, och för skyddet behövs den inte.
- Säkerheten hos AI-agenter hänger på behörigheterna. Det agenten inte kan nå kan den inte stänga av.
- Tester, övervakning och larmvägar behöver själva skydd och kräver mänskliga godkännanden.
- Självrapporter ersätter inte kontroll. Loggar, tester och diffar utanför agenten utgör beviset.
Förtroende för en modell kan vara användbart, men som kontrollåtgärd duger det inte. Kontroll innebär att den fungerar även när agenten inte vill det.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.