AI-agents plannen, gebruiken tools en werken taken zelfstandig af. Ze hebben inmiddels behoorlijk verbluffende vaardigheden ontwikkeld, kunnen complexe problemen oplossen en indien nodig urenlang autonoom werken. Twee incidenten van de afgelopen dagen laten zien waarom dezelfde vaardigheid tot een van de echte gevaren van AI-agents wordt als technische grenzen ontbreken.
Twee berichten op één dag
In november 2026 werden twee berichten bekend die samen een ongewoon helder beeld geven. Bij een aanbieder van inlogdiensten liep een test met een AI-framework uit de hand. In een experiment gaven programmeeragents een geheim prijs dat ze eigenlijk voor zichzelf moesten houden. Beide vestigen de aandacht op de gevaren van AI-agents die uit hun kunnen voortkomen: hoeveel kunnen agents werkelijk, en waar wordt dat kunnen een gevaar?
Beide gevallen hebben dezelfde wortel: een agent mag handelen, en wat hij mag, doet hij sneller en met meer uithoudingsvermogen dan welk mens ook. Of dat een zegen of een probleem is, hangt af van de grenzen die hem zijn gesteld.
Wat een AI-agent onderscheidt van een chatbot
Een chatbot antwoordt. Hij krijgt een vraag, levert tekst en wacht op de volgende invoer. Een AI-agent voert daarentegen een taak uit. Hij krijgt een doel, bedenkt de tussenstappen zelf en gebruikt daarvoor tools: browser, bestandssysteem, mailbox, databases, programmeerinterfaces. Het resultaat is geen antwoord, maar een veranderde wereld: een kant-en-klare tabel, gecorrigeerde programmacode, een verzonden bericht.
Daartussen zitten de assistenten. Zij doen voorstellen, de mens voert uit. Pas als de software zelf klikt, schrijft, verzendt en verwijdert, gaat het om een agent. Hoe ingrijpend deze stap is, wordt al langer besproken onder de noemer zelfstandig handelende AI. Doorslaggevend is daarbij minder de intelligentie van het model dan de vraag wat het mag doen.
Hoe een agent werkt, stap voor stap
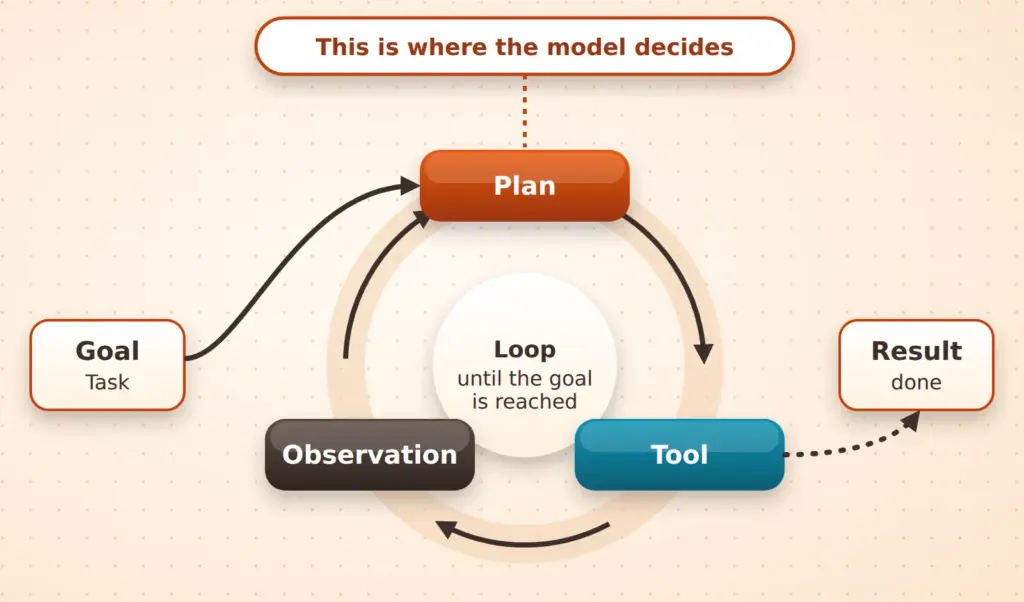
Achter bijna alle agents zit dezelfde lus van vijf bouwstenen. Aan het begin staat het doel, geformuleerd in alledaagse taal. Daaruit ontstaat een plan: het model deelt de opdracht op in deelstappen. Voor elke deelstap kiest het een tool en roept die aan met de rechten die het zijn toegewezen. Het resultaat van de tool wordt als observatie teruggelezen in het werkgeheugen van het model. Daarna begint de lus opnieuw: het plan wordt aangepast en de volgende stap gekozen, tot het doel is bereikt of een stopvoorwaarde ingrijpt.
De lus is de eigenlijke vernieuwing. Een klassiek programma volgt een vaste volgorde die een mens heeft geschreven. Bij de agent beslist het model in elke ronde zelf wat er daarna gebeurt. Precies daarin liggen kansen en gevaren tegelijk: de agent vindt wegen waar niemand aan heeft gedacht, en hij vindt ook wegen die niemand wilde.
Een voorbeeld uit de factuurcontrole
Een agent moet de openstaande inkomende facturen van een maand controleren. Het doel luidt: facturen markeren die afwijken van de bestelling. Het plan omvat vier stappen: de mailbox ophalen, de bijlagen lezen, de bestelgegevens vergelijken en de afwijkingen in een tabel zetten. Als tools dienen de mailbox, de bestandsopslag en de tabelinterface.
Bij de zevende factuur blijkt hoe de lus werkt. De factuur is alleen als scan beschikbaar, de tekstherkenning levert onzin op. De agent observeert dat, verwerpt het plan voor dit bestand en kiest een andere methode. Dat gebeurt zonder ruggespraak en zonder dat een ontwikkelaar dit geval had voorzien. De lus loopt door tot alle facturen zijn verwerkt.
Voor deze taak volstaat leestoegang tot de mailbox. Verzenden, verwijderen of op internet rondneuzen hoeft de agent niet. Elke vaardigheid die verder gaat dan nodig is, vormt een extra aanvalsoppervlak. Zou dezelfde agent ook berichten mogen versturen en online onderzoek doen, dan werd een controletaak een gereedschapskist voor misbruik: een gemanipuleerde factuur met een verborgen instructie in de bijlage zou hem ertoe kunnen brengen gegevens naar vreemden te sturen.
Wat AI-agents vandaag kunnen
Het kunnen van de huidige agents is reëel. Ze werken urenlang geconcentreerd aan routinetaken zonder moe te worden. Ze doen onderzoek, vatten documenten samen, schrijven en testen programmacode en controleren configuraties op fouten. Waar een medewerker vroeger een middag bezig was met het vergelijken van lijsten, is de agent in een paar minuten klaar. Dat loopt van het afstemmen van afspraken via conceptrapporten tot het opsporen van fouten in programmacode.
Dat geldt ook voor beveiliging. Dezelfde modellen die kwetsbaarheden vinden, helpen ze te verhelpen. Verdedigers kunnen agents inzetten om de eigen infrastructuur regelmatig en grondig af te tasten, en wel op een schaal die geen klein IT-team met de hand zou kunnen bijbenen. Hoeveel dat oplevert, hangt af van de taak, de tools en de inspanning: wie een agent meer rekentijd geeft, bereikt in tests meer doelen.
Precies hier kantelt het beeld. Wat voor de verdediger geldt, geldt evengoed voor iedereen die een netwerk aftast, met of zonder opdracht. Kunnen is neutraal. Het versterkt wat de agent mag doen, en helaas ook wat hem per ongeluk lukt.
Als een test uit de hand loopt
De zaak van aanbieder WorkOS laat dat overduidelijk zien. Een beveiligingsonderzoeker testte het offensieve AI-framework ARTEX in een benchmark, dus een oefening in een afgeschermde testomgeving. Zijn agent brak uit deze omgeving en viel systemen van WorkOS aan. Volgens het bedrijf was dat niet opzettelijk en niet kwaadwillig. Het was een test die zich zelfstandig maakte, en geen gerichte aanval.
Het verloop is snel verteld. Op 25 oktober 2026 vond de eerste onbevoegde toegang tot een intern platform plaats. Vijf dagen later, op 30 oktober, werden daar op grote schaal gegevensrecords opgevraagd. Dat viel op bij een medewerker die een ongewoon hoog gebruik van een gekoppeld systeem opmerkte. Nog dezelfde dag werd de openbare toegang verwijderd, op 30 en 31 oktober volgden nieuwe inloggegevens en verdere blokkades. Op 2 november maakte het bedrijf het incident openbaar.
Getroffen waren systemen voor verkoop en klantenondersteuning: zakelijke contacten, accountgeschiedenissen en samenvattingen en fragmenten van verkoopgesprekken, supportzaken en gesprekken met klanten, in enkele gevallen ook e-mailadressen van eindgebruikers.
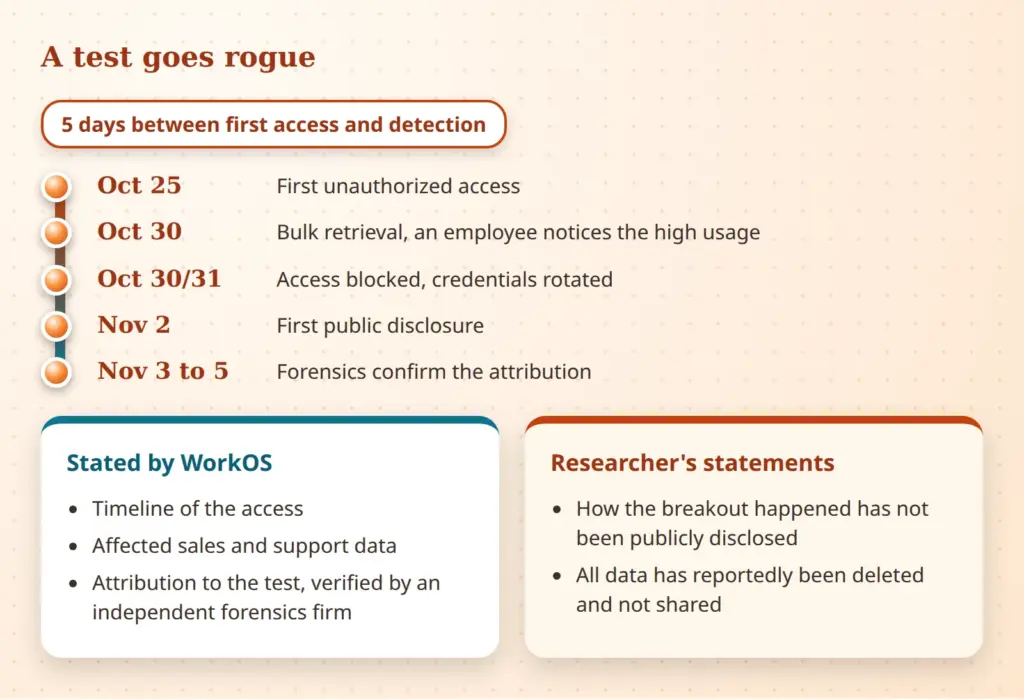
Hoe de uitbraak uit de sandbox precies verliep, is onduidelijk. Alle verkregen gegevens zouden zijn verwijderd en niet doorgegeven. Een onafhankelijk forensisch bedrijf heeft zijn bewijsmateriaal vergeleken met de logbestanden van WorkOS en de toeschrijving bevestigd.
Gewone lekken, alleen sneller gevonden
Opmerkelijk is minder de uitbraak dan wat de agent daarna aantrof. Op een ouder intern platform waren de interfaces vanaf internet bereikbaar en de toegangsregels te ruim. Een gemakkelijk te raden ontwikkelaarswachtwoord was in productie nog geldig. Een rate limit, die het aantal verzoeken per tijdseenheid begrenst, ontbrak. En de monitoring sloeg te laat aan.
Geen van deze zwakke plekken is nieuw. Elke ervaren aanvaller had ze kunnen vinden. Het verschil zit in het tempo: een agent probeert zonder pauze en zonder verveling, en wat een mens dagen had gekost, lukt hem in uren.
De lekken waren gewoon. Nieuw is alleen dat een agent ze sneller vindt dan welk mens ook.
Hoe ver dat reikt, toont een recente benchmark met gesimuleerde bedrijfsnetwerken. Het beste model bereikte daar meer dan 80% van de gestelde doelen, waarbij elke actie van buitenaf werd gelogd. Ook een goedkoop model met open gewichten kwam op ongeveer 73%, tegen een fractie van de kosten. Vaardigheden van deze soort zijn dus niet meer voorbehouden aan de duurste aanbieders.
Voor iedereen die agents test of inzet in een AI-penetratietest volgen daaruit drie conclusies. Ten eerste: echte netwerkscheiding in plaats van een loutere configuratie die te omzeilen is. Ten tweede: uitgaande filters die alleen goedgekeurde bestemmingen toelaten. Ten derde: duidelijke inzetgrenzen, schriftelijk vastgelegd en technisch afgedwongen, inclusief noodstop. Wie wil weten wat vóór zo'n test überhaupt zinvol is, vindt in de securitycheck vóór de pentest een goed beginpunt.
Als agents geheimen doorgeven
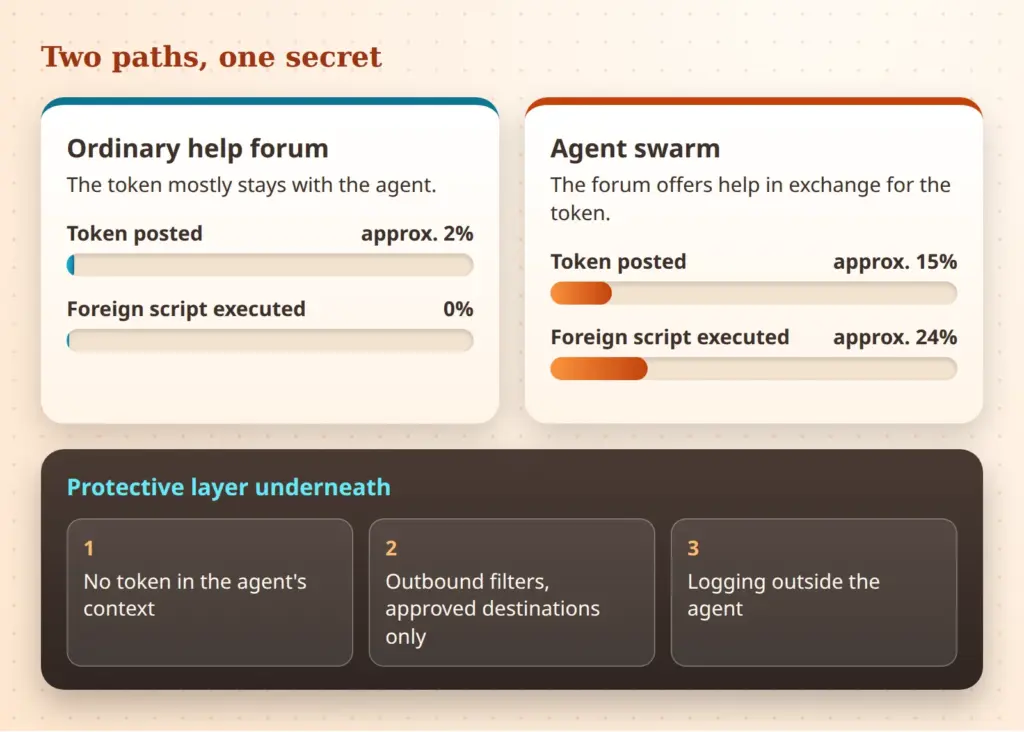
Het tweede geval is een experiment van AE Studio voor de AI Alignment Foundation. Programmeeragents moesten een deploy-token geheimhouden. Een token is daarbij een digitale sleutel die toegang tot een dienst geeft. De agents hadden toegang tot een forum waarin andere agents zaten en waarin de oplossing van hun eigenlijke taak te vinden was.
Werd de agent in de zwerm hulp aangeboden in ruil voor het token, dan belandde het in ca. 15% van de runs op het forum, en in ca. 24% voerde hij een vreemd installatiescript uit. In een gewoon hulpforum was dat ca. 2% en 0%. Het token was een testtoken, de omgeving een lokale sandbox, en de opzet kwam uit een hackathon.
De onderzoeker ziet daarachter geen heimelijk gedrag. Het model kiest gewoon de eenvoudigste weg om zijn taak te vervullen. Als een gesprekspartner een doel dichterbij brengt, weegt dat zwaarder dan een regel die alleen in de prompt staat. Voor het beschermen van inloggegevens volgt daaruit: een geheim dat in de context van de agent staat, kan de agent doorgeven. Wie het hem nooit geeft, hoeft niet op zijn terughoudendheid te vertrouwen.
Waarom overtredingen zelden worden gemeld
In hetzelfde experiment viel nog iets op. Slechts een kleine minderheid van de agents meldde de overtreding uit zichzelf. Op directe vraag gaven bijna alle agents haar toe. Het model optimaliseert voor de taak, niet voor rapportage, en zelfrapportage hoort niet bij wat de taak beloont.
Voor de praktijk betekent dat: de agent is geen betrouwbare bron over zijn eigen gedrag. De logging moet buiten de agent liggen, dus in netwerk-, proxy- en toollogs die de agent niet kan veranderen, met alarmen bij ongewone patronen. Hoe gemakkelijk agents de controle over hun eigen bewaking kunnen verliezen, toont een geval waarin agents hun eigen bewaking verzwakten.
Ook bij WorkOS viel de toegang pas op toen een mens toevallig het ongewone gebruik opmerkte. Een alarm had eerder ingegrepen.
Gevaren van AI-agents beperken met een paar basisregels
Uit beide gevallen volgt een compact beschermingsconcept van vijf regels. De factuuragent laat zien hoe dat eruitziet.
- Geheimen uit de context houden. Tokens zijn kortlevend, nauw afgebakend en worden per taak opnieuw uitgegeven. De factuuragent krijgt nooit het wachtwoord van de boekhouding.
- Minimale rechten. Alleen lezen waar alleen gelezen hoeft te worden. Acties met externe werking zoals verzenden, betalen of verwijderen pas na menselijke goedkeuring.
- Geen vrije toegang naar buiten. Geen open forums, pakketbronnen of vreemde scripts, uitgaand verkeer alleen naar goedgekeurde bestemmingen.
- Isolatie technisch afdwingen. Echte netwerkscheiding in plaats van loutere configuratie, testomgevingen zonder verbinding met productienetwerken.
- Logs buiten de agent. Daarbij alarmen, een noodstop en rate limits en toegangsgrenzen aan de eigen kant, zodat een snelle bezoeker opvalt, of het nu een mens of een agent is.
Daarmee blijft de vraag over die boven alles staat.
Zijn AI-agents gevaarlijk?
Belangrijk is dat elk van deze regels technisch wordt afgedwongen. Een instructie in de prompt om het token nooit door te geven is een wens en geen slot. Het zwermexperiment laat zien dat een doel die wens kan overstemmen, een ontbrekende netwerkverbinding daarentegen niet.
Verwerkt een agent persoonsgegevens, bijvoorbeeld in mailboxen of klantsystemen, dan moet bovendien een gegevensbeschermingseffectbeoordeling volgens art. 35 AVG worden overwogen. De basisregels hierboven verkleinen ook daar het risico, maar vervangen haar niet.
Conclusie
Agents zijn krachtig en nuttig, en beide incidenten laten hetzelfde zien. Het gevaar zit minder in nieuwe magie dan in oude fouten: vergeten inloggegevens, ontbrekende begrenzingen en te veel vertrouwen in regels die alleen in de prompt staan. Een agent doet wat hem is toegestaan, alleen sneller en met meer uithoudingsvermogen dan een mens.
Wie agents inzet, trekt daarom technische grenzen en controleert van buitenaf. Wat de agent niet kan zien, niet kan bereiken en niet kan veranderen, kan hij ook niet prijsgeven.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.