Frontier AI (den mest avancerede AI) bliver ikke kun bedre af mere regnekraft. Samtaler, vurderinger, automatiske tests og simulationer giver signaler, man kan lære af. Også robotter kan få gavn af det.
Den, der bruger AI-assistenter regelmæssigt, har bemærket det: Frontier AI laver færre fejl fra version til version, skriver mere brugbar kode og løser opgaver, som tidligere generationer fejlede på. Forklaringen er ofte, at der simpelthen er mere data og mere regnekraft. Det er rigtigt, men det er ikke hele sandheden. Fremskridtet kommer i stigende grad fra feedback. Svar vurderes, programmer testes, beviser kontrolleres, og resultatet bliver til et læringssignal.
Indlægget gennemgår disse signaler efter tur. Det handler om samtaler mellem mennesker og assistenter, om sammenligning af gode og dårlige svar, om automatiske kontroller og om, hvad rekursiv selvforbedring faktisk betyder i dag. Derefter følger skridtet til robotter, og til sidst er der praktiske anbefalinger om databeskyttelse.
I dag kan enhver selv iagttage i praksis, hvor meget der allerede er muligt med AI. AI er for længst langt mere end en chatbot; det ved i hvert fald enhver, der behersker de tekniske grundprincipper.
Frontier AI: Hvad topmodeller er, og hvor fremskridtet kommer fra
Frontier AI betegner de mest ydedygtige AI-modeller i deres tid. På tysk tales der også om topmodeller eller førende AI-modeller. Der findes ingen fast, almindeligt anerkendt grænse. Ofte beskrives klassen ud fra træningsindsatsen, altså mængden af regnekraft, der er brugt på en model.
Man bør dog hellere tale om AI-systemer, hvor AI-modellerne er hovedbestanddelen. Yderligere komponenter omfatter virtuelle testmiljøer, tool-use-routere med tilsluttede værktøjer osv.
Træningen af sådanne modeller kan groft opdeles i flere trin:
- Fortræning: Modellen læser store mængder tekst og lærer at forudsige sandsynlige fortsættelser. Sådan opstår sprogfornemmelse og verdensviden.
- Eftertræning med feedback: Modellen lærer at give hjælpsomme og uskadelige svar. Til det formål vurderes og sammenlignes svar.
- Træning med kontrolsignaler: Ved opgaver med et entydigt resultat, f.eks. regning eller programmering, afgør en kontrol automatisk, om et løsningsforsøg var korrekt.
- Rekursiv selvforbedring: AI'en forbedrer sig selv og bliver stadig mere intelligent.
Det andet og tredje trin udgør kernen i dette indlæg. Begge bygger på den samme tanke.
Fremskridt hos topmodeller er i stigende grad et spørgsmål om feedback: Den, der kan kontrollere, hvad der var godt, kan lære af det.
Fortræningen giver bredden, feedbacken giver retningen. Uden den forbliver en model en tekstgenerator, der udsender noget plausibelt. Med den lærer den, hvad der i en konkret situation regnes for vellykket.
Hvad der kan ske med brugersamtaler: træning, analyse, sikkerhed
Samtaler med assistenter er en oplagt kilde til læringssignaler, selv om AI-træning med brugerdata kun finder sted på visse betingelser. Det er dog værd at holde fire ting adskilt, som i hverdagen let forveksles:
- Træning: Samtaler indgår i videreudviklingen af modellerne. Om det sker, afhænger af udbyderen, abonnementet og indstillingen.
- Analyse af hensyn til sikkerhed: Samtaler kontrolleres for misbrug eller regelovertrædelser. Det er noget andet end modeltræning.
- Analyse til egne formål: Det glemmer AI-brugere ofte: OpenAI og andre analyserer kundeforespørgsler og AI-svar for at forbedre deres egen AI. Her kan koncepter blive "stjålet".
- Udtrykkelig feedback: Tommel op eller ned, fejlmeldinger og kommentarer afgives målrettet som vurdering.
Et eksempel på en offentliggjort regel leverer Anthropic. Virksomheden varslede i midten af 2025 nye forbrugervilkår. Brugere af forbrugerkonti skulle vælge, om deres chats og kodesessioner må bruges til at forbedre modellerne. Ved samtykke er opbevaringsperioden fem år, uden samtykke 30 dage. Kommercielle tjenester og API'et er undtaget. Ifølge Claudes hjælpeside kan desuden feedback gemmes i op til fem år, og samtaler, der er registreret som markerede, kan kontrolleres af hensyn til sikkerheden. Inkognito-chats er undtaget fra træning.
Også Google beskriver regler af denne art i privatlivsoplysningerne til Gemini-apps. Her er der blandt andet tale om indstillingen for aktivitet, om menneskelige gennemsyn og om opbevaringstider på op til tre år for gennemgåede samtaler og feedback. Hos OpenAI findes der ifølge udbyderens oplysninger en indstilling, som gør det muligt at slå brugen til modelforbedring fra.
Oplysningerne er forskellige fra udbyder til udbyder og ændrer sig. De gælder desuden oftest kun for forbrugerkonti. Det betyder ikke, at andre konti er sikre mod "fremmedbrug af data".
Sådan kan man lære af samtaler uden at læse enkelte chats
Millioner af samtaler kan intet menneske læse. En offentliggjort metode viser, hvordan man alligevel kan genkende mønstre: Clio fra Anthropic. Værktøjet opsummerer automatisk samtaler, grupperer ensartede emner og viser kun anonymiserede, aggregerede resultater. Formålet synes at være analyse af brugsmønstre, opdagelse af misbrug og forbedring af beskyttelsesklassifikatorer. Det er ikke det samme som modeltræning.
Eksemplet gør klart, hvad der grundlæggende er muligt. Af store samtalemængder kan man udlede emner, koncepter og behov. Hvad har folk brug for hjælp til? Hvilke spørgsmål forbliver ubesvarede? Hvor virker svar utilfredsstillende, fordi brugerne spørger igen eller ændrer formuleringen? Sådanne analyser kan vise, hvilke evner en model bør lære næste gang. Om og hvordan enkelte udbydere bruger denne mulighed i deres træning, er ikke dokumenteret i detaljer offentligt. Der er tale om en teknisk mulighed, ikke en bekræftet praksis. Den er (desværre) ikke let at påvise, hvilket øger sandsynligheden for, at den praktiseres.
Udbyderen nævner også grænser. Ikke alle private oplysninger bliver pålideligt genkendt, og et værktøj til samtaleanalyse kan i princippet også misbruges til overvågning. Aggregering og anonymisering er derfor beskyttelsesforanstaltninger, men ingen garanti.
Gode og dårlige svar: Signalet fra sammenligningen
Mennesker har ofte lettere ved at sammenligne to svar end at vurdere ét svar absolut. Dette forhold ligger til grund for eftertræning med menneskelig feedback. Til et spørgsmål opstår der to svar, og en person markerer det bedste. Af mange sådanne par lærer modellen, hvilke egenskaber der foretrækkes: nøjagtighed, forståelighed, passende tone, sikkerhed.
Denne sammenligning er et kontrastivt signal. Modellen lærer ikke kun, hvad der er godt, men også, hvad den skal tage afstand fra. En kendt metode hertil er Direct Preference Optimization (DPO). Den bruger præferencepar direkte til at tilpasse modellen uden først at træne en separat vurderingsmodel.
Vurderinger behøver ikke komme fra mennesker. Constitutional AI beskriver, hvordan en model kritiserer og omarbejder svar ud fra skriftlige principper. Et studie sammenlignede feedback fra AI med feedback fra mennesker og fandt sammenlignelige resultater i de undersøgte opgaver. Det gælder udtrykkeligt kun for disse opgaver og datidens stade.
Her er der berøringspunkter med rekursiv selvforbedring: En model hjælper med at vurdere sin efterfølger. Efterfølgeren bliver dermed bedre, og det næste skridt begynder på et højere niveau. Sløjfen er snævert afgrænset, men delvis reel og finder sted i praksis.
Rekursiv selvforbedring: Hvad der er dokumenteret, og hvad der forbliver prognose
Begrebet vækker store forventninger. Et system skal forbedre sig selv, den forbedrede version forbedrer sig videre, og fremskridtet accelererer. Begrebet bruges forskelligt i debatten, og nogle aktører nævner imponerende procenttal, f.eks. om andelen af AI-skrevet programkode.
Dokumenteret er snarere små byggesten:
- Træning på selvgenererede data, hvor en model skriver svar, som efter en kontrol genbruges.
- AI som bedømmer, som ved Constitutional AI og Reinforcement Learning.
- AI-støtte i udviklingen, f.eks. ved skrivning og test af kode.
Over for det står risici. Trænes en model gentagne gange på AI-output, kan dens kvalitet falde. Forskere taler om modelkollaps (undersøgt i Nature). Også en fejlbehæftet bedømmer er en risiko, for så lærer modellen at tilfredsstille bedømmeren frem for at løse opgaven. Bedømmerens fordomme kan blive forstærket.
Mellem de dokumenterede byggesten og en uophørligt accelererende intelligens ligger et stort rum. Hvor stor en andel sådanne tilbagekoblinger faktisk har i de førende modellers fremskridt, kan ikke opgøres udefra.
Tests og simulationer før svaret: Kontrolsignaler i stedet for meninger
Et læringssignal er særligt kraftigt, når ingen behøver at dømme. Ved nogle opgaver kan resultatet kontrolleres automatisk (f.eks. med Lean). Et program består sine tests eller gør det ikke. Et regnestykke giver det rigtige resultat eller ikke. Et bevis bliver accepteret eller afvist af kontrolprogrammet. Her taler vi om verificerbar belønning, som bruges som læringssignal i Reinforcement Learning.
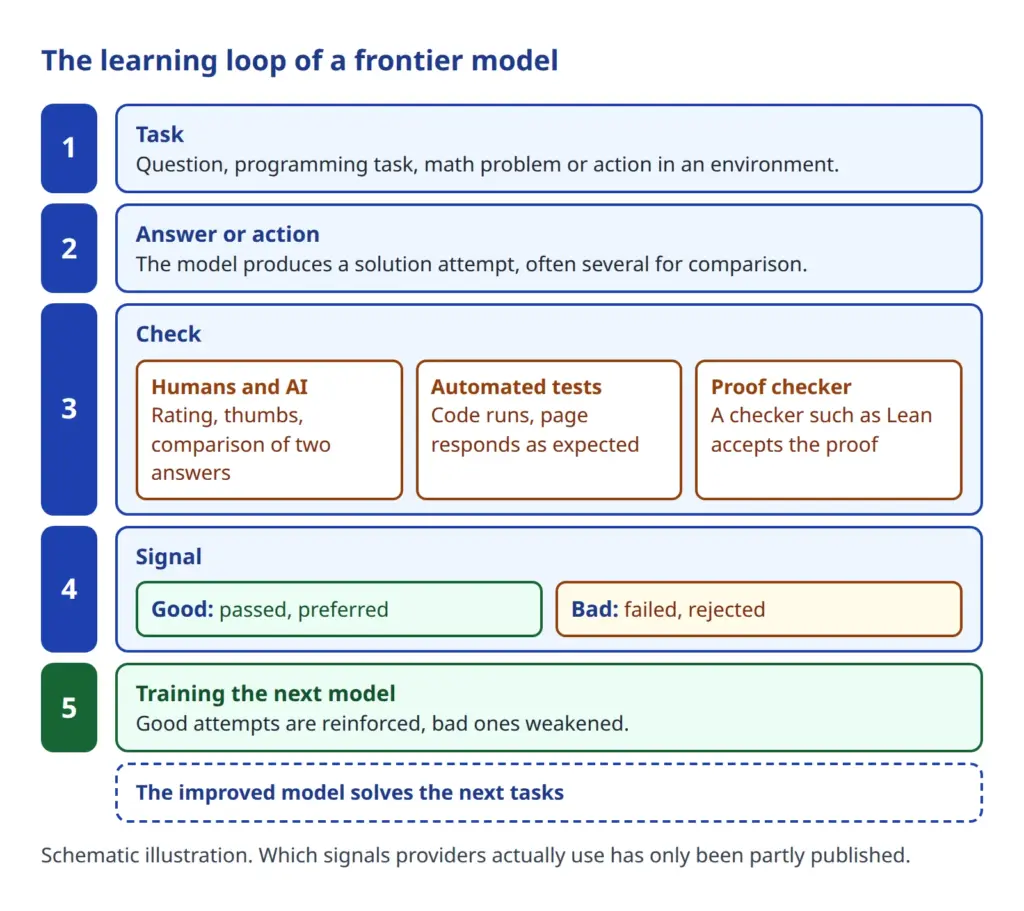
Princippet er veldokumenteret. Arbejdet om DeepSeek-R1 rapporterer, at evnen til at drage slutninger kan vokse gennem Reinforcement Learning med kontrollerbare opgaver. Allerede tidligere viste forskere, at en trænet kontrollant ved regneopgaver i tekstform kan hjælpe med at vælge den rigtige blandt flere løsninger. Bevisassistenter som Lean giver ligeledes en entydig dom og dermed et særligt klart signal.
En test siger ikke, hvad der er smukt, men om det virker, og netop det gør den så værdifuld som læringssignal.
En webapplikation egner sig som eksempel. En agent opretter en side og åbner den derefter med et browsertestværktøj som Playwright/Chromium. Den klikker på knapper, kontrollerer, om formularer virker, og ser, om visningen er korrekt. Fejler noget, retter den koden og tester igen. For brugeren virker det som et bedre svar, der dukker op efter en ventetid. Et overblik over, hvordan modeller trænes, giver indlægget Træning af AI-modeller, og om udbydernes kappestrid indlægget om det uophørlige modelkapløb.
En yderligere tanke trænger sig på: Resultatet af en sådan testkørsel, bestået eller dumpet, kunne indgå som signal i fremtidig træning. Om og i hvilket omfang udbyderne gør det, er spørgsmålet. Dokumenteret er princippet om verificerbar belønning, ikke den konkrete brug af browsertests i træningen.
En test kontrollerer kun det, den er skrevet til. Et program kan bestå alle tests og alligevel løse den forkerte opgave. En model kan desuden lære at snyde tests i stedet for at løse opgaven. Den, der arbejder med agenter, som betjener værktøjer, finder baggrund i indlægget om AI-agenter.

Fremstillingen viser, hvorfor kontrolsignaler er så værdsatte: Jo mere entydig feedbacken er, jo mindre fortolkning kræves der. Samtaledata er rige, men flertydige. Tests er snævre, men klare.
Robotter med AI: Embodied AI, simulation og Sim-to-Real
Hvorfor har robotter gavn af fremskridtene inden for sprog- og tænkemodeller? Fordi en robot, der skal udføre en instruktion som "ryd op i køkkenvasken", har brug for tre evner, som sprogmodeller også øver: at forstå instruktioner, bruge verdensviden og planlægge trin. Embodied AI, altså AI med en krop, tager netop fat dér.
Google DeepMind beskriver med Gemini Robotics en model, der ud over syn og sprog tilføjer et tredje output: handlinger. Sådanne vision-language-action-modeller omsætter et kamerabillede og en sætning til bevægelseskommandoer. Ved siden af findes modeller til embodied reasoning, som yder rumlig forståelse og planlægning og kan kalde værktøjer.
Robotter lærer dog sværere end software. Et fejlslagent forsøg i virkeligheden koster tid, materiale og i værste fald sikkerhed. Her kommer simulationen ind i billedet. I et virtuelt miljø er millioner af forsøg mulige, fejl koster ingenting, og udfaldet kan vurderes automatisk. Det er igen et kontrolsignal, blot for bevægelser.
Problemet hedder Sim-to-Real: Det, der virker i simulationen, fejler ofte i virkeligheden på detaljer som lysforhold, friktion eller målestøj. En kendt modforanstaltning er Domain Randomization. Simulationen beregnes bevidst i mange varianter, så virkeligheden blot bliver endnu en variant. Tobin og kolleger trænede på denne måde en model til objektgenkendelse udelukkende med simulerede billeder og opnåede i praksis en nøjagtighed på ca. 1,5 centimeter.

Verdensmodeller går et skridt videre. De skaber simulerede miljøer ikke ud fra håndbyggede regler, men lærer, hvordan verden ser ud og opfører sig. Genie 3 fra Google DeepMind skaber ifølge virksomheden interaktive verdener i realtid med 24 billeder i sekundet og skulle egne sig til træning af agenter. Udbyderen kalder det en forskningsforhåndsvisning med begrænset konsistens. Også NVIDIA tilbyder med Cosmos og Isaac Sim værktøjer til syntetiske data og simulation.
Grænserne er reelle. Overførslen til fysiske miljøer er fortsat en udfordring, og ved robotter, der møder mennesker, kommer sikkerheden til. En fejl er dér ikke en forkert sætning, men en forkert bevægelse.
Databeskyttelse i hverdagen: Hvad brugere og virksomheder bør kontrollere
Set fra databeskyttelsens side er det vigtigste spørgsmål enkelt at stille, men kan ikke besvares generelt.
Bliver chats med AI-assistenter brugt til træning?
Heraf følger nogle praktiske punkter:
- Kontroller indstillinger: Hvor udbydere tilbyder et valg om brug til træning, er det værd at kigge i privatlivsindstillingerne. Standardindstillinger kan ændre sig.
- Foretræk erhvervsprodukter: For virksomheder er produkter med en databehandleraftale (art. 28 GDPR) almindelige. Vilkårene afviger som regel fra forbrugerkonti.
- Ingen personoplysninger i private konti: Kundedata og interne oplysninger hører ikke hjemme i forbrugerkonti.
- Brug feedback bevidst: Den, der markerer en samtale med tommelfinger eller fejlrapport, kan dermed gøre det muligt, at hele samtalen gemmes længere og gennemgås.
- Vær opmærksom på stade: Udbyderoplysninger har en dato. Afgørende er altid den aktuelle version.
Konklusion
Fremskridt opstår af feedback!
Samtaler og vurderinger viser, hvad mennesker har brug for, og hvad der regnes for et godt svar. Tests, bevischeckere og simulationer siger entydigt, hvad der virker. Begge slags signaler gør modeller bedre og efterhånden også robotter, hvis evner bygger på de samme modeller. Hvor langt rekursiv selvforbedring bærer, er fortsat åbent. Gennemsigtighed og valgmuligheder ved brugerdata forbliver udbydernes opgave, nøje eftersyn brugernes.
Enhver har det i nogen grad selv i hænderne, hvor mange af ens egne data der flyder til tredjeparter. Man kan vælge sparsom indtastning af personlige eller værdifulde data, men også brug af lokal AI. Pseudonymisering kan for korte tekster foretages automatisk eller manuelt. For længere tekster er en automatik dog ikke pålidelig mulig (og heller ikke for korte tekster, hvor mennesket dog kan investere tilstrækkelig indsats i efterkontrol).
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.