Frontier AI (den mest avancerade AI:n) blir inte bättre enbart genom mer beräkningskraft. Samtal, bedömningar, automatiska tester och simuleringar ger signaler som går att lära sig av. Även robotar kan dra nytta av detta.
Den som använder AI-assistenter regelbundet märker det: frontier AI gör färre fel från version till version, skriver mer användbar kod och löser uppgifter som tidigare generationer misslyckades med. Den vanliga förklaringen är helt enkelt mer data och mer beräkningskraft. Det stämmer, men räcker inte hela vägen. Allt oftare kommer framstegen från återkoppling. Svar bedöms, program testas, bevis kontrolleras, och av resultatet uppstår en inlärningssignal.
Artikeln följer dessa signaler en i taget. Det handlar om samtal mellan människor och assistenter, om jämförelsen mellan bra och dåliga svar, om automatiska kontroller och om frågan vad rekursiv självförbättring faktiskt innebär i dag. Därefter följer steget till robotar, och till sist ges praktiska råd om dataskydd.
I dag kan var och en själv se i praktiken vad som redan är möjligt med AI. AI är numera mycket mer än en chattbot; det vet i alla fall alla som behärskar de tekniska grunderna.
Frontier AI: vad spetsmodeller är och var framstegen kommer ifrån
Frontier AI betecknar de mest kraftfulla AI-modellerna i sin tid. Man talar också om spetsmodeller eller ledande AI-modeller. Någon fast, allmänt erkänd gräns finns inte. Ofta beskrivs klassen utifrån träningsinsatsen, alltså mängden beräkningskraft som har lagts på en modell.
Egentligen borde man dock snarare tala om AI-system, där AI-modellerna utgör huvuddelen. Andra komponenter är virtuella testmiljöer, tool-use-routrar med anslutna verktyg och så vidare.
Träningen av sådana modeller kan grovt delas in i flera steg:
- Förträning: modellen läser stora textmängder och lär sig att förutsäga sannolika fortsättningar. Så uppstår språkkänsla och världskunskap.
- Efterträning med återkoppling: modellen lär sig att ge hjälpsamma och ofarliga svar. För detta bedöms och jämförs svar.
- Träning med kontrollsignaler: vid uppgifter med entydigt resultat, till exempel räkning eller programmering, avgör en kontroll automatiskt om ett lösningsförsök var rätt.
- Rekursiv självförbättring: AI:n lär upp sig själv och blir allt smartare.
Det andra och tredje steget utgör kärnan i den här artikeln. Båda bygger på samma tanke.
Framsteg hos spetsmodeller är alltmer en fråga om återkoppling: den som kan kontrollera vad som var bra kan lära sig av det.
Förträningen ger bredden, återkopplingen ger riktningen. Utan den förblir en modell en textgenerator som producerar rimligt klingande text. Med den lär den sig vad som räknas som lyckat i en konkret situation.
Vad som kan hända med användarsamtal: träning, analys, säkerhet
Samtal med assistenter är en självklar källa till inlärningssignaler, även om AI-träning med användardata bara sker under vissa villkor. Det lönar sig dock att skilja på fyra saker som lätt blandas ihop i vardagen:
- Träning: samtal används för att vidareutveckla modellerna. Om det sker beror på leverantören, abonnemanget och inställningen.
- Analys för säkerhet: samtal granskas med avseende på missbruk eller regelbrott. Det är något annat än modellträning.
- Analys för egna syften: det glömmer AI-användare ofta. OpenAI och andra analyserar kundförfrågningar och AI-svar för att förbättra sin egen AI. Då kan koncept bli ”stulna”.
- Uttrycklig feedback: tumme upp eller ner, felrapporter och kommentarer lämnas medvetet som bedömning.
Anthropic ger ett exempel på en publicerad regel. Företaget aviserade i mitten av 2025 nya konsumentvillkor. Användare av konsumentkonton skulle välja om deras chattar och kodningssessioner får användas för att förbättra modellerna. Med samtycke är lagringstiden fem år, utan samtycke 30 dagar. Kommersiella tjänster och API:et är undantagna. Enligt Claudes hjälpsida kan dessutom feedback lagras i upp till fem år, och samtal som flaggats kan granskas i säkerhetssyfte. Inkognitochattar är undantagna från träning.
Även Google beskriver regler av detta slag i integritetsinformationen för Gemini-apparna. Där nämns bland annat inställningen för aktivitet, mänskliga granskare och lagringstider på upp till tre år för granskade samtal och feedback. Hos OpenAI finns enligt leverantörens information en inställning som stänger av användningen för modellförbättring.
Uppgifterna skiljer sig mellan leverantörer och ändras över tid. Dessutom gäller de oftast bara konsumentkonton. Det betyder inte att andra konton är skyddade mot att data används för främmande ändamål.
Hur man kan lära av samtal utan att läsa enskilda chattar
Ingen människa kan läsa miljontals samtal. En publicerad metod visar hur mönster ändå kan upptäckas: Clio från Anthropic. Verktyget sammanfattar samtal automatiskt, grupperar liknande ämnen och visar bara anonymiserade, aggregerade resultat. Syftet ligger enligt uppgift i att analysera användningsmönster, upptäcka missbruk och förbättra skyddsklassificerare. Det kan inte likställas med modellträning.
Exemplet visar vad som är möjligt i princip. Ur stora mängder samtal kan ämnen, koncept och behov härledas. Vad behöver människor hjälp med? Vilka frågor förblir obesvarade? Var verkar svaren otillfredsställande, eftersom användare följer upp eller omformulerar sin fråga? Sådana analyser kan visa vilka förmågor en modell borde lära sig härnäst. Om och hur enskilda leverantörer använder denna möjlighet i sin träning är inte offentligt belagt i detalj. Det är en teknisk möjlighet, inte en bekräftad praxis. Den är (tyvärr) inte lätt att påvisa, vilket ökar sannolikheten för att den tillämpas.
Leverantören nämner också begränsningar. Inte alla privata uppgifter upptäcks på ett tillförlitligt sätt, och ett verktyg för samtalsanalys kan i princip också missbrukas för övervakning. Aggregering och anonymisering är därför skyddsåtgärder, men ingen garanti.
Bra och dåliga svar: signalen från jämförelsen
Människor har ofta lättare att jämföra två svar än att bedöma ett svar i absoluta termer. Detta ligger till grund för efterträning med mänsklig feedback. Till en fråga genereras två svar, och en person markerar det bättre. Av många sådana par lär sig modellen vilka egenskaper som föredras: noggrannhet, begriplighet, lämplig ton, säkerhet.
Denna jämförelse är en kontrastiv signal. Modellen lär sig inte bara vad som är bra, utan också vad den ska ta avstånd från. En välkänd metod för detta är Direct Preference Optimization (DPO). Den använder preferenspar direkt för att anpassa modellen, utan att först träna en separat belöningsmodell.
Bedömningar behöver inte komma från människor. Constitutional AI beskriver hur en modell kritiserar och omarbetar svar utifrån skrivna principer. En studie jämförde feedback från AI med feedback från människor och fann jämförbara resultat för de undersökta uppgifterna. Det gäller uttryckligen bara dessa uppgifter och dåvarande kunskapsläge.
Här finns beröringspunkter med rekursiv självförbättring: en modell hjälper till att bedöma sin efterföljare. Efterföljaren blir därigenom bättre, och nästa steg börjar på en högre nivå. Slingan är snävt avgränsad, men delvis verklig och förekommer i praktiken.
Rekursiv självförbättring: vad som är belagt och vad som förblir prognos
Begreppet väcker stora förväntningar. Ett system ska förbättra sig självt, den förbättrade versionen förbättrar sig vidare, och framstegen accelererar. Begreppet används på olika sätt i debatten, och vissa aktörer anger imponerande procentsatser, till exempel om andelen AI-skriven programkod.
Belagda är snarare små byggstenar:
- Träning på självgenererade data, där en modell skriver svar som återanvänds efter en kontroll.
- AI som bedömare, som vid Constitutional AI och Reinforcement Learning.
- AI-stöd i utvecklingen, till exempel när kod skrivs och testas.
Mot detta står risker. Om en modell upprepade gånger tränas på AI-utdata kan dess kvalitet sjunka. Forskare talar om modellkollaps (undersökt i Nature). Även en felaktig bedömare är en risk, eftersom modellen då lär sig att behaga bedömaren i stället för att lösa uppgiften. Bedömarens fördomar kan förstärkas.
Mellan de belagda byggstenarna och en ostoppbart accelererande intelligens ligger ett stort avstånd. Hur stor andel sådana återkopplingar faktiskt har i de ledande modellernas framsteg går inte att kvantifiera utifrån.
Tester och simuleringar före svaret: kontrollsignaler i stället för åsikter
En inlärningssignal är särskilt stark när ingen behöver döma. För vissa uppgifter kan resultatet kontrolleras automatiskt (till exempel med Lean). Ett program klarar sina tester eller inte. En beräkning ger rätt resultat eller inte. Ett bevis godtas eller förkastas av kontrollprogrammet. Här talar vi om verifierbar belöning, som fungerar som inlärningssignal vid reinforcement learning.
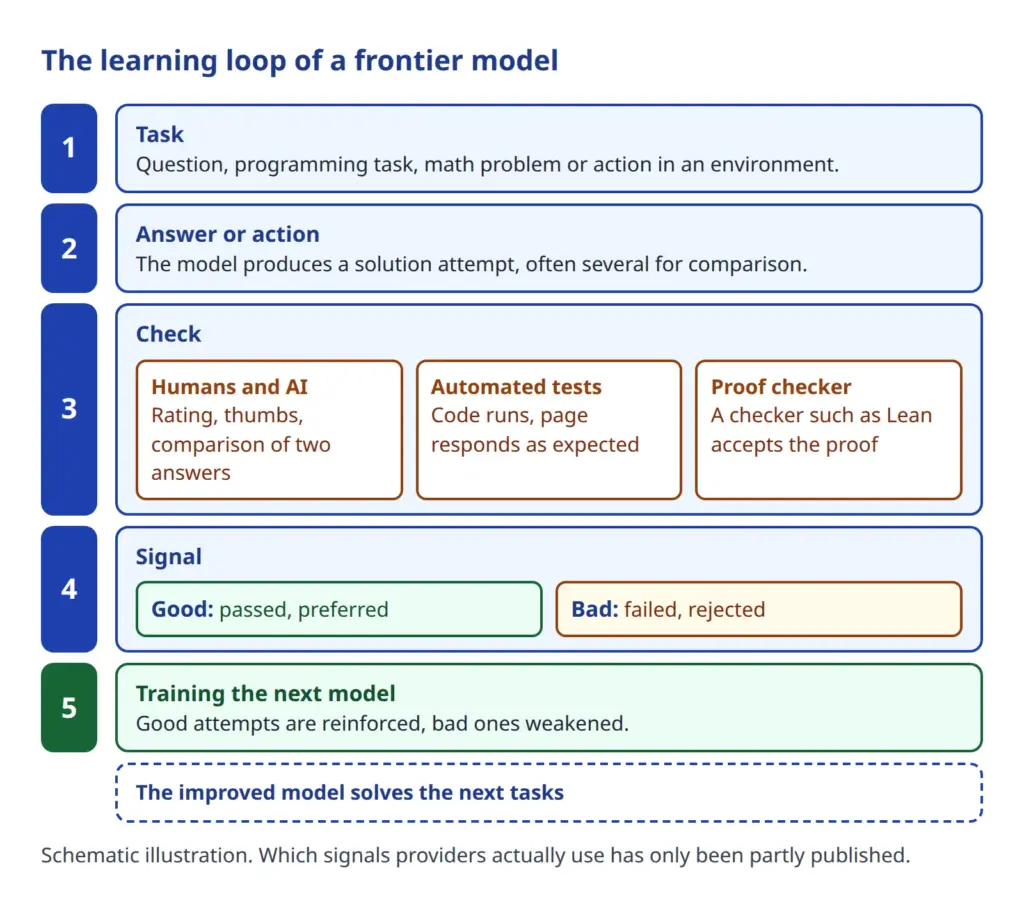
Principen är väl belagd. Arbetet om DeepSeek-R1 rapporterar att förmågan att dra slutsatser kan växa genom reinforcement learning med kontrollerbara uppgifter. Redan tidigare visade forskare att en tränad kontrollant kan hjälpa till att välja rätt lösning bland flera vid textuppgifter i matematik. Bevisassistenter som Lean ger också ett entydigt utlåtande och därmed en särskilt tydlig signal.
Ett test säger inte vad som är vackert, utan om det fungerar, och just det gör det så värdefullt som inlärningssignal.
En webbapplikation fungerar bra som exempel. En agent skapar en sida och öppnar den sedan med ett verktyg för webbläsartester som Playwright/Chromium. Den klickar på knappar, kontrollerar om formulär fungerar och ser om layouten stämmer. Om något misslyckas korrigerar den koden och testar igen. För användaren ser det ut som ett bättre svar som dyker upp efter en stunds väntan. En översikt över hur modeller tränas ger artikeln Träning av AI-modeller, och konkurrensen mellan leverantörerna behandlas i artikeln om den ständiga modellkapplöpningen.
En ytterligare tanke ligger nära till hands: resultatet av en sådan testkörning, godkänd eller underkänd, skulle kunna användas som signal i framtida träning. Om och i vilken omfattning leverantörer gör det är frågan. Belagd är principen om verifierbar belöning, inte den konkreta användningen av webbläsartester i träningen.
Ett test kontrollerar bara det som det skrevs för. Ett program kan klara alla tester och ändå lösa fel uppgift. En modell kan dessutom lära sig att lura testerna i stället för att lösa uppgiften. Den som arbetar med agenter som använder verktyg hittar bakgrund i artikeln om AI-agenter.
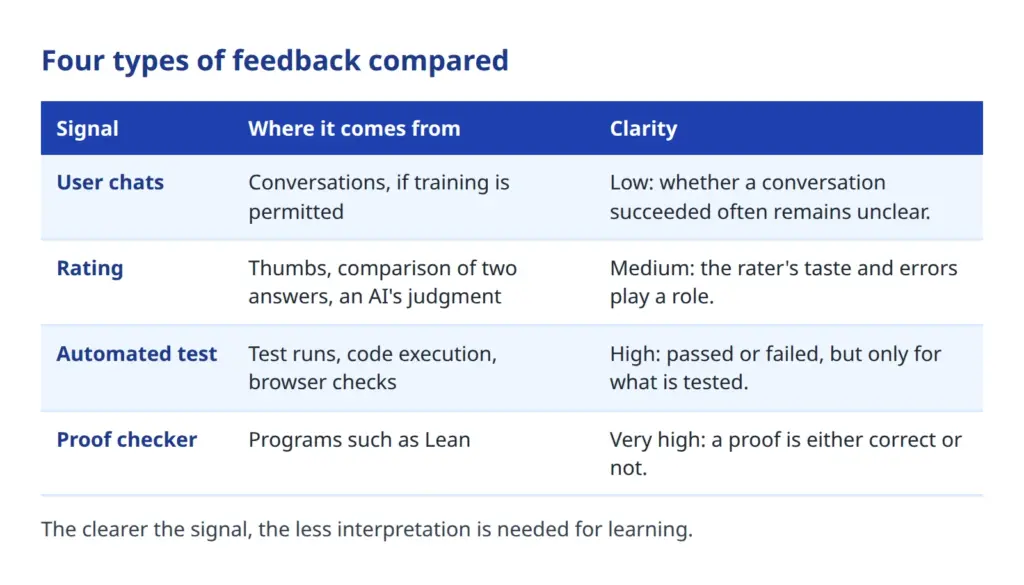
Översikten visar varför kontrollsignaler värderas så högt: ju entydigare återkopplingen är, desto mindre tolkning behövs. Samtalsdata är rika, men mångtydiga. Tester är snäva, men tydliga.
Robotar med AI: embodied AI, simulering och sim-to-real
Varför drar robotar nytta av framstegen hos språk- och resonemangsmodeller? Därför att en robot som ska utföra en instruktion som ”städa diskhon” behöver tre förmågor som även språkmodeller övar på: att förstå instruktioner, att använda världskunskap och att planera steg. Embodied AI, alltså AI med en kropp, tar sin utgångspunkt just där.
Google DeepMind beskriver med Gemini Robotics en modell som lägger till en tredje utdata till syn och språk: handlingar. Sådana vision-language-action-modeller översätter en kameravy och en mening till rörelsekommandon. Dessutom finns modeller för embodied reasoning som står för rumslig förståelse och planering och kan anropa verktyg.
Robotar lär sig dock svårare än programvara. Ett misslyckat försök i verkligheten kostar tid, material och i värsta fall säkerhet. Här kommer simuleringen in. I en virtuell miljö är miljontals försök möjliga, misstag kostar ingenting, och utfallet kan bedömas automatiskt. Det är återigen en kontrollsignal, fast för rörelser.
Problemet kallas sim-to-real: det som fungerar i simuleringen misslyckas ofta i verkligheten på grund av detaljer som ljusförhållanden, friktion eller mätbrus. En välkänd motåtgärd är domain randomization. Simuleringen beräknas avsiktligt i många varianter, så att verkligheten bara blir ytterligare en variant. Tobin och kollegor tränade på detta sätt en modell för objektigenkänning enbart med simulerade bilder och uppnådde i praktiken en noggrannhet på cirka 1,5 centimeter.
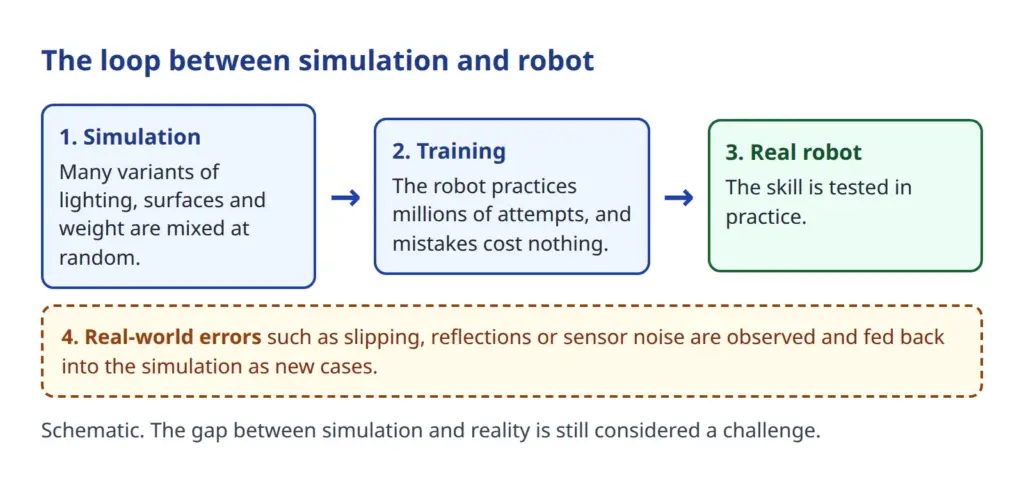
Världsmodeller går ett steg längre. De skapar inte simulerade miljöer utifrån handbyggda regler, utan lär sig hur världen ser ut och beter sig. Genie 3 från Google DeepMind genererar enligt företaget interaktiva världar i realtid med 24 bilder per sekund och ska lämpa sig för att träna agenter. Leverantören kallar det en forskningsförhandsvisning med begränsad konsistens. Även NVIDIA erbjuder med Cosmos och Isaac Sim verktyg för syntetiska data och simulering.
Begränsningarna är verkliga. Överföringen till fysiska miljöer förblir en utmaning, och för robotar som möter människor tillkommer säkerheten. Där är ett fel ingen felaktig mening, utan en felaktig rörelse.
Dataskydd i vardagen: vad användare och företag bör kontrollera
Ur dataskyddssynpunkt är den viktigaste frågan enkel att ställa, men kan inte besvaras generellt.
Används chattar med AI-assistenter för träning?
Av detta följer några praktiska punkter:
- Kontrollera inställningar: där leverantörer erbjuder ett val om användning för träning lönar det sig att titta i integritetsinställningarna. Standardinställningar kan ändras.
- Föredra företagsprodukter: för företag är produkter med personuppgiftsbiträdesavtal (art. 28 GDPR) standard. Villkoren skiljer sig oftast från konsumentkonton.
- Inga personuppgifter i privata konton: kunddata och intern information hör inte hemma i konsumentkonton.
- Använd feedback medvetet: den som markerar ett samtal med tumme eller felrapport kan därmed möjliggöra att hela samtalet lagras och granskas längre.
- Tänk på datumet: leverantörers uppgifter har ett datum. Det är alltid den aktuella versionen som gäller.
Slutsats
Framsteg uppstår ur återkoppling!
Samtal och bedömningar visar vad människor behöver och vad som räknas som ett bra svar. Tester, bevisprogram och simuleringar säger entydigt vad som fungerar. Båda typerna av signaler gör modellerna bättre och efter hand även robotar, vars förmågor bygger på samma modeller. Hur långt rekursiv självförbättring räcker är fortfarande öppet. Transparens och valmöjligheter kring användardata förblir leverantörernas uppgift, att granska noga användarnas.
Var och en har det delvis i egna händer hur mycket av de egna uppgifterna som flödar till tredje part. Alternativen är att mata in personliga eller värdefulla uppgifter sparsamt, men också att använda lokal AI. Pseudonymisering kan för korta texter göras automatiskt eller manuellt. För längre texter är en automatik dock inte tillförlitligt möjlig (och egentligen inte heller för korta texter, men där kan människan lägga tillräckligt med arbete på efterkontroll).
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.