gekennzeichnet.


Frontier AI (die fortschrittlichste KI) wird nicht nur durch mehr Rechenleistung besser. Gespräche, Bewertungen, automatische Tests und Simulationen liefern Signale, aus denen sich lernen lässt. Auch Roboter können davon profitieren.
Wer KI-Assistenten regelmäßig nutzt, bemerkt es: Frontier AI macht von Version zu Version weniger Fehler, schreibt brauchbareren Code und löst Aufgaben, an denen frühere Generationen scheiterten. Häufig lautet die Erklärung, es gebe schlicht mehr Daten und mehr Rechenleistung. Das stimmt, greift aber zu kurz. Zunehmend kommt der Fortschritt aus Rückkopplung. Antworten werden bewertet, Programme werden getestet, Beweise werden geprüft, und aus dem Ergebnis entsteht ein Lernsignal.
Der Beitrag geht diesen Signalen der Reihe nach nach. Es geht um Gespräche zwischen Menschen und Assistenten, um den Vergleich guter und schlechter Antworten, um automatische Prüfungen und um die Frage, was rekursive Selbstverbesserung heute tatsächlich bedeutet. Danach folgt der Schritt zu Robotern, und zum Schluss gibt es praktische Empfehlungen zum Datenschutz.
Heute kann jeder selbst in der Praxis beobachten, was schon alles mit KI möglich ist. KI ist mittlerweile weit mehr als ein Chatbot; das weiß jedenfalls jeder, der die technischen Grundlagen beherrscht.
Frontier AI: Was Spitzenmodelle sind und woher der Fortschritt kommt
Frontier AI bezeichnet die leistungsfähigsten KI-Modelle ihrer Zeit. Im Deutschen ist auch von Spitzenmodellen oder führenden KI-Modellen die Rede. Eine feste, allgemein anerkannte Grenze gibt es nicht. Häufig wird die Klasse über den Trainingsaufwand beschrieben, also über die Menge an Rechenleistung, die in ein Modell geflossen ist.
Allerdings sollte eher von KI-Systemen gesprochen werden, von denen die KI-Modelle der Hauptbestandteil sind. Weitere Komponenten enthalten virtuelle Testumgebungen, Tool-Use Router mitsamt angebundener Tools usw.
Das Training solcher Modelle lässt sich grob in mehrere Stufen gliedern:
- Vortraining: Das Modell liest große Textmengen und lernt, wahrscheinliche Fortsetzungen vorherzusagen. So entstehen Sprachgefühl und Weltwissen.
- Nachtraining mit Rückmeldung: Das Modell lernt, hilfreiche und unbedenkliche Antworten zu geben. Dafür werden Antworten bewertet und verglichen.
- Training mit Prüfsignalen: Bei Aufgaben mit eindeutigem Ergebnis, etwa Rechnen oder Programmieren, entscheidet eine Prüfung automatisch, ob ein Lösungsversuch richtig war.
- Rekursive Selbtverbesserung: Die KI schlaut sich selbst auf und wird immer intelligenter.
Die zweite und dritte Stufe bilden den Kern dieses Beitrags. Beide beruhen auf demselben Gedanken.
Fortschritt bei Spitzenmodellen ist zunehmend eine Frage der Rückkopplung: Wer prüfen kann, was gut war, kann daraus lernen.
Das Vortraining liefert die Breite, die Rückkopplung liefert die Richtung. Ohne sie bleibt ein Modell ein Textgenerator, der Plausibles von sich gibt. Mit ihr lernt es, was in einer konkreten Situation als gelungen gilt.
Was mit Nutzerkonversationen geschehen kann: Training, Auswertung, Sicherheit
Gespräche mit Assistenten sind eine naheliegende Quelle für Lernsignale, auch wenn das KI Training mit Nutzerdaten nur unter bestimmten Bedingungen stattfindet. Es lohnt sich jedoch, vier Dinge zu trennen, die im Alltag leicht verwechselt werden:
- Training: Gespräche fließen in die Weiterentwicklung der Modelle ein. Ob das geschieht, hängt vom Anbieter, vom Tarif und von der Einstellung ab.
- Auswertung für Sicherheit: Gespräche werden auf Missbrauch oder Regelverstöße geprüft. Das ist etwas anderes als Modelltraining.
- Auswertung für eigene Zwecke: Daswird oft von KI-Nutzern vergessen: OpenAI und andere analysieren Kundenanfragen und KI-Antworten, um die eigene KI zu verbessern. Dabei können Konzepte "geklaut" werden.
- Ausdrückliches Feedback: Daumen hoch oder runter, Fehlermeldungen und Kommentare werden gezielt als Bewertung abgegeben.
Ein Beispiel für eine veröffentlichte Regelung liefert Anthropic. Das Unternehmen kündigte Mitte 2025 neue Verbraucherbedingungen an. Nutzer von Verbraucherkonten sollten wählen, ob ihre Chats und Coding-Sitzungen zur Verbesserung der Modelle genutzt werden dürfen. Bei Zustimmung beträgt die Aufbewahrungsfrist fünf Jahre, ohne Zustimmung 30 Tage. Kommerzielle Dienste und die API sind davon ausgenommen. Gemäß der Hilfeseite von Claude können außerdem Feedback bis zu fünf Jahre gespeichert und als markiert erkannte Gespräche für Sicherheitszwecke geprüft werden. Inkognito-Chats sind vom Training ausgenommen.
Auch Google beschreibt in den Datenschutzhinweisen zu den Gemini-Apps Regeln dieser Art. Dort ist unter anderem von der Einstellung zu Aktivitäten, von menschlichen Prüfern und von Aufbewahrungszeiten bis zu drei Jahren bei geprüften Gesprächen und Feedback die Rede. Bei OpenAI gibt es nach den Hinweisen des Anbieters eine Einstellung, mit der sich die Nutzung für die Modellverbesserung abschalten lässt.
Die Angaben unterscheiden sich je Anbieter und ändern sich. Sie gelten außerdem meist nur für Verbraucherkonten. Das heißt nicht, dass andere Konten vor "Datenfremdnutzung" sicher sind.
Wie sich aus Gesprächen lernen lässt, ohne einzelne Chats zu lesen
Millionen Gespräche kann kein Mensch lesen. Ein veröffentlichtes Verfahren zeigt, wie sich trotzdem Muster erkennen lassen: Clio von Anthropic. Das Werkzeug fasst Gespräche automatisch zusammen, gruppiert ähnliche Themen und zeigt nur anonymisierte, aggregierte Ergebnisse. Der Zweck liegt anscheinend bei der Analyse von Nutzungsmustern, bei der Erkennung von Missbrauch und bei der Verbesserung von Schutzklassifikatoren. Mit Modelltraining ist das nicht gleichzusetzen.
Das Beispiel macht deutlich, was grundsätzlich möglich ist. Aus großen Gesprächsmengen lassen sich Themen, Konzepte und Bedürfnisse ableiten. Wofür brauchen Menschen Hilfe? Welche Fragen bleiben unbeantwortet? Wo wirken Antworten unbefriedigend, weil Nutzer nachhaken oder die Formulierung ändern? Solche Auswertungen können zeigen, welche Fähigkeiten ein Modell als Nächstes lernen sollte. Ob und wie einzelne Anbieter diese Möglichkeit für ihr Training nutzen, ist öffentlich nicht im Detail belegt. Es handelt sich um eine technische Möglichkeit, nicht um eine bestätigte Praxis. Sie ist (leider) nicht leicht nachweisbar, was die Wahrscheinlichkeit dafür erhöht, dass sie praktiziert wird.
Der Anbieter nennt auch Grenzen. Nicht alle privaten Angaben werden zuverlässig erkannt, und ein Werkzeug zur Gesprächsanalyse lässt sich im Prinzip auch zur Überwachung missbrauchen. Aggregation und Anonymisierung sind deshalb Schutzmaßnahmen, aber keine Garantie.
Gute und schlechte Antworten: Das Signal aus dem Vergleich
Menschen fällt es oft leichter, zwei Antworten zu vergleichen, als eine Antwort absolut zu bewerten. Dieser Umstand liegt dem Nachtraining mit menschlichem Feedback zugrunde. Zu einer Frage entstehen zwei Antworten, und eine Person markiert die bessere. Aus vielen solcher Paare lernt das Modell, welche Eigenschaften bevorzugt werden: Genauigkeit, Verständlichkeit, passender Ton, Sicherheit.
Dieser Vergleich ist ein kontrastives Signal. Das Modell lernt nicht nur, was gut ist, sondern auch, wovon es sich abgrenzen soll. Ein bekanntes Verfahren dafür ist die Direct Preference Optimization (DPO). Sie nutzt Präferenzpaare unmittelbar zur Anpassung des Modells, ohne zuvor ein eigenes Bewertungsmodell zu trainieren.
Bewertungen müssen nicht von Menschen stammen. Constitutional AI beschreibt, wie ein Modell Antworten anhand schriftlicher Grundsätze kritisiert und überarbeitet. Eine Studie verglich Feedback durch KI mit Feedback durch Menschen und fand in den untersuchten Aufgaben vergleichbare Ergebnisse. Das gilt ausdrücklich nur für diese Aufgaben und den damaligen Stand.
Hier gibt es Berührungspunkte mit der rekursiven Selbstverbesserung: Ein Modell hilft, den Nachfolger zu bewerten. Der Nachfolger wird dadurch besser, und der übernächste Schritt beginnt auf höherem Niveau. Die Schleife ist eng begrenzt, in Teilen aber real und findet praktisch statt.
Rekursive Selbstverbesserung: Was belegt ist und was Prognose bleibt
Der Begriff weckt große Erwartungen. Ein System soll sich selbst verbessern, die verbesserte Version verbessert sich weiter, und der Fortschritt beschleunigt sich. Der Begriff wird in der Debatte unterschiedlich verwendet, und manche Player nennen beeindruckende Prozentzahlen, etwa zum Anteil KI-geschriebenen Programmcodes.
Belegt sind eher kleine Bausteine:
- Training auf selbst erzeugten Daten, bei dem ein Modell Antworten schreibt und diese nach einer Prüfung wiederverwendet werden.
- KI als Bewerter, wie bei Constitutional AI und Reinforcement Learning.
- KI-Unterstützung bei der Entwicklung, etwa beim Schreiben und Testen von Code.
Dem stehen Risiken gegenüber. Wird ein Modell wiederholt auf KI-Ausgaben trainiert, kann seine Qualität sinken. Forschende sprechen von Modellkollaps (untersucht in Nature). Auch ein fehlerhafter Bewerter ist ein Risiko, denn ein Modell lernt dann, dem Bewerter zu gefallen statt der Aufgabe gerecht zu werden. Vorurteile des Bewerters können sich verstärken.
Zwischen den belegten Bausteinen und einer sich unaufhaltsam beschleunigenden Intelligenz liegt ein weiter Raum. Wie groß der Anteil solcher Rückkopplungen am Fortschritt der führenden Modelle tatsächlich ist, lässt sich von außen nicht beziffern.
Tests und Simulationen vor der Antwort: Prüfsignale statt Meinungen
Besonders kräftig ist ein Lernsignal, wenn niemand urteilen muss. Bei manchen Aufgaben lässt sich das Ergebnis automatisch prüfen (etwa mit Lean). Ein Programm besteht seine Tests oder nicht. Eine Rechnung ergibt das richtige Ergebnis oder nicht. Ein Beweis wird vom Prüfprogramm akzeptiert oder abgelehnt. Wir sprechen hier von verifizierbarer Belohnung, die beim Reinforcement Learning als Lernsignal dient.
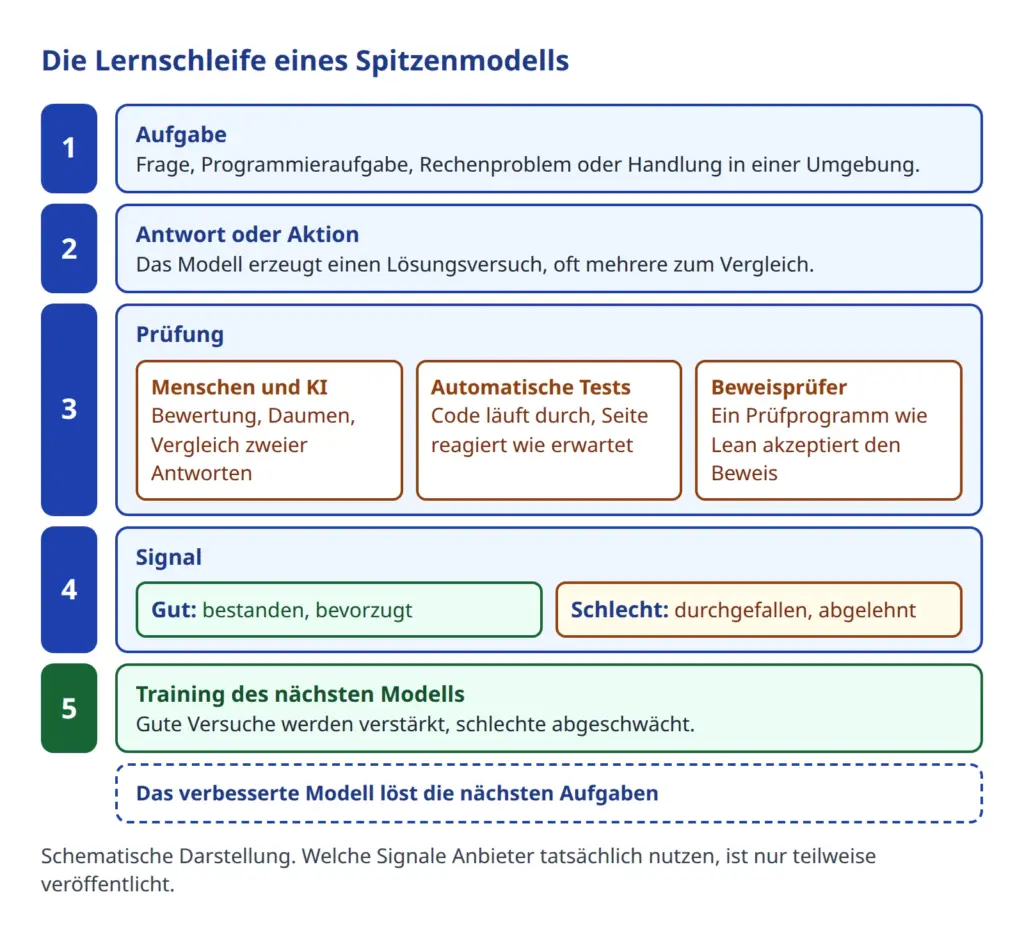
Das Prinzip ist gut belegt. Die Arbeit zu DeepSeek-R1 berichtet, dass Fähigkeiten zum Schlussfolgern durch Reinforcement Learning mit prüfbaren Aufgaben wachsen können. Schon früher zeigten Forscher dass ein trainierter Prüfer bei Textaufgaben zum Rechnen helfen kann, aus mehreren Lösungen die richtige auszuwählen. Beweisassistenten wie Lean liefern ebenfalls ein eindeutiges Urteil und damit ein besonders klares Signal.
Ein Test sagt nicht, was schön ist, sondern ob es funktioniert, und genau das macht ihn als Lernsignal so wertvoll.
Als Beispiel taugt eine Webanwendung. Ein Agent erstellt eine Seite und öffnet sie anschließend mit einem Browser-Testwerkzeug wie Playwright/Chromium. Er klickt auf Schaltflächen, prüft, ob Formulare funktionieren, und sieht, ob die Darstellung stimmt. Schlägt etwas fehl, korrigiert er den Code und testet erneut. Für den Nutzer wirkt das wie eine bessere Antwort, die nach einer Wartezeit erscheint. Einen Überblick, wie Modelle trainiert werden, gibt der Beitrag Training von KI-Modellen, zum Wettbewerb der Anbieter der Beitrag zum ständigen Modell-Wettlauf.
Ein weiterer Gedanke drängt sich auf: Das Ergebnis eines solchen Testlaufs, bestanden oder durchgefallen, könnte als Signal in künftiges Training einfließen. Ob und in welchem Umfang Anbieter das tun, ist die Frage. Belegt ist das Prinzip der verifizierbaren Belohnung, nicht die konkrete Nutzung von Browser-Tests im Training.
Ein Test prüft nur das, wofür er geschrieben wurde. Ein Programm kann alle Tests bestehen und trotzdem die falsche Aufgabe lösen. Ein Modell kann außerdem lernen, Tests auszutricksen, statt die Aufgabe zu lösen. Wer mit Agenten arbeitet, die Werkzeuge bedienen, findet Hintergründe im Beitrag zu KI-Agenten.
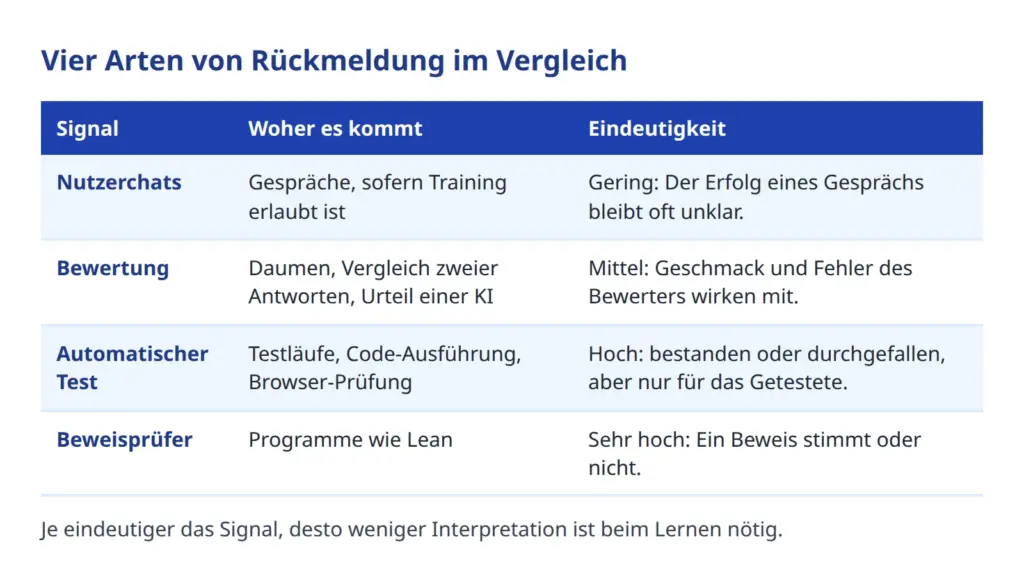
Die Darstellung zeigt, warum Prüfsignale so geschätzt werden: Je eindeutiger die Rückmeldung, desto weniger Deutung ist nötig. Gesprächsdaten sind reich, aber mehrdeutig. Tests sind eng, aber klar.
Roboter mit KI: Embodied AI, Simulation und Sim-to-Real
Warum profitieren Roboter von den Fortschritten bei Sprach- und Denkmodellen? Weil ein Roboter, der eine Anweisung wie "räume die Spüle auf" ausführen soll, drei Fähigkeiten braucht, die auch Sprachmodelle üben: Anweisungen verstehen, Weltwissen nutzen und Schritte planen. Embodied AI, also KI mit einem Körper, setzt genau dort an.
Google DeepMind beschreibt mit Gemini Robotics ein Modell, das zu Sehen und Sprache eine dritte Ausgabe hinzufügt: Aktionen. Solche Vision-Language-Action-Modelle übersetzen eine Kameraansicht und einen Satz in Bewegungsbefehle. Daneben gibt es Modelle für Embodied Reasoning, die räumliches Verständnis und Planung leisten und Werkzeuge aufrufen können.
Roboter lernen allerdings schwerer als Software. Ein Fehlversuch in der Wirklichkeit kostet Zeit, Material und im schlimmsten Fall Sicherheit. Hier kommt die Simulation ins Spiel. In einer virtuellen Umgebung sind Millionen Versuche möglich, Fehler kosten nichts, und der Ausgang lässt sich automatisch bewerten. Das ist wieder ein Prüfsignal, nur eben für Bewegungen.
Das Problem heißt Sim-to-Real: Was in der Simulation funktioniert, scheitert in der Wirklichkeit oft an Kleinigkeiten wie Lichtverhältnissen, Reibung oder Messrauschen. Eine bekannte Gegenmaßnahme ist die Domain Randomization. Die Simulation wird absichtlich in vielen Varianten gerechnet, sodass die Wirklichkeit nur noch eine weitere Variante ist. Tobin und Kollegen trainierten auf diese Weise ein Modell zur Objekterkennung ausschließlich mit simulierten Bildern und erreichten in der Praxis eine Genauigkeit von etwa 1,5 Zentimetern.
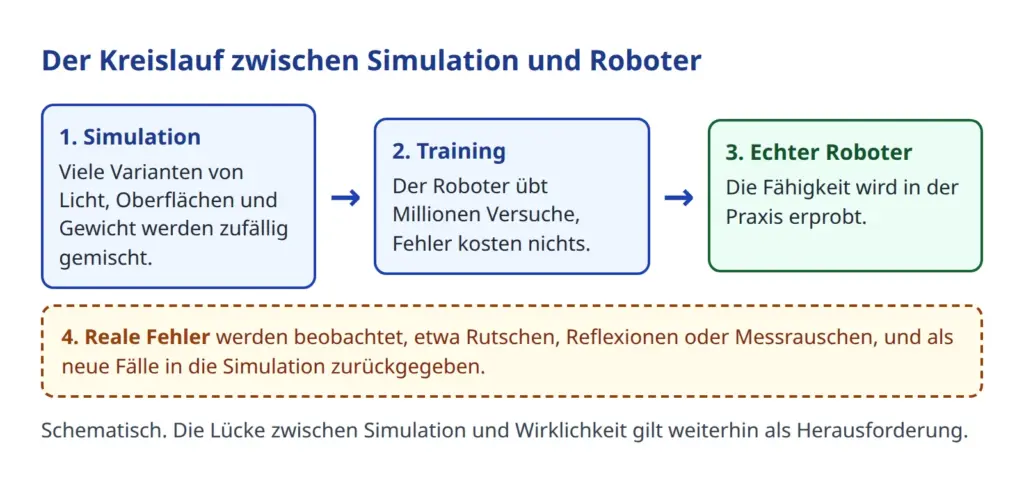
Einen Schritt weiter gehen Weltmodelle. Sie erzeugen simulierte Umgebungen nicht aus Hand gebauten Regeln, sondern lernen, wie die Welt aussieht und sich verhält. Genie 3 von Google DeepMind erzeugt nach Angaben des Unternehmens interaktive Welten in Echtzeit mit 24 Bildern pro Sekunde und soll sich zum Training von Agenten eignen. Der Anbieter nennt es eine Forschungsvorschau mit begrenzter Konsistenz. Auch NVIDIA bietet mit Cosmos und Isaac Sim Werkzeuge für synthetische Daten und Simulation an.
Die Grenzen sind real. Die Übertragung in physische Umgebungen bleibt eine Herausforderung, und bei Robotern, die Menschen begegnen, kommt die Sicherheit hinzu. Ein Fehler ist dort kein falscher Satz, sondern eine falsche Bewegung.
Datenschutz im Alltag: Was Nutzer und Unternehmen prüfen sollten
Aus Sicht des Datenschutzes ist die wichtigste Frage einfach gestellt, aber nicht pauschal zu beantworten.
Werden Chats mit KI-Assistenten zum Training verwendet?
Daraus ergeben sich einige praktische Punkte:
- Einstellungen prüfen: Wo Anbieter eine Wahl zur Nutzung für das Training vorsehen, lohnt ein Blick in die Datenschutzeinstellungen. Voreinstellungen können sich ändern.
- Geschäftsprodukte bevorzugen: Für Unternehmen sind Produkte mit Vertrag zur Auftragsverarbeitung (Art. 28 DSGVO) üblich. Die Bedingungen weichen meist von Verbraucherkonten ab.
- Keine personenbezogenen Daten in private Konten: Kundendaten und Interna gehören nicht in Verbraucherkonten.
- Feedback bewusst nutzen: Wer ein Gespräch mit Daumen oder Fehlerbericht markiert, kann damit ermöglichen, dass das ganze Gespräch länger gespeichert und geprüft wird.
- Stand beachten: Anbieterangaben haben ein Datum. Maßgeblich ist stets die aktuelle Fassung.
Fazit
Fortschritt entsteht aus Rückkopplung!
Gespräche und Bewertungen zeigen, was Menschen brauchen und was als gute Antwort gilt. Tests, Beweisprüfer und Simulationen sagen eindeutig, was funktioniert. Beide Arten von Signalen machen Modelle besser und nach und nach auch Roboter, deren Fähigkeiten auf denselben Modellen aufbauen. Wie weit rekursive Selbstverbesserung trägt, bleibt offen. Transparenz und Wahlmöglichkeiten bei Nutzerdaten bleiben Aufgabe der Anbieter, genaues Hinsehen die der Nutzer.
Jeder hat es ein Stück weit selbst in der Hand, wie viele der eigenen Daten an Dritte fließen. Zur Auswahl stehen sparsame Eingab persönlicher oder wertvoller Daten, aber auch die Nutzung lokaler KI. Pseudonymisierung kann für kurze Texte automatisiert oder manuell vorgenommen werden. Für längere Texte ist ein Automatismus allerdings nicht zuverlässig möglich (bzw. auch für kurze Texte nicht, wo aber der Mensch genügend Aufwand zur Nachkontrolle investieren kann).
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die