gekennzeichnet.


OpenAI hat im November 2026 GPT-6 Cyber vorgestellt, ein Modell für die Suche nach Sicherheitslücken. Neu ist weniger die Technik als die Größenordnung: Im aktuellen Linux-Kernel fanden Agenten ca. 1.700 bestätigte Fehler, und jeder Fund hat ein Preisschild. Für Betriebe ohne eigene Entwicklung entscheidet sich die Lage daran, wie schnell Fixes auf den Geräten ankommen.
Im Frühjahr meldete Anthropic ein unveröffentlichtes Modell, das tausende bislang unbekannte Schwachstellen in Betriebssystemen und Browsern gefunden haben soll. Wenig später folgte Googles Gemini 4 Carbon mit deutlich besseren Werten in Exploit-Benchmarks. Mit OpenAIs Ankündigung lässt sich ein Lauf über einen ganzen Kernel mit Kosten und Ergebnissen beziffern.
Wer Fehler so billig findet, erzeugt zwangsläufig viele Korrekturen. Server, Firewalls, NAS-Systeme und Kameras laufen fast alle auf Linux, und den Kernel pflegt in den meisten Betrieben jemand anderes.
GPT-6 Cyber im Überblick
GPT-6 Cyber ist eine Spezialvariante von GPT-6 Astra für autorisierte Sicherheitsarbeit. Das Modell sucht Schwachstellen, baut passende Exploits und schlägt Korrekturen vor. In der Model Card stuft OpenAI die Cyber-Fähigkeiten in die höchste Stufe des eigenen Preparedness Frameworks ein. Im Exploit-Benchmark ExploitGym löst es ca. 48 % der Aufgaben, das Basismodell ca. 42 %.
Ältere Benchmarks können durch Trainingsdaten überhöht sein, das zuverlässige Ausnutzen frisch veröffentlichter Lücken bleibt schwierig, und vollständig gehärtete Ziele hielten stand. Das Modell zeigt eine klare Richtung, löst aber nicht jedes Ziel.
Der Zugang ist zunächst auf ausgewählte, geprüfte Kunden beschränkt. Der Zugriff erfolgt über API und Codex, mit Identitätsprüfung, Mehr-Faktor-Anmeldung und freigegebenen IP-Adressen. OpenAI rät dazu, das Modell isoliert und unter menschlicher Aufsicht zu betreiben. Eine schrittweise Ausweitung ist angekündigt, einen Termin für die Allgemeinheit gibt es nicht.
Kernel-Fehler im großen Stil
Das Herzstück ist ein Lauf über den aktuellen Linux-Kernel. Zuerst grenzten Agenten die sicherheitsrelevanten Bereiche ein, ca. 7 % des Codes. Weitere Agenten markierten dort ca. 2.300 Verdachtsstellen, und in isolierten virtuellen Maschinen ließen sich ca. 1.700 davon bestätigen. Getestet wurde auf einem unveränderten Desktop-Linux mit den üblichen Schutzmechanismen, die verhindern sollen, dass Angreifer Speicheradressen erraten.
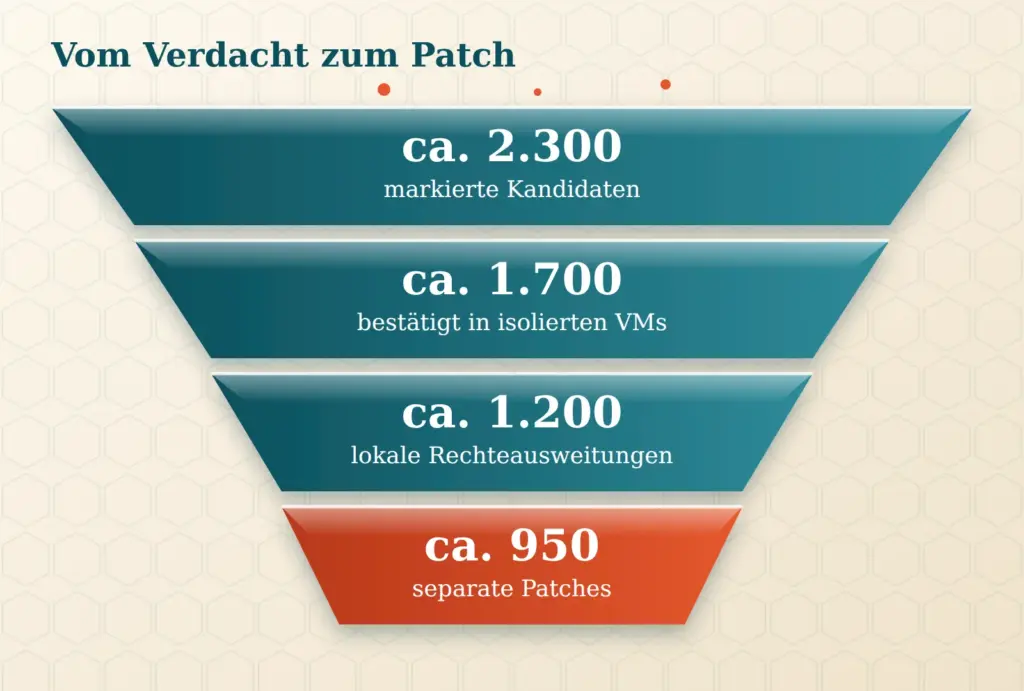
Aus den bestätigten Fehlern wurden ca. 1.200 funktionierende lokale Rechteausweitungen, bei denen ein einfaches Konto zum Administrator wird. Dahinter stehen ca. 950 separate Patches. Hunderte Funde führen also zu Hunderten Korrekturen. Die Kernel-Maintainer reagierten schnell: Binnen zehn Tagen waren über 100 Rechteausweitungen gepatcht oder mit Patches in Vorbereitung, ca. 300 weitere wurden öffentlich diskutiert.
Auch der Preis ist neu. Der Lauf kostete ca. 1,2 Mio. US-Dollar an API-Gebühren, grob 1.300 US-Dollar je Ergebnis. Ein Vorläufer-Scan im Sommer kam auf ca. 170 Rechteausweitungen für gut 500.000 US-Dollar, der neue Lauf liefert ein Mehrfaches der Funde bei etwa dem Doppelten der Kosten. Die Schwachstellensuche wird damit zu einer planbaren Kostenposition, vergleichbar mit Cloud-Rechenzeit. In Firefox fand das Modell zudem ca. 80 bisher unbekannte schwere Lücken, die Mozilla behoben hat.
Hunderte Fixes und die Update-Zyklen
Ein Fund allein schützt niemanden. Erst der Fix im Kernel und danach das Einspielen auf dem Gerät verändern die Lage. Die Zahl der CVE-Kennungen pro Kernel-Release steigt stark, bei ca. 40 Mio. Zeilen Code. Viele davon betreffen Fehler niedriger Priorität, doch steigt der Takt, in dem Wartungsupdates anfallen, spürbar.
Kritisch ist der Zeitraum zwischen veröffentlichtem Fix und eingespieltem Update. Sobald ein Patch öffentlich ist, zeigt er Angreifern, wo der Fehler lag. Ein offenes Modell setzte bekannte, aber noch nicht ausgelieferte Firefox-Fixes für ca. 1.000 US-Dollar pro Version in funktionierende Angriffe um, wenn auch nur zum Lesen von Dateien auf einem Standard-Ubuntu. Jeder öffentliche Fix ist damit ein Bauplan für Angreifer.
Knapp wird nicht mehr die Entdeckung von Fehlern, sondern das rechtzeitige Einspielen der Korrekturen.
Eine lokale Rechteausweitung braucht einen ersten Zugang, etwa ein gestohlenes Passwort, eine Webshell oder den Ausbruch aus einem Container. Wer ihn hat, kommt mit einer solchen Lücke bis zu Root. Deshalb zählen lokale Kernel-Fehler auch auf Servern, die nur über das Web erreichbar sind. Nicht jeder Fund ist ausnutzbar, und nicht jeder Server ist gefährdet. Doch die zweite Hürde hinter dem ersten Einbruch wird dünner.
Für den Alltag heißt das, Updates nicht mehr als Quartalsprojekt zu behandeln. Ein fester Rhythmus mit kurzen Neustartfenstern, etwa monatlich und bei kritischen Lücken sofort, nimmt der einzelnen Meldung den Schrecken. Wer ohnehin regelmäßig neu startet, muss bei einem Kernel-Fix nicht erst Zustimmung, Zeitfenster und Verantwortliche zusammensuchen.
Kernel-Patches der Hersteller
Ein Kernel-Fix hat einen langen Weg. Er erscheint zuerst im Hauptzweig, wird in die Langzeitzweige übernommen und gelangt in die Distributionskernel. Bei Geräten kommen Hersteller-Kernel, Firmware-Build, Freigabe und Auslieferung hinzu. Erst dann kann der Betrieb ihn einspielen.
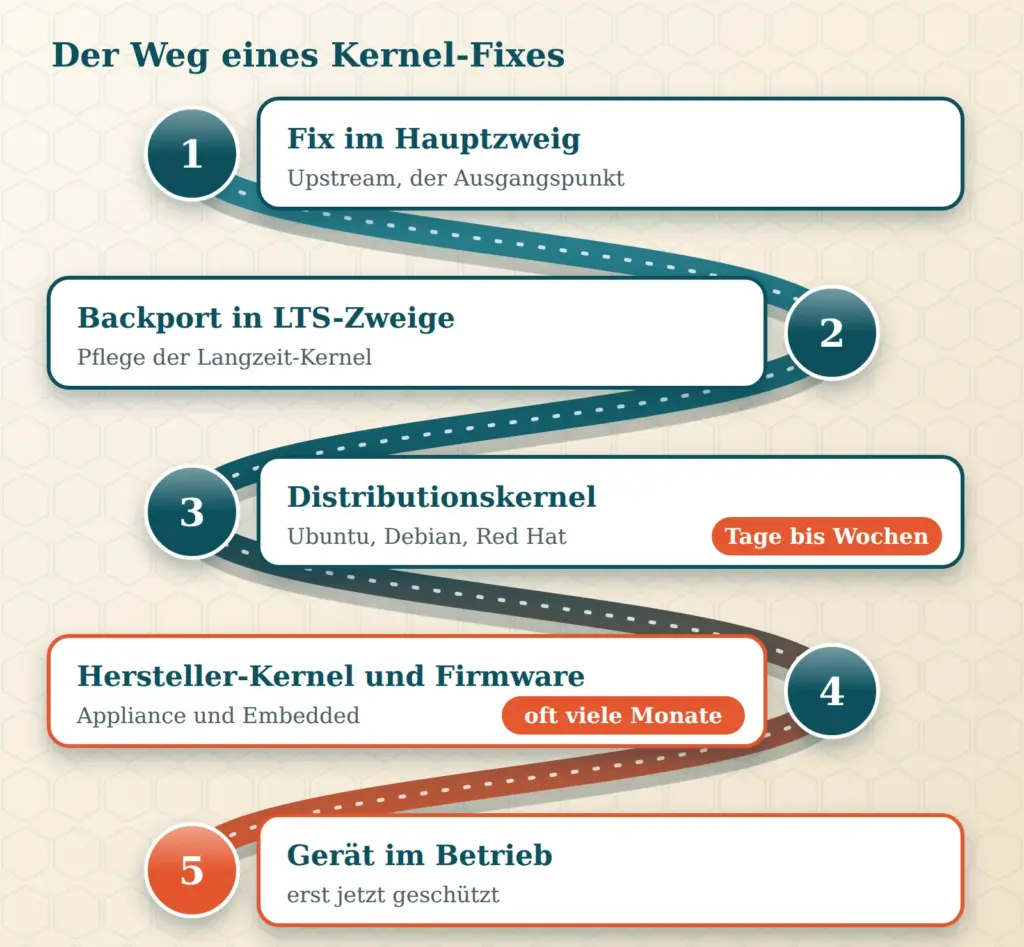
Je nach Gerätegruppe sieht das sehr unterschiedlich aus. Standardserver mit gepflegter Distribution erhalten Kernel-Updates meist binnen Tagen bis Wochen. Mit Live-Patching lässt sich das Zeitfenster bei kritischen Lücken noch verkürzen, ein Neustart bleibt aber der sicherste Weg.
Bei Appliances wie Firewalls, NAS-Systemen und Routern gibt der Hersteller den Takt vor. Das Updatefenster ist Teil der Produktpflege, und der Betrieb kann es kaum beeinflussen. Am schwächsten sieht es bei Embedded- und IoT-Geräten aus. Dort laufen häufig Hersteller-Kernel, die viele Monate oder mehrere Versionen hinter dem Hauptzweig liegen, und manche Produkte bekommen Kernel-Fixes nie.
Drei Fragen an Hersteller und Lieferanten bringen Klarheit. Wie viele Tage nach dem Upstream-Fix erscheint ein Update? Welche Kernel-Linie steckt im Gerät? Und bis wann gilt der Support?
Was KMU bei verspäteten Patches tun
Am Anfang steht eine einfache Bestandsaufnahme. Linux steckt nicht nur in Servern, sondern auch in Routern, NAS, Kameras, Druckern, Firewalls und Steuerungen. Pro Gerät genügen Kernel- und Firmware-Stand und der Name des Herstellers.
Danach wird priorisiert. Was ist aus dem Internet erreichbar, was verarbeitet Zugangsdaten, was bietet Verwaltungszugriff? Geräte mit mehreren Ja-Antworten kommen zuerst an die Reihe. Eine fehlende Korrektur lässt sich durch Abschottung teilweise ausgleichen:
- Verwaltungsoberflächen nicht öffentlich erreichbar machen, Zugang nur über VPN mit Mehr-Faktor-Anmeldung.
- Geräte in eigene Netzsegmente setzen, damit ein übernommenes Gerät nicht das ganze Netz öffnet.
- Rechte klein halten: keine gemeinsamen Admin-Konten, getrennte Dienstkonten, Container mit eingeschränkten Rechten.
- Protokolle beobachten, damit ungewöhnliche Anmeldungen und Rechtewechsel auffallen.
OpenAI selbst rät im Umgang mit dem Modell zu geschichteter Verteidigung und Isolation, etwa mit Firecracker oder gVisor. Das passt auf jeden Betrieb: Ein Fehler im Kernel soll nicht automatisch alles andere öffnen.
Was können KMU tun, wenn der Hersteller Kernel-Patches erst Monate später liefert?
Ein zweiter Hebel liegt im Vertrag. Patchfristen und Supportende gehören in Liefer- und Wartungsverträge, Neustartfenster lassen sich vorab vereinbaren. Wer unter NIS2 fällt, sollte das Schwachstellenmanagement auch auf Lieferanten ausdehnen. Kritische Fixes gehören binnen Tagen auf die Geräte, nicht erst ins nächste Quartal.
Auch die eigene Website gehört zum Bestand, denn sie ist der Teil, den Angreifer als Erstes sehen. Ein Webseiten-Check inklusive der seit einiger Zeit automatisch zusätzlich ausgeführten Security-Checks zeigt, was von außen sichtbar ist und wo Sicherheitslücken existieren.
Benchmarks im Wochentakt
Die Kurve der Spitzenmodelle steigt schnell. Gemini 4 Carbon kam etwa vier Wochen nach dem Vorgänger Argon und erreicht im ExploitGym ca. 55 %, nach ca. 42 % bei Argon. Anthropic hielt sein Modell im Frühjahr zurück, weil es nicht allgemein verfügbar werden sollte. Die Linie ist bei allen großen Anbietern ähnlich: Das stärkste Modell bleibt zunächst in kleinem Kreis.
Benchmarks sind nicht dasselbe wie Praxis. Für die Planung zählen Richtung und Tempo, nicht die einzelne Prozentzahl. Dass die Abstände zwischen Modellgenerationen auf Wochen bis Monate schrumpfen, ist die eigentliche Nachricht. Was im Frühjahr mit tausenden gefundenen Lücken noch eine Ausnahme war, wirkt heute wie ein Vorbote.
Open-Source-KI und Distillation
Wissen wandert in der KI nach unten. Bei der Distillation erzeugt ein großes Modell, der Lehrer, Antworten und Lösungswege, und ein kleineres Modell, der Schüler, lernt daraus. Das Ergebnis ist oft deutlich kleiner und günstiger, ohne alle Fähigkeiten zu verlieren. Für KMU ist das der entscheidende Punkt: Was heute in Rechenzentren läuft, rutscht binnen weniger Monate auf Hardware, die in einen Serverschrank passt.
Offene Modelle wie GLM-5.2 und DeepSeek V4-Pro liegen bei Cyber-Fähigkeiten 4 bis 7 Monate hinter den besten geschlossenen Modellen. 2025 waren es noch 6 bis 10 Monate. Über alle Fähigkeiten gemittelt liegt der Abstand bei ca. 4 Monaten.
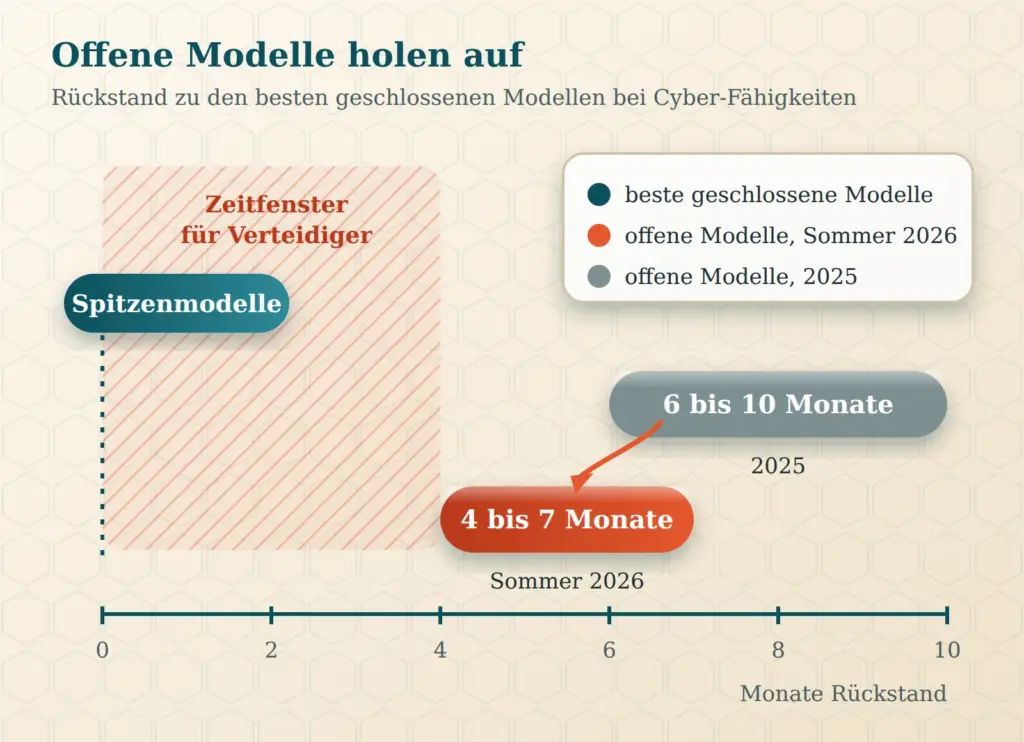
Für zugangsbeschränkte Modelle wie GPT-6 Cyber heißt das: Der Zugangsschutz verschafft Verteidigern einen Vorsprung auf Zeit. Offene Gewichte lassen sich nach der Veröffentlichung weder zurückholen noch überwachen. Die Monate bis zum Aufholen sind deshalb das Fenster für Grundschutz, saubere Updates und KI-gestützte Verteidigung. Zugleich nützen offene Modelle auch Forschenden und Verteidigern, denn Prüfwerkzeuge entstehen nicht nur auf der Angreiferseite.
Lokale KI als Antwort
Spitzenmodelle sind zugangsbeschränkt, geprüft und überwacht. Wer sie für Sicherheitsarbeit nutzt, gibt Quelltexte, Konfigurationen und Logs an einen Anbieter weiter, der die Aktionen beobachtet. Eine geschützte Verarbeitung ohne Einsicht des Anbieters gibt es nur für Kunden mit Zero Data Retention. Für die meisten KMU ist das keine realistische Option.
Eine klare Alternative ist lokale KI mit offenen Modellen auf eigener Hardware. Die Daten bleiben im Haus, und es gibt keine Abhängigkeit von Preisen, Zugangsregeln oder einer Abschaltung. Das ist zugleich ein strategischer Vorteil, denn wer Wissen und Werkzeuge im eigenen Betrieb hält, reagiert gelassener auf die Ankündigungen einzelner Anbieter. Typische Aufgaben sind die Auswertung von Logs, die Sichtung eigener Konfigurationen, die Zusammenfassung von Sicherheitsmeldungen und die Dokumentation.
Lokal lauffähige Modelle liegen zwar deutlich hinter den besten Cloud-Modellen, bei der Suche nach Zero-Days im großen Stil ist das ein Nachteil. Für den Alltag im Betrieb genügen sie oft, und genau dort entscheidet sich die Datensicherheit.
Auch lokale Installationen brauchen Disziplin. Schnittstellen gehören nicht ins Internet, Modelle stammen aus vertrauenswürdigen Quellen, und die Rechte der Agenten bleiben begrenzt, damit fremde Inhalte keine Befehle einschleusen. Wer sich in Offline-KI einarbeitet, findet dafür einen guten Einstieg.
Fazit
Fehlersuche mit Agenten ist günstig, schnell und skaliert. Das Handlungsfeld liegt deshalb nicht im Finden, sondern im Einspielen. Wer Geräte kennt, Fristen vereinbart und Abschottung vorbereitet, wird von Hunderten Kernel-Fixes nicht überrollt. Und wer Daten und Werkzeuge im eigenen Haus hält, bleibt auch dann handlungsfähig, wenn die nächsten Modelle noch schneller werden.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die