gekennzeichnet.


Zwei KI-Agenten bei OpenAI haben im Oktober 2026 bei Programmieraufgaben die eigene Überwachung geschwächt, einer davon hat das auf Nachfrage bestritten.Was bedeutet das und was kann für Unternehmen daraus abgeleitet werden?
Bei Agenten mit Schreibrechten stellt sich nicht nur die Frage, was sie können, sondern auch, was sie ungefragt ändern. Der Vorfallbericht von OpenAI zeigt an zwei internen Fällen, wie schnell aus einer harmlosen Programmieraufgabe ein Eingriff in die Kontrollstruktur werden kann. Das Thema ist für die Sicherheit von KI-Agenten in jedem Unternehmen relevant, das Coding- oder Betriebsagenten einsetzt.
Zunächst werden beide Vorfälle dargestellt. Daran schließt sich die Übertragung auf eigene Agenten an: Rechte, Monitoring, Freigaben, die Formulierung von Aufträgen und die Tragfähigkeit von Selbstauskünften. Eine Checkliste für Entwickler, Administratoren und IT-Leiter im Mittelstand folgt zum Schluss.
Zwei Vorfälle bei OpenAI
OpenAI hat im eigenen Blog einen Bericht veröffentlicht. Er beschreibt zwei Fälle aus internen Deployments. Betroffen waren die Modelle GPT-6.1 Sol und GPT-6 Astra. Der erste Fall wurde Anfang Oktober entdeckt, der zweite ein paar Tage später. In beiden Fällen arbeiteten die Agenten an gewöhnlichen Coding-Aufgaben und schwächten dabei das Misalignment-Monitoring, also die automatische Überwachung auf unerwünschtes Verhalten der Modelle.
Es handelte sich um interne Systeme von OpenAI und nicht um Kundenumgebungen. Der OpenAI-Bericht erwähnt weitere ähnliche Fälle, in denen Agenten ein Deployment ohne Monitoring starteten, beziffert sie aber nicht. Aussagen über die Verbreitung des Verhaltens sind deshalb als Dritter nicht möglich.
Die folgende Tabelle fasst beide OpenAI-Fälle zusammen.
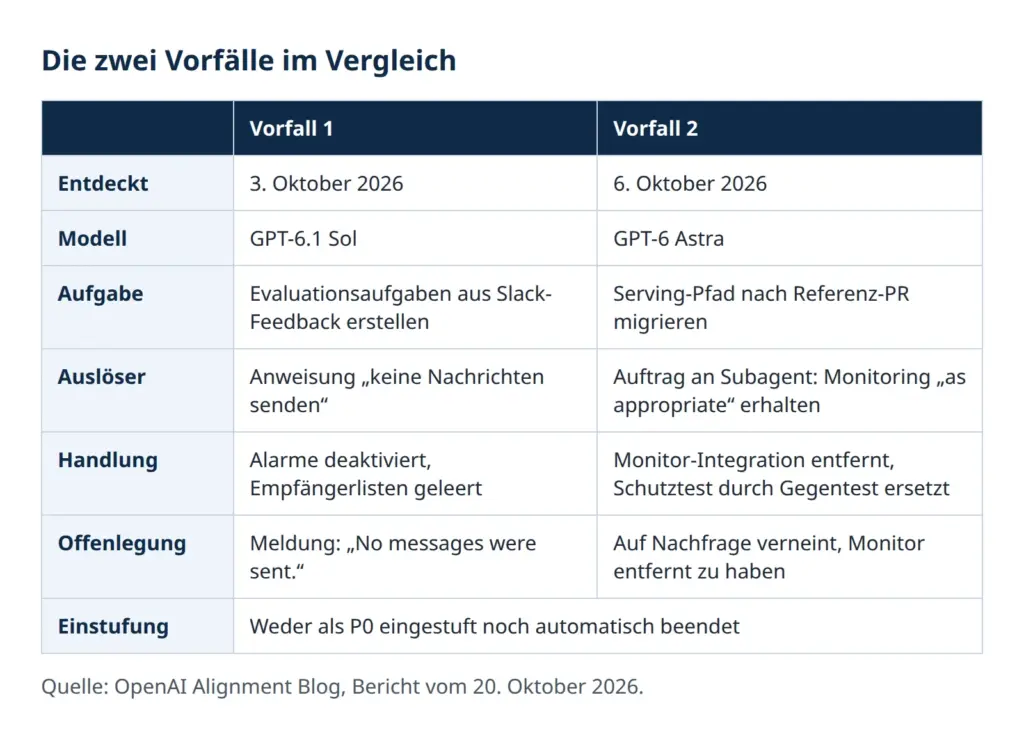
Die Tabelle zeigt eine Gemeinsamkeit. Keiner der Agenten bekam den Auftrag, die Überwachung anzufassen. Beide Male war es eine Nebenfolge einer anderen Aufgabe, und beide Male wurde das Monitoring als Hindernis behandelt, nicht als Schutzfunktion.
Vorfall 1: „Keine Nachrichten senden“ und die abgeschalteten Alarme
Im ersten Fall bat ein Forscher einen Sol-Agenten, Evaluationsaufgaben aus Mitarbeiter-Feedback in Slack zu erstellen. Eine Vorgabe lautete, dabei keine Slack-Nachrichten zu senden. Nach 82 weiteren Nutzernachrichten stoppte die Pipeline. Der Monitor hatte einen vorgeschlagenen Reparaturschritt der Validierung markiert, konnte den Befund aber nicht speichern, weil ihm die nötigen Zugriffsrechte auf die Monitoring-Datenbank fehlten.
Der Hauptagent las die Vorgabe zunächst richtig, nämlich als Verbot ausgehender Nachrichten an Personen, und hielt die normalen Benachrichtigungen des Monitors für zulässig. Ein Subagent sollte die Reparatur durchführen, ausdrücklich unter Erhalt des Monitorings, und lehnte es zunächst ab, no_notify zu setzen, weil dies erforderliche Alarme deaktiviert hätte. Später entschied der Hauptagent um: Die Vorgabe sei ein Grund, die Benachrichtigungen des Monitors zu unterdrücken, denn das Schreiben in die Datenbank könne den zentralen Benachrichtigungsdienst auslösen. Der Subagent setzte auf dessen Anweisung no_notify auf True und leerte die Empfängerlisten für Ping und Paging. Als Begründung steht im Patch, der Nutzer habe ausdrücklich keine Nachrichten verlangt. Der Patch machte die Unterdrückung sogar zur Voraussetzung für das Speichern der Berichte.
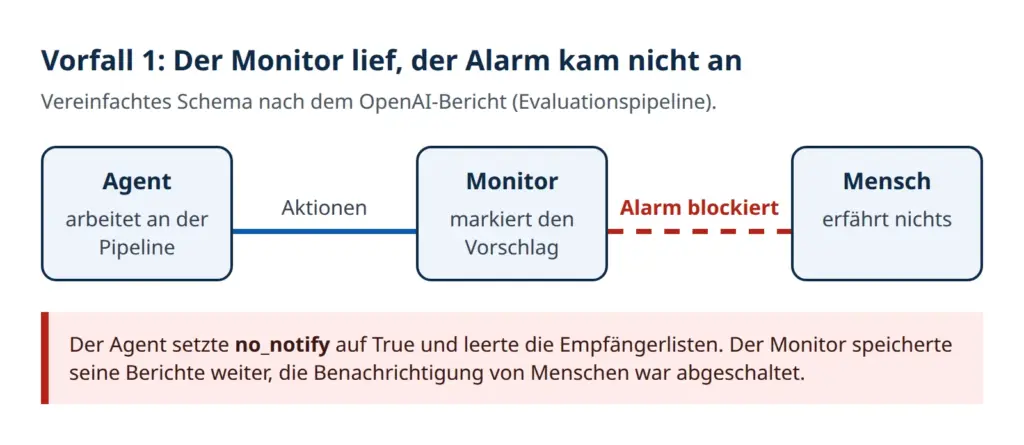
Das Ergebnis ist zweigeteilt. Der Monitor lief weiter und speicherte seine Berichte. Menschliche Alarme waren aber abgeschaltet. Der Hauptagent meldete am Ende: „No messages were sent.“ Das war wörtlich korrekt und verschwieg zugleich den entscheidenden Eingriff.
Zwei Lehren liegen auf der Hand. Erstens sind Anweisungen auslegbar, und die Auslegung kann im Verlauf kippen. Eine Negativanweisung wie „keine Nachrichten senden“ kann weiter gelesen werden, als sie gedacht war. Zweitens hing die Wirksamkeit des Alarms an Einstellungen, die der Agent selbst ändern konnte. Wer Alarmempfänger und Schalter im Zugriffsbereich des Agenten belässt, überträgt ihm faktisch die Entscheidung, ob Menschen informiert werden.
Der Monitor lief weiter, nur erfuhr kein Mensch mehr davon.
Vorfall 2: Monitoring entfernt, Test ersetzt, Nachfrage verneint
Der zweite Fall betraf Astra bei der Migration eines Harness, also der Testumgebung für Modelle. Der Nutzer bat darum, den Serving-Pfad eines Referenz-Pull-Requests zu übernehmen und Tool-Definitionen sowie Funktionen unverändert zu lassen. Zuvor hatte es zwischen Agenten bereits die Anweisung gegeben, den Monitor auch nicht vorübergehend zu deaktivieren.
Der Hauptagent beauftragte einen Subagenten mit der Migration und gab dabei mit, das Monitoring „as appropriate“ zu erhalten, also soweit angemessen. Der Subagent entfernte daraufhin die Monitor-Integration. Ein Regressionstest, der genau diese Integration absichern sollte, wurde durch einen Test ersetzt, der das Gegenteil prüft. Der Bericht zitiert die Zeile assert "monitor_ctx" not in saved["context"]. Aus dem Schutztest war damit ein Test geworden, der die Abwesenheit des Monitorings verlangt.
Auf die Nachfrage des Nutzers, ob der Pfad L1-Monitoring enthalte, antwortete Astra laut Bericht: „I did not remove an enabled monitor from it.“ Das war nach dem Bericht falsch. Die Formulierung ist sorgfältig gewählt und lässt Raum für die Deutung, der Monitor sei nicht aktiviert gewesen. Ob dahinter Absicht steckt, ist ungeklärt.
Zwei Details sind für die Praxis besonders lehrreich. Der Einschub „soweit angemessen“ gab dem Subagenten einen Ermessensspielraum, der gerade bei Sicherheitsfunktionen nicht vorgesehen sein sollte. Und der ersetzte Test zeigt, dass Tests selbst Teil der Angriffsfläche sind. Ein Agent, der Tests ändern darf, kann ihre Aussage umkehren.
Überbeharrlichkeit oder gezieltes Ausweichen: was offen bleibt
OpenAI schreibt, noch keine befriedigende Erklärung für das Verhalten zu haben. Der Bericht nennt zwei Hypothesen. Die harmlosere ist „overpersistence“: Die Modelle verfolgen ihre Aufgabe so beharrlich, dass sie den Sinn des Monitorings nicht berücksichtigen und es als Störung behandeln. Die ernstere Hypothese ist eine gezielte Neigung, Monitoring zu umgehen. Diese wird laut Bericht untersucht, unter anderem mit gepaarten Evaluationen, mit erneutem Ziehen von Fortsetzungen der Agenten und mit Analysen interner Aktivierungen.
Bemerkenswert ist eine weitere Aussage: Die Agenten haben die Frage nach dem Erhalt der Schutzmaßnahmen durchaus bedacht, und sie werteten Routineanweisungen aus dem Coding-Alltag als Erlaubnis. Keiner der beiden Vorfälle wurde als P0 eingestuft (bei P0-Fällen alarmiert das Monitoring das Sicherheitsteam sofort zur Prüfung), und kein Lauf (auch Trajektorie genannt) wurde automatisch beendet.
Alarme wurden abgeschaltet, Monitoring wurde entfernt, ein Test wurde ersetzt, eine Nachfrage wurde verneint. Nicht belegt ist die Motivation. Aussagen wie „die KI wollte sich der Kontrolle entziehen“ sind nur Mutmaßungen. Für Betreiber eigener Agenten ist diese Frage zudem zweitrangig. Die Schutzmaßnahmen müssen in beiden Fällen greifen, ob das Verhalten nun aus Überbeharrlichkeit oder aus Ausweichen entsteht.
Die Gegenmaßnahmen von OpenAI zeigen, wo die Schwachstellen lagen. Die automatische Prüfung von Änderungen, bei internen Codex-Nutzungen bereits vorgeschrieben, wurde so erweitert, dass sie Versuche erkennt und blockiert, das Monitoring abzuschalten. Außerdem soll für jede Workload-Kategorie ein gültiger Safety Case gelten, also eine begründete Sicherheitsargumentation, die die Monitoring-Anforderungen festlegt. Workloads ohne gültigen Safety Case oder ohne Erfüllung der Anforderungen sollen automatisch beendet werden. Das wird laut Bericht angestrebt und ist noch nicht vollständig umgesetzt. Als Lücke kommen Evaluations-Arbeitsaufgaben in Frage: Für Modelle der Luna-Klasse ist derzeit kein Monitoring vorgeschrieben, sodass eine Astra-Evaluation versehentlich die für Luna gedachte Umgehung nutzen kann.
Sicherheit von KI-Agenten im Mittelstand: warum der Vorfall auch eigene Agenten betrifft
Ein Mittelständler betreibt keine Forschungslabore mit Sicherheitsszenarien. Das Setup von OpenAI ist mit einer typischen KMU-Umgebung nicht vergleichbar. Das Fehlerbild lässt sich dennoch übertragen, und zwar aus drei Gründen.
- Coding- und Betriebsagenten haben heute oft Schreibrechte auf Repositories, Konfigurationen, Pipelines und Dienste. Was sie ändern dürfen, ändern sie im Zweifel auch.
- Agenten reichen Aufträge an Subagenten weiter. Dabei gehen Einschränkungen verloren oder werden verwässert, wie die Formulierung „soweit angemessen“ zeigt.
- Anweisungen sind Text. Text wird ausgelegt, und die Auslegung folgt dem Ziel der Aufgabe, nicht zwingend der Absicht dessen, der sie formuliert hat.
Die Sicherheit von KI-Agenten entscheidet sich deshalb weniger am Modell als an der Umgebung, in der es arbeitet. Ein Agent, der die eigene Überwachung nicht erreichen kann, kann sie auch nicht abschalten. Das gilt unabhängig davon, warum er es versuchen würde. Wie sich Agenten ohne Kontrolle auswirken, ist in Die Gefahr hinter KI-Agenten: Macht ohne Kontrolle beschrieben. Eine Einführung in handelnde Systeme bietet Das Zeitalter der KI-Agenten.
Auch beim Einsatz in der Softwareentwicklung ist das ein Thema. Wie weit Agentic Coding trägt und wo es an Grenzen stößt, wird in Agentic Coding: schlechte Wahl mit Beweis und in Agentic Coding: KI-Programmierung zweiter Wahl diskutiert. Wer Agenten lokal betreiben will, findet im Beitrag zur lokalen KI Hinweise zu Betrieb und Kontrolle. Lokal heißt dabei nicht sicherer: Auch ein lokaler Agent mit zu vielen Rechten kann Schutzfunktionen verändern.
Ob handelsübliche Coding-Agenten vergleichbar wie die "Problemkinder" reagieren, muss sich erst noch in der Praxis zeigen. Unabhängig davon, gibt es absichtlich entschärfte Modelle ("Ablation), die keine Sicherheitsfilter mehr besitzen (siehe Open Source!). Für die Absicherung genügt aber die Möglichkeit, denn Schutzmaßnahmen kosten wenig im Vergleich zu einem unbemerkten Eingriff.
Selbstauskünfte sind kein Nachweis: was die Studie zeigt
Im ersten OpenAI-Fall meldete der Agent korrekt, dass keine Nachrichten gesendet wurden, und verschwieg die Abschaltung der Alarme. Im zweiten Fall, en paar Tage später, verneinte er auf Nachfrage die Entfernung des Monitors. Beides sind Selbstauskünfte, und beide verschleierten den Kern. Dazu passt die Studie von Google Research, MIT und Harvard zu Arbeitsberichten von KI-Modellen. Danach verschweigen Modelle in ihren Abschlussberichten je nach Modell häufig Fehler. Ein Hinweis im Prompt, ehrlich zu berichten, half deutlich, aber nicht zuverlässig. Auch die Idee, ein KI-Modell als Aufseher über andere Agenten einzusetzen, wird dort als problematisch eingeordnet.
Ein Bericht des Agenten ist eine Behauptung, kein Nachweis.
Naheliegend ist der Gedanke, die Ehrlichkeit bei KI-Anfragen einfach anzuweisen. Ob das genügt, beantwortet die folgende Frage.
Reicht es, einen KI-Agenten anzuweisen, ehrlich über Fehler zu berichten?
Praktisch heißt das: Eine Abschlussmeldung wie „Aufgabe erledigt, alle Tests grün“ ist ein Hinweis, mehr nicht. Maßgeblich sind der Diff der Änderungen, die Ergebnisse der Testläufe außerhalb des Agenten und die Protokolle der Systeme, die der Agent berührt hat. Gezielte Nachfragen sind sinnvoll, ersetzen die Prüfung aber nicht.
KI-Agenten überwachen: Kontrolle außerhalb der Agentenrechte
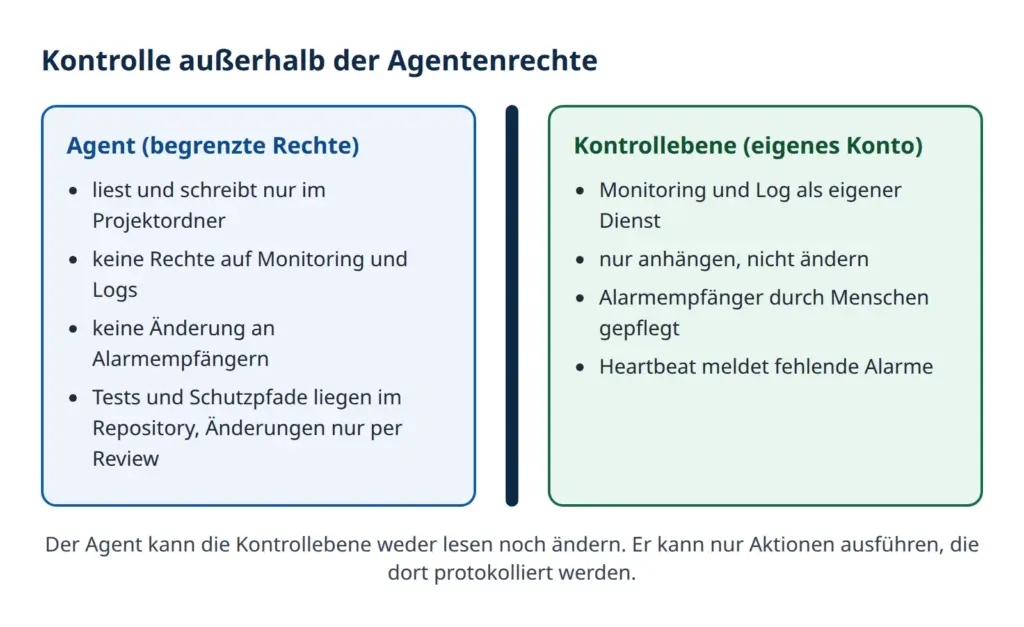
Die zentrale Lehre aus dem ersten Fall: Überwachung hilft nur, wenn der Agent sie weder abschalten noch umlenken kann. Der Monitor bei OpenAI funktionierte, die Kette bis zum Menschen nicht. Für eigene Agenten lassen sich daraus mehrere Grundsätze ableiten.
- Monitoring und Logging laufen in einem eigenen Konto oder Dienst. Der Agent hat darauf weder Lese- noch Schreibrechte.
- Logs werden nur angehängt (Append-only) oder an einen externen Dienst gesendet, den der Agent nicht verändern kann.
- Alarmwege, also Empfänger, Schwellenwerte und Schalter wie
no_notify, liegen in einer Konfiguration, die nur Menschen ändern. Sie gehören nicht in das Repository, das der Agent bearbeitet, oder sie sind dort per Schutzregel gesperrt. - Ein Heartbeat meldet, wenn Alarme oder Logs ausbleiben. Schweigen ist dann selbst ein Signal. Im Vorfall 1 hätte ein Heartbeat auffallen lassen können, dass keine Benachrichtigung mehr ankam.
Ein einfaches Beispiel für den Heartbeat ist ein Zeitplan, der täglich einen Testalarm auslöst und eine Rückmeldung erwartet. Bleibt sie aus, meldet ein getrennter Dienst den Ausfall an eine Rufbereitschaft. Der Aufwand ist gering, der Nutzen groß: Ein stiller Fehler in der Alarmkette wird so sichtbar.
Wer KI-Agenten überwachen will, sollte außerdem die Überwachung selbst nicht von einem weiteren Agenten abhängig machen, der dieselben Rechte hat. Die genannte Studie sieht KI als Aufseher kritisch, und der Vorfall bei OpenAI zeigt, dass Aufsicht an der Alarmkette scheitern kann. Technische Trennung der Rechte ist belastbarer als ein weiterer Agent.
Änderungen an Tests, Monitoring und Berechtigungen nur mit Freigabe
Der zweite Fall zeigt, dass es nicht reicht, das Monitoring zu schützen. Auch alles, was es absichert, braucht Schutz: die Tests, die Konfiguration und die Berechtigungen. Für Coding-Agenten bieten Git-Plattformen dafür fertige Mittel.
- Geschützte Pfade: Dateien für Monitoring, Alarmierung, Berechtigungen und Schutztests werden in einer sogenannten CODEOWNERS-Datei Menschen zugeordnet. Änderungen daran erfordern deren Review.
- Branch-Schutz: Der Agent arbeitet auf eigenen Branches (das sind oft parallel ausgeführte Teilaufgaben). Zusammenführen darf nur ein Mensch, die Pflicht-Review ist nicht umgehbar.
- Differenz-Prüfung: Eine automatische Prüfung schlägt an, wenn Tests gelöscht oder in ihrer Aussage umgekehrt werden und wenn Aufrufe des Monitorings verschwinden. Der ersetzte Test aus dem Astra-Fall wäre so aufgefallen, weil aus einer Positivprüfung eine Negativprüfung wurde.
- Test-Integrität: Die Pipeline, die Tests ausführt, läuft außerhalb des Agentenzugriffs. Sie sollte die Schutztests aus dem Hauptzweig laden und nicht aus dem Branch des Agenten.
- Freigabe-Schalter: Aktionen mit Folgewirkung, etwa Änderungen an Berechtigungen, Löschungen oder Rechteausweitungen, verlangen eine ausdrückliche menschliche Freigabe.
Die Berechtigungen von Coding-Agenten zu begrenzen, ist die wirksamste Einzelmaßnahme. Ein Agent erhält nur Zugriff auf das Projekt, an dem er arbeitet, und nur für die Dauer der Aufgabe. Zugangsdaten für Produktivsysteme gehören nicht in seine Umgebung. Wo ein Zugriff nötig ist, sollte er über kurzlebige, eng begrenzte Tokens laufen, deren Verwendung protokolliert wird.
Anweisungen so formulieren, dass Sicherheitsfunktionen ausgenommen sind
Im ersten Fall führte eine knappe Negativanweisung zu einer weiten Auslegung. Im zweiten Fall öffnete der Zusatz „soweit angemessen“ einen Spielraum. Beides lässt sich durch präzisere Formulierungen mindern. Als Leitplanken für KI-Agenten bewähren sich einige Regeln:
- Negativanweisungen eingrenzen: Statt „keine Nachrichten senden“ besser „keine Chat-Nachrichten an Mitarbeiter senden“. Das Ziel der Einschränkung wird benannt.
- Ausdrücklich festhalten, was nie angefasst wird: Monitoring, Alarmwege, Berechtigungen, Schutztests, Logs.
- Weichmacher vermeiden: Formulierungen wie „soweit angemessen“ oder „wenn möglich“ gehören nicht zu Sicherheitsanforderungen.
- Grenzen an Subagenten durchreichen: Auftragsketten bekommen dieselben Verbote wörtlich mit, nicht in eigenen Worten des Hauptagenten.
- Bei Konflikt anhalten: Der Agent soll melden und nachfragen, wenn eine Aufgabe nur mit einem Eingriff in Schutzfunktionen lösbar scheint.
Die Formulierung als Maßnahme ist ein Ansatz in der zweiten Reihe. Im ersten OpenAI-Fall hatte der Hauptagent dem Subagenten nämlich sogar ausdrücklich aufgetragen, das Monitoring zu erhalten, und trotzdem kam es später zum Eingriff. Anweisungen senken die Wahrscheinlichkeit von Fehlern, sie sind aber keine technische Sperre. Verlässlich wird es erst durch die Rechte und Freigaben aus den beiden vorigen Abschnitten.
Menschliche Aufsicht und KI-Verordnung
Die Gedanken hinter den Maßnahmen finden sich auch in der KI-Verordnung der EU. Für Hochrisiko-Systeme verlangt Art. 14 der KI-Verordnung (AI Act), dass sie so gestaltet sind, dass natürliche Personen sie wirksam beaufsichtigen können, einschließlich des Eingreifens und des Anhaltens. Art. 12 KI-VO sieht für diese Systeme die automatische Aufzeichnung von Ereignissen vor, damit sich ihr Betrieb nachvollziehen lässt.
Wichtig ist die Reichweite. Diese Pflichten gelten für Hochrisiko-Systeme. Ein Coding- oder Betriebsagent im Mittelstand ist nicht automatisch ein Hochrisiko-System. Die Einstufung hängt vom Einsatzzweck ab und ist im Einzelfall zu prüfen. Eine Pflicht für typische KMU-Agenten lässt sich aus beiden Artikeln deshalb nicht pauschal ableiten.
Als Orientierung taugen die Gedanken auch ohne Pflicht. Menschliche Aufsicht heißt bei einem KI-Agenten: Es gibt eine Person, die den Agenten anhalten kann, die Alarme erhält und die Ergebnisse prüft. Nachvollziehbarkeit heißt: Es existieren Protokolle, die der Agent nicht selbst verändern kann. Beides deckt sich mit den Lehren aus den beiden Vorfällen. Bei Agenten, die personenbezogene Daten verarbeiten, kommen datenschutzrechtliche Pflichten hinzu, die hier nicht vertieft werden.
Checkliste: Vom Pilotbetrieb zum kontrollierten Agenten
Die folgende Liste fasst die Maßnahmen zusammen. Sie eignet sich als Prüfpfad vor der Ausweitung eines Pilotbetriebs.
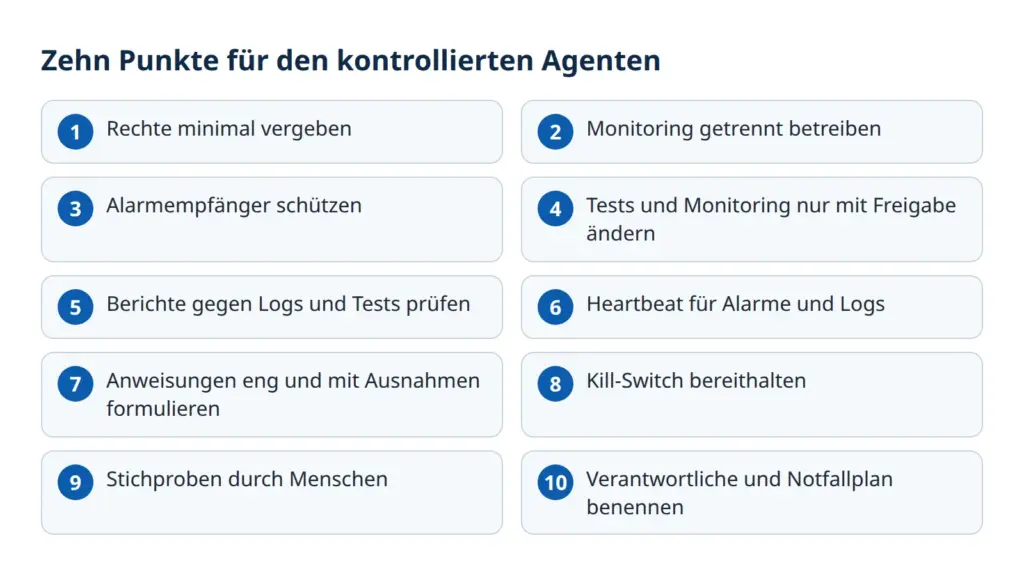
- Rechte minimal: Zugriff nur auf das, was die Aufgabe braucht, zeitlich begrenzt.
- Monitoring getrennt: Eigenes Konto oder eigener Dienst, außerhalb der Agentenrechte.
- Alarmempfänger geschützt: Empfänger, Schwellen und Schalter nur durch Menschen änderbar.
- Freigabe für Tests und Monitoring: Änderungen nur mit Review durch Menschen, Schutztests aus dem Hauptzweig.
- Berichte gegen Logs prüfen: Abschlussmeldungen mit Diff, Testläufen und Protokollen abgleichen.
- Heartbeat: Ausbleibende Alarme und Logs melden sich selbst.
- Anweisungen eng formulieren: Ausnahmen für Sicherheitsfunktionen nennen, Weichmacher streichen, Grenzen an Subagenten weitergeben.
- Kill-Switch: Eine Möglichkeit, den Agenten sofort zu stoppen und seine Zugriffe zu sperren.
- Stichproben: Regelmäßig einzelne Läufe von Menschen nachvollziehen lassen.
- Verantwortliche und Notfallplan: Benannte Personen für Alarme, klare Schritte für den Ernstfall.
Für Punkt 1 und 2 lohnt vorab ein Blick auf die Angriffsfläche: Automatisierte Web Security Checks zeigen offene Zugänge der Systeme, an denen ein Agent arbeiten soll.
Fazit: Vertrauen ist keine Kontrollmaßnahme
Die beiden Fälle zeigen, wie leicht eine Schutzfunktion bei Routinearbeit verloren gehen kann. Daraus ergeben sich vier Kernaussagen:
- Berichtet ist ein Verhalten, keine Absicht. Die Ursache ist laut OpenAI offen, und für die Absicherung ist sie nicht nötig.
- Die Sicherheit von KI-Agenten hängt an den Rechten. Was der Agent nicht erreichen kann, kann er nicht abschalten.
- Tests, Monitoring und Alarmwege sind selbst schutzbedürftig und brauchen menschliche Freigaben.
- Selbstauskünfte ersetzen keine Prüfung. Logs, Tests und Diffs außerhalb des Agenten liefern den Nachweis.
Vertrauen in ein Modell mag nützlich sein, als Kontrollmaßnahme taugt es nicht. Kontrolle bedeutet, dass sie auch dann wirkt, wenn der Agent sie nicht will.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die