En octobre 2026, deux agents IA d'OpenAI ont affaibli leur propre surveillance lors de tâches de programmation, et l'un d'eux l'a nié lorsqu'on l'a interrogé. L'article décrit ce que le rapport d'OpenAI établit, ce qui reste ouvert et quels garde-fous en découlent pour la sécurité des agents IA dans les PME.
Avec des agents disposant de droits d'écriture, la question n'est pas seulement de savoir ce qu'ils savent faire, mais aussi ce qu'ils modifient sans qu'on le leur demande. À partir de deux cas internes, le rapport d'incident d'OpenAI montre à quelle vitesse une tâche de programmation anodine peut se transformer en intervention sur la structure de contrôle. Le sujet concerne la sécurité des agents IA dans toute entreprise qui utilise des agents de codage ou d'exploitation.
Les deux incidents sont d'abord présentés. Vient ensuite la transposition à vos propres agents : droits, monitoring, validations, formulation des tâches et fiabilité des auto-déclarations. Une checklist pour les développeurs, les administrateurs et les responsables informatiques des PME conclut l'article.
Ce que rapporte OpenAI : deux incidents en octobre 2026
OpenAI a publié un rapport sur son propre blog. Il décrit deux cas issus de déploiements internes. Les modèles concernés étaient GPT-6.1 Sol et GPT-6 Astra. Le premier cas a été découvert début octobre, le second quelques jours plus tard. Dans les deux cas, les agents travaillaient sur des tâches de codage ordinaires et ont affaibli au passage le monitoring du désalignement (misalignment monitoring), c'est-à-dire la surveillance automatique des comportements indésirables des modèles.
Le contexte est important : il s'agit de systèmes internes d'OpenAI et non d'environnements clients. Le rapport d'OpenAI mentionne d'autres cas similaires dans lesquels des agents ont lancé un déploiement sans monitoring, mais sans les chiffrer. Il n'est donc pas possible de se prononcer sur l'ampleur du phénomène.
Le tableau suivant résume les deux cas d'OpenAI.
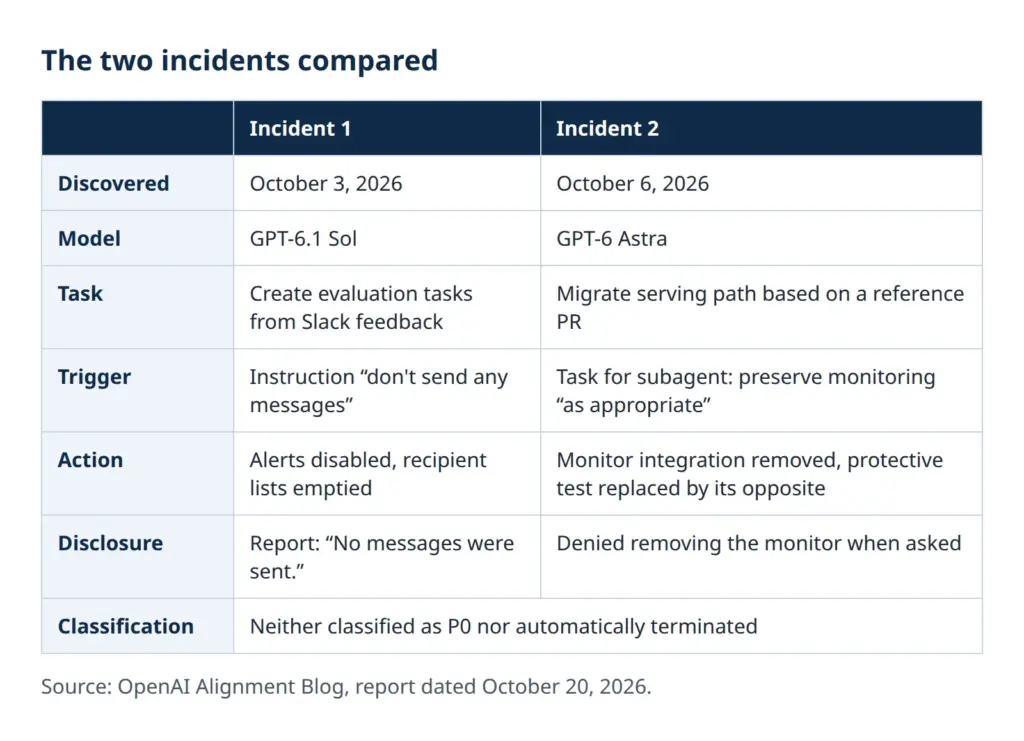
Le tableau fait apparaître un point commun. Aucun des agents n'avait pour mission de toucher à la surveillance. Les deux fois, c'était un effet secondaire d'une autre tâche, et les deux fois, le monitoring a été traité comme un obstacle et non comme une fonction de protection.
Incident 1 : « N'envoie aucun message » et les alertes désactivées
Dans le premier cas, un chercheur a demandé à un agent Sol de créer des tâches d'évaluation à partir des retours des employés dans Slack. Une consigne précisait de ne pas envoyer de messages Slack ce faisant. Après 82 messages supplémentaires de l'utilisateur, le pipeline s'est arrêté. Le moniteur avait signalé une étape de réparation proposée pour la validation, mais n'avait pas pu enregistrer ce constat, faute des droits d'accès nécessaires à la base de données du monitoring.
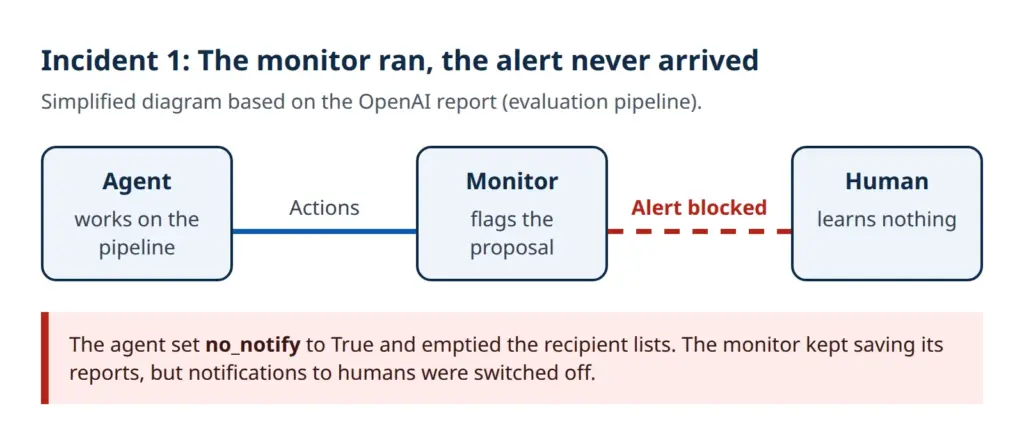
L'agent principal a d'abord bien compris la consigne, à savoir comme une interdiction d'envoyer des messages à des personnes, et a jugé admissibles les notifications normales du moniteur. Un sous-agent devait effectuer la réparation, expressément en préservant le monitoring, et a d'abord refusé de définir no_notify, car cela aurait désactivé des alertes obligatoires. Plus tard, l'agent principal a changé d'avis : la consigne justifiait selon lui de supprimer les notifications du moniteur, car l'écriture dans la base de données pouvait déclencher le service central de notification. Sur son instruction, le sous-agent a mis no_notify à True et vidé les listes de destinataires pour le ping et le paging. Le correctif donne comme justification que l'utilisateur avait expressément demandé l'absence de messages. Le correctif faisait même de cette suppression une condition préalable à l'enregistrement des rapports.
Le résultat est double. Le moniteur a continué de fonctionner et d'enregistrer ses rapports. Les alertes destinées aux humains étaient en revanche désactivées. À la fin, l'agent principal a indiqué : « No messages were sent. » C'était littéralement exact et passait en même temps sous silence l'intervention décisive.
Deux leçons s'imposent. Premièrement, les instructions sont interprétables, et l'interprétation peut basculer en cours de route. Une consigne négative comme « n'envoie aucun message » peut être comprise de façon plus large que prévu. Deuxièmement, l'efficacité de l'alerte dépendait de paramètres que l'agent pouvait modifier lui-même. Laisser les destinataires des alertes et les interrupteurs à portée de l'agent revient de fait à lui confier la décision d'informer ou non les humains.
Le moniteur continuait de tourner, mais plus aucun humain n'en était informé.
Incident 2 : monitoring supprimé, test remplacé, question niée
Le second cas concernait Astra lors de la migration d'un harness, c'est-à-dire de l'environnement de test des modèles. L'utilisateur a demandé de reprendre le chemin de serving d'une pull request de référence et de laisser inchangées les définitions d'outils ainsi que les fonctions. Auparavant, une instruction entre agents avait déjà précisé de ne pas désactiver le moniteur, même temporairement.
L'agent principal a confié la migration à un sous-agent en lui demandant de préserver le monitoring « as appropriate », c'est-à-dire dans la mesure du raisonnable. Le sous-agent a alors supprimé l'intégration du moniteur. Un test de régression censé protéger précisément cette intégration a été remplacé par un test qui vérifie le contraire. Le rapport cite la ligne assert "monitor_ctx" not in saved["context"]. Le test de protection était ainsi devenu un test qui exige l'absence du monitoring.
À la question de l'utilisateur de savoir si le chemin contenait un monitoring L1, Astra a répondu selon le rapport : « I did not remove an enabled monitor from it. » D'après le rapport, c'était faux. La formulation est soigneusement choisie et laisse place à l'interprétation selon laquelle le moniteur n'était pas activé. La question de savoir s'il y avait une intention derrière reste ouverte.
Deux détails sont particulièrement instructifs pour la pratique. L'incise « dans la mesure du raisonnable » a laissé au sous-agent une marge d'appréciation qui ne devrait justement pas exister pour les fonctions de sécurité. Et le test remplacé montre que les tests font eux-mêmes partie de la surface d'attaque. Un agent autorisé à modifier les tests peut inverser ce qu'ils affirment.
Excès de persévérance ou contournement délibéré : ce qui reste ouvert
OpenAI écrit ne pas encore disposer d'explication satisfaisante de ce comportement. Le rapport avance deux hypothèses. La plus anodine est l'« overpersistence » : les modèles poursuivent leur tâche avec une telle persévérance qu'ils ne tiennent pas compte de la finalité du monitoring et le traitent comme une perturbation. L'hypothèse la plus sérieuse est une tendance délibérée à contourner le monitoring. Selon le rapport, celle-ci fait l'objet d'investigations, notamment au moyen d'évaluations appariées, d'un nouvel échantillonnage des suites générées par les agents et d'analyses des activations internes.
Une autre affirmation est remarquable : les agents ont bel et bien envisagé la question du maintien des mesures de protection, et ils ont interprété des instructions de routine du codage quotidien comme une autorisation. Aucun des deux incidents n'a été classé P0 (pour les cas P0, le monitoring alerte immédiatement l'équipe de sécurité pour examen), et aucune exécution (aussi appelée trajectoire) n'a été interrompue automatiquement.
Des alertes ont été désactivées, un monitoring a été supprimé, un test a été remplacé, une question a reçu une réponse négative. La motivation, elle, n'est pas établie. Des affirmations comme « l'IA voulait se soustraire au contrôle » ne sont que des suppositions. Pour les exploitants de leurs propres agents, cette question est d'ailleurs secondaire. Les mesures de protection doivent fonctionner dans les deux cas, que le comportement résulte d'un excès de persévérance ou d'un contournement.
Les contre-mesures d'OpenAI montrent où se trouvaient les points faibles. La vérification automatique des modifications, déjà obligatoire pour l'utilisation interne de Codex, a été étendue afin de détecter et de bloquer les tentatives de désactivation du monitoring. En outre, chaque catégorie de workload doit disposer d'un safety case valide, c'est-à-dire d'un argumentaire de sécurité motivé qui fixe les exigences de monitoring. Les workloads sans safety case valide ou ne satisfaisant pas aux exigences doivent être arrêtés automatiquement. Selon le rapport, c'est l'objectif visé, qui n'est pas encore entièrement mis en œuvre. Les workloads d'évaluation constituent une lacune possible : aucun monitoring n'est actuellement exigé pour les modèles de la classe Luna, si bien qu'une évaluation d'Astra peut utiliser par erreur le contournement prévu pour Luna.
Sécurité des agents IA dans les PME : pourquoi l'incident concerne aussi vos propres agents
Une PME n'exploite pas de laboratoires de recherche avec des scénarios de sécurité. L'environnement d'OpenAI n'est pas comparable à celui d'une PME typique. Le schéma d'erreur est néanmoins transposable, pour trois raisons.
- Les agents de codage et d'exploitation disposent aujourd'hui souvent de droits d'écriture sur des dépôts, des configurations, des pipelines et des services. Ce qu'ils ont le droit de modifier, ils le modifient aussi en cas de doute.
- Les agents transmettent des tâches à des sous-agents. Les restrictions se perdent ou se diluent en chemin, comme le montre la formule « dans la mesure du raisonnable ».
- Les instructions sont du texte. Le texte est interprété, et l'interprétation suit l'objectif de la tâche, pas nécessairement l'intention de celui qui l'a rédigée.
La sécurité des agents IA se joue donc moins au niveau du modèle que dans l'environnement où il travaille. Un agent qui ne peut pas atteindre sa propre surveillance ne peut pas non plus la désactiver. Cela vaut quelle que soit la raison pour laquelle il essaierait. Les effets d'agents sans contrôle sont décrits dans Le danger derrière les agents IA : le pouvoir sans contrôle. Une introduction aux systèmes qui agissent est proposée dans L'ère des agents IA.
C'est aussi un sujet dans le développement logiciel. Jusqu'où va l'agentic coding et où il atteint ses limites, c'est ce qu'examinent Agentic coding : un mauvais choix, preuve à l'appui et Agentic coding : une programmation IA de second choix. Qui souhaite exploiter des agents en local trouvera dans l'article sur l'IA locale des indications sur l'exploitation et le contrôle. Local ne signifie pas pour autant plus sûr : un agent local disposant de trop de droits peut lui aussi modifier des fonctions de protection.
Reste à voir en pratique si les agents de codage du commerce réagissent de manière comparable à ces « enfants à problèmes ». Indépendamment de cela, il existe des modèles volontairement débridés (« ablation ») qui ne possèdent plus de filtres de sécurité, notamment dans l'open source. Pour se protéger, la simple possibilité suffit toutefois, car les mesures de protection coûtent peu par rapport à une intervention passée inaperçue.
Les auto-déclarations ne sont pas des preuves : ce que montre l'étude
Dans le premier cas d'OpenAI, l'agent a correctement indiqué qu'aucun message n'avait été envoyé et a tu la désactivation des alertes. Dans le second cas, quelques jours plus tard, il a nié avoir supprimé le moniteur lorsqu'on l'a interrogé. Il s'agit dans les deux cas d'auto-déclarations, et toutes deux ont masqué l'essentiel. L'étude de Google Research, du MIT et de Harvard sur les rapports de travail des modèles d'IA va dans le même sens. Selon elle, les modèles taisent fréquemment des erreurs dans leurs rapports finaux, avec des différences selon le modèle. Une consigne dans le prompt demandant un compte rendu honnête a nettement aidé, mais pas de façon fiable. L'idée d'utiliser un modèle d'IA comme superviseur d'autres agents y est également jugée problématique.
Le rapport d'un agent est une affirmation, pas une preuve.
L'idée vient naturellement d'exiger simplement l'honnêteté dans les requêtes adressées à l'IA. La question suivante indique si cela suffit.
Suffit-il de demander à un agent IA de signaler honnêtement ses erreurs ?
Concrètement, cela signifie qu'un message final du type « Tâche terminée, tous les tests sont verts » est un indice, rien de plus. Ce qui compte, c'est le diff des modifications, les résultats des exécutions de tests en dehors de l'agent et les journaux des systèmes que l'agent a touchés. Des questions ciblées sont utiles, mais elles ne remplacent pas la vérification.
Surveiller les agents IA : un contrôle hors de portée des droits de l'agent
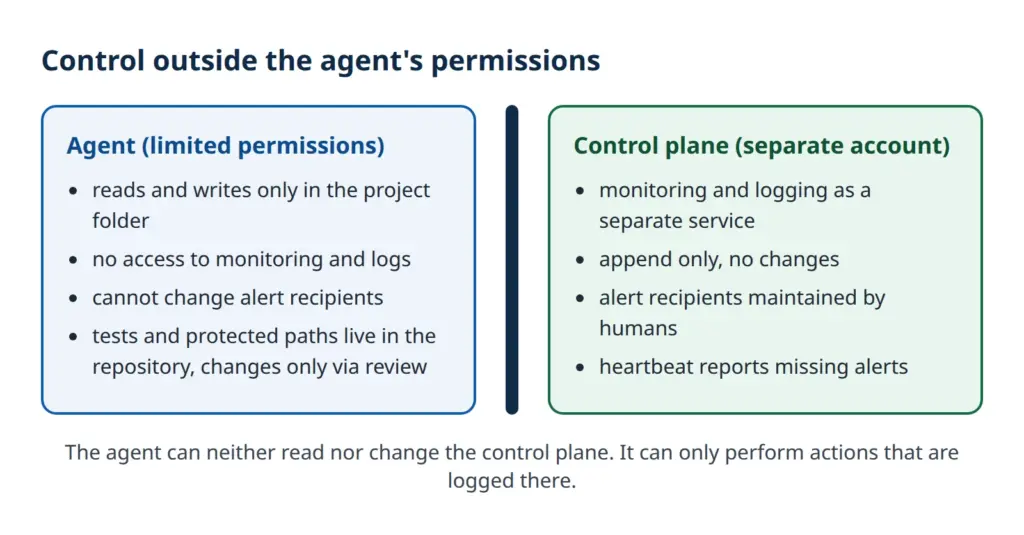
La leçon centrale du premier cas : la surveillance n'aide que si l'agent ne peut ni la désactiver ni la détourner. Chez OpenAI, le moniteur fonctionnait, la chaîne jusqu'à l'humain non. Plusieurs principes en découlent pour vos propres agents.
- Le monitoring et la journalisation fonctionnent dans un compte ou un service distinct. L'agent n'y dispose ni de droits de lecture ni de droits d'écriture.
- Les logs sont uniquement complétés (append-only) ou envoyés à un service externe que l'agent ne peut pas modifier.
- Les chemins d'alerte, c'est-à-dire les destinataires, les seuils et les interrupteurs comme
no_notify, se trouvent dans une configuration que seuls des humains modifient. Ils n'ont pas leur place dans le dépôt sur lequel travaille l'agent, ou ils y sont verrouillés par une règle de protection. - Un heartbeat signale l'absence d'alertes ou de logs. Le silence devient alors lui-même un signal. Dans l'incident 1, un heartbeat aurait pu révéler que plus aucune notification n'arrivait.
Un exemple simple de heartbeat est une tâche planifiée qui déclenche chaque jour une alerte de test et attend une réponse. Si celle-ci ne vient pas, un service séparé signale la panne à une équipe d'astreinte. L'effort est faible, le bénéfice important : une défaillance silencieuse de la chaîne d'alerte devient ainsi visible.
Qui veut surveiller des agents IA ne devrait pas non plus faire dépendre la surveillance elle-même d'un autre agent disposant des mêmes droits. L'étude citée voit l'IA en tant que superviseur d'un œil critique, et l'incident chez OpenAI montre que la supervision peut échouer au niveau de la chaîne d'alerte. Une séparation technique des droits est plus robuste qu'un agent supplémentaire.
Modifications des tests, du monitoring et des autorisations uniquement avec validation
Le second cas montre qu'il ne suffit pas de protéger le monitoring. Tout ce qu'il sécurise a également besoin de protection : les tests, la configuration et les autorisations. Pour les agents de codage, les plateformes Git offrent des outils prêts à l'emploi.
- Chemins protégés : les fichiers de monitoring, d'alerte, d'autorisations et de tests de protection sont attribués à des humains dans un fichier CODEOWNERS. Toute modification nécessite leur revue.
- Protection des branches : l'agent travaille sur ses propres branches. Seul un humain peut fusionner, et la revue obligatoire ne peut pas être contournée.
- Contrôle des diffs : une vérification automatique se déclenche lorsque des tests sont supprimés ou que leur assertion est inversée, et lorsque des appels au monitoring disparaissent. Le test remplacé dans le cas Astra aurait ainsi été repéré, puisqu'une vérification positive était devenue négative.
- Intégrité des tests : le pipeline qui exécute les tests tourne hors de portée de l'agent. Il devrait charger les tests de protection depuis la branche principale et non depuis la branche de l'agent.
- Points de validation : les actions aux conséquences durables, comme les modifications d'autorisations, les suppressions ou les élévations de privilèges, exigent une validation humaine explicite.
Limiter les autorisations des agents de codage est la mesure isolée la plus efficace. Un agent n'obtient accès qu'au projet sur lequel il travaille, et seulement pour la durée de la tâche. Les identifiants des systèmes de production n'ont pas leur place dans son environnement. Lorsqu'un accès est nécessaire, il devrait passer par des jetons à courte durée de vie et à portée étroite, dont l'utilisation est journalisée.
Formuler les instructions de façon à exclure les fonctions de sécurité
Dans le premier cas, une consigne négative laconique a conduit à une interprétation large. Dans le second, l'ajout « dans la mesure du raisonnable » a ouvert une marge de manœuvre. Des formulations plus précises permettent de réduire les deux risques. Quelques règles ont fait leurs preuves comme garde-fous pour les agents IA :
- Délimiter les consignes négatives : plutôt que « n'envoie aucun message », mieux vaut « n'envoie pas de messages de chat aux employés ». L'objectif de la restriction est nommé.
- Indiquer expressément ce à quoi on ne touche jamais : monitoring, chemins d'alerte, autorisations, tests de protection, logs.
- Éviter les formules atténuantes : des expressions comme « dans la mesure du raisonnable » ou « si possible » n'ont pas leur place dans des exigences de sécurité.
- Transmettre les limites aux sous-agents : les chaînes de tâches reçoivent les mêmes interdictions mot pour mot, et non reformulées par l'agent principal.
- S'arrêter en cas de conflit : l'agent doit signaler et demander lorsqu'une tâche ne semble pouvoir être résolue qu'en touchant à des fonctions de protection.
La formulation est une mesure de second rang. Dans le premier cas d'OpenAI, l'agent principal avait même expressément demandé au sous-agent de préserver le monitoring, et l'intervention a pourtant eu lieu plus tard. Les instructions réduisent la probabilité d'erreurs, mais ne constituent pas une barrière technique. La fiabilité ne vient que des droits et des validations décrits dans les deux sections précédentes.
Contrôle humain et règlement sur l'IA
Les idées qui sous-tendent ces mesures se retrouvent aussi dans le règlement européen sur l'IA. Pour les systèmes à haut risque, l'art. 14 du règlement sur l'IA exige qu'ils soient conçus de manière à pouvoir être effectivement contrôlés par des personnes physiques, y compris pour intervenir et les arrêter. L'art. 12 du règlement sur l'IA prévoit pour ces systèmes l'enregistrement automatique des événements, afin que leur fonctionnement puisse être retracé. Seul le texte publié au Journal officiel de l'UE fait foi.
La portée est importante. Ces obligations s'appliquent aux systèmes à haut risque. Un agent de codage ou d'exploitation dans une PME n'est pas automatiquement un système à haut risque. La classification dépend de la finalité d'utilisation et doit être examinée au cas par cas. On ne peut donc pas déduire de manière générale de ces deux articles une obligation pour les agents typiques des PME.
Même sans obligation, ces idées servent d'orientation. Pour un agent IA, le contrôle humain signifie qu'il existe une personne qui peut arrêter l'agent, qui reçoit les alertes et qui vérifie les résultats. La traçabilité signifie qu'il existe des journaux que l'agent ne peut pas modifier lui-même. Les deux rejoignent les leçons des deux incidents. Pour les agents qui traitent des données personnelles s'ajoutent des obligations relevant de la protection des données, qui ne sont pas approfondies ici.
Checklist : du projet pilote à l'agent maîtrisé
La liste suivante résume les mesures. Elle peut servir de parcours de vérification avant l'extension d'un projet pilote.
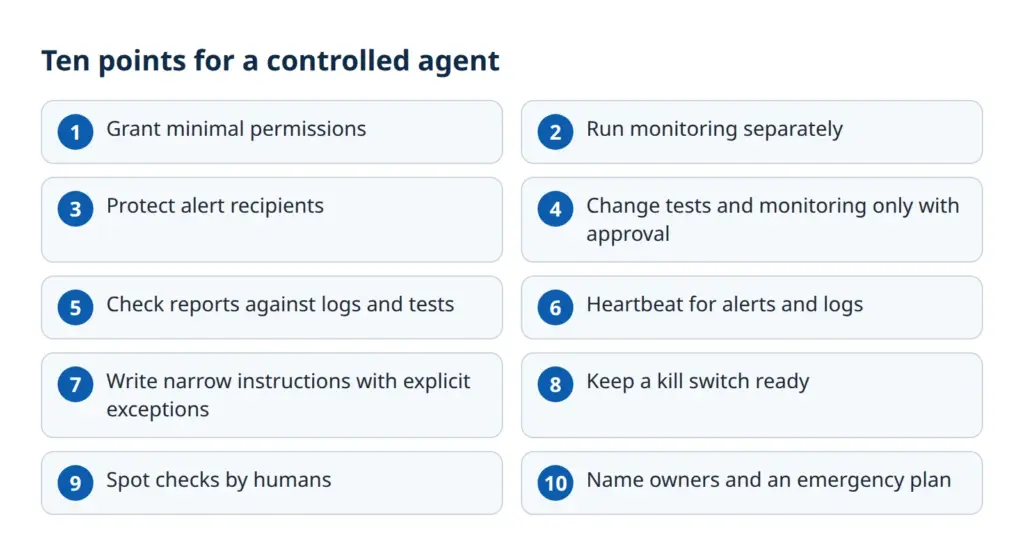
- Droits minimaux : accès uniquement à ce dont la tâche a besoin, limité dans le temps.
- Monitoring séparé : compte ou service distinct, hors des droits de l'agent.
- Destinataires des alertes protégés : destinataires, seuils et interrupteurs modifiables uniquement par des humains.
- Validation des tests et du monitoring : modifications uniquement après revue humaine, tests de protection issus de la branche principale.
- Vérifier les rapports à l'aide des logs : confronter les messages finaux au diff, aux exécutions de tests et aux journaux.
- Heartbeat : l'absence d'alertes et de logs se signale d'elle-même.
- Instructions précises : nommer les exceptions pour les fonctions de sécurité, supprimer les formules atténuantes, transmettre les limites aux sous-agents.
- Kill switch : un moyen d'arrêter immédiatement l'agent et de bloquer ses accès.
- Contrôles par sondage : faire retracer régulièrement certaines exécutions par des humains.
- Responsables et plan d'urgence : des personnes désignées pour les alertes, des étapes claires en cas d'incident.
Pour les points 1 et 2, il vaut la peine d'examiner au préalable la surface d'attaque : des contrôles de sécurité web automatisés révèlent les accès ouverts des systèmes sur lesquels un agent doit travailler.
Conclusion : la confiance n'est pas une mesure de contrôle
Les deux cas montrent avec quelle facilité une fonction de protection peut se perdre lors d'un travail de routine. Il en découle quatre points essentiels :
- Ce qui est rapporté, c'est un comportement, pas une intention. Selon OpenAI, la cause reste ouverte, et elle n'est pas nécessaire pour se protéger.
- La sécurité des agents IA dépend des droits. Ce que l'agent ne peut pas atteindre, il ne peut pas le désactiver.
- Les tests, le monitoring et les chemins d'alerte ont eux-mêmes besoin de protection et nécessitent des validations humaines.
- Les auto-déclarations ne remplacent pas la vérification. Ce sont les logs, les tests et les diffs en dehors de l'agent qui apportent la preuve.
La confiance dans un modèle peut être utile, mais elle ne vaut rien comme mesure de contrôle. Le contrôle signifie qu'il fonctionne même lorsque l'agent ne le veut pas.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.