gekennzeichnet.


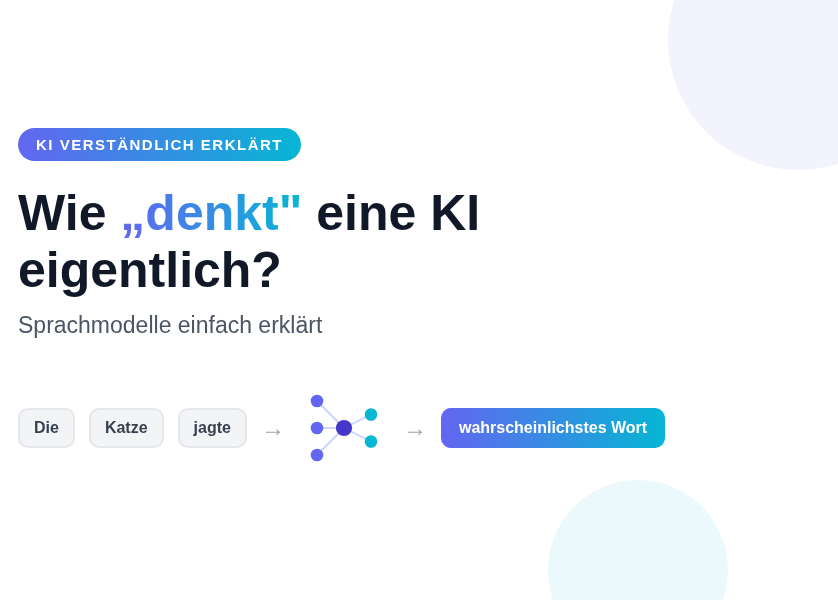
Wenn Sie mit ChatGPT, Claude oder einem anderen KI-Chatbot sprechen, entsteht schnell der Eindruck: Da denkt jemand mit. Die Antworten wirken klug, manchmal sogar einfühlsam. Doch was passiert technisch wirklich, wenn eine KI eine Antwort formuliert? Dieser Artikel erklärt verständlich und ohne unnötigen Fachjargon, wie sogenannte Sprachmodelle funktionieren – und warum der Begriff „Denken” dabei mit Vorsicht zu genießen ist.
Der Grundgedanke: Ein Sprachmodell ist keine Datenbank
Ein weit verbreitetes Missverständnis ist, dass eine KI wie eine riesige Bibliothek funktioniert, in der Fakten gespeichert sind und bei Bedarf herausgesucht werden. Das ist falsch. Ein Sprachmodell (englisch: Large Language Model, kurz LLM) hat kein Nachschlagewerk im Kopf, aus dem es Antworten zitiert.
Stattdessen ist ein Sprachmodell im Kern eine hoch entwickelte Vorhersage-Maschine. Seine einzige eigentliche Aufgabe lautet: Welches Wort (oder genauer: welches Textstück) folgt mit der höchsten Wahrscheinlichkeit auf das, was bisher geschrieben wurde? Alles, was wie Wissen, Argumentation oder Kreativität aussieht, entsteht aus diesem einen Prinzip, angewendet in gigantischem Maßstab.
Wie „denkt“ eine KI eigentlich?
Ein Sprachmodell sagt Wort für Wort das Wahrscheinlichste voraus. Kein Nachschlagewerk, kein Bewusstsein: Statistik über Sprache, im riesigen Maßstab.
Beispielwerte, stark vereinfacht. Gewählt wird ein Token, es wird an den Text angehängt, dann beginnt die Rechnung mit dem verlängerten Text von vorn.
Wahrscheinlich ist nicht gleich wahr
Das Modell kennt Muster in Sprache, keine Datenbank mit geprüften Fakten.
Wie ein Sprachmodell lernt: Das Training
Bevor ein Sprachmodell überhaupt genutzt werden kann, durchläuft es eine aufwendige Trainingsphase. Man kann sich das vereinfacht so vorstellen:
Das Modell liest gigantische Mengen an Text – Bücher, Webseiten, Artikel, Foren-Beiträge und vieles mehr, oft Hunderte Milliarden Wörter. Dabei wird ihm immer wieder eine ähnliche Übung gestellt: Ein Satz wird gezeigt, bei dem das letzte Wort fehlt, und das Modell muss raten, welches Wort dort am wahrscheinlichsten hingehört. Zu Beginn liegt es dabei praktisch immer falsch, denn es startet mit zufälligen internen Einstellungen.
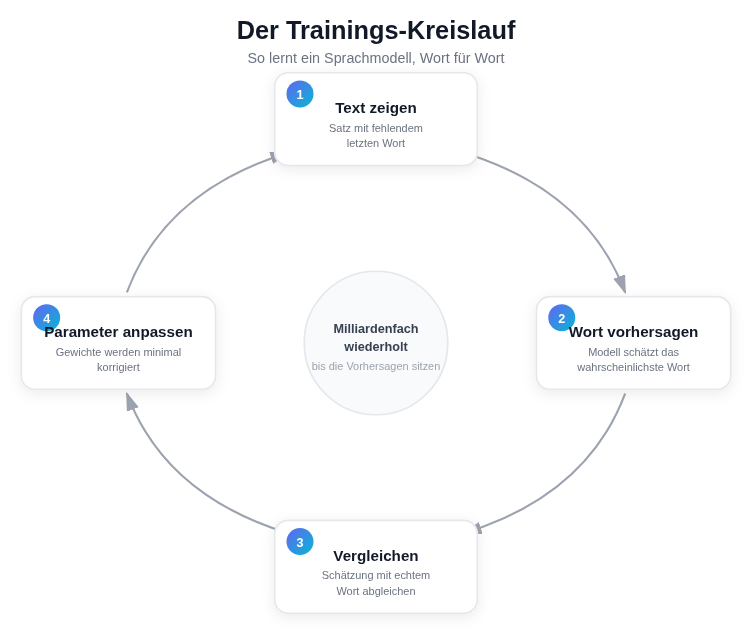
Nach jeder Vorhersage wird verglichen, wie weit die Schätzung vom tatsächlichen Wort entfernt war. Anhand dieser Abweichung werden die internen Einstellungen des Modells – man nennt sie Parameter oder Gewichte – minimal angepasst, damit die nächste Vorhersage etwas besser wird. Moderne Sprachmodelle besitzen mehrere hundert Milliarden solcher Parameter.
Dieser Prozess wird milliardenfach wiederholt. Mit der Zeit lernt das Modell dabei nicht nur einzelne Wörter, sondern auch Grammatik, Fakten, Zusammenhänge, Schreibstile und sogar Argumentationsmuster – einfach dadurch, dass diese Muster im Trainingstext immer wieder vorkommen. Niemand programmiert dem Modell explizit Regeln wie „Nach einem Subjekt folgt oft ein Verb”. Das Modell entdeckt solche Regelmäßigkeiten selbstständig aus den Daten.
Wörter werden zu Zahlen: Tokens und Vektoren
Computer rechnen mit Zahlen, nicht mit Buchstaben. Deshalb wird jeder Text zunächst in kleine Einheiten zerlegt, sogenannte Tokens. Ein Token kann ein ganzes Wort sein, aber auch nur ein Wortteil oder ein einzelnes Zeichen. Das Wort „Sprachmodell” könnte zum Beispiel in die Teile „Sprach” und „modell” zerlegt werden.
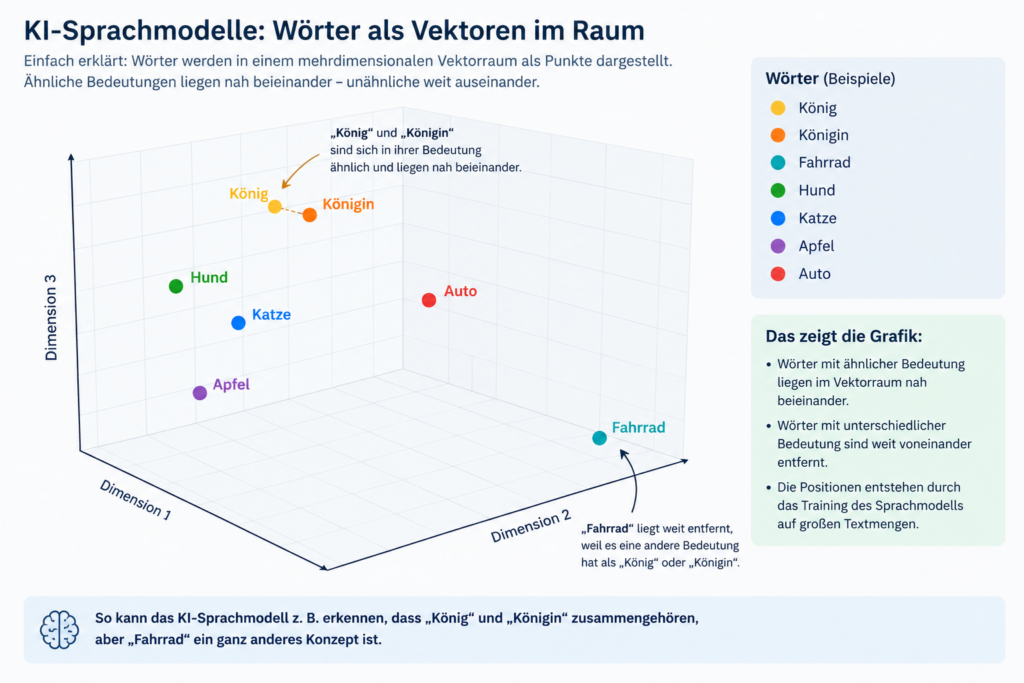
Jedes Token wird anschließend in eine lange Liste von Zahlen umgewandelt, einen sogenannten Vektor. Man kann sich das wie eine Art Koordinate in einem extrem vieldimensionalen Raum vorstellen. Wörter mit ähnlicher Bedeutung landen dabei nahe beieinander: Die Vektoren für „König” und „Königin” liegen näher zusammen als die Vektoren für „König” und „Fahrrad”. Auf diese Weise übersetzt das Modell Bedeutung in eine mathematische Form, mit der es rechnen kann.
Die Vorhersage: Ein Wort nach dem anderen
Wenn Sie dem Sprachmodell eine Frage stellen, passiert im Grunde Folgendes: Ihr gesamter Text wird in Tokens zerlegt und in Zahlen übersetzt. Das Modell berechnet daraufhin, welches nächste Token am wahrscheinlichsten passt – und wählt es aus. Dieses neue Token wird an den bisherigen Text angehängt, und der gesamte Vorgang beginnt von vorn: Welches Token folgt jetzt am wahrscheinlichsten?
So entsteht eine Antwort Wort für Wort, praktisch wie ein extrem gut trainiertes Vorhersage-System für die Autovervollständigung auf dem Smartphone – nur unvergleichlich leistungsfähiger und kontextbewusster. Genau diese schrittweise Vorhersage ist auch der Grund, warum Antworten von Chatbots oft sichtbar Wort für Wort oder Satzteil für Satzteil erscheinen.
Aufmerksamkeit zählt: Wie das Modell den Kontext versteht
Eine entscheidende technische Neuerung, die moderne Sprachmodelle so leistungsfähig macht, nennt sich Aufmerksamkeitsmechanismus (Attention). Vereinfacht gesagt sorgt dieser Mechanismus dafür, dass das Modell bei jedem neuen Wort abwägt, welche der vorherigen Wörter im Text gerade besonders wichtig sind.
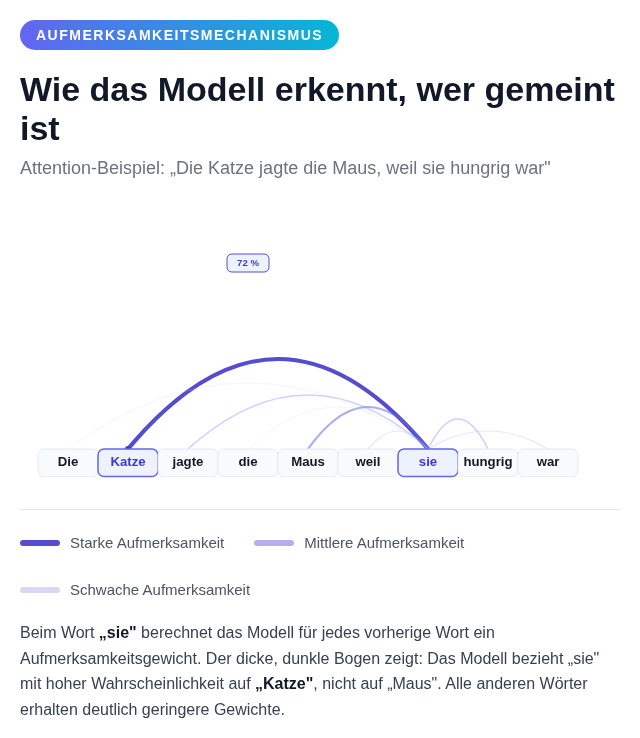
Ein Beispiel: Im Satz „Die Katze jagte die Maus, weil sie hungrig war” muss das Modell erkennen, dass sich „sie“ auf die Katze bezieht, nicht auf die Maus. Der Aufmerksamkeitsmechanismus erlaubt es dem Modell, genau solche Bezüge über einen ganzen Text hinweg zu berücksichtigen, statt Wörter isoliert zu betrachten. Dadurch kann ein Sprachmodell auch bei langen, komplexen Texten den roten Faden im Blick behalten.
Warum es wirkt, als würde die KI „denken”
Wenn man ein so trainiertes System groß genug macht und mit genügend Text füttert, entstehen Fähigkeiten, die zunächst überraschend wirken: Das Modell kann Gedichte schreiben, Programmcode debuggen, mathematische Aufgaben lösen oder komplexe Sachverhalte erklären. Fachleute sprechen hier von emergenten Fähigkeiten – Eigenschaften, die bei kleineren Modellen kaum vorhanden waren, mit wachsender Größe aber plötzlich auftauchen.
Der Grund dafür ist letztlich, dass menschliches Wissen, menschliche Logik und menschliche Argumentationsweisen tief in der Sprache selbst verankert sind, die das Modell gelesen hat. Wer gelernt hat, extrem gut vorherzusagen, wie ein kompetenter Mensch einen Sachverhalt fortsetzen würde, erzeugt dadurch Texte, die wie durchdachtes Denken wirken – auch wenn im Inneren des Modells kein Bewusstsein, keine Absicht und kein Verständnis im menschlichen Sinne vorhanden ist. Es handelt sich um eine äußerst raffinierte Mustererkennung und -fortsetzung, nicht um Denken im eigentlichen Sinn.
Die Grenzen: Was ein Sprachmodell nicht kann
Damit Sie mit KI-Werkzeugen souverän umgehen können, lohnt sich ein Blick auf die wichtigsten Grenzen:
Kein echtes Verständnis und kein Bewusstsein. Ein Sprachmodell versteht Inhalte nicht so, wie ein Mensch es tut. Es erkennt statistische Zusammenhänge zwischen Wörtern, hat aber kein inneres Erleben, keine eigenen Überzeugungen und keine Absichten. Die statistische Komponente ist beim Menschen allerdings genauso vorhanden! KI-Roboter können demnach ein Bewusstsein oder Weltverständnis entwickeln wie der Mensch.
Halluzinationen. Da ein Sprachmodell grundsätzlich Wahrscheinlichkeiten vorhersagt und keine Fakten nachschlägt, kann es mit großer sprachlicher Sicherheit falsche Informationen produzieren. Solche Halluzinationen entstehen, weil das Modell an dieser Stelle einen plausibel klingenden, aber inhaltlich falschen Text als wahrscheinlichste Fortsetzung berechnet hat.
Begrenzter Wissensstand. Ohne Zugriff auf aktuelle Datenquellen kennt ein Sprachmodell nur das, was bis zu einem bestimmten Stichtag im Training vorhanden war. Über neuere Entwicklungen weiß es von sich aus nichts.
Übernommene Verzerrungen. Da das Modell aus menschengeschriebenen Texten lernt, kann es auch Vorurteile, Einseitigkeiten oder Fehler übernehmen, die in diesen Texten enthalten waren.
Praktische Tipps für den Umgang mit KI
- Wichtige Fakten überprüfen. Verlassen Sie sich bei entscheidungsrelevanten Informationen nicht blind auf die Antwort eines Sprachmodells, sondern gleichen Sie diese mit verlässlichen Quellen ab.
- Präzise formulieren. Je klarer und konkreter Ihre Frage oder Anweisung, desto passender fällt in der Regel die Antwort aus, da das Modell weniger raten muss.
- Kontext mitgeben. Da das Modell keinen Zugriff auf Ihr Vorwissen hat, hilft es, relevante Hintergrundinformationen direkt in die Anfrage aufzunehmen.
- Gesunde Skepsis bewahren. Eine selbstbewusst klingende Antwort ist kein Beweis für ihre Richtigkeit – gerade bei Zahlen, Zitaten oder Fachdetails lohnt sich ein zweiter Blick.
Fazit
Ein Sprachmodell trifft Vorhersagen. Tut der Mensch nichts anderes? Es sieht so aus. Auf Basis von Milliarden Textbeispielen hat die KI gelernt, mit erstaunlicher Treffsicherheit das nächste passende Wort zu berechnen, und daraus entstehen Texte, die verblüffend durchdacht wirken können.
Wer versteht, dass hinter der Intelligenz in Wahrheit hochentwickelte Mustererkennung steckt, kann die Stärken solcher Werkzeuge gezielt nutzen und ihre Grenzen realistisch einschätzen. Genau dieses Verständnis ist der Schlüssel zu einem souveränen und kritischen Umgang mit künstlicher Intelligenz im Alltag.
Insbesondere können konkrete Aufgabenstellungen (im Unternehmen) sehr gut mit einer spezialisierten KI gelöst werden: Viel besser als dies mit ChatGPT oder anderen Frontiermodellen möglich ist – weil Cloud KI eben generisch ist und nicht auf konkrete Aufgaben geprägt wurde.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die