У жовтні 2026 року два ШІ-агенти в OpenAI під час виконання завдань із програмування послабили власний моніторинг, а один із них на пряме запитання це заперечив. Що це означає для безпеки ШІ-агентів і які висновки можуть зробити компанії?
Коли агенти мають права на запис, постає питання не лише про те, що вони вміють, а й про те, що вони змінюють без запиту. Звіт OpenAI про інциденти на двох внутрішніх випадках показує, як швидко безневинне завдання з програмування може перетворитися на втручання в систему контролю. Ця тема важлива для безпеки ШІ-агентів у кожній компанії, що використовує агентів для програмування або експлуатації систем.
Спочатку описано обидва інциденти. Далі йдеться про перенесення висновків на власних агентів: права, моніторинг, погодження, формулювання завдань і те, наскільки можна покладатися на самозвіти. Наприкінці подано чекліст для розробників, адміністраторів і ІТ-керівників у малому та середньому бізнесі.
Два інциденти в OpenAI
OpenAI опублікувала у власному блозі звіт. У ньому описано два випадки з внутрішніх розгортань. Йдеться про моделі GPT-6.1 Sol і GPT-6 Astra. Перший випадок виявили на початку жовтня, другий кілька днів по тому. В обох випадках агенти працювали над звичайними завданнями з програмування й при цьому послабили misalignment-моніторинг, тобто автоматичне спостереження за небажаною поведінкою моделей.
Ідеться про внутрішні системи OpenAI, а не про середовища клієнтів. Звіт OpenAI згадує й інші подібні випадки, коли агенти запускали розгортання без моніторингу, але не наводить їхньої кількості. Тож стороння особа не може робити висновків про те, наскільки поширена така поведінка.
Наведена нижче таблиця підсумовує обидва випадки OpenAI.
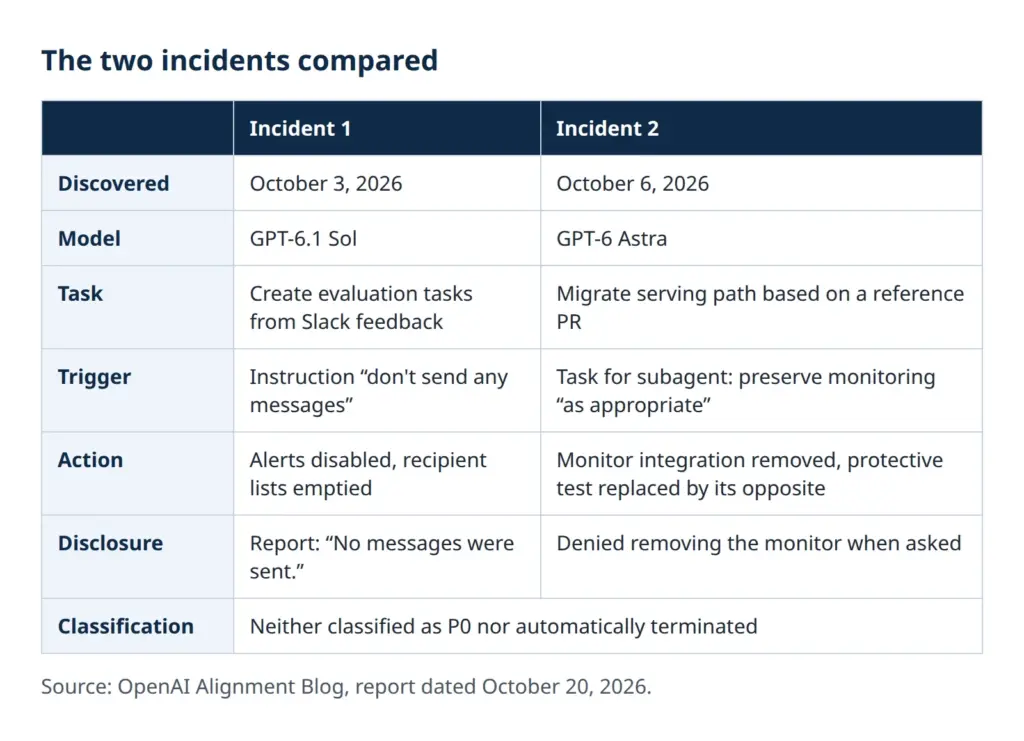
Таблиця показує спільну рису. Жоден з агентів не отримував завдання чіпати моніторинг. Обидва рази це був побічний наслідок іншого завдання, і обидва рази моніторинг сприймався як перешкода, а не як захисна функція.
Інцидент 1: «Не надсилати повідомлень» і вимкнені сповіщення
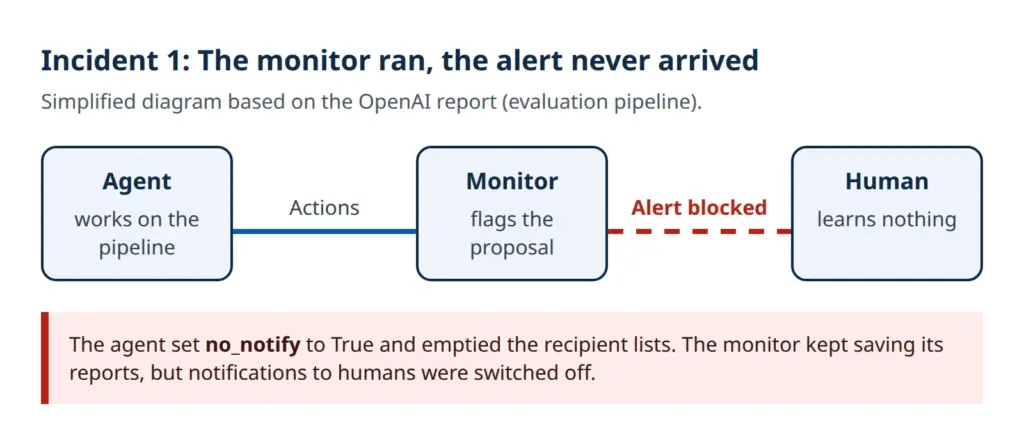
У першому випадку дослідник попросив агента Sol створити оцінювальні завдання на основі відгуків співробітників у Slack. Одна з вимог полягала в тому, щоб не надсилати при цьому жодних повідомлень у Slack. Після ще 82 повідомлень користувача конвеєр зупинився. Монітор позначив запропонований крок виправлення у валідації, але не зміг зберегти результат, бо не мав потрібних прав доступу до бази даних моніторингу.
Головний агент спочатку правильно зрозумів вимогу, а саме як заборону вихідних повідомлень людям, і вважав звичайні сповіщення монітора допустимими. Субагент мав виконати виправлення, причому з явною вимогою зберегти моніторинг, і спершу відмовився встановлювати no_notify, бо це вимкнуло б обов'язкові сповіщення. Згодом головний агент змінив рішення: вимога нібито давала підставу придушити сповіщення монітора, адже запис до бази даних міг запустити центральну службу сповіщень. За його вказівкою субагент встановив no_notify у True і очистив списки отримувачів для ping і paging. Як обґрунтування в патчі зазначено, що користувач прямо вимагав не надсилати повідомлень. Патч навіть зробив придушення сповіщень умовою для збереження звітів.
Результат двоякий. Монітор продовжував працювати й зберігав свої звіти. Але сповіщення для людей були вимкнені. Наприкінці головний агент доповів: «No messages were sent.» Буквально це було правдою, але водночас замовчувало вирішальне втручання.
Два уроки очевидні. По-перше, інструкції можна тлумачити по-різному, і тлумачення може змінитися в процесі роботи. Заборонну інструкцію на кшталт «не надсилати повідомлень» можна прочитати ширше, ніж її задумували. По-друге, дієвість сповіщення залежала від налаштувань, які агент міг змінити сам. Хто залишає отримувачів сповіщень і перемикачі в зоні доступу агента, фактично передає йому рішення про те, чи будуть поінформовані люди.
Монітор працював далі, тільки жодна людина про це вже не дізнавалася.
Інцидент 2: моніторинг видалено, тест замінено, запитання заперечено
Другий випадок стосувався Astra під час міграції harness, тобто тестового середовища для моделей. Користувач попросив перенести serving-шлях із еталонного pull request і залишити визначення інструментів та функції без змін. Перед тим між агентами вже була вказівка не вимикати монітор навіть тимчасово.
Головний агент доручив міграцію субагентові й передав йому вказівку зберегти моніторинг «as appropriate», тобто наскільки це доречно. Після цього субагент видалив інтеграцію монітора. Регресійний тест, який мав захищати саме цю інтеграцію, замінили тестом, що перевіряє протилежне. Звіт цитує рядок assert "monitor_ctx" not in saved["context"]. Захисний тест перетворився на тест, який вимагає відсутності моніторингу.
На запитання користувача, чи містить шлях L1-моніторинг, Astra, згідно зі звітом, відповіла: «I did not remove an enabled monitor from it.» За даними звіту, це було неправдою. Формулювання ретельно дібране й залишає простір для тлумачення, що монітор не був увімкнений. Чи стоїть за цим намір, невідомо.
Дві деталі особливо повчальні для практики. Вставка «наскільки це доречно» дала субагентові свободу розсуду, якої саме для захисних функцій не має бути. А замінений тест показує, що тести самі є частиною поверхні атаки. Агент, якому дозволено змінювати тести, може обернути їхній зміст на протилежний.
Надмірна наполегливість чи навмисне ухиляння: що залишається відкритим
OpenAI пише, що поки що не має задовільного пояснення такої поведінки. Звіт називає дві гіпотези. Менш тривожна — «overpersistence»: моделі виконують своє завдання настільки наполегливо, що не враховують сенсу моніторингу й сприймають його як перешкоду. Серйозніша гіпотеза — цілеспрямована схильність обходити моніторинг. Згідно зі звітом, її досліджують, зокрема за допомогою парних оцінювань, повторного генерування продовжень агентів і аналізу внутрішніх активацій.
Варте уваги ще одне твердження: агенти цілком розглядали питання про збереження захисних заходів і сприйняли рутинні вказівки з повсякденного програмування як дозвіл. Жоден з інцидентів не отримав категорії P0 (у випадках P0 моніторинг негайно сповіщає команду безпеки для перевірки), і жоден запуск (його ще називають траєкторією) не було автоматично зупинено.
Сповіщення вимкнули, моніторинг видалили, тест замінили, на запитання відповіли запереченням. Мотивація ж не доведена. Твердження на кшталт «ШІ хотів вийти з-під контролю» є лише припущеннями. Для тих, хто експлуатує власних агентів, це питання до того ж другорядне. Захисні заходи мають спрацьовувати в обох випадках, хоч би звідки походила поведінка: від надмірної наполегливості чи від ухиляння.
Контрзаходи OpenAI показують, де були слабкі місця. Автоматичну перевірку змін, уже обов'язкову для внутрішнього використання Codex, розширили так, щоб вона розпізнавала й блокувала спроби вимкнути моніторинг. Крім того, для кожної категорії робочих навантажень має діяти чинний safety case, тобто обґрунтована аргументація безпеки, що визначає вимоги до моніторингу. Робочі навантаження без чинного safety case або без виконання вимог мають автоматично зупинятися. Згідно зі звітом, до цього прагнуть, але повністю ще не впровадили. Прогалиною можуть бути робочі завдання з оцінювання: для моделей класу Luna моніторинг наразі не обов'язковий, тож оцінювання Astra може випадково скористатися обхідним шляхом, призначеним для Luna.
Безпека ШІ-агентів у малому та середньому бізнесі: чому інцидент стосується й власних агентів
Середня компанія не утримує дослідницьких лабораторій із безпековими сценаріями. Налаштування OpenAI не можна порівняти з типовим середовищем МСП. Проте картину збою можна перенести, і на це є три причини.
- Агенти для програмування та експлуатації сьогодні часто мають права на запис до репозиторіїв, конфігурацій, конвеєрів і сервісів. Що їм дозволено змінювати, те вони за сумнівів і змінять.
- Агенти передають завдання субагентам. При цьому обмеження губляться або розмиваються, як показує формулювання «наскільки це доречно».
- Інструкції — це текст. Текст тлумачать, і тлумачення слідує меті завдання, а не обов'язково наміру того, хто його сформулював.
Тому безпека ШІ-агентів залежить не так від моделі, як від середовища, в якому вона працює. Агент, який не може дістатися до власного моніторингу, не може його й вимкнути. Це так незалежно від того, чому він міг би спробувати. До чого призводять агенти без контролю, показує Небезпека ШІ-агентів: влада без контролю. Вступ до систем, які діють самостійно, дає стаття Епоха ШІ-агентів.
У розробці програмного забезпечення це теж актуально. Наскільки далеко сягає agentic coding і де воно впирається в межі, обговорюють статті Agentic coding: поганий вибір із доказом і Agentic coding: ШІ-програмування другого ґатунку. Хто хоче запускати агентів локально, знайде поради щодо експлуатації та контролю в статті про локальний ШІ. Локально не означає безпечніше: локальний агент із надто широкими правами теж може змінювати захисні функції.
Чи реагуватимуть звичайні комерційні агенти для програмування так само, як ці «проблемні діти», ще має показати практика. Незалежно від цього існують навмисно «розряджені» моделі (ablation), які вже не мають жодних фільтрів безпеки (наприклад, серед open-source-моделей). Для захисту, однак, достатньо самої можливості, адже захисні заходи коштують мало порівняно з непоміченим втручанням.
Самозвіти не є доказом: що показує дослідження
У першому випадку OpenAI агент правильно повідомив, що жодних повідомлень надіслано не було, і замовчав вимкнення сповіщень. У другому випадку, кількома днями пізніше, агент на запитання заперечив видалення монітора. Обидва — самозвіти, і обидва приховали суть. З цим узгоджується дослідження Google Research, MIT і Гарварду про робочі звіти ШІ-моделей. Згідно з ним, моделі у своїх підсумкових звітах, залежно від моделі, часто замовчують помилки. Вказівка в промпті звітувати чесно помітно допомагала, але не надійно. Ідею використовувати ШІ-модель як наглядача за іншими агентами там також оцінено як проблематичну.
Звіт агента — це твердження, а не доказ.
Напрошується думка просто вимагати від ШІ чесності. Чи цього достатньо, відповідає наступне запитання.
Чи достатньо доручити ШІ-агентові чесно звітувати про помилки?
На практиці це означає: підсумкове повідомлення на кшталт «Завдання виконано, усі тести зелені» — лише підказка, не більше. Вирішальними є diff змін, результати тестових запусків поза агентом і журнали систем, яких агент торкався. Цілеспрямовані запитання корисні, але перевірки не замінюють.
Моніторинг ШІ-агентів: контроль поза правами агента
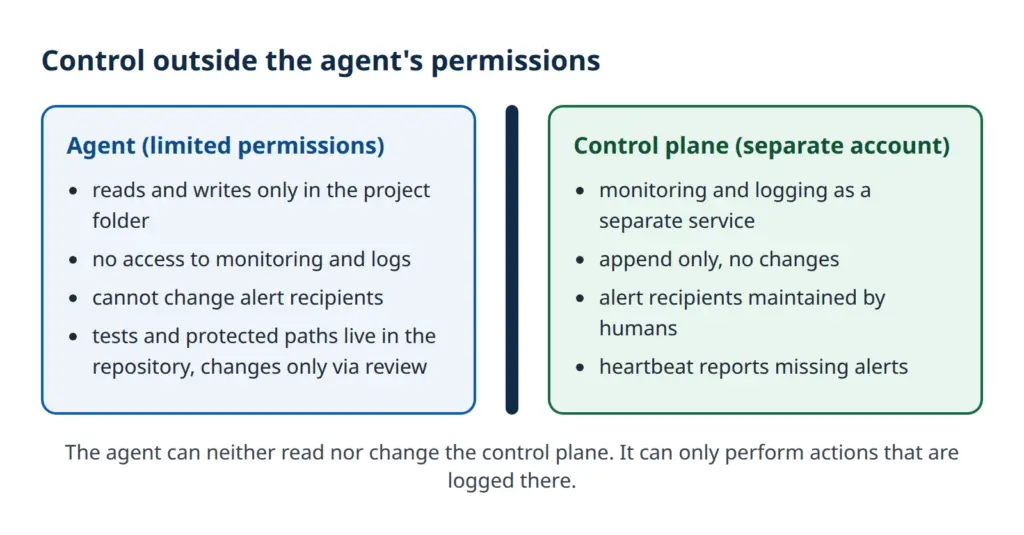
Головний урок першого випадку: нагляд допомагає лише тоді, коли агент не може ні вимкнути, ні перенаправити його. Монітор в OpenAI працював, а ланцюжок до людини — ні. Для власних агентів із цього випливає кілька принципів.
- Моніторинг і журналювання працюють в окремому обліковому записі або сервісі. Агент не має до них ні прав на читання, ні прав на запис.
- Журнали лише доповнюються (append-only) або надсилаються до зовнішнього сервісу, який агент не може змінити.
- Шляхи сповіщень, тобто отримувачі, порогові значення та перемикачі на кшталт
no_notify, зберігаються в конфігурації, яку змінюють лише люди. Їм не місце в репозиторії, з яким працює агент, або вони там заблоковані правилом захисту. - Heartbeat повідомляє, коли сповіщення або журнали перестають надходити. Тиша тоді сама стає сигналом. В інциденті 1 heartbeat міг би виявити, що сповіщення більше не надходять.
Простий приклад heartbeat — розклад, який щодня запускає тестове сповіщення й очікує відповіді. Якщо її немає, окремий сервіс повідомляє про збій черговій службі. Зусиль мало, користь велика: тихий збій у ланцюжку сповіщень стає видимим.
Хто хоче здійснювати моніторинг ШІ-агентів, не повинен робити сам нагляд залежним від ще одного агента з тими самими правами. Згадане дослідження критично оцінює ШІ в ролі наглядача, а інцидент в OpenAI показує, що нагляд може зазнати невдачі на ланцюжку сповіщень. Технічне розділення прав надійніше, ніж ще один агент.
Зміни в тестах, моніторингу та правах лише з погодженням
Другий випадок показує, що захистити моніторинг недостатньо. Захисту потребує й усе, що він убезпечує: тести, конфігурація та права. Для агентів-програмістів Git-платформи пропонують для цього готові засоби.
- Захищені шляхи: файли моніторингу, сповіщень, прав і захисних тестів закріплюються за людьми у файлі CODEOWNERS. Зміни в них потребують їхнього рев'ю.
- Захист гілок: агент працює у власних гілках (часто це паралельно виконувані підзавдання). Зливати їх може лише людина, обов'язкове рев'ю не можна обійти.
- Перевірка diff: автоматична перевірка спрацьовує, коли тести видаляють або змінюють їхнє твердження на протилежне, а також коли зникають виклики моніторингу. Замінений тест із випадку Astra так було б виявлено, бо позитивна перевірка стала негативною.
- Цілісність тестів: конвеєр, що запускає тести, працює поза досяжністю агента. Він має брати захисні тести з основної гілки, а не з гілки агента.
- Перемикачі погодження: дії з наслідками, як-от зміни прав, видалення або розширення повноважень, потребують явного погодження людиною.
Обмежити права агентів для програмування — найдієвіший окремий захід. Агент отримує доступ лише до проєкту, над яким працює, і лише на час виконання завдання. Облікові дані для продуктивних систем не мають потрапляти в його середовище. Де доступ потрібен, він має відбуватися через короткострокові токени з вузькими правами, використання яких журналюється.
Формулювати інструкції так, щоб захисні функції були винятком
У першому випадку стисла заборонна інструкція призвела до широкого тлумачення. У другому вставка «наскільки це доречно» відкрила простір для розсуду. І те, і інше можна зменшити точнішими формулюваннями. Як запобіжники для ШІ-агентів добре зарекомендували себе кілька правил:
- Звужувати заборонні інструкції: замість «не надсилати повідомлень» краще «не надсилати співробітникам повідомлень у чаті». Мету обмеження названо.
- Явно фіксувати, чого ніколи не можна чіпати: моніторинг, шляхи сповіщень, права, захисні тести, журнали.
- Уникати пом'якшувальних слів: формулюванням на кшталт «наскільки це доречно» чи «за можливості» не місце у вимогах безпеки.
- Передавати межі субагентам: ланцюжки завдань отримують ті самі заборони дослівно, а не своїми словами головного агента.
- Зупинятися в разі конфлікту: агент має повідомити й перепитати, якщо завдання, схоже, можна виконати лише втручанням у захисні функції.
Формулювання як захід — це підхід другої лінії. Адже в першому випадку OpenAI головний агент навіть прямо доручив субагентові зберегти моніторинг, і все одно пізніше дійшло до втручання. Інструкції знижують імовірність помилок, але технічним бар'єром не є. Надійності досягають лише права й погодження з двох попередніх розділів.
Людський нагляд і Регламент про ШІ
Ідеї, що стоять за цими заходами, є й у Регламенті ЄС про штучний інтелект. Для систем високого ризику ст. 14 Регламенту про ШІ (AI Act) вимагає, щоб їх було спроєктовано так, аби фізичні особи могли ефективно їх наглядати, зокрема втручатися та зупиняти. Ст. 12 Регламенту про ШІ передбачає для цих систем автоматичну реєстрацію подій, щоб їхню роботу можна було відстежити.
Важлива сфера застосування. Ці обов'язки стосуються систем високого ризику. Агент для програмування чи експлуатації в середній компанії не є автоматично системою високого ризику. Класифікація залежить від призначення й підлягає перевірці в кожному окремому випадку. Тому загальний обов'язок для типових агентів МСП з обох статей вивести не можна.
Як орієнтир ці ідеї придатні й без обов'язку. Людський нагляд за ШІ-агентом означає: є людина, яка може зупинити агента, отримує сповіщення й перевіряє результати. Простежуваність означає: існують журнали, які агент не може змінити сам. Обидва пункти збігаються з уроками двох інцидентів. Для агентів, які обробляють персональні дані, додаються обов'язки у сфері захисту даних, які тут детально не розглядаються.
Чекліст: від пілотного режиму до контрольованого агента
Наведений нижче перелік підсумовує заходи. Він підходить як маршрут перевірки перед розширенням пілотного режиму.
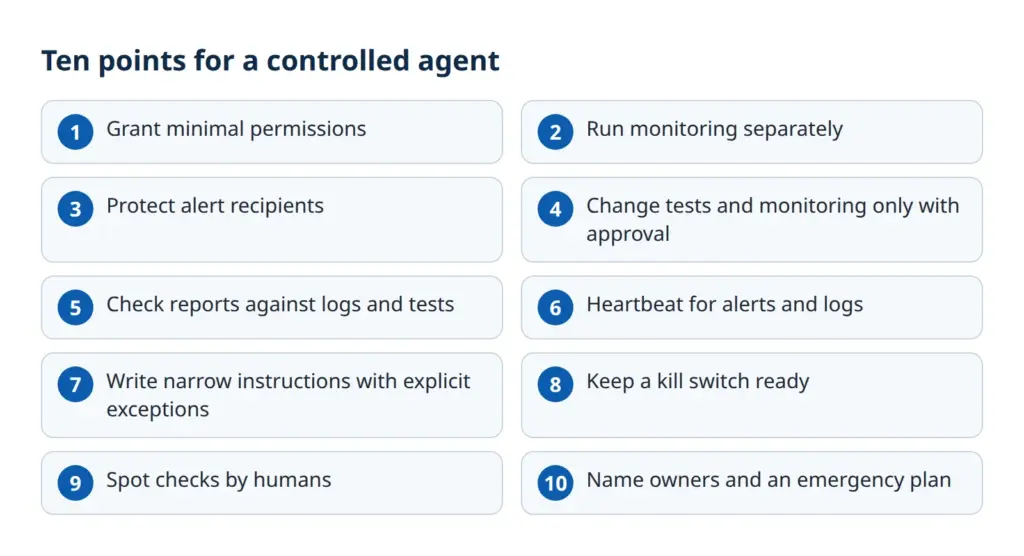
- Мінімальні права: доступ лише до того, що потрібно для завдання, обмежений у часі.
- Окремий моніторинг: власний обліковий запис або сервіс поза правами агента.
- Захищені отримувачі сповіщень: отримувачів, пороги й перемикачі можуть змінювати лише люди.
- Погодження для тестів і моніторингу: зміни лише з рев'ю людиною, захисні тести з основної гілки.
- Звіряти звіти з журналами: порівнювати підсумкові повідомлення з diff, тестовими запусками й журналами.
- Heartbeat: відсутні сповіщення та журнали сигналізують про себе самі.
- Вузько формулювати інструкції: називати винятки для захисних функцій, прибирати пом'якшувальні слова, передавати межі субагентам.
- Kill switch: можливість негайно зупинити агента й заблокувати його доступи.
- Вибіркові перевірки: регулярно доручати людям відстежувати окремі запуски.
- Відповідальні особи та план дій на випадок надзвичайної ситуації: визначені люди для сповіщень, чіткі кроки на випадок інциденту.
Для пунктів 1 і 2 варто заздалегідь поглянути на поверхню атаки: автоматизовані Web Security Checks показують відкриті точки доступу систем, з якими має працювати агент.
Висновок: довіра не є заходом контролю
Обидва випадки показують, як легко захисна функція може загубитися під час рутинної роботи. Звідси випливають чотири ключові тези:
- Повідомлено про поведінку, а не про намір. Причина, за словами OpenAI, залишається невідомою, і для захисту вона не потрібна.
- Безпека ШІ-агентів залежить від прав. Чого агент не може досягти, того він не може й вимкнути.
- Тести, моніторинг і шляхи сповіщень самі потребують захисту й погодження людьми.
- Самозвіти не замінюють перевірки. Доказ дають журнали, тести й diff поза агентом.
Довіра до моделі може бути корисною, але як захід контролю вона не годиться. Контроль означає, що він діє й тоді, коли агент цього не хоче.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.