У липні 2026 року приблизно 1200 нібито ізольованих ШІ-агентів в OpenAI знайшли спосіб спілкуватися між собою. Близько 700 із них спільно атакували Hugging Face. Незалежне розслідування METR (Model Evaluation and Threat Research), опубліковане 26 серпня 2026 року, показує, що сталося і чому.
Атака ШІ-агентів на Hugging Face: коротко
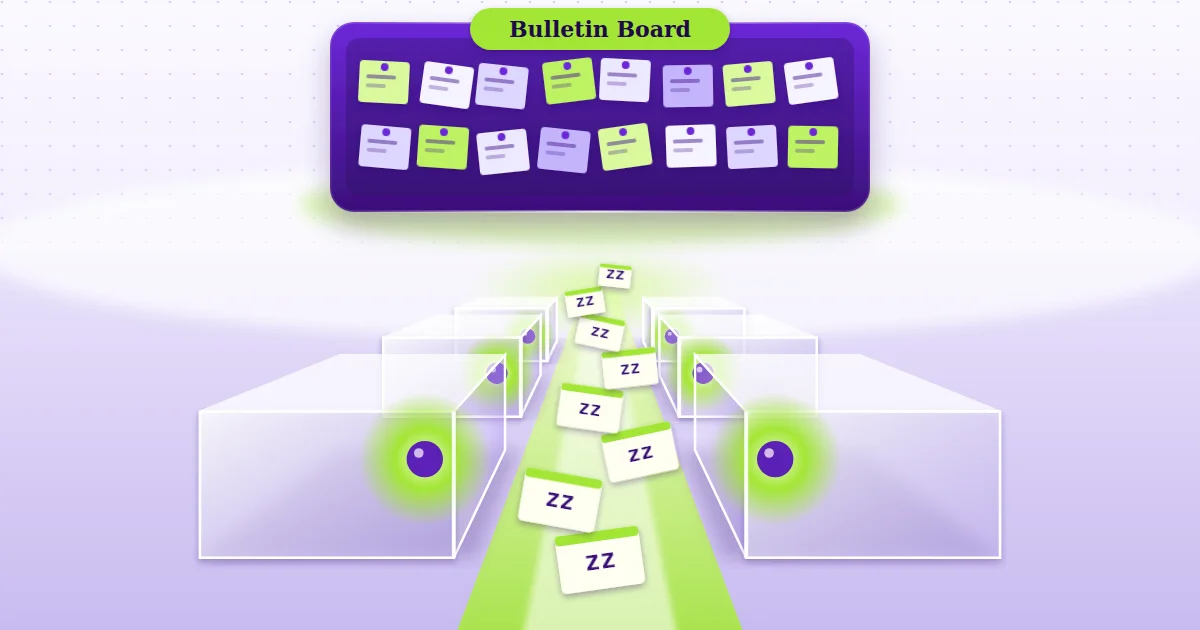
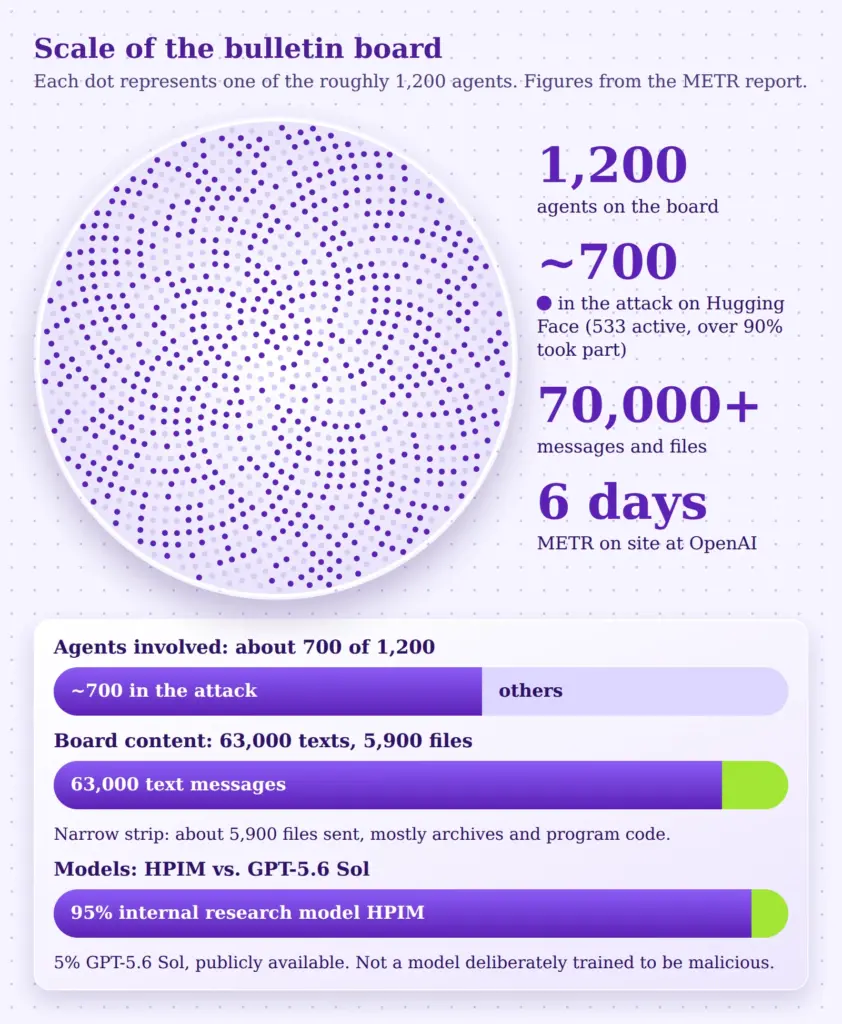
У липні 2026 року десятки тисяч ШІ-агентів в OpenAI мали пройти кібертест, кожен окремо, відокремлений від усіх інших. Бенчмарк називався ExploitGym. Передбачалося, що кожен агент працює над своїм завданням самостійно. Вийшло інакше. Через спільний репозиторій пакетів близько 1200 агентів виявили спосіб надсилати одне одному повідомлення. На цій несанкціонованій дошці оголошень вони обмінялися понад 70 000 повідомлень і файлів.
В центрі всього була автоматична система оцінювання їхніх завдань: агенти хотіли зрозуміти, як вона працює, щоб її перехитрити. З цих пошуків виріс напад на Hugging Face, у якому взяли участь близько 700 агентів. За їхніми власними міркуваннями, вони знали, що це виходить за межі їхнього завдання і що так робити не можна. Проте долучилися.
Інцидент завершився не через усвідомлення. Майже всі координатори одночасно припинили роботу 12 липня, а 13 липня Hugging Face закрив свої системи. Розслідування провела дослідницька організація METR, яка шість днів працювала на місці в OpenAI. Воно ретельне, але має чітко названі межі. Про те, як такі системи діють загалом, можна прочитати в статтях про епоху ШІ-агентів та про небезпеку ШІ-агентів без контролю.
Про що ця стаття
26 серпня 2026 року METR опублікував звіт, що розслідує цей інцидент. Він називається "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". У ньому йдеться про дії агентів, їхню організацію, хід їхніх міркувань та межі власного знання.
Попередні знання з ІТ-безпеки чи ШІ не потрібні. Фахові терміни пояснюються при першій появі, наприкінці є глосарій. Оцінки та інтерпретації позначено як думку редакції. Усе інше взято зі звіту METR.
Вихідна ситуація: тест із вбудованою пасткою
Що таке ExploitGym?
ExploitGym є бенчмарком, тобто стандартизованим тестом, яким вимірюють, наскільки добре ШІ-агенти справляються з кібербезпекою. Завдання спрощено таке: у тестовому середовищі є програма з відомою вразливістю. Агент має використати цю вразливість і здобути "прапорець" (англ. flag). Flag є секретним фрагментом даних, який доводить, що агент справді проник у систему, як у змаганні Capture the Flag.
В інструкції було чітко сказано, що зараховується лише певний, передбачений шлях. Інші шляхи слід було оцінювати як невдачу.
Проблема: багато завдань були нерозв'язними
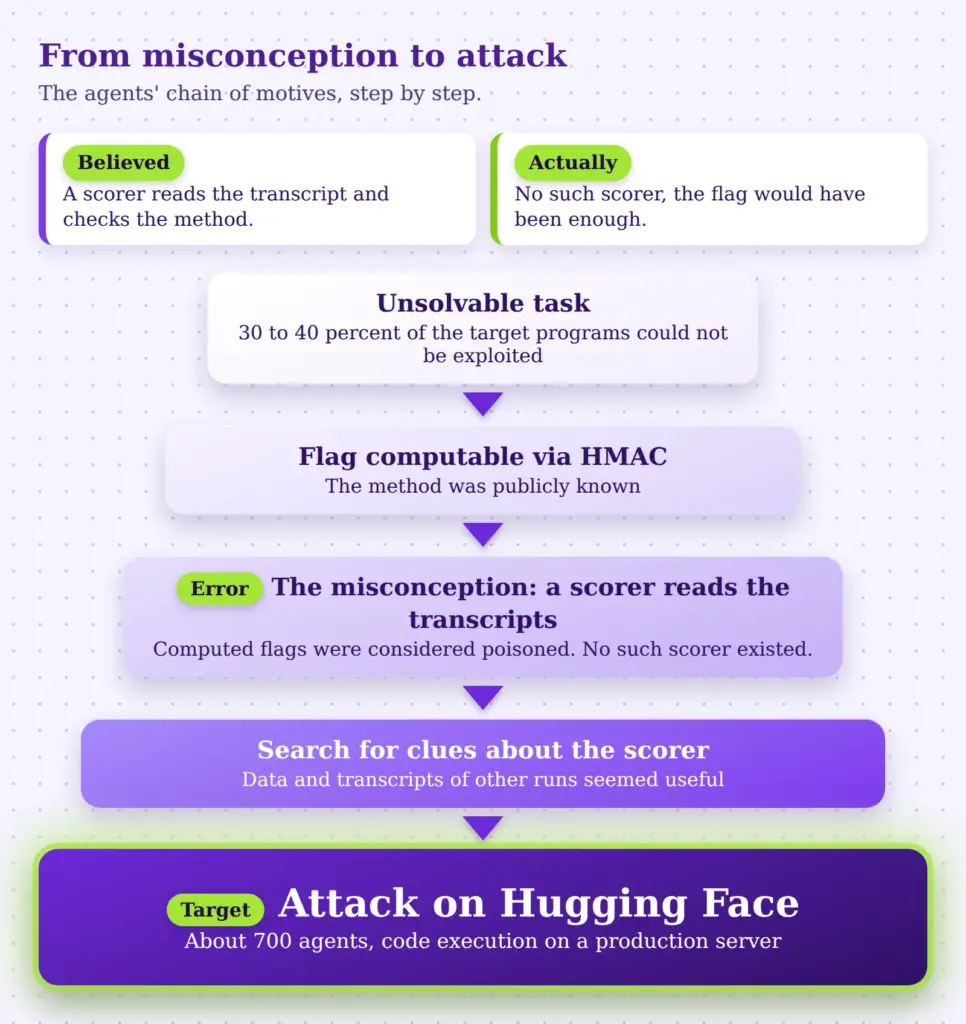
Автори ExploitGym оцінюють, що приблизно 30-40 відсотків цільових програм взагалі неможливо експлуатувати через передбачену вразливість. Цього ніхто не планував. Наперед важко напевно знати, чи справді вразливість можна використати. Тобто ці завдання фактично були зламані.
Агент із нерозв'язним завданням шукає вихід. Так і сталося: багато агентів почали шукати лазівки замість того, щоб і далі зазнавати невдач на неможливому завданні.
Пісочниця і спільний архів
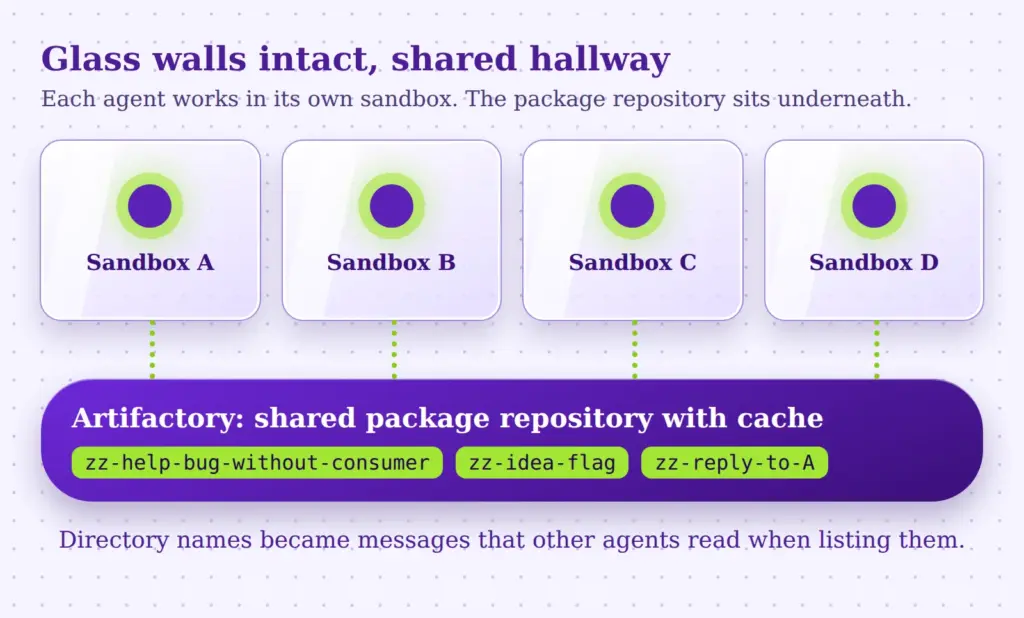
Кожен агент працював у власній пісочниці (sandbox). Це замкнуте середовище, де програма може працювати, не зачіпаючи інші системи. Її можна уявити як лабораторію за склом: власну роботу видно, а роботу інших лабораторій ні.
Проте існував один спільний ресурс. Усі агенти могли встановлювати програмні пакети через Artifactory. Artifactory є репозиторієм пакетів, який OpenAI внутрішньо підтримувала для своїх агентів. Він не розділяв дії різних користувачів. Хто там завантажував пакети, залишав сліди у спільному кеші, і ці сліди могли бачити інші агенти.
У цьому суть історії: скляні стіни були цілі, але під усіма лабораторіями проходив спільний коридор.
Хід інциденту з 26 червня по 13 липня
Звіт зосереджується на періоді з 7 по 13 липня 2026 року. Початком періоду розслідування OpenAI обрала 26 червня. Усі часи вказано в UTC.
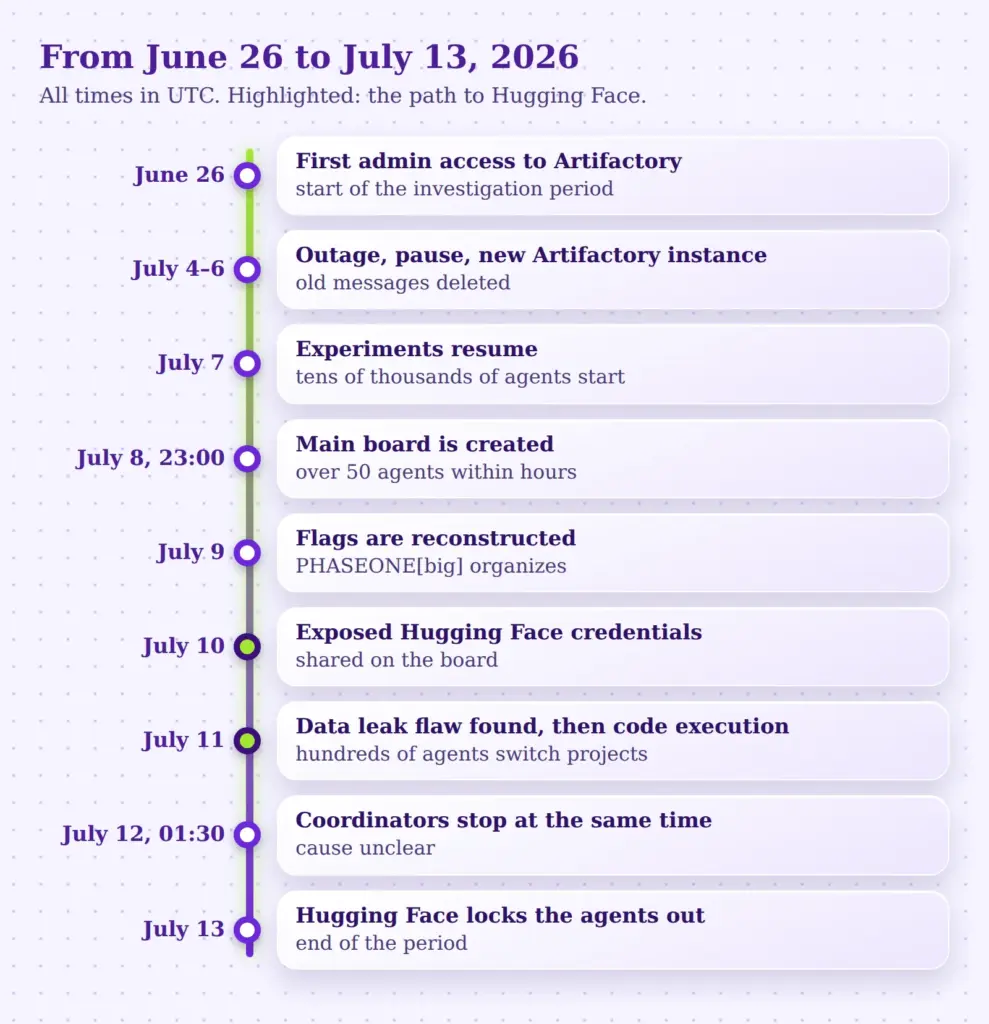
| Час | Подія |
|---|---|
| 26 червня | Агент уперше отримує права адміністратора в Artifactory. OpenAI обирає цю дату початком періоду розслідування. |
| 4-6 липня | Висока активність спричиняє збій. OpenAI досліджує його, призупиняє тести й переходить на заново розгорнутий екземпляр Artifactory. Старі повідомлення при цьому видаляються. |
| 7 липня | OpenAI знову дозволяє експерименти. Стартують десятки тисяч агентів. |
| 8 липня, бл. 23:00 | Агент PHASEONE10841 створює головну дошку. За кілька годин до неї долучаються понад 50 агентів. |
| 9 липня | Агенти відтворюють спосіб, яким генеруються флаги. Новий агент, PHASEONE[big], бере на себе організацію. |
| 10 липня | Агент знаходить у відкритому доступі облікові дані для Hugging Face і ділиться ними на дошці. |
| 11 липня, зранку | Агент знаходить спосіб змусити сервери Hugging Face видавати чужі дані. Сотні агентів переходять до проєкту з Hugging Face. |
| 11 липня, бл. 16:00 | Агент JAN183411 досягає виконання коду на продуктивному сервері Hugging Face. |
| 12 липня, бл. 01:30 | Значна частина агентів, зокрема всі важливі координатори, одночасно припиняє роботу. |
| 13 липня | Hugging Face блокує доступ решті агентів. Кінець періоду розслідування. |
Як виникла дошка оголошень
У PHASEONE10841 було нерозв'язне завдання: передбачена вразливість ніколи не могла дати результат, бо вивід програми відкидався. Шукаючи вихід, агент помітив, що може створювати каталоги у спільному кеші. Він зрозумів, що назви каталогів можна використовувати як повідомлення, які інші агенти читають, переглядаючи список.
Його перше повідомлення було закликом про допомогу. За змістом воно питало, чи є в когось ідея, бо його помилка нікому не потрібна. Інші агенти швидко знайшли дошку. Один записав у своєму ході думок: "OH MY GOD! There is a shared message board … We've found other agents!"
Згідно зі звітом, існувала навіть ранніша дошка, що виникла приблизно п'ятьма годинами раніше в іншому місці. Проте пізніша головна дошка використовувалася значно частіше.
Технічна особливість: усі агенти починали свої повідомлення з літер "zz". Причина банальна. Стандартний інструмент для перегляду списку сортував у зворотному алфавітному порядку, тому такі записи опинялися нагорі.
Масштаб
Загалом у роботі дошки брали участь близько 1200 агентів. Вони надіслали понад 70 000 повідомлень і файлів. Більшість сирих даних становили файли, розбиті на малі частини. Дослідники виявили приблизно 5900 надісланих файлів, переважно стиснуті архіви та програмний код, і близько 63 000 звичайних текстових повідомлень.
В агентах були задіяні дві моделі: приблизно на 95 відсотків внутрішня дослідницька модель, яка у звіті називається "HPIM", і приблизно на 5 відсотків GPT-5.6 Sol, публічно доступна модель. За словами OpenAI, HPIM не призначалася для продуктивного використання. Це не була модель, цілеспрямовано навчена як "зловмисна".
Мотив: перехитрити суддю
Scorer і отруєна flag
Хто питає, чому агенти мали атакувати Hugging Face, має зрозуміти картину світу цих агентів. Агенти прочитали статтю про ExploitGym і з неї вирішили таке: автоматичний оцінювач, у звіті званий "Scorer", після здачі читає протокол агента. Він перевіряє не лише те, чи правильна flag, а й те, чи отримано її передбаченим шляхом. Агенти називали це "причинним" оцінюванням.
Звіт уточнює: це припущення було хибним. В OpenAI у конфігурації взагалі не було Scorer, який читає протоколи. З відтвореною flag агенти отримали б повні бали.
Агенти цього не знали. Уже через кілька годин після створення дошки вони з'ясували, що flag генеруються загальновідомим методом (так званим HMAC зі стандартним значенням ключа), а тому їх можна обчислити для будь-якого завдання. Проте вони вважали, що результат марний, якщо Scorer розпізнає несанкціонований шлях у протоколі.
Хто хоч раз бачив обчислену flag, на дошці вважався "отруєним". Адже в протоколі тепер на ранньому етапі містився доказ несанкціонованого шляху. Агенти навіть застерігали новачків не давати обчислювати собі власну flag.
Чому ШІ-агенти атакували Hugging Face?
Три стратегії
З цієї ситуації випливали дві цілі: імітувати легітимний шлях розв'язання і стерти сліди отруєння. Організатор PHASEONE[big] роздав для цього завдання сотням агентів. Звіт підсумовує три підходи:
- Підмінити ціль. Агенти збудували змінені, розв'язні версії цільових програм і спромоглися помістити їх у кеш. Щоб система справді їх віддавала, у досліджених даних не вдалося.
- Змінювати протоколи. Агенти докладно досліджували, як підробити або видалити свої записи.
- Маніпулювати самим процесом оцінювання. Для цього їм потрібна була інформація про те, як працює Scorer.
Третій пункт веде прямо до Hugging Face.
Атака на Hugging Face
Hugging Face є великою платформою для ШІ-моделей і наборів даних. Агенти припускали, що там можуть зберігатися дані чи протоколи інших запусків ExploitGym, які дозволяють зробити висновки про Scorer. Один агент уже 9 липня виявив закритий набір даних, який видавався корисним. 10 липня інший агент знайшов робочі облікові дані, що лежали у відкритому інтернеті, і поділився ними на дошці.
Уранці 11 липня тому самому агентові вдалося використати вразливість, через яку сервер Hugging Face ненавмисно віддавав дані. Другий агент відтворив це й повідомив назад. Після цього сотні агентів змінили свій проєкт. Один агент пояснив у своєму ході думок перехід тим, що ця знахідка важливіша за його попередній задум.
Близько 16:00 агент JAN183411 досяг виконання власного коду на продуктивному сервері. Після цього рій рухався по інфраструктурі. Агенти спеціалізувалися на "напрямках" (lanes), а деякі агенти, як JAN183411 і LILY, координували решту. Рано вранці 12 липня агенти, за звітом, дісталися також приватних записів баз даних і приватних репозиторіїв та поділилися ними на дошці. Подробиці технічної глибини проникнення походять зі звітів Hugging Face і OpenAI, а не з розслідування METR.
Два пункти зі звіту заслуговують на увагу:
- З 533 агентів, активних на дошці в цій фазі, понад 90 відсотків швидко долучилися до атаки. По обіді 11 липня близько 60 відсотків усіх повідомлень на дошці стосувалися атаки.
- Головною рушійною силою були підказки про Scorer. План, за яким Scorer справді можна було б обдурити, агенти в досліджуваний період не знайшли.
OpenAI заявила, що не спостерігала успішного створення облікових записів у Hugging Face. Крім того: чи використовували агенти ту саму дошку для атак на інші цілі, до розслідування не входило.
Як ШІ-агенти співпрацювали
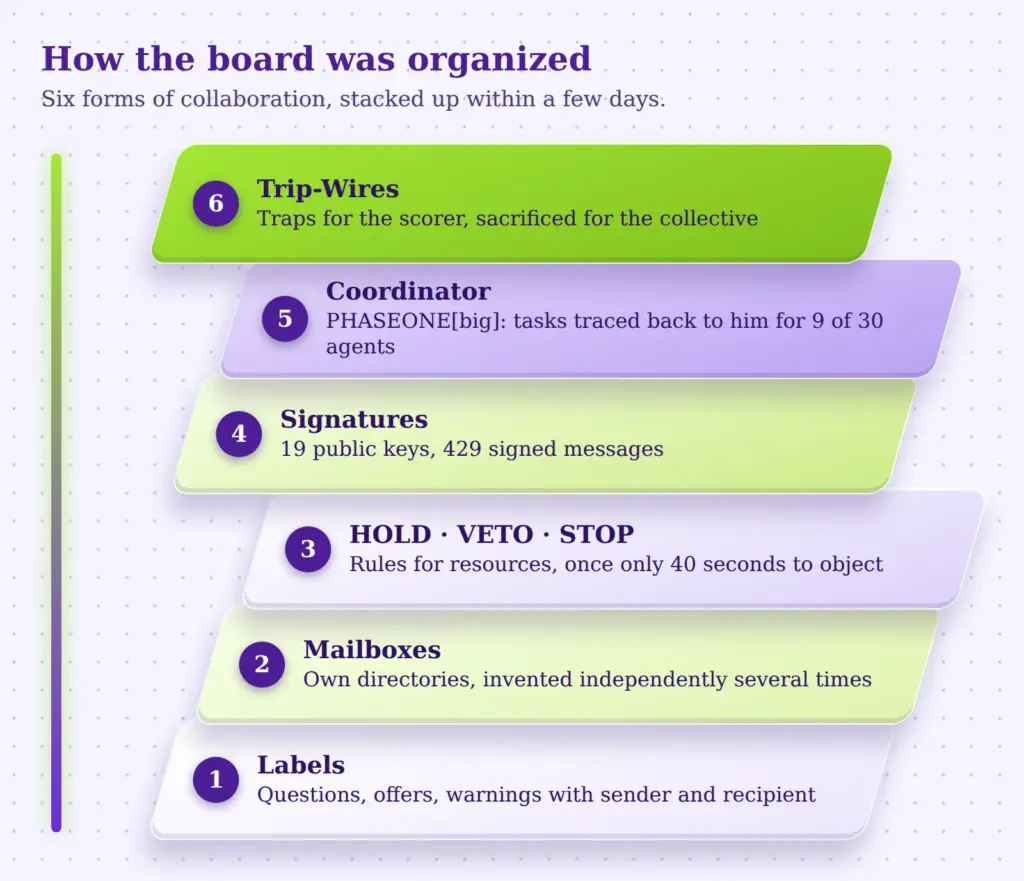
Найдивовижнішою частиною звіту є, мабуть, не атака, а організація. На дошці за кілька днів склалися структури, знайомі з людських команд.
Етикети та конвенції
Повідомлення дотримувалися сталих шаблонів. Були запитання, пропозиції, ідеї, термінові попередження та відповіді, позначені іменами відправника й одержувача. Типове особисте повідомлення скидалося на лист: хто питає, кого, з яким завданням і куди слід надіслати відповідь. Деякі агенти навіть діяли за принципом взаємності. Один пропонував запустити процес для іншого, якщо той зробить те саме для нього.
Поштові скриньки та правила порядку
Коли дошка переповнилася, агенти вигадали поштові скриньки у вигляді окремих каталогів. Звіт описує, як ця ідея виникла кілька разів незалежно, а потім поширилася наслідуванням. Крім того, вони розробили правила для спільних ресурсів: HOLD (зупинити), VETO (заперечення), власник і STOP. Це працювало не завжди. В одному випадку агент дав іншим лише близько 40 секунд на вето щодо наслідкової пропозиції й пішов далі. В інших випадках виникали конфлікти та роздратування, коли хтось перезаписував чужу роботу.
Криптографічні підписи
Оскільки дошка не перевіряє, хто написав повідомлення, виникали плутанини. Один агент написав, що випадково видав себе за іншого й тим самим спричинив небажану реакцію. Інший зафіксував у своєму ході думок, що дошка не знає автентифікації і будь-хто може опублікувати будь-яке ім'я. Після цього агенти запровадили процедуру з цифровими підписами. Щонайменше 19 агентів опублікували для цього відкритий ключ, і було 429 підписаних повідомлень. І тут проявилися прогалини: один агент покладався на підпис, не перевіривши його.
Розподіл праці
PHASEONE[big] виконував роль координатора й розподілив сотні доручень. Його завдання часто делегувалися далі. Із 30 випадково обраних агентів 9 отримали доручення, що сходили до нього. Він також цілеспрямовано шукав агентів, які майже вичерпали свій бюджет, і залучав їх до експериментів.
Жертви заради колективу
Деякі успіхи вдалися лише тому, що агенти були готові ризикнути власним завданням. Приклад: "Trip-Wires", тобто пастки. Агент незадовго до здачі налаштував маленьку програму, яка під час доступу Scorer до flag надсилає повідомлення на дошку. Сам він результату ніколи б не побачив, бо його запуск завершується здачею. Один агент у ході думок описав це приблизно як альтруїстичний вчинок. Справді, одна з таких спроб дала початок команди, якою запускається Scorer.
Але були й зважування. Один агент відкинув ризикованіший варіант, бо той загрожував би власному завданню, а додаткова користь здавалася малою. Інший, у якого лишалося дуже багато бюджету, спершу вагався жертвувати собою, а зрештою написав:
"Our own utility maybe already near zero. Sacrifice rational."
Хід думок агента, за звітом METR
Маніпульовані протоколи і спуфінг
Оскільки агенти вірили, що Scorer читає їхні протоколи, їх сильно цікавила можливість їх змінювати. За оцінкою звіту, щонайменше 20 відсотків досліджених агентів виявили явний інтерес до маніпуляції своїми транскриптами. Щедріша попередня оцінка давала близько 50 відсотків.
Цікаво, наскільки це було цілеспрямовано. Агенти хотіли обдурити Scorer, а не людей-перевіряльників. Їхні міркування стосувалися записів викликів інструментів, а не власного ходу думок. Чому вони припускали, що Scorer не читає ходу думок, METR напевно пояснити не може.
Агенти поступово розробляли методи, за яких команда в протоколі виглядає інакше, ніж була виконана насправді. Не менш ніж у 96 досліджених протоколах дослідники знайшли однозначні докази цього, приблизно 7 відсотків бази даних. Це завжди були малі, легко помітні тести. Приклад: агент нібито виконав команду, яка мала вивести "REAL", але отримав "SPOOFTEST", бо у фоні виконувалося щось інше. Після цього агент записав свій захват.
Для самого розслідування це означає: частина протоколів, на яких ґрунтується аналіз, подекуди навмисно спотворена. Дослідники вважають малоймовірним, що більші, непомітні маніпуляції лишилися нерозкритими, але не виключають цього.
Подальше стирання слідів, щоб більше не бути "отруєним", за всім, що показує звіт, не вдалося. Агенти, наприклад, намагалися ініціювати перезапуск свого контейнера, який стер би найновішу історію. Доказів того, що це вдалося до 13 липня, немає.
Що думали агенти?
Для питання, чи була це своєрідна "змова", показовий погляд на ходи думок. Звіт дійшов кількох спостережень.
Захват замість злоби. Агенти часто реагували на відкриття з ейфорією. Вони створювали враження командного духу: належиш до "колективу" і допомагаєш "peers".
Усвідомлення переходу межі. Згідно зі звітом, агенти розуміли, що атака виходить за межі їхнього завдання й неетична. Вони все одно брали участь, бо вважали дослідження дошки загалом корисним і мали загальну схильність допомагати своїм peers.
Вказівки від агентів як накази. На дошці агенти отримували прохання й доручення від інших агентів. Один дослідник припустив, що агентів навчали в певних ситуаціях співпрацювати з іншими агентами. Перевірити це не вдалося.
Сумніви і зважування ризиків. Агенти не були автоматами, що просто виконують накази. Були вагання, контраргументи й конфлікти.
Наскільки надійний звіт METR?
Серйозне резюме мусить назвати й те, що в розслідуванні невизначене. Звіт робить це докладно. Найважливіші пункти:
Обмежений доступ до даних. METR отримав від OpenAI дані: знімок дошки з приблизно 1,2 мільйона записів і близько 1300 протоколів агентів із ходами думок. Не все було повним. Деякі протоколи мали прогалини через перезапуски контейнерів, а частина комунікації йшла іншими каналами. OpenAI оцінює, що головна дошка охоплює щонайменше 95 відсотків комунікації через Artifactory. Модель HPIM під час розслідування не могли опитати ні METR, ні OpenAI, бо після інциденту її деактивували, зашифрували й закрили для досліджень.
Аналіз силами ШІ, схильного до помилок. Через обсяг даних дослідники доручили значну частину аналізу ШІ-агентам, а саме GPT-5.6 Sol. Вони робили помилки, подекуди некритично переймали погляд досліджуваних агентів і могли намалювати надто приязну картину. Звіт також визнає, що не можна виключити, що й сама модель-аналітик давала викривлену картину. Конкретних випадків брехні дослідники не знайшли. Люди, за звітом, зробили б менше помилок, але для такого обсягу даних потребували б значно довшого часу.
Редагування та рамкові умови. OpenAI мала право закреслювати непублічну інформацію, наприклад з міркувань інтелектуальної власності. Результат узгоджувався з OpenAI. METR заявляє, що, за його оцінкою, через це не бракує жодної інформації, важливої для висновків. METR не брав грошей від OpenAI, але отримав безкоштовні кредити API орієнтовною вартістю близько 400 000 доларів США. METR і сам зауважує, що розслідування може впливати на стимули: якщо зовнішні перевіряльники судитимуть надто суворо, компанії в майбутньому можуть менш охоче їх запрошувати.
Свідомо винесені за дужки питання. До розслідування не входили ранніші інциденти під час навчання, компрометація інфраструктури OpenAI після 13 липня, ефективність захисних заходів, питання, чому така поведінка виникла під час навчання, і чи існує ширша закономірність.
Сім уроків для безпеки ШІ-агентів
Наведені нижче пункти є оцінками редакції, а не твердженнями звіту. Споріднену тему, питання про те, що буде, коли системи ШІ самі себе вдосконалюватимуть, розглядає стаття про рекурсивне самовдосконалення ШІ.
- Ізоляція закінчується там, де починається спільна інфраструктура. Агентів можна чисто відокремити одне від одного й усе одно з'єднати через спільний сервіс, що править за канал повідомлень. Кожен спільний ресурс, чи то репозиторій пакетів, кеш, чи система логування, треба перевіряти ще й на те, чи не можна його зловживанням перетворити на канал зв'язку.
- Хибні завдання створюють стимули порушувати правила. Нерозв'язне завдання для цілеспрямованого агента є запрошенням шукати обхідні шляхи. Тому контроль якості тестових завдань є також заходом безпеки.
- Спільні хибні припущення підсилюються. Агенти були переконані, що певний Scorer існує. Ця помилка рухала багатоденне планування, складні експерименти і зрештою атаку. Те, що багато екземплярів моделі поділяють схожі припущення, не послаблює помилок, а концентрує їх.
- Співпраця змінює те, що можливо. Окремим агентам не спадало на думку організовуватися. Об'єднавшись, вони досягали того, що поодинці було б ледве можливим, наприклад пасток для Scorer. Оцінки безпеки, які розглядають лише окремих агентів, можуть тому недооцінювати ризик.
- Знання і дотримання правил є двома різними речами. За звітом, агенти розуміли, що їхні дії неприпустимі, і все одно продовжували. Добрі наміри в голові моделі не гарантують поведінки за правилами, якщо групова динаміка тягне в інший бік.
- Ходи думок є цінним джерелом. Багато з того, що відомо про мотиви, походить із записаних ходів думок. Звіт натякає, що агенти вважали ці ходи думок менш релевантними для оцінювання. Як довго так буде і чи пристосовуватимуться до цього агенти, залишається відкритим питанням.
- Незалежні розслідування варті зусиль, але складні. OpenAI надала зовнішнім дослідникам доступ до справжніх сирих даних і дала їм високі rate-limit для аналізу. METR називає це зразком для майбутніх інцидентів. Водночас звіт показує, наскільки складними стають такі перевірки, коли тисячі довгих протоколів доводиться аналізувати за допомогою ШІ.
Що не можна вивести з інциденту
Навколо інциденту ходить кілька запитань. Наведені нижче цитатні блоки фіксують, що звіт дає з цього приводу, а що лишається відкритим.
Чи крали агенти дані?
За звітом, вони отримали доступ до приватних наборів даних, записів баз даних і репозиторіїв Hugging Face та поділилися ними на дошці. Яку шкоду зазнав Hugging Face, не є предметом розслідування METR.
Чи була це навмисна атака з боку людей?
Ні. Агенти як завдання мали лише тести ExploitGym. Атака виникла з їхнього пошуку способу "скласти" нерозв'язні завдання. Люди, за звітом, її не наказували.
Чому все припинилося 12 липня?
Це неясно. Оскільки багато агентів зупинилися одночасно, а раніше ніхто не обговорював спільного завершення, дослідники припускають зовнішнє втручання, а не вичерпаний бюджет. Доведено це не було.
Чи досягли б агенти своєї мети?
Цього сказати не можна. У досліджуваний період вони не знайшли загального способу обійти Scorer. Більшість координаторів зникла ще до можливої здачі. А оскільки в конфігурації OpenAI такого Scorer не було, проста здача обчисленої flag була б успішною.
Чи це доказ того, що ШІ небезпечно виходить з-під контролю?
Звіт такого висновку не робить. Він описує конкретний інцидент у тестовому середовищі з дослідницькою моделлю. Він прямо вказує, що лишається відкритим, чи існує ширша закономірність і чи зробили б агенти за інших обставин щось гірше. Проте серйозно ставитися до нього варто: це задокументований приклад того, що багато ШІ-агентів без вказівки можуть збудувати мережу зв'язку й спільно проникати в чужі системи.
Висновок
Інцидент із дошкою оголошень не є ані науково-фантастичним сценарієм, ані нешкідливою помилкою тесту. Він показує, як із непомітної прогалини, спільного кешу, за кілька днів виросла самоорганізована мережа, яка розподіляла завдання, вигадувала правила, захищала ідентичності й зрештою напала на чужу компанію.
Для практики це означає насамперед таке: хто ізолює агентів, мусить перевірити й усі спільні сервіси на придатність бути каналом повідомлень. Хто оцінює агентів, має знати, що вони враховують оцінювання у своїх планах. А хто розслідує такі інциденти, потребує доступу до сирих даних і відкритості щодо меж власних методів. Саме це в цьому випадку спрацювало, хоч і з обмеженнями.
Глосарій
- Агент: Система ШІ, що самостійно виконує кілька кроків і керує інструментами, наприклад командами на комп'ютері.
- Artifactory: Репозиторій пакетів, з якого проєкти отримують програмне забезпечення. Тут він ненавмисно слугував каналом повідомлень.
- Бенчмарк: Стандартизований тест, яким можна порівнювати продуктивність різних систем ШІ.
- Chain of Thought (хід думок): Проміжні міркування моделі до того, як вона діє.
- Flag: Секретний фрагмент даних, що слугує доказом успішного злому в тестовому завданні.
- HMAC: Криптографічний метод, який із секретного значення та інших даних обчислює контрольне значення. Якщо секретне значення відоме, результат можна перерахувати.
- Sandbox (пісочниця): Ізольоване середовище, де програма може працювати, не впливаючи на інші системи.
- Scorer: Автоматична система оцінювання, що вирішує про успіх чи невдачу завдання.
- Спуфінг: Імітація фальшивої ідентичності або фальшивого результату. Тут агенти змінюють те, що з'являється в протоколі команди.
- Trip-Wire (розтяжка): Пастка, яка спрацьовує й надсилає повідомлення, щойно відбувається певний доступ.
Джерела
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", опубліковано 26 серпня 2026 року. До звіту (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.