Googles topchef Sundar Pichai siger, at branchen stadig er langt fra slutstadiet for selvforbedrende AI, altså den rekursive selvforbedring. Samtidig beskriver han løkker, hvor AI-agenter allerede i dag hjælper med at bygge nye modeller. Med det, vi ved i dag, kan man sortere, hvad der er dokumenteret, og hvad det betyder for brugen af AI i små og mellemstore virksomheder. Er menneskeheden i fare?
Anledningen er et interview, som Big Technology omtalte den 23.10.2026. Her falder en sætning om selvforbedrende AI, som er let at citere: Branchen er stadig langt fra slutstadiet for RSI. RSI står for Recursive Self-Improvement, altså rekursiv selvforbedring. Det betegner et kredsløb, hvor AI-systemer forbedrer deres efterfølgere, som igen bygger bedre efterfølgere.
Det grundlæggende om, hvordan sådanne løkker fungerer, findes i artiklen om rekursiv selvforbedring af AI. Udsagn fra interviewet, producenternes egne oplysninger, en forskningsartikel og en prognose fra insidere står i det følgende adskilt ved siden af hinanden.
Hvad Pichai sagde, og hvad han ikke sagde
Kernen er kort. Ifølge Alex Kantrowitz' artikel sagde Pichai: »To be very clear. We are pretty far from the end state of RSI.« Det betyder nogenlunde: »For at sige det helt klart: Branchen er stadig ret langt fra slutstadiet for rekursiv selvforbedring.« Kantrowitz stiller sætningen op over for forventningen hos nogle i AI-branchen om, at en intelligenseksplosion er lige om hjørnet, og at AI snart forbedrer sig selv i en fuldstændig løkke uden menneskelig medvirken.
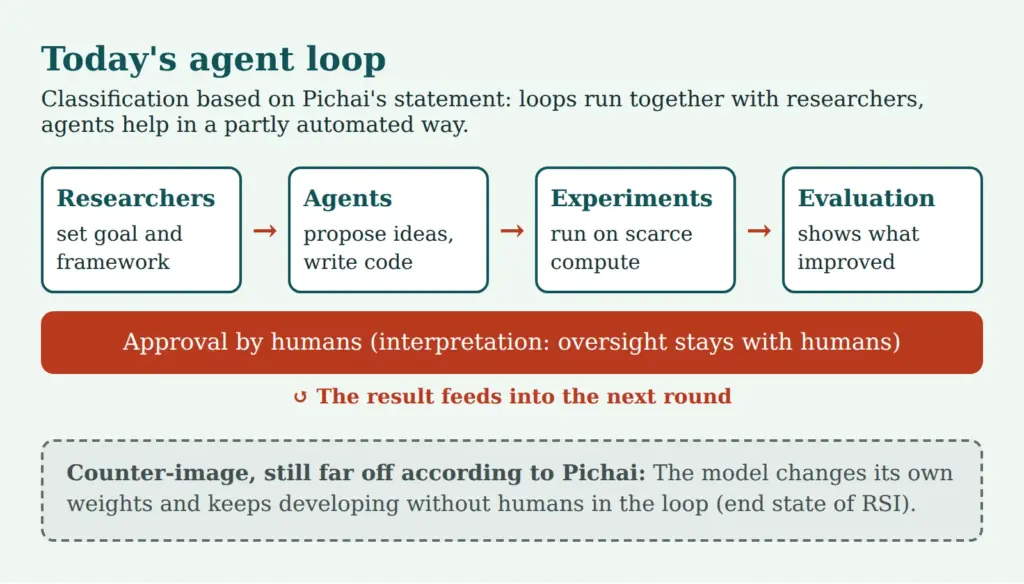
Lige derefter følger to sætninger, der er vigtigere for vurderingen end den første. Pichai sagde: »You have RSI loops along with AI researchers in various aspects of model development.« Og: »You almost have agents helping AI researchers in some automated way work together to build these models.« Meningen er: Inden for forskellige dele af modeludviklingen findes der feedbackløkker sammen med forskerne, og agenter hjælper dem delvist automatiseret med at bygge modellerne.
Dokumenteret ordret er dermed: Delløkker kører allerede, og de kører sammen med forskerne. En model, der bygger sig selv om uden opsyn, nævnes ikke i disse sætninger. Sætningen om slutstadiet kan læses sådan, at det netop er dette billede, der menes.
Som sidetema skriver Big Technology om regnekraft. Pichai siger, at alle mangler den, ikke kun Google: »The compute we have today is a function of decisions I made in 2024.« Ifølge artiklen siger han desuden, at cloudforretningen gang på gang giver afkald på kortsigtet omsætning, fordi regnekraft reserveres til udviklingen af de førende modeller. For selvforbedringen er det relevant, for hver løkke af idé, eksperiment og evaluering koster regnetid. Hvor den er knap, bremser den også automatiseret forskning.
En tidsramme er ikke dokumenteret. Sekundære kilder som DigitalToday nævner »næste år« som tidspunkt for yderligere fremskridt.
Her følger en fortolkning, der ikke stammer fra Pichai. Den, der taler om et slutstadie, forudsætter, at der findes en vej dertil, og at vejen er påbegyndt. Sætningen kan derfor også læses som et udsagn for RSI: Udviklingen finder sted, Google driver den frem med store ressourcer, og om nogle år er store gennembrud tænkelige. Denne forventning er en selvstændig vurdering. Et tilsvarende udsagn fra Pichai findes ikke i de læste kilder.
En mulig læsning: Den, der taler om slutstadiet, forudsætter, at vejen dertil er påbegyndt. Sætningen er så mindre en afblæsning end en stedsbestemmelse.
Selvforbedrende AI: agentløkke kontra ændring af vægte
Bag begrebet gemmer sig to meget forskellige ting, som ofte blandes sammen i hverdagen. Den første er agentløkken. Her arbejder AI-agenter med i udviklingen: De foreslår eksperimenter, skriver og ændrer kode, starter træningskørsler, evaluerer resultater og melder tilbage. Mennesker sætter mål, kontrollerer resultater og beslutter ændringer. Kredsløbet forbedrer processer, værktøjer og arbejdsgange.
Den anden er ændringen af vægte. Her ville en model ændre sine egne vægte, så efterfølgeren bliver bedre, uden at et menneske godkender resultaterne undervejs. Det er dette billede, der bærer begrebet intelligenseksplosion. Og netop derfra er branchen, sådan som Pichai kan læses, stadig langt væk.
Mellem de to poler er der ikke en kontakt, men et spektrum. Antallet af trin, som agenter udfører uden at spørge, kan vokse. Med det vokser den del af udviklingen, som mennesker kun kontrollerer stikprøvevis. Hvordan agenter handler i drift, og hvorfor det kræver kontrol, beskriver artiklen om AI-agenternes tidsalder.
Det centrale spørgsmål fortjener et nøgternt svar. Det kan udledes af de dokumenterede sætninger.
Bedriver Google allerede rekursiv selvforbedring, når AI hjælper med at bygge efterfølgermodellerne?
For SMV'er er forskellen ikke akademisk. En agentløkke gør modelcyklusserne hurtigere, uden at tab af kontrol er problemet. En ændring af vægte uden opsyn ville rejse spørgsmålet, om mennesker stadig kan følge med i ændringerne. De to spørgsmål kræver forskellige svar, og kun det første er praktisk relevant i dag.
Hvad Google og andre fortæller om deres egen status
Producenters udsagn om egne fremskridt er egne oplysninger. De kan være korrekte, men de er ikke uafhængigt efterprøvet. Det gælder alt i dette afsnit.
Et aktuelt eksempel er Flint. Virksomheden Recursive præsenterer i sin annoncering modellen som en hurtig kodningsmodel til lokal hardware med i alt 40 milliarder parametre og 2,5 milliarder aktive pr. token (altså en Mixture of Experts-model). Efter egen fremstilling har et lille team af mennesker og agenter bygget den på under fire måneder. Det automatiserede forskningssystem, »Eureka Machine«, skulle have været med til at udvikle næsten alle led i kæden for modelbygning, fra data og træningsopskrifter til inferens. Benchmarkene stammer fra producenten og er ikke uafhængigt verificeret. Recursive advarer selv om, at Flint kan have brug for mere vejledning end store lukkede modeller.
For virksomheder er det interessant af to grunde. For det første viser sagen, at automatiseret forskning allerede frembringer produkter, også hos små teams. For det andet kører modellen lokalt. Den, der ikke vil sende følsomme data til cloududbydere, får dermed en mulighed mere, uden at producentens oplysninger dermed er bevist. Hvordan lokale modeller passer ind i en virksomhed, viser oversigten over lokal AI i virksomheden.
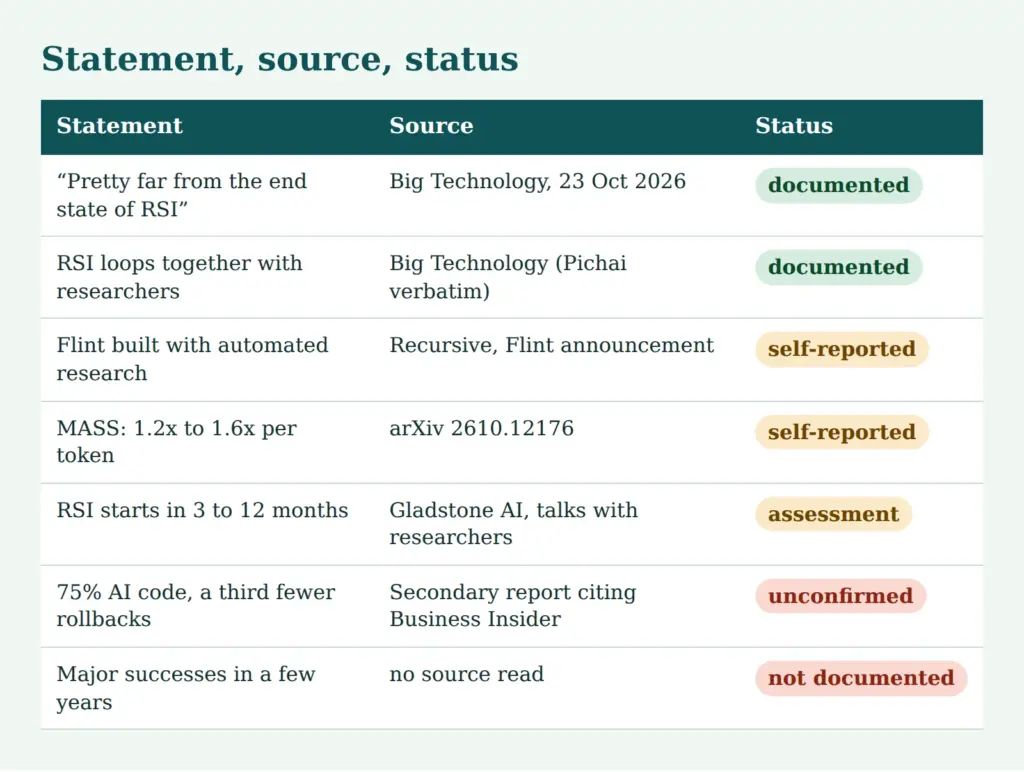
Oversigten viser, hvordan udsagnene i denne artikel skal vurderes. Dokumenteret er Pichais to sætninger i artiklens ordlyd. Tal fra producenter og forskning er egne oplysninger. Gladstone er en vurdering ud fra samtaler med forskere, ikke en måling. Kodetallet er fortsat ubekræftet, og den påståede tidsramme »om et par år« er ikke dokumenteret som et udsagn fra Pichai.
Hvad forskningen viser, og hvor den slutter
En forskningsartikel gør det håndgribeligt, hvordan sådan en løkke kan se ud. Under titlen »Recursive Self-Improvement through Multi-Agent Self-Supervision« (indsendt den 8. oktober 2026) beskrives metoden MASS. En enkelt basismodel, i artiklen Qwen3.6-27B, foreslår multiagent-workflows, udfører dem og vurderer dem selv. Derefter eftertrænes den på sine egne kørsler, og proceduren gentages.
Efter to cyklusser melder abstractet 1,2 til 1,6 gange så høj ydelse pr. output-token på fire åbne benchmarks. Desuden skulle en model, der er trænet på flere agenters kørsler, være bedre end en model, der er trænet på en enkelt agents kørsler med 40 procent flere træningsdata.
Begrænsningerne fremgår af materialet selv. Der er tale om én model og to cyklusser. Signalet for forbedringen kommer fra selvevalueringen. På de to kodningsbenchmarks Terminal-Bench 2.0 og SWE-bench Verified viser en figur i artiklen værdierne 0,96 og 0,94, altså pr. token lidt under udgangsværdien. På disse to test viste figuren altså ingen gevinst pr. token.
Forfatternes udgangspunkt passer til emnet (overordnet) »tilsyn«. De skriver, at en enkelt model har svært ved at kritisere og forbedre sine egne komplekse overvejelser, når den arbejder i en homogen løkke. Derfor satser de på flere instanser med forskellige roller. Når den samme model både genererer og vurderer, kan fælles fejl forblive uopdagede. Det er en følgeslutning af tilgangen. Artiklens formulering sigter mod metoden, ikke mod virksomheder.
Forskningen dokumenterer, at idéen kan fungere, og at kontrollen er flaskehalsen. Den dokumenterer ikke, at modeller i hverdagen forbedrer sig pålideligt uden mennesker. Det passer til Pichais sætning og modsiger den ikke.
Hvor hurtigt det kan gå: Gladstone og prognosens grænser
Forskere hos Anthropic, OpenAI og Google DeepMind forventede, at rekursiv selvforbedring ville begynde inden for de næste tre til tolv måneder, muligvis tidligere, under forudsætning af at den amerikanske regering ikke griber ind eller bremser.
De adspurgte har en egeninteresse i feltets dynamik, og forfatterne er en organisation med fokus på sikkerhedspolitik.
Automatiseret forskning kan være teknisk mulig uden at være rentabel. Gode idéer er ikke flaskehalsen, det er regnetiden til at afprøve dem. Det stemmer overens med Pichais henvisning til knap regnekraft.
Udsagnene udelukker ikke hinanden. »Begyndelse« og »slutstadie« er forskellige punkter på den samme vej. Pichai siger, at vejen er lang, og beskriver samtidig, at løkkerne kører sammen med forskere. Gladstone forventer, at en del af det snart bliver mere autonomt. Læser man begge dele, får man et billede, hvor den rekursive selvforbedring tiltager trin for trin. At basere en planlægning alene på angivelser i måneder er risikabelt, fordi de stammer fra en lille samtalerunde.
Konsekvenser for SMV'er: test modelcyklusser og modelskift
For virksomheder viser effekten sig ikke som en intelligenseksplosion, men i kalenderen og teknikken. Når agenter aflaster forskere, kan nye modelversioner udkomme oftere. For driften gælder dog uanset årsagen: Modeller ændrer sig hurtigere, end fagafdelinger tilpasser processer.
Det har praktiske konsekvenser. En model kan svare anderledes end sin forgænger på den samme prompt. Tone, format, fejltyper og omkostninger pr. opgave forskydes. Udbydere udfaser ældre versioner, nogle gange med kort varsel. Og den, der satser på aliasset »latest«, får ændringer ind i produktionen uden at spørge.
Heraf følger en enkel fremgangsmåde ved modelskift. For det første et testkorpus af rigtige opgaver, for eksempel 50 til 200 anonymiserede sager med et kendt godt svar (det kan man til dels endda generere med AI!). For det andet en sammenligningskørsel af den nye model mod den aktuelle version med uændrede prompts. For det tredje en godkendelse fra en navngiven person, der har set kvalitet, omkostninger og fejlbillede. For det fjerde en vej tilbage (rollback), altså en fast modelversion og gemt konfiguration, så man kan skifte tilbage på få minutter.
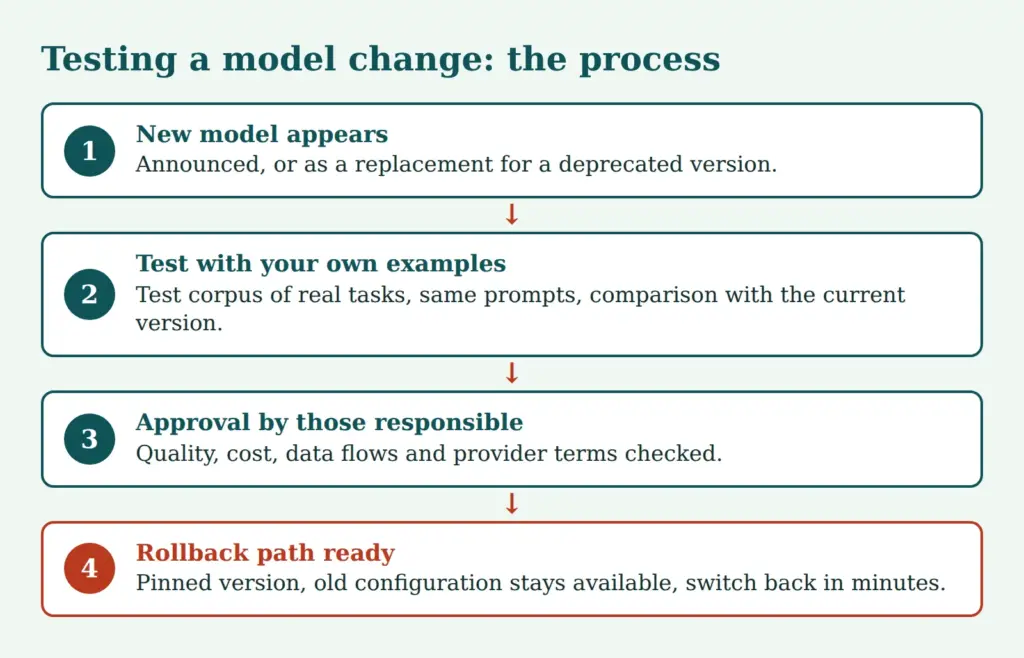
Ved skift af udbyder eller en ny model fra en eksisterende udbyder kommer databeskyttelse og kontrakt til. Det skal afklares, hvordan data flyder, hvor serverne står, hvordan databehandlingen er aftalt, og om input bruges til træning. En automatisk opgradering til den nyeste model bør ikke være tilladt i produktionen. Lokale modeller flytter spørgsmålet: De fjerner afhængigheden af udbyderen og medfører deres egen vedligeholdelse, se oversigten over lokal AI.
Små virksomheder behøver ikke at opbygge deres egen testafdeling til det. Et regneark med eksempler, et script, der sender dem gennem begge modeller, og en kort note om godkendelsen er nok som start.
Bevar tilsyn og godkendelser: Hvad der fortsat er menneskets opgave
Når udviklere i egen virksomhed bruger agenter med skriverettigheder, opstår i det små den samme løkke som hos laboratorierne: Agenten ændrer kode, test kører, agenten retter. Tilsynet kan indrettes efter samme mønster. Agenten må foreslå og teste, men en navngiven person godkender ændringer i produktionssystemer, konfigurationer og data.
Hertil hører logfiler, der gør det sporbart, hvad agenten har gjort, og rettigheder, der er så snævre som nødvendigt. Sletning, afsendelse og betaling er handlinger, der fortjener en ekstra bekræftelse. Hvilke risici en agent uden kontrol medfører, beskriver artiklen Faren bag AI-agenter.
Det er også vigtigt, hvem der kontrollerer. Når den samme model både genererer og vurderer, består de samme blinde vinkler. I driften betyder det: En AI må gerne kontrollere en anden, men kun som supplement. Den holdbare krydskontrol kommer fra test, en anden udbyder eller et menneske.
AI kontrollerer kun AI pålideligt, når krydskontrollen er uafhængig: gennem test, en anden udbyder eller et menneske.
Ansvaret ligger fortsat hos den virksomhed, der bruger agenten. Det gælder, uanset hvor meget af udviklingen der er automatiseret i baggrunden. Et udsagn om, at AI forbedrer sig selv, fritager ikke operatøren.
Tjekliste
En tjekliste skal hjælpe med at besvare spørgsmålet om, hvad der skal gøres nu, og hvad ikke:
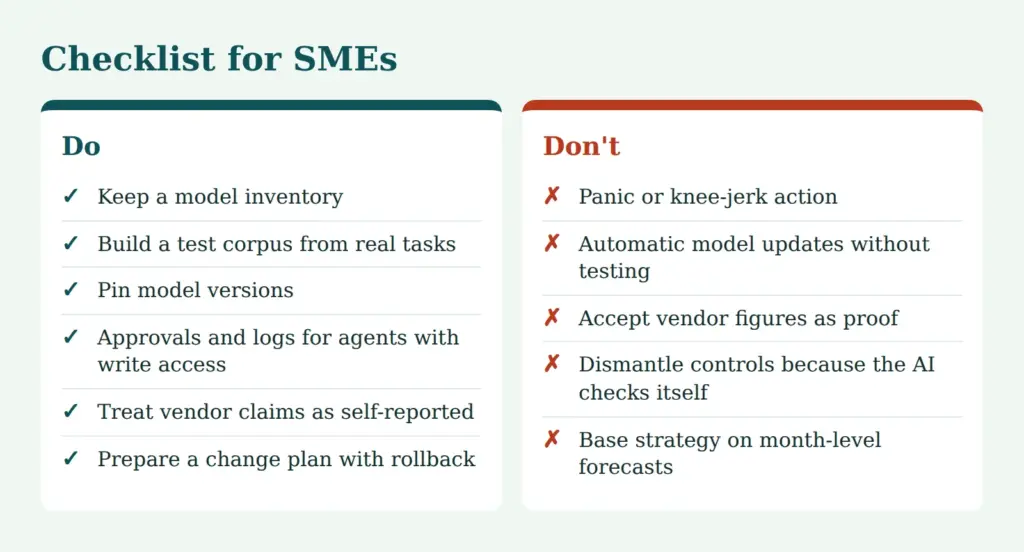
Punkterne enkeltvis:
Modelfortegnelsen registrerer, hvilke modeller der kører hvor og i hvilken version, hvem der er ansvarlig, og hvilke data der flyder. Testkorpusset vokser med hver fejl, der opdages i driften. Versioner fastlåses og ændres kun efter test. For agenter med skriverettigheder gælder godkendelser og logfiler. Producentoplysninger, hvad enten det gælder benchmarks eller AI-andele i koden, behandles som egne oplysninger og ikke som bevis.
Panik og forhastede tiltag kan ikke anbefales, for den dokumenterede situation er en delløkke med mennesker. Lige så lidt bør kontroller afvikles, fordi en AI kontrollerer sig selv. Og strategier, der bygger på månedsangivelser fra prognoser, står på et tyndt grundlag. Den, der også vil kontrollere den tekniske side, for eksempel rettigheder og systemers angrebsflade, finder et udgangspunkt i sikkerhedstjekkene på wwwschutz.de.
Konklusion
Sammenfattende kan udsagnene og den aktuelle status, der kan ændre sig dagligt, ordnes sådan.
Pichai dokumenterer, at der findes feedbackløkker med forskere, og at slutstadiet uden mennesker stadig er langt væk. Det er ingen afblæsning. En mulig læsning er, at vejen allerede er i gang, og at store fremskridt er mulige om nogle år.
For SMV'er tæller kortere modelcyklusser, test før hvert skift, faste versioner og godkendelser for agenter. Om løkken bliver markant mere autonom om tre måneder eller om tre år, ved ingen i dag med sikkerhed. Den, der mestrer test, godkendelser og rollback, er forberedt på begge tilfælde.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.