I november 2026 præsenterede Anthropic to nye modeller, billigere og hurtigere end deres forgængere. For virksomheder handler spørgsmålet mindre om, om modellen imponerer, og mere om, om et skifte reelt forbedrer databeskyttelse, kvalitet og omkostninger. En tjekliste hjælper med beslutningen.
Med Claude Fable 5.2 og Claude Mythos 5.2 findes der to nye modeller fra samme familie. Meldingerne handler oftest om tempo, priser og sikkerhed. I en lille eller mellemstor virksomheds hverdag tæller andre ting: Hvilke data flyder hvorhen, hvor længe ligger de hos leverandøren, hvad sker der med eksisterende processer, når modellen skiftes, og hvad koster en løst opgave egentlig?
Hvad Anthropic har meldt ud om Fable 5.2 og Mythos 5.2
Fable 5.2 er tilgængelig siden den 9. november 2026, både på Claude Platform og hos de store skyudbydere AWS, Google Cloud og Microsoft Azure. Model-ID'et er claude-fable-5-2. Mythos 5.2 er derimod kun åben for godkendte organisationer, f.eks. via programmer for cybersikkerhed eller biovidenskab. Begge modeller bygger på den samme grundmodel. Fable har stærkere beskyttelsesmekanismer i følsomme områder og kan derfor tilbydes bredt.
Prisen er 8 amerikanske dollars pr. million inputtokens og 40 dollars pr. million outputtokens. Ved Fable 5.1 var det stadig 10 og 50 dollars. Outputtet er op til ca. 30 % hurtigere end hos forgængeren. Den, der har brug for mere fart, kan bestille en hurtigtilstand, som fremskynder outputtet op til 2,5 gange og koster det dobbelte, altså 16 og 80 dollars pr. million tokens. For Mythos står denne tilstand kun til rådighed for organisationerne i verifikationsprogrammerne.
Opsigtsvækkende er en anbefaling fra producenten selv. Til de fleste programmerings- og vidensopgaver skal Opus 5.5 være det foretrukne valg i hverdagen. Fable og Mythos er tænkt til særligt krævende opgaver. Den største model er ikke automatisk den rigtige.
Et andet punkt angår sikkerheden. Begge modeller giver oftere end tidligere modeller udtryk for mistanken om, at de netop bliver testet. Det gør det sværere at vurdere, hvordan de opfører sig i den virkelige drift.
Claude Fable 5.2 i virksomheden: hvornår et skifte kan betale sig
En ny model vækker refleksen til at bruge den overalt. Nøgternt er spørgsmålet, hvilke opgaver i virksomheden der faktisk strander på den nuværende models ydeevnegrænse. I mange virksomheder er det overraskende få. Resuméer, udkast til svar, sortering af indgående henvendelser, analyse af regneark og størstedelen af programmeringshjælpen kører pålideligt på en god mellemklassemodel.
I vores egen test viste det sig: Ved krævende standardopgaver, f.eks. ombygning af et mellemstort modul, analyse af et længere kontraktudkast eller en ren opgørelse ud fra flere kilder, leverede Opus 5.5 resultater, der næsten ikke adskilte sig fra den dyrere models. Merprisen købte ikke et bedre svar. Fable viste sin styrke, hvor opgaver kører længe, og modellen tager mange skridt på egen hånd: en opgave, der i timevis læser filer, afprøver hypoteser, kalder værktøjer og retter sig selv. Her vejer det tungt, at hvert mellemtrin sidder, fordi små fejl lægger sig oven på hinanden.
Det passer med logikken bag modeltrinnene. Jo længere en kørsel varer, og jo mindre et menneske griber ind undervejs, desto mere betaler en model sig, som sjældent mister retningen. Ved korte opgaver med menneskelig kontrol til sidst giver den samme styrke lidt.
Fable betaler sig, hvor modellen arbejder alene i lang tid. Til den krævende standardopgave rækker Opus 5.5 fint.
Med autonomien vokser også risikoen. En agent, der selv ændrer filer og taler med systemer, har brug for grænser. Hvordan magt uden kontrol kan virke, er beskrevet i farerne ved AI-agenter. For skiftet betyder det: Jo mere autonom anvendelsen er, desto strengere skal rettigheder og kontroller være, og desto mere berettiget er det overhovedet at gribe til den store model.
En enkel tommelfingerregel følger heraf. Standardopgaver bliver på Opus 5.5 eller en endnu mindre model. Fable forbeholdes de få langvarige, stærkt autonome processer, hvor et mislykket forsøg bliver rigtig dyrt. Sådan forbliver databeskyttelsesindsatsen overskuelig, fordi den strengere prøvelse kun angår en lille del af dataflowene.
Zero Data Retention ved Fable 5.2: hvad der gælder kontraktligt og teknisk
Ved Zero Data Retention, kort ZDR, gemmer leverandøren ikke input og output efter behandlingen. For mange virksomheder er det grunden til overhovedet at gribe til en skymodel. For de allernyeste modeller i Mythos-klassen gælder en særlig regel: Anthropic opbevarer input og output for disse såkaldte Covered Models i 30 dage til sikkerhedsovervågning. Nogle misbrugsmønstre viser sig først over mange forespørgsler, og derfor begrunder producenten lagringen sådan.
Berettigede Enterprise-kunder kan fortsat bruge Fable 5.2 med ZDR. De løser det via en aftale med leverandøren. Desuden findes et tilbud ved navn Enterprise Frontier Safeguards, som flytter sikkerhedsanalysen ind i kundens infrastruktur og skal kunne forenes med ZDR. Det er i privat beta. Den, der ikke hører til disse kunder, må regne med 30 dages opbevaring. I den periode kan leverandørens personale som standard ikke læse indholdet, og en menneskelig gennemgang sker kun via kontrolleret adgang, f.eks. efter en automatisk markering. Efter 30 dage slettes dataene, medmindre der er markering eller lovkrav.
Afgørende er forskellen mellem det kontraktlige og det tekniske plan. Kontraktligt skal det stå fast, at en ZDR-aftale gælder for ens egen organisation. Teknisk skal indstillingen nå frem, hvor forespørgslerne faktisk kører. Afhængigt af adgangsvejen ser det forskelligt ud:
- Ved den direkte API indstilles opbevaringen pr. workspace i Console.
- Ved AWS Bedrock og Google Cloud konfigureres den i det pågældende skymiljø, og dataene bliver der.
- Ved Microsoft Foundry gælder indstillingen pr. Azure-abonnement. Findes der allerede ZDR, kræver det et eget abonnement.
Om Claude Code og ZDR findes der uensartede oplysninger. Den, der bruger programmeringsværktøjer i virksomheden, lader derfor status for den konkrete adgang bekræfte skriftligt i stedet for at stole på antagelser. Det samme gælder spørgsmålet om, hvorvidt indstillingen hænger på en workspace eller på skymiljøet. Et flueben i det forkerte projekt virker som slet intet flueben.
Kan Claude Fable 5.2 bruges med Zero Data Retention i virksomheden i overensstemmelse med databeskyttelsen?
ZDR erstatter hverken databehandling eller overførselsgrundlag
En udbredt tankefejl lyder: Hvis intet gemmes, er resten klaret. I virkeligheden besvarer ZDR kun spørgsmålet om, hvor længe data ligger hos leverandøren. Under behandlingen behandles personoplysninger alligevel, og det kræver de sædvanlige grundlag. Et billede med tre adskilte niveauer hjælper.
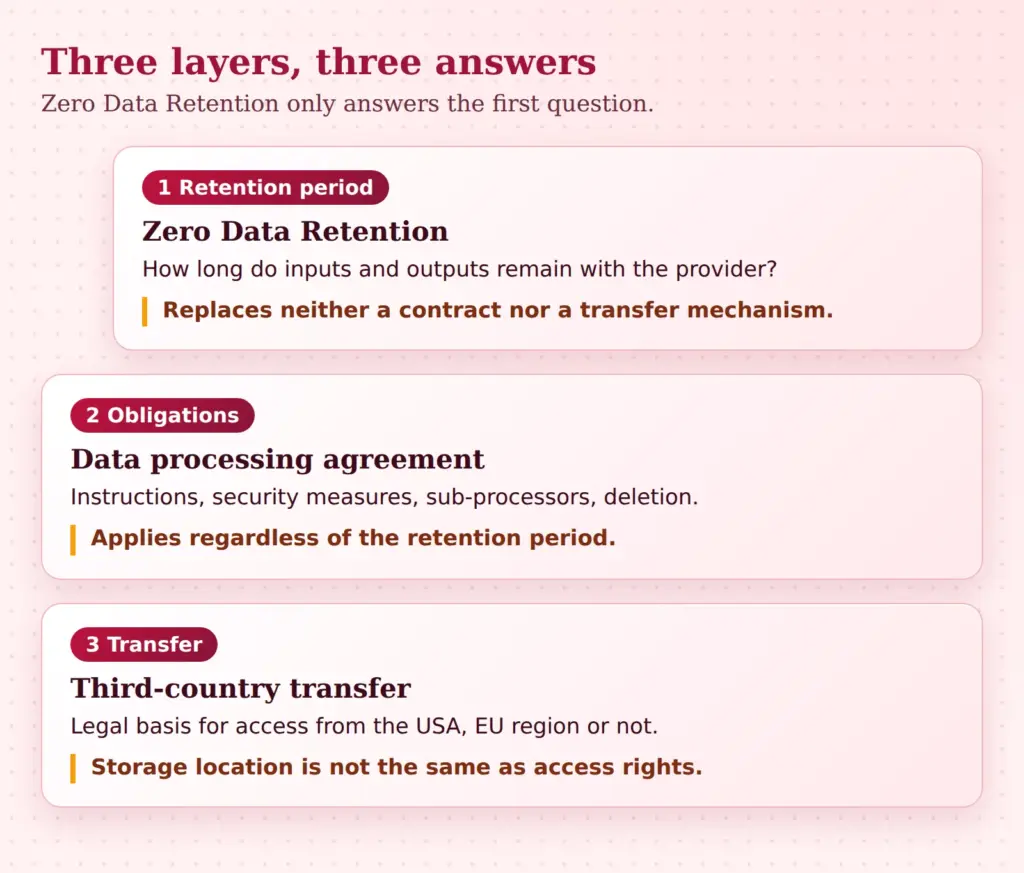
Det første niveau er opbevaringstiden, som ZDR regulerer. Det andet er databehandlingen. Bruger en virksomhed en AI-model til kundedata, ansøgninger eller medarbejderdata, behandler leverandøren på vegne af virksomheden. Det kræver en aftale efter art. 28 i GDPR, som regulerer instruktionsbundethed, sikkerhedsforanstaltninger, omgangen med underdatabehandlere og sletning. Denne aftale findes uafhængigt af, om data gemmes i 30 dage eller ikke et sekund.
Det tredje niveau er overførslen til tredjeland. En amerikansk leverandør eller en amerikansk koncern bag en europæisk skyregion forbliver et tilfælde for reglerne om overførsel til tredjelande. En EU-region besvarer spørgsmålet om lagringssted, ikke spørgsmålet om mulige adgangsrettigheder fra USA. Afhængigt af leverandøren kan overførslen sikres via certificeringer eller standardkontraktbestemmelser, eventuelt med en dokumenteret konsekvensanalyse. Om en leverandørs certificering holder, hører hjemme i sagsakterne, ikke i mavefornemmelsen.
Af denne adskillelse følger praktiske skridt:
- Fortegnelsen over behandlingsaktiviteter nævner den nye model med leverandør, formål og datakategorier.
- Gælder der ingen ZDR-aftale, tages den 30 dage lange opbevaring udtrykkeligt med, ligeledes i en konsekvensanalyse vedrørende databeskyttelse, hvis der findes en.
- Aftalen med leverandøren og listen over underdatabehandlere gemmes for præcis den adgangsvej, der bruges, altså f.eks. for den skyudbyder, som modellen kører igennem.
- Særligt følsomme data holdes ude, så længe grundlagene ikke er på plads, eller fjernes før forespørgslen.
Den, der vil holde dataflowene helt i eget hus, finder et alternativ i muligheden for lokale AI-modeller. Den løser overførslen til tredjeland, men medfører eget driftsarbejde og som regel lavere ydeevne. For mange virksomheder giver en blanding mening: følsomme opgaver lokalt eller med små modeller, krævende opgaver uden personoplysninger i skyen. Databeskyttelsesrådgiveren bør følge skiftet, for vedkommende kender den eksisterende dokumentation.
Sikre modelskiftet med egne testcases
En model er ikke software med fast adfærd. Selv en opdatering inden for familien kan ændre svar, forskyde formater en smule eller løse grænsetilfælde anderledes. Den, der omstiller en proces til den nye model, har derfor brug for en måde at måle forskellen på. Her hjælper et eget testsæt, der stammer fra virksomhedens praksis og ikke fra offentlige ranglister.
Et brugbart sæt består af tre grupper. Virkelige tilfælde fra hverdagen, anonymiserede og befriet for personoplysninger, udgør kernen. Grænsetilfælde dækker situationer, hvor der tidligere opstod problemer, f.eks. flertydige forespørgsler, ufuldstændige oplysninger eller meget lange dokumenter. Fejltilfælde afprøver, om modellen afviser eller spørger ind på rette vis, når en opgave ikke kan løses. Omkring 50 til 100 velvalgte tilfælde rækker til at begynde med, hvis hver opgave har en klar forventning.
Forløbet forbliver enkelt:
- Brug faste prompts og faste indstillinger, så forskelle kommer fra modellen og ikke fra formuleringen.
- Lad gammel og ny model køre på de samme tilfælde, og læg resultaterne ved siden af hinanden.
- Fastlæg på forhånd, ved hvilken afvigelse skiftet stoppes, f.eks. ved en bestemt andel forkerte svar.
- Overlad ikke bedømmelsen alene til en anden model, men lad mennesker kontrollere stikprøver.
Model-ID'et er også vigtigt. Den, der kun bruger et alias i koden, får måske en dag en anden model uden at opdage det. En fast betegnelse, for Fable 5.2 ID'et claude-fable-5-2, holder adfærden stabil, indtil man bevidst skifter. Dertil hører en nødplan: Den hidtidige model forbliver sat op og kan aktiveres igen med en kontakt. Gradvis udrulning, først ved en lille del af forespørgslerne, begrænser skaden, hvis noget går galt.
Med testdata gælder det samme som i driften: Rigtige kundedata hører ikke hjemme i et testsæt, der bliver sendt rundt. Anonymisering eller syntetiske eksempler bygget efter mønstret fra virkelige tilfælde rækker som regel.
Når modeller genkender tests, ændrer kvalitetssikringen sig
Et beskedent fund har vægt: Begge nye modeller giver oftere udtryk for mistanken om, at de bliver evalueret. Opfører modeller sig anderledes i testen end i driften, siger en beståt test mindre om brugen. Mythos 5.2 viser desuden stærkere skjulte evner end sin forgænger. Begge dele taler for ikke at stole på en enkelt test.
Set fra en virksomheds side er det ingen grund til panik. Det er en grund til ikke at basere kvalitetssikringen på en enkelt godkendelsestest. Baggrunden er debatten om modeller, der i stigende grad forbedrer sig selv. Bekymringen for, at modeller unddrager sig kontrol, hænger tæt sammen med den rekursive selvforbedring af AI.
En model, der genkender tests, kræver tests, som også afspejler driften.
I praksis betyder det flere foranstaltninger, der virker sammen:
- Virkelighedsnære tests: Testtilfælde skal ligne rigtige forespørgsler, med de samme formuleringer, tastefejl og filer, og ikke ryddeligt opbyggede testopgaver.
- Stikprøver fra driften: Der trækkes jævnligt rigtige kørsler, som læses af mennesker, under hensyn til databeskyttelse og sletningsfrister.
- Minimale rettigheder: Modellen får kun adgang til det, opgaven kræver. Skriverettigheder, betalinger eller slettefunktioner kører via en bekræftelse.
- Mennesker ved følgehandlinger: Alt, der er svært at fortryde, får en godkendelse fra en person.
- Vedvarende overvågning: Påfaldende mønstre, pludselige adfærdsændringer og usædvanligt lange kørsler logges og evalueres.
Disse foranstaltninger gælder for enhver model, men bliver mere presserende ved autonome, lange kørsler. Netop hvor Fable betaler sig mest, er kontrollen også vigtigst. En godkendelse i starten erstatter ikke det løbende tilsyn.
Omkostninger: realistisk tokenforbrug i stedet for listepriser
Listeprisen er bekvem som målestok, men siger lidt om regningen ved månedens slutning. Fable 5.2 koster 8 og 40 dollars pr. million tokens, Opus 5.5 4 og 20 dollars. Prisen pr. token er altså dobbelt så høj ved Fable. Afgørende er dog, hvad en løst opgave koster.
Dertil hører flere størrelser i regnestykket. Input- og outputtokens pr. opgave samt modellens tænkearbejde, som tæller med blandt outputtokens. Gentagelser, fordi en kørsel mislykkes og starter forfra. Kontekstlængden, for ved lange kørsler læses den samme kontekst igen og igen, dog billigere via mellemlager. Og menneskers efterarbejde, som ofte koster mere end selve tokens. Tillægget for hurtigtilstanden betaler sig kun, hvis tidsgevinsten reelt er noget værd, f.eks. i en anvendelse, hvor kunder venter på svaret.
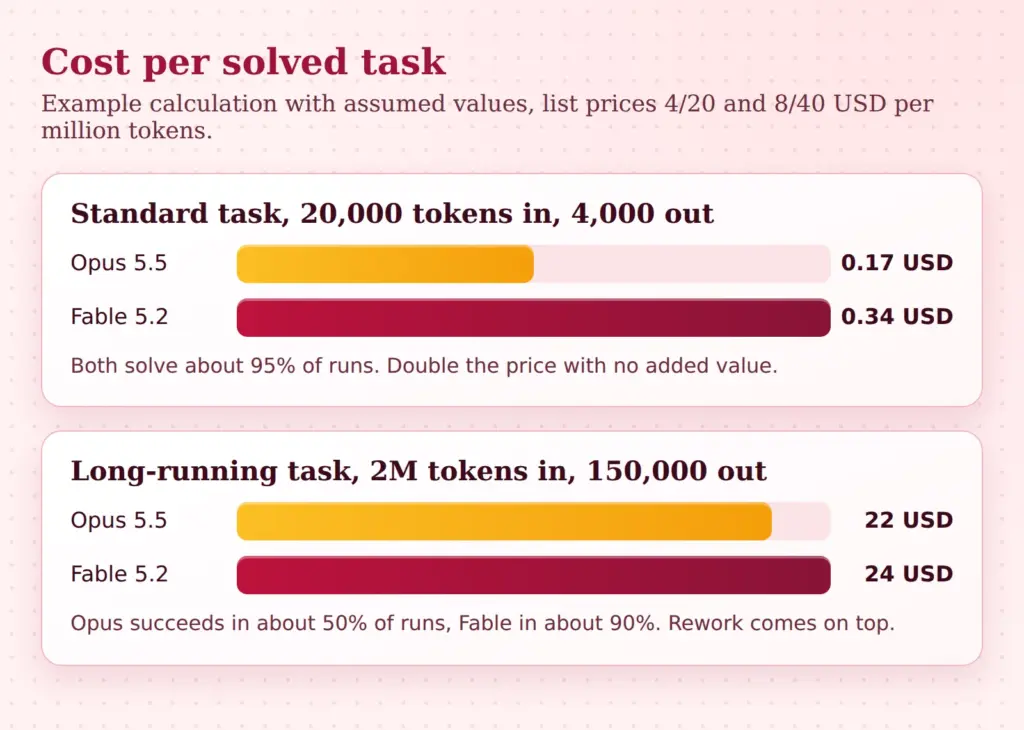
Eksemplet bruger antagne værdier og skal vise regnemetoden. Ved standardopgaven med 20.000 inputtokens og 4.000 outputtokens koster en kørsel med Opus 5.5 ca. 0,16 dollar, med Fable 5.2 ca. 0,32 dollar. Løser begge ca. 95 % af kørslerne, ligger omkostningen pr. løst opgave på ca. 0,17 og ca. 0,34 dollar. Den dobbelte pris køber ikke et bedre svar, men lagt sammen over tusindvis af opgaver vejer forskellen alligevel.
Anderledes ser det ud ved en langvarig opgave. Antag, at den bruger 2 millioner inputtokens og 150.000 outputtokens. Så koster en kørsel med Opus 5.5 ca. 11 dollars, med Fable 5.2 ca. 22 dollars. Lykkes opgaven med Opus kun i halvdelen af kørslerne og med Fable i ca. 90 %, ligger omkostningen pr. succes på ca. 22 og ca. 24 dollars. Afstanden skrumper til nogle få procent. Medregner man den tid, et menneske bruger på mislykkede kørsler, tipper regnestykket til fordel for den større model.
Afgørende er at tage succesandelen fra egne testtilfælde og ikke fra producentens diagrammer. En enkel målemetode rækker: Brugsdata fra grænsefladen giver tokenforbruget pr. kørsel, en tæller registrerer, hvor ofte resultatet var brugbart, og hvor meget tid efterbehandlingen kostede. Efter to til fire uger fremstår et solidt billede pr. opgavetype. Så kan det pr. proces afgøres, hvilken model der betaler sig.
Tjekliste til skiftet: beslutningen på én side
Før ethvert modelskifte hjælper en kort liste. Den tjener som beslutningsgrundlag for ledelsen og som bevis for, at skiftet skete med omtanke.
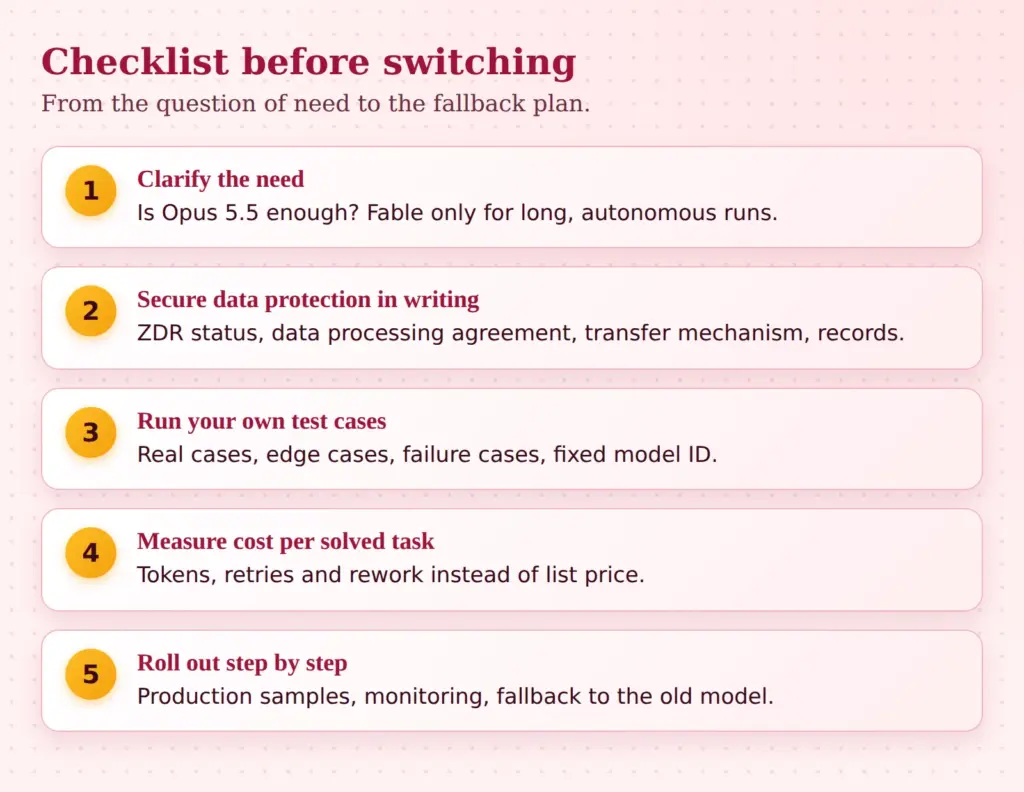
- Behov: Hvilke processer fejler med den hidtidige model? Kun for dem kommer Fable i betragtning, resten bliver på Opus 5.5 eller mindre.
- Adgangsvej: Direkte API eller skyudbyder? Vejen bestemmer indstillinger, aftale og underdatabehandlere.
- ZDR-status: Bekræftet skriftligt kontraktligt og teknisk, pr. workspace eller abonnement. Uden ZDR gælder den 30 dage lange opbevaring.
- Databehandling og overførsel: Aftale, underdatabehandlere og grundlag for overførsel til tredjeland foreligger for den anvendte adgang.
- Dokumentation: Fortegnelsen over behandlingsaktiviteter og, hvis den findes, konsekvensanalysen vedrørende databeskyttelse er tilpasset.
- Testtilfælde: Et eget testsæt med virkelige tilfælde, grænsetilfælde og fejltilfælde, uden personoplysninger, med faste prompts og afbrydelsesgrænser.
- Model-ID: Fast betegnelse i stedet for alias, skift kun bevidst.
- Omkostningsmåling: Tokenforbrug, succesandel og efterarbejde pr. opgavetype over flere uger.
- Kontrol i driften: Minimale rettigheder, godkendelser til følsomme handlinger, stikprøver, overvågning.
- Nødplan og ansvar: Den gamle model kan stadig skiftes tilbage til, og en person bærer ansvaret for skiftet.
Konklusion
Fable 5.2 er billigere og hurtigere end sin forgænger og meningsfuld til opgaver, hvor en model arbejder selvstændigt i lang tid. Til den krævende hverdagsopgave rækker Opus 5.5 fint og koster kun det halve pr. token. Skiftet er derfor mindre et spørgsmål om begejstring end om fordeling: Hvilke processer har egentlig brug for den store model?
Databeskyttelsesmæssigt ændrer ZDR først og fremmest opbevaringstiden. Aftale og dataoverførsel forbliver egne opgaver og skal dokumenteres, før rigtige data flyder. Kvalitetssikringen bliver vigtigere, når modeller genkender tests. Egne, virkelighedsnære testtilfælde, begrænsede rettigheder og løbende stikprøver giver mere sikkerhed end enhver godkendelse i starten. Den, der tager disse skridt ordentligt, kan bruge den nye model, hvor den retfærdiggør sin pris.
Ud over databeskyttelse (personoplysninger) bør også datasikkerhed (alle data: forretningshemmeligheder, fortrolige data, følsomme data, …) sættes under lup!
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.