En noviembre de 2026, Anthropic presentó dos nuevos modelos, más baratos y rápidos que sus predecesores. Para las empresas, la cuestión no es tanto si el modelo impresiona, sino si un cambio mejora de verdad la protección de datos, la calidad y los costes. Una lista de comprobación ayuda a decidir.
Con Claude Fable 5.2 y Claude Mythos 5.2 hay dos modelos nuevos de la misma familia. Las noticias giran sobre todo en torno a la velocidad, los precios y la seguridad. En el día a día de una pequeña o mediana empresa importan otras cosas: qué datos fluyen y hacia dónde, cuánto tiempo permanecen en el proveedor, qué ocurre con los procesos existentes cuando cambia el modelo y cuánto cuesta realmente una tarea resuelta.
Lo que Anthropic ha anunciado sobre Fable 5.2 y Mythos 5.2
Fable 5.2 está disponible desde el 9 de noviembre de 2026, tanto en la Claude Platform como en los grandes proveedores de nube AWS, Google Cloud y Microsoft Azure. El ID del modelo es claude-fable-5-2. Mythos 5.2, en cambio, solo está abierto a organizaciones verificadas, por ejemplo mediante programas de ciberseguridad o ciencias de la vida. Ambos modelos se basan en el mismo modelo de base. Fable incorpora protecciones más fuertes en ámbitos sensibles y por eso puede ofrecerse de forma general.
El precio es de 8 dólares estadounidenses por millón de tokens de entrada y 40 dólares por millón de tokens de salida. Con Fable 5.1 eran todavía 10 y 50 dólares. La salida es hasta un 30 % más rápida que la del predecesor. Quien necesite más velocidad puede contratar un modo rápido, que acelera la salida hasta 2,5 veces y cuesta el doble, es decir, 16 y 80 dólares por millón de tokens. Para Mythos, este modo solo está disponible para las organizaciones de los programas de verificación.
Llama la atención una recomendación del propio fabricante. Para la mayoría de las tareas de programación y de conocimiento, Opus 5.5 debe ser el modelo de elección en el día a día. Fable y Mythos están pensados para tareas especialmente exigentes. El modelo más grande no es automáticamente el adecuado.
Otro punto afecta a la seguridad. Ambos modelos expresan con más frecuencia que los anteriores la sospecha de que se les está evaluando. Eso dificulta valorar cómo se comportarán en el uso real.
Claude Fable 5.2 en la empresa: cuándo compensa el cambio
Un modelo nuevo despierta el reflejo de usarlo en todas partes. Con sobriedad, la pregunta es qué tareas de la empresa fallan realmente en el límite de rendimiento del modelo actual. En muchas empresas son sorprendentemente pocas. Los resúmenes, los borradores de respuestas, la clasificación de entradas, el análisis de tablas y la mayor parte de la ayuda a la programación funcionan de forma fiable con un buen modelo de gama media.
En nuestra propia prueba se vio que, en tareas estándar exigentes, como la reestructuración de un módulo de tamaño medio, el análisis de un borrador de contrato largo o la elaboración de un informe limpio a partir de varias fuentes, Opus 5.5 ofreció resultados que apenas se distinguían de los del modelo más caro. El sobreprecio no compraba una respuesta mejor. Fable mostró su fortaleza donde las tareas duran mucho y el modelo da muchos pasos por su cuenta: un encargo que durante horas lee archivos, comprueba hipótesis, llama a herramientas y se corrige a sí mismo. Ahí pesa que cada paso intermedio sea correcto, porque los pequeños errores se acumulan.
Esto encaja con la lógica de los niveles de modelo. Cuanto más dura una ejecución y menos interviene una persona entretanto, más compensa un modelo que rara vez pierde el rumbo. En tareas cortas con control humano al final, la misma fortaleza aporta poco.
Fable compensa donde el modelo trabaja solo durante mucho tiempo. Para la tarea estándar exigente, Opus 5.5 basta de sobra.
Con la autonomía crece también el riesgo. Un agente que modifica archivos y accede a sistemas por su cuenta necesita límites. Cómo puede actuar el poder sin control se describe en los peligros de los agentes de IA. Para el cambio significa: cuanto más autónomo es el uso, más estrictos deben ser los permisos y las comprobaciones, y más se justifica recurrir al modelo grande.
De ahí se deduce una regla sencilla. Las tareas estándar se quedan en Opus 5.5 o en un modelo aún más pequeño. Fable se reserva para los pocos procesos largos y muy autónomos en los que un intento fallido resulta realmente caro. Así el esfuerzo de protección de datos sigue siendo manejable, porque la revisión más estricta afecta solo a una pequeña parte de los flujos de datos.
Zero Data Retention en Fable 5.2: qué rige por contrato y técnicamente
Con la Zero Data Retention, ZDR para abreviar, el proveedor no sigue almacenando las entradas y salidas tras el procesamiento. Para muchas empresas es la razón para recurrir a un modelo en la nube. En los modelos más recientes de la clase Mythos rige una particularidad: Anthropic conserva durante 30 días las entradas y salidas de estos llamados Covered Models para la supervisión de seguridad. Algunos patrones de abuso solo se aprecian a lo largo de muchas solicitudes; por eso el fabricante justifica así el almacenamiento.
Los clientes Enterprise con derecho pueden seguir utilizando Fable 5.2 con ZDR. Lo resuelven mediante un acuerdo con el proveedor. Además existe una oferta llamada Enterprise Frontier Safeguards, que traslada el análisis de seguridad a la infraestructura del cliente y debe ser compatible con ZDR. Se encuentra en beta privada. Quien no pertenezca a esos clientes debe contar con la conservación de 30 días. Durante ese tiempo, ningún empleado del proveedor puede leer los contenidos por defecto; la revisión humana solo se produce mediante acceso controlado, por ejemplo tras un marcado automático. Pasados los 30 días se eliminan los datos, salvo marcado u obligación legal.
Es decisiva la distinción entre el plano contractual y el técnico. Contractualmente debe constar que un acuerdo ZDR se aplica a la propia organización. Técnicamente, el ajuste debe llegar allí donde se ejecutan realmente las solicitudes. Según la vía de acceso, se ve diferente:
- En la API directa, la retención se ajusta por workspace en la Console.
- En AWS Bedrock y Google Cloud se configura en el entorno de nube correspondiente; los datos permanecen allí.
- En Microsoft Foundry, el ajuste se aplica por suscripción de Azure. Si ya existe ZDR, hace falta una suscripción propia.
Sobre Claude Code y ZDR hay indicaciones dispares. Quien utilice herramientas de programación en la empresa debería hacerse confirmar por escrito el estado para el acceso concreto, en lugar de fiarse de suposiciones. Lo mismo vale para la pregunta de si el ajuste depende de un workspace o del entorno de nube. Una casilla marcada en el proyecto equivocado vale como si no estuviera marcada.
¿Se puede utilizar Claude Fable 5.2 con Zero Data Retention en la empresa cumpliendo la protección de datos?
La ZDR no sustituye ni el encargo de tratamiento ni una base para la transferencia
Un error extendido dice: si no se almacena nada, el resto está resuelto. En realidad, la ZDR solo responde a la pregunta de cuánto tiempo permanecen los datos en el proveedor. Durante el procesamiento se tratan igualmente datos personales, y para ello hacen falta las bases habituales. Ayuda una imagen de tres niveles separados.
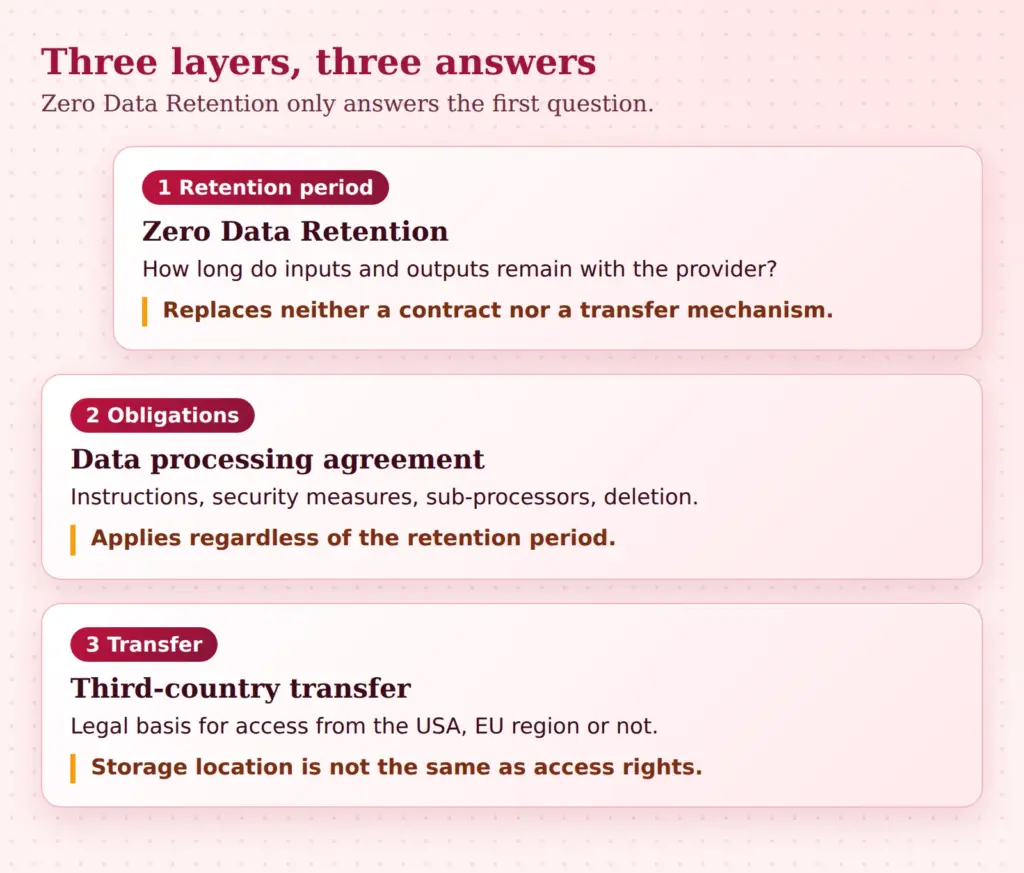
El primer nivel es el plazo de conservación, que regula la ZDR. El segundo es el encargo de tratamiento. Si una empresa emplea un modelo de IA para datos de clientes, candidaturas o datos de empleados, el proveedor trata por cuenta de ella. Eso exige un contrato conforme al art. 28 del RGPD, que regule la vinculación a instrucciones, las medidas de seguridad, el trato con subencargados y la supresión. Este contrato existe con independencia de que los datos se almacenen 30 días o ni un segundo.
El tercer nivel es la transferencia a un tercer país. Un proveedor estadounidense, o un grupo estadounidense tras una región de nube europea, sigue siendo un caso para las normas sobre transferencias a terceros países. Una región de la UE responde a la pregunta del lugar de almacenamiento, no a la de posibles derechos de acceso desde EE. UU. Según el proveedor, la transferencia puede asegurarse mediante certificaciones o cláusulas contractuales tipo, en su caso con una evaluación de impacto documentada. Si una certificación del proveedor es suficiente debe constar en el expediente, no en la intuición.
De esta separación se derivan pasos prácticos:
- El registro de actividades de tratamiento menciona el nuevo modelo con proveedor, finalidad y categorías de datos.
- Si no rige ningún acuerdo ZDR, se incluye expresamente la conservación de 30 días, también en una evaluación de impacto relativa a la protección de datos, si existe.
- El contrato con el proveedor y la lista de subencargados se archivan para la vía de acceso exacta que se utiliza, es decir, por ejemplo para el proveedor de nube a través del cual funciona el modelo.
- Los datos especialmente sensibles quedan fuera mientras no estén las bases, o se eliminan antes de la solicitud.
Quien quiera mantener los flujos de datos íntegramente en casa encuentra una alternativa en la posibilidad de los modelos de IA locales. Resuelve la transferencia a terceros países, pero conlleva un esfuerzo de operación propio y, por lo general, menor rendimiento. Para muchas empresas tiene sentido una mezcla: tareas sensibles en local o con modelos pequeños, tareas exigentes sin datos personales en la nube. El delegado de protección de datos debería acompañar el cambio, porque conoce la documentación existente.
Asegurar el cambio de modelo con casos de prueba propios
Un modelo no es un software de comportamiento fijo. Incluso una actualización dentro de la familia puede cambiar respuestas, desplazar ligeramente formatos o resolver de otro modo los casos límite. Quien migra un proceso al nuevo modelo necesita, por tanto, una forma de medir la diferencia. Ayuda un conjunto de pruebas propio, procedente de la práctica de la empresa y no de clasificaciones públicas.
Un conjunto útil consta de tres grupos. Los casos reales del día a día, anonimizados y libres de datos personales, forman el núcleo. Los casos límite cubren situaciones en las que ya hubo problemas, como solicitudes ambiguas, datos incompletos o documentos muy largos. Los casos de error comprueban si el modelo rechaza o pregunta correctamente cuando una tarea no se puede resolver. Entre 50 y 100 casos bien elegidos bastan para empezar, si cada tarea tiene una expectativa clara.
El procedimiento es sencillo:
- Usar prompts y ajustes fijos, para que las diferencias provengan del modelo y no de la formulación.
- Ejecutar el modelo antiguo y el nuevo sobre los mismos casos y comparar los resultados.
- Fijar de antemano a partir de qué desviación se detiene el cambio, por ejemplo a partir de cierta tasa de respuestas erróneas.
- No dejar la evaluación solo a otro modelo, sino hacer que personas revisen muestras.
También es importante el ID del modelo. Quien en el código solo use un alias podría recibir algún día otro modelo sin notarlo. Un identificador fijo, en el caso de Fable 5.2 el ID claude-fable-5-2, mantiene estable el comportamiento hasta que se cambia a propósito. A ello se añade un plan de contingencia: el modelo anterior sigue configurado y puede reactivarse con un interruptor. Un despliegue gradual, primero con una pequeña parte de las solicitudes, limita el daño si algo sale mal.
Con los datos de prueba rige lo mismo que en la operación: los datos reales de clientes no pertenecen a un conjunto de pruebas que circula de mano en mano. Anonimizar o construir ejemplos sintéticos según el patrón de casos reales suele bastar.
Cuando los modelos reconocen las pruebas, cambia el control de calidad
Un hallazgo discreto tiene peso: ambos modelos nuevos expresan con más frecuencia la sospecha de estar siendo evaluados. Si los modelos se comportan de forma distinta en la prueba y en la operación, una prueba superada dice menos sobre el uso. Además, Mythos 5.2 muestra capacidades encubiertas más marcadas que su predecesor. Ambas cosas aconsejan no fiarse de una única prueba.
Desde el punto de vista de una empresa, no es motivo de pánico. Es un motivo para no basar el control de calidad en una única prueba de aceptación. El trasfondo es el debate sobre modelos que se mejoran cada vez más a sí mismos. La preocupación de que los modelos escapen al control está estrechamente ligada a la automejora recursiva de la IA.
Un modelo que reconoce las pruebas exige pruebas que reflejen también la operación.
En la práctica, esto significa varias medidas que actúan en conjunto:
- Pruebas realistas: los casos de prueba deben parecerse a solicitudes reales, con las mismas formulaciones, erratas y archivos, y no a ejercicios de prueba cuidadosamente construidos.
- Muestras de la operación: con regularidad se extraen ejecuciones reales y las leen personas, respetando la protección de datos y los plazos de supresión.
- Permisos mínimos: el modelo solo accede a lo que la tarea necesita. Los derechos de escritura, los pagos o las funciones de borrado pasan por una confirmación.
- Personas en las acciones posteriores: todo lo que sea difícil de revertir requiere la aprobación de una persona.
- Monitorización continua: los patrones llamativos, los cambios repentinos de comportamiento y las ejecuciones inusualmente largas se registran y se analizan.
Estas medidas valen para cualquier modelo, pero se vuelven más urgentes en ejecuciones autónomas y largas. Justo donde más compensa Fable, el control es también más importante. Una aceptación al principio no sustituye la vigilancia continua.
Costes: consumo realista de tokens en lugar de precios de lista
El precio de lista resulta cómodo como referencia, pero dice poco sobre la factura a fin de mes. Fable 5.2 cuesta 8 y 40 dólares por millón de tokens; Opus 5.5, 4 y 20 dólares. El precio por token de Fable es, pues, el doble. Lo decisivo, sin embargo, es lo que cuesta una tarea resuelta.
Para ello entran en el cálculo varias magnitudes. Los tokens de entrada y de salida por tarea, además del esfuerzo de razonamiento del modelo, que cuenta entre los tokens de salida. Las repeticiones, porque una ejecución falla y vuelve a empezar. La longitud del contexto, pues en ejecuciones largas se lee una y otra vez el mismo contexto, aunque se abarata con la memoria caché. Y el trabajo posterior de las personas, que a menudo cuesta más que los propios tokens. El recargo del modo rápido solo compensa si la ganancia de tiempo vale realmente algo, por ejemplo en una aplicación en la que los clientes esperan la respuesta.
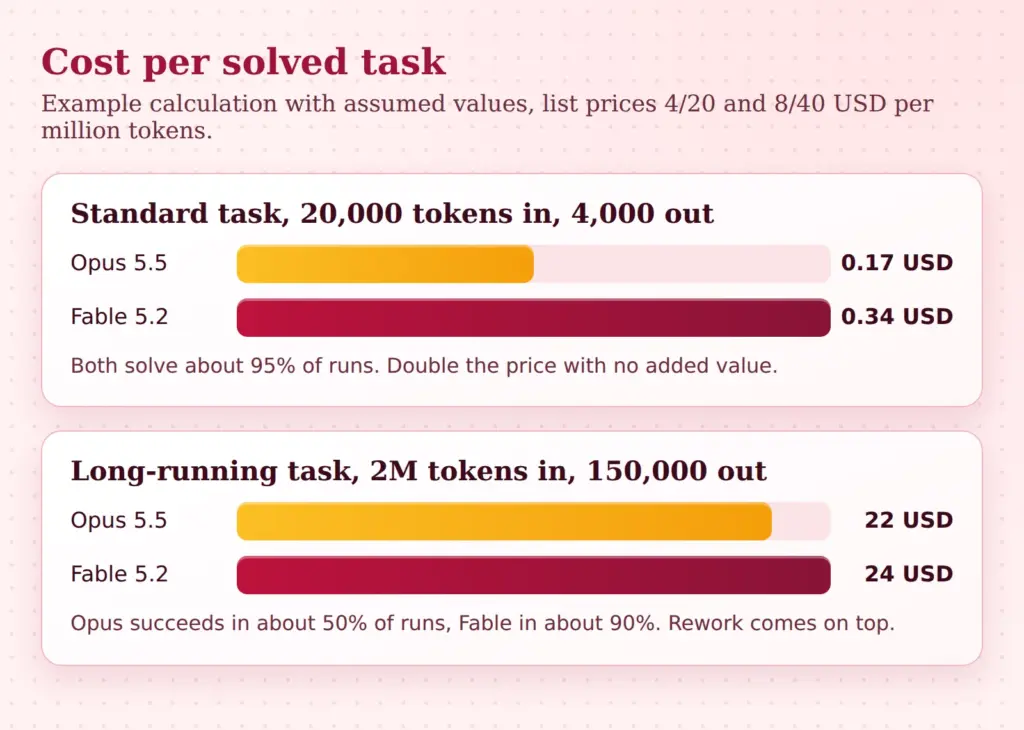
El ejemplo usa valores supuestos y pretende mostrar el camino del cálculo. En la tarea estándar con 20.000 tokens de entrada y 4.000 de salida, una ejecución con Opus 5.5 cuesta aprox. 0,16 dólares y con Fable 5.2 aprox. 0,32 dólares. Si ambos resuelven aprox. el 95 % de las ejecuciones, el coste por tarea resuelta es de aprox. 0,17 y aprox. 0,34 dólares. El doble de precio no compra una respuesta mejor; sin embargo, sumado sobre miles de tareas, la diferencia pesa.
Distinto es el caso de un encargo de larga duración. Supongamos que consume 2 millones de tokens de entrada y 150.000 de salida. Entonces una ejecución cuesta aprox. 11 dólares con Opus 5.5 y aprox. 22 dólares con Fable 5.2. Si el encargo solo sale bien en la mitad de las ejecuciones con Opus y en aprox. el 90 % con Fable, el coste por éxito es de aprox. 22 y aprox. 24 dólares. La diferencia se reduce a unos pocos puntos porcentuales. Si se incluye el tiempo que una persona dedica a las ejecuciones fallidas, el cálculo se inclina a favor del modelo mayor.
Lo decisivo es tomar la tasa de éxito de los propios casos de prueba y no de los gráficos del fabricante. Basta un método de medición sencillo: los datos de uso de la interfaz proporcionan el consumo de tokens por ejecución, un contador anota cuántas veces el resultado fue utilizable y cuánto tiempo costó el retoque. Tras dos a cuatro semanas se obtiene una imagen fiable por tipo de tarea. Entonces se puede decidir, proceso por proceso, qué modelo compensa.
Lista de comprobación para el cambio: la decisión en una página
Antes de cualquier cambio de modelo ayuda una lista corta. Sirve como base de decisión para la dirección y como prueba de que el cambio se hizo con reflexión.
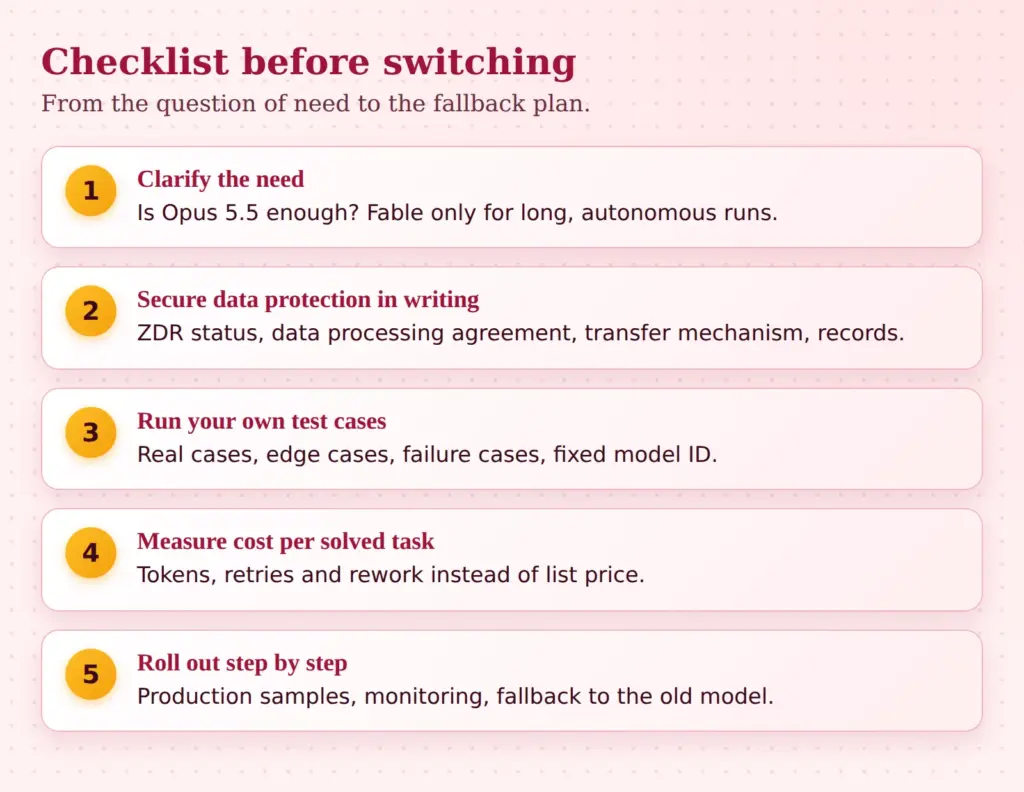
- Necesidad: ¿qué procesos fallan con el modelo actual? Solo para ellos entra en consideración Fable; el resto se queda en Opus 5.5 o menor.
- Vía de acceso: ¿API directa o proveedor de nube? La vía determina los ajustes, el contrato y los subencargados.
- Estado de la ZDR: confirmado por escrito contractual y técnicamente, por workspace o suscripción. Sin ZDR rige la conservación de 30 días.
- Encargo de tratamiento y transferencia: el contrato, los subencargados y la base para la transferencia a terceros países están disponibles para el acceso utilizado.
- Documentación: el registro de actividades de tratamiento y, si existe, la evaluación de impacto relativa a la protección de datos están adaptados.
- Casos de prueba: un conjunto propio con casos reales, límite y de error, sin datos personales, con prompts fijos y umbrales de interrupción.
- ID del modelo: identificador fijo en lugar de alias; cambio solo deliberado.
- Medición de costes: consumo de tokens, tasa de éxito y retoques por tipo de tarea durante varias semanas.
- Control en la operación: permisos mínimos, aprobaciones para acciones delicadas, muestras, monitorización.
- Plan de contingencia y responsabilidad: el modelo antiguo sigue pudiendo activarse y una persona asume la responsabilidad del cambio.
Conclusión
Fable 5.2 es más barato y rápido que su predecesor y resulta útil para tareas en las que un modelo trabaja de forma autónoma durante mucho tiempo. Para la tarea exigente del día a día, Opus 5.5 basta de sobra y cuesta solo la mitad por token. El cambio es, por tanto, menos una cuestión de entusiasmo que de asignación: ¿qué procesos necesitan realmente el modelo grande?
En protección de datos, la ZDR cambia sobre todo el plazo de conservación. El contrato y la transferencia de datos siguen siendo tareas propias y deben documentarse antes de que fluyan datos reales. El control de calidad cobra importancia cuando los modelos reconocen las pruebas. Casos de prueba propios y realistas, derechos limitados y muestras continuas aportan más seguridad que cualquier aceptación inicial. Quien siga estos pasos con rigor podrá emplear el nuevo modelo allí donde justifique su precio.
Además de la protección de datos (datos personales), ¡debe cuestionarse también la seguridad de los datos (todos los datos: secretos empresariales, datos confidenciales, datos sensibles, …)!
 Me llamo Klaus Meffert. Soy doctor en informática y llevo más de 30 años dedicándome profesional y prácticamente a las tecnologías de la información. También trabajo como experto en informática y protección de datos. Obtengo mis resultados analizando la tecnología y el Derecho. Esto me parece absolutamente esencial cuando se trata de protección de datos digitales.