El CEO de Google, Sundar Pichai, afirma que el sector aún está lejos del estado final de la automejora recursiva. Al mismo tiempo, describe bucles en los que agentes de IA ya ayudan a construir nuevos modelos. A día de hoy se puede ordenar qué está documentado sobre la IA que se mejora a sí misma y qué significa para el uso de la IA en pequeñas y medianas empresas. ¿Está la humanidad en peligro?
El punto de partida es una entrevista sobre la que Big Technology informó el 23/10/2026. En ella aparece una frase sobre la IA que se mejora a sí misma muy fácil de citar: el sector aún estaría lejos del estado final de la RSI. RSI son las siglas de Recursive Self-Improvement, es decir, automejora recursiva. Se refiere a un ciclo en el que los sistemas de IA mejoran a sus sucesores, que a su vez construyen sucesores mejores.
Los fundamentos de cómo funcionan estos bucles se explican en el artículo sobre la automejora recursiva de la IA. A continuación se presentan por separado las declaraciones de la entrevista, la información que los fabricantes dan sobre sí mismos, un trabajo de investigación y un pronóstico de personas del sector.
Lo que dijo Pichai y lo que no dijo
El núcleo es breve. Según el informe de Alex Kantrowitz, Pichai dijo: «To be very clear. We are pretty far from the end state of RSI.» Viene a significar: «Que quede muy claro: el sector todavía está bastante lejos del estado final de la automejora recursiva». Kantrowitz contrapone esta frase a la expectativa de algunos en el sector de la IA de que una explosión de inteligencia es inminente y de que la IA pronto se mejorará en un bucle completo sin intervención humana.
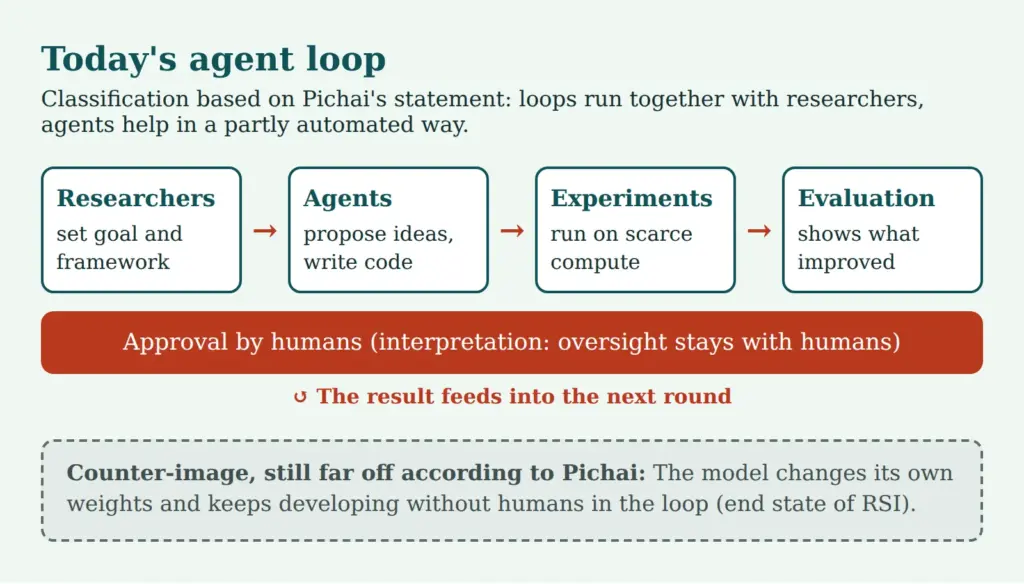
Justo después vienen dos frases más que pesan más que la primera para valorar la situación. Pichai dijo: «You have RSI loops along with AI researchers in various aspects of model development.» Y: «You almost have agents helping AI researchers in some automated way work together to build these models.» En esencia: en varios ámbitos del desarrollo de modelos hay bucles de retroalimentación junto con los investigadores, y los agentes les ayudan, en parte de forma automatizada, a construir los modelos.
Lo que queda documentado literalmente es, por tanto, esto: ya funcionan bucles parciales, y lo hacen junto con los investigadores. Estas frases no hablan de un modelo que se reconstruye a sí mismo sin supervisión. La frase sobre el estado final puede leerse como referida precisamente a esa imagen.
Como tema secundario, Big Technology informa sobre la capacidad de cómputo. Pichai dice que todos van escasos, no solo Google: «The compute we have today is a function of decisions I made in 2024.» Según el informe, también afirma que el negocio de la nube renuncia una y otra vez a ingresos a corto plazo porque la capacidad de cómputo se reserva para desarrollar los modelos punteros. Para la automejora esto es relevante, porque cada bucle de idea, experimento y evaluación cuesta tiempo de cómputo. Donde escasea, frena también la investigación automatizada.
No hay ningún plazo documentado. Informes secundarios como el de DigitalToday mencionan «el año que viene» como momento de nuevos avances.
Sigue una interpretación que no procede de Pichai. Quien habla de un estado final presupone que existe un camino hacia él y que ese camino ya ha comenzado. Por eso la frase también puede leerse como una declaración a favor de la RSI: el desarrollo está en marcha, Google lo impulsa con gran esfuerzo y en unos años son concebibles grandes éxitos. Esta expectativa es una valoración propia. En las fuentes consultadas no consta ninguna declaración de Pichai en ese sentido.
Una lectura posible: quien habla del estado final presupone que el camino hacia él ya ha comenzado. La frase sería entonces menos una señal de calma que una determinación de la posición actual.
IA que se mejora a sí misma: bucle de agentes frente a cambio de pesos
Detrás del término se esconden dos cosas muy distintas que a menudo se mezclan en el día a día. La primera es el bucle de agentes. Aquí, agentes de IA participan en el desarrollo: proponen experimentos, escriben y modifican código, lanzan entrenamientos, evalúan resultados e informan. Las personas fijan los objetivos, revisan los resultados y deciden sobre los cambios. El ciclo mejora procesos, herramientas y flujos de trabajo.
La segunda es el cambio de pesos. En ese caso, un modelo modificaría sus propios pesos de modo que su sucesor fuera mejor, y lo haría sin que una persona aprobara resultados entre medias. Es esta imagen la que sostiene el concepto de explosión de inteligencia. Y precisamente de eso, según una lectura de Pichai, el sector aún está lejos.
Entre ambos polos no hay un interruptor, sino un espectro. El número de pasos que los agentes completan sin consultar puede crecer. Con él crece la parte del desarrollo que las personas solo controlan por muestreo. Cómo actúan los agentes en la práctica y por qué eso exige control se describe en el artículo sobre la era de los agentes de IA.
La pregunta central merece una respuesta sobria. Se puede derivar de las frases documentadas.
¿Practica Google ya la automejora recursiva cuando la IA ayuda a construir los modelos sucesores?
Para las pymes, la diferencia no es académica. Un bucle de agentes acelera los ciclos de los modelos sin que la pérdida de control sea el problema. Un cambio de pesos sin supervisión plantearía la pregunta de si las personas aún pueden seguir los cambios. Ambas preguntas requieren respuestas distintas, y hoy solo la primera se plantea en la práctica.
Lo que Google y otros cuentan sobre su propio avance
Las declaraciones de los fabricantes sobre su propio progreso son información que dan sobre sí mismos. Pueden ser ciertas, pero no han sido verificadas de forma independiente. Esto vale para todo lo que figura en este apartado.
Un ejemplo actual es Flint. En su anuncio, la empresa Recursive presenta el modelo como un modelo rápido de programación para hardware local, con 40 000 millones de parámetros en total y 2500 millones activos por token (es decir, un modelo Mixture of Experts). Según su propia versión, un pequeño equipo de personas y agentes lo construyó en menos de cuatro meses. El sistema de investigación automatizada, la «Eureka Machine», habría codesarrollado casi todas las partes de la cadena de construcción del modelo, desde los datos y las recetas de entrenamiento hasta la inferencia. Los benchmarks proceden del fabricante y no se han verificado de forma independiente. La propia Recursive advierte de que Flint puede necesitar más indicaciones que los grandes modelos cerrados.
Para las empresas, esto resulta interesante por dos motivos. Primero, el caso muestra que la investigación automatizada ya da lugar a productos, también en equipos pequeños. Segundo, el modelo funciona en local. Quien no quiera enviar datos sensibles a proveedores de nube tiene así una opción más, sin que con ello queden demostradas las afirmaciones del fabricante. Cómo encajan los modelos locales en la empresa lo muestra el resumen sobre la IA local en la empresa.
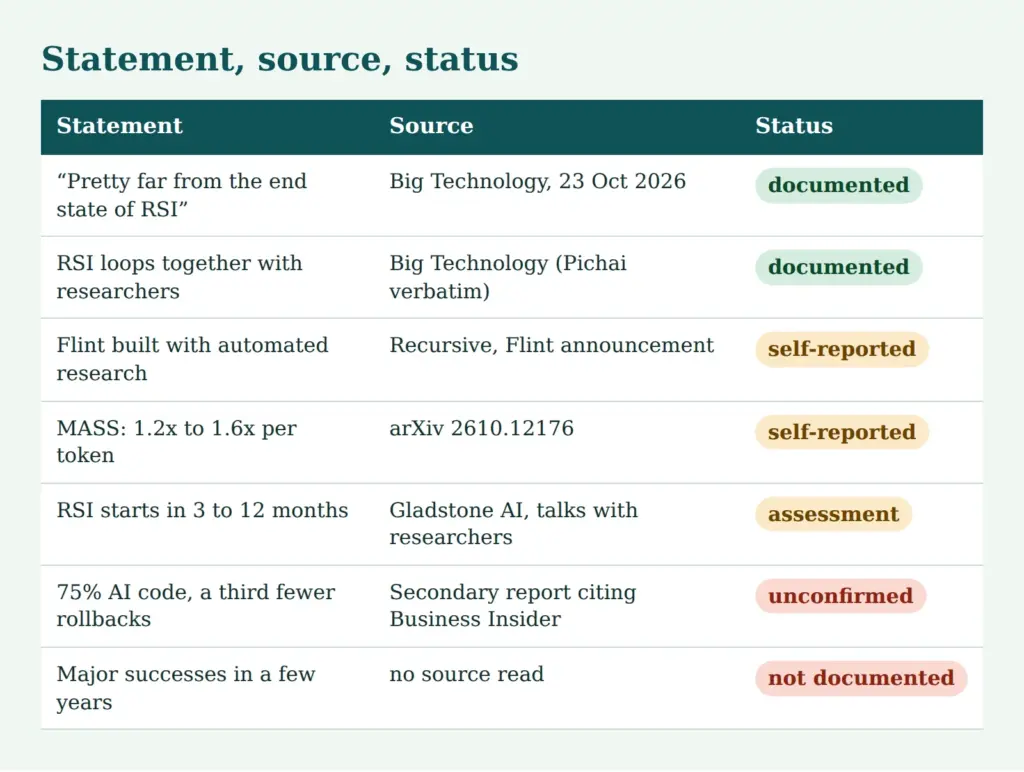
El resumen muestra cómo deben clasificarse las afirmaciones de este artículo. Están documentadas las dos frases de Pichai en la redacción del informe. Las cifras de fabricantes y de investigación son autodeclaradas. Gladstone es una valoración a partir de conversaciones con investigadores, no una medición. La cifra sobre el código sigue sin confirmar, y el supuesto plazo «en unos pocos años» no está documentado como declaración de Pichai.
Lo que muestra la investigación y dónde termina
Un trabajo de investigación hace tangible cómo puede ser un bucle así. Con el título «Recursive Self-Improvement through Multi-Agent Self-Supervision» (enviado el 8 de octubre de 2026) se describe el método MASS. Un único modelo base, en el artículo Qwen3.6-27B, propone flujos de trabajo multiagente, los ejecuta y los evalúa él mismo. Después se reentrena con sus propias ejecuciones y el procedimiento se repite.
Tras dos ciclos, el resumen del artículo informa de un rendimiento de 1,2 a 1,6 veces por token de salida en cuatro benchmarks abiertos. Además, un modelo entrenado con las ejecuciones de varios agentes sería mejor que uno entrenado con las ejecuciones de un solo agente y un 40 por ciento más de datos de entrenamiento.
Los límites se ven en el propio material. Se trata de un modelo y dos ciclos. La señal de mejora procede de la autoevaluación. En los dos benchmarks de programación Terminal-Bench 2.0 y SWE-bench Verified, una figura del artículo muestra los valores 0,96 y 0,94, es decir, ligeramente por debajo del valor de partida por token. En estas dos pruebas, la figura no muestra, por tanto, ninguna ganancia por token.
El punto de partida de los autores encaja con el tema de la supervisión (de nivel superior). Escriben que a un único modelo le cuesta criticar y mejorar sus propios razonamientos complejos cuando trabaja en un bucle homogéneo. Por eso recurren a varias instancias con distintos roles. Si el mismo modelo genera y evalúa, los errores compartidos pueden pasar desapercibidos. Esta es una conclusión derivada del enfoque; la formulación del artículo se refiere al método, no a las empresas.
La investigación demuestra que la idea puede funcionar y que la verificación es el cuello de botella. No demuestra que los modelos se mejoren de forma fiable sin personas en el uso cotidiano. Esto encaja con la frase de Pichai y no la contradice.
Lo rápido que podría ir: Gladstone y los límites del pronóstico
Investigadores de Anthropic, OpenAI y Google DeepMind esperarían que la automejora recursiva comience en los próximos tres a doce meses, posiblemente antes, siempre que el Gobierno de EE. UU. no intervenga ni la frene.
Las personas consultadas tienen un interés propio en la dinámica del sector, y los autores son una organización centrada en la política de seguridad.
La investigación automatizada podría ser técnicamente posible sin ser rentable. Las buenas ideas no serían el cuello de botella, sino el tiempo de cómputo para probarlas. Esto coincide con la referencia de Pichai a la escasez de capacidad de cómputo.
Las afirmaciones no se excluyen entre sí. «Comienzo» y «estado final» son puntos distintos del mismo camino. Pichai dice que el camino es largo y describe a la vez que los bucles funcionan con investigadores. Gladstone espera que una parte de ello se vuelva pronto más autónoma. Quien lee ambas cosas obtiene una imagen en la que la automejora recursiva avanza paso a paso. Basar la planificación solo en plazos de meses es arriesgado, porque proceden de un pequeño círculo de conversaciones.
Consecuencias para las pymes: probar los ciclos y los cambios de modelo
Para las empresas, el efecto no se manifiesta como explosión de inteligencia, sino en el calendario y en la técnica. Si los agentes descargan a los investigadores, pueden aparecer nuevas versiones de modelos con más frecuencia. Para la operación, sin embargo, cuenta una cosa con independencia de la causa: los modelos cambian más rápido de lo que los departamentos adaptan sus procesos.
Esto tiene consecuencias prácticas. Un modelo puede responder de otra manera que su predecesor ante el mismo prompt. El tono, el formato, los tipos de error y el coste por tarea se desplazan. Los proveedores retiran versiones antiguas, a veces con poco preaviso. Y quien confía en el alias «latest» recibe cambios en producción sin haberlos pedido.
De ahí resulta un procedimiento sencillo para el cambio de modelo. Primero, un corpus de prueba con tareas reales, por ejemplo de 50 a 200 casos anonimizados con una respuesta correcta conocida (¡que en parte incluso se pueden generar con IA!). Segundo, una ejecución comparativa del nuevo modelo frente a la versión actual con los prompts sin cambios. Tercero, la aprobación por parte de una persona designada que haya visto la calidad, los costes y el patrón de errores. Cuarto, una vía de reversión, es decir, una versión de modelo fija y la configuración guardada, para que volver atrás sea cuestión de minutos.
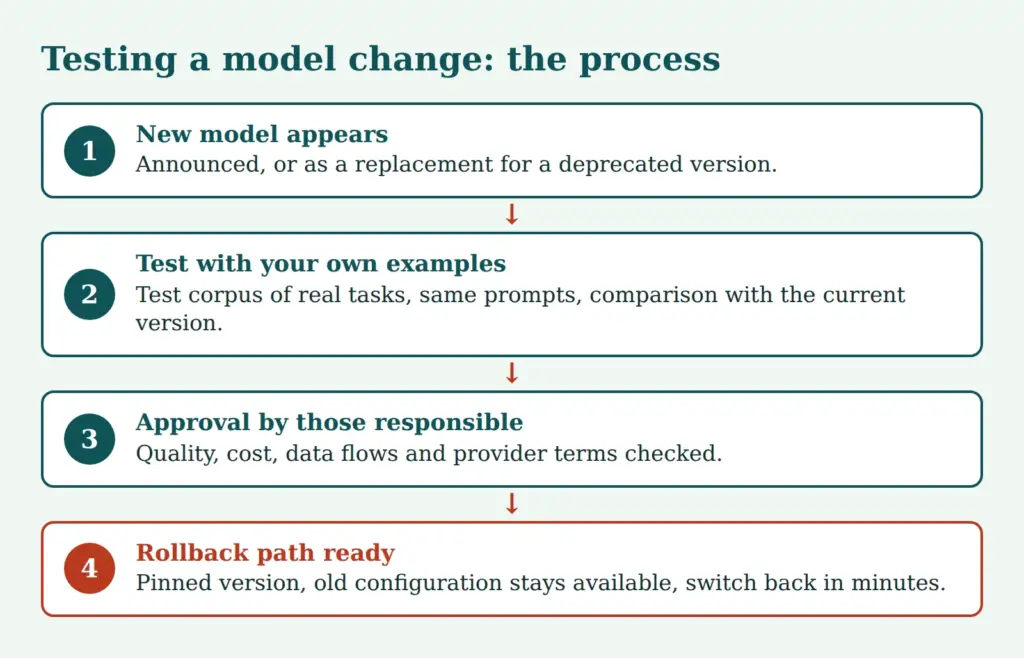
En un cambio de proveedor o con un nuevo modelo de un proveedor existente entran en juego la protección de datos y el contrato. Hay que aclarar los flujos de datos, la ubicación de los servidores, el encargo de tratamiento y si las entradas se utilizan para entrenamiento. En producción no debería permitirse una actualización automática al modelo más reciente. Los modelos locales desplazan la cuestión: eliminan la dependencia del proveedor y traen su propio mantenimiento, véase el resumen sobre la IA local.
Las pequeñas empresas no necesitan crear un departamento de pruebas propio para ello. Una tabla con ejemplos, un script que los envíe a ambos modelos y una breve nota de aprobación bastan para empezar.
Mantener la supervisión y las aprobaciones: lo que sigue siendo tarea de las personas
Cuando los desarrolladores de la propia empresa utilizan agentes con permisos de escritura, surge a pequeña escala el mismo bucle que en los laboratorios: el agente modifica código, se ejecutan las pruebas, el agente corrige. La supervisión puede seguir el mismo patrón. El agente puede proponer y probar, pero una persona designada aprueba los cambios en sistemas de producción, configuraciones y datos.
A ello se suman registros que permitan reconstruir lo que ha hecho el agente y permisos tan restringidos como sea necesario. Borrar, enviar y pagar son acciones que merecen una confirmación adicional. Los riesgos de un agente sin control se describen en el artículo El peligro detrás de los agentes de IA.
También importa quién verifica. Si el mismo modelo genera y evalúa, persisten los mismos puntos ciegos. En la operación eso significa: una IA puede revisar a otra, pero solo como complemento. La contraprueba fiable procede de pruebas, de otro proveedor o de una persona.
La IA solo verifica a la IA de forma fiable si la contraprueba es independiente: mediante pruebas, otro proveedor o una persona.
La responsabilidad sigue recayendo en la empresa que utiliza el agente. Esto es así con independencia de cuánto del desarrollo esté automatizado en segundo plano. Que se diga que la IA se mejora a sí misma no exime al operador.
Lista de control: qué hacer ahora y qué no
Una lista de control debe ayudar a responder a la pregunta de qué hacer ahora y qué no:
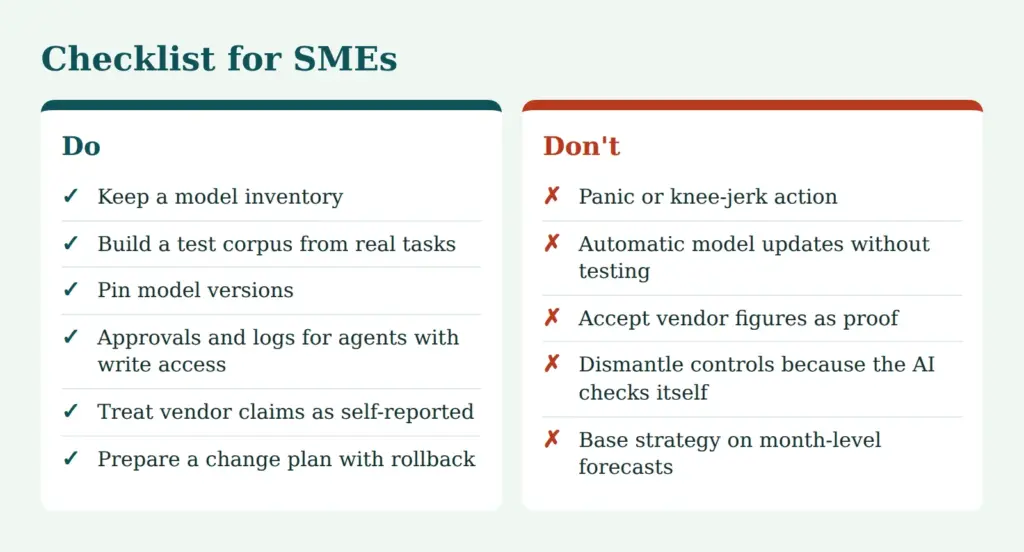
Los puntos en detalle:
El inventario de modelos recoge qué modelos funcionan, en qué versión y dónde, quién es responsable y qué datos fluyen. El corpus de prueba crece con cada error que se detecta en la operación. Las versiones se fijan y solo se cambian tras una prueba. Para los agentes con permisos de escritura rigen aprobaciones y registros. Las afirmaciones de los fabricantes, ya sea sobre benchmarks o sobre la proporción de IA en el código, se tratan como autodeclaraciones y no como prueba.
No son recomendables el pánico ni el activismo precipitado, porque la situación documentada es un bucle parcial con personas. Tampoco deberían desmontarse controles porque una IA se revise a sí misma. Y las estrategias basadas en plazos de meses de los pronósticos se apoyan en una base frágil. Quien además quiera revisar el lado técnico, por ejemplo los permisos y la superficie de ataque de los sistemas, encontrará un punto de partida en los Security-Checks de wwwschutz.de.
Conclusión
En resumen, las afirmaciones y el estado actual, que puede cambiar a diario, pueden ordenarse así.
Pichai documenta que existen bucles de retroalimentación con investigadores y que el estado final sin personas aún está lejos. Esto no es una señal de calma. Una lectura posible es que el camino ya está en marcha y que en unos años son posibles grandes avances.
Para las pymes cuentan los ciclos de modelos más cortos, las pruebas antes de cada cambio, las versiones fijas y las aprobaciones para los agentes. Si el bucle se vuelve claramente más autónomo en tres meses o en tres años, hoy nadie lo sabe con certeza. Quien domina las pruebas, las aprobaciones y la reversión está preparado para ambos casos.
 Me llamo Klaus Meffert. Soy doctor en informática y llevo más de 30 años dedicándome profesional y prácticamente a las tecnologías de la información. También trabajo como experto en informática y protección de datos. Obtengo mis resultados analizando la tecnología y el Derecho. Esto me parece absolutamente esencial cuando se trata de protección de datos digitales.