


Frontier AI (najbardziej zaawansowana sztuczna inteligencja) staje się lepsza nie tylko dzięki większej mocy obliczeniowej. Rozmowy, oceny, automatyczne testy i symulacje dostarczają sygnałów, z których można się uczyć. Mogą na tym skorzystać także roboty.
Kto regularnie korzysta z asystentów AI, ten to zauważa: Frontier AI z wersji na wersję popełnia mniej błędów, pisze użyteczniejszy kod i rozwiązuje zadania, przy których wcześniejsze generacje zawodziły. Zwykle słyszymy wyjaśnienie, że po prostu jest więcej danych i więcej mocy obliczeniowej. To prawda, ale to nie wszystko. Postęp coraz częściej wynika ze sprzężenia zwrotnego. Odpowiedzi są oceniane, programy testowane, dowody sprawdzane, a z wyniku powstaje sygnał uczenia.
Artykuł omawia te sygnały po kolei. Mowa o rozmowach między ludźmi a asystentami, o porównywaniu dobrych i złych odpowiedzi, o automatycznych kontrolach i o tym, co rekurencyjne samodoskonalenie oznacza dziś w praktyce. Następnie przechodzimy do robotów, a na koniec podajemy praktyczne zalecenia dotyczące ochrony danych.
Dziś każdy może sam zaobserwować w praktyce, co już jest możliwe dzięki AI. AI to obecnie znacznie więcej niż chatbot; wie o tym każdy, kto zna podstawy techniczne.
Frontier AI: czym są modele czołowe i skąd bierze się postęp
Frontier AI to najwydajniejsze modele AI swojej epoki. Po niemiecku mówi się też o modelach szczytowych lub wiodących modelach AI. Nie istnieje stała, powszechnie uznana granica. Klasę tę często opisuje się nakładem treningu, czyli ilością mocy obliczeniowej włożonej w model.
Właściwiej jednak mówić o systemach AI, których głównym składnikiem są modele AI. Pozostałe komponenty to m.in. wirtualne środowiska testowe, routery wyboru narzędzi wraz z podłączonymi narzędziami itd.
Trening takich modeli można z grubsza podzielić na kilka etapów:
- Wstępny trening: model czyta duże ilości tekstu i uczy się przewidywać prawdopodobne kontynuacje. W ten sposób powstaje wyczucie języka i wiedza o świecie.
- Dotrenowanie ze sprzężeniem zwrotnym: model uczy się udzielać odpowiedzi pomocnych i bezpiecznych. W tym celu odpowiedzi są oceniane i porównywane.
- Trening z sygnałami weryfikującymi: przy zadaniach o jednoznacznym wyniku, np. rachunkach lub programowaniu, kontrola automatycznie rozstrzyga, czy próba rozwiązania była poprawna.
- Rekurencyjne samodoskonalenie: AI sama się rozwija i staje się coraz inteligentniejsza.
Drugi i trzeci etap stanowią rdzeń tego artykułu. Oba opierają się na tej samej myśli.
Postęp w modelach czołowych jest coraz częściej kwestią sprzężenia zwrotnego: kto potrafi sprawdzić, co było dobre, może się na tym uczyć.
Wstępny trening zapewnia szerokość, sprzężenie zwrotne nadaje kierunek. Bez niego model pozostaje generatorem tekstu, który wypowiada rzeczy prawdopodobne. Dzięki niemu uczy się, co w konkretnej sytuacji uchodzi za udane.
Co może się dziać z rozmowami użytkowników: trening, analiza, bezpieczeństwo
Rozmowy z asystentami są oczywistym źródłem sygnałów uczenia, choć trening AI na danych użytkowników odbywa się tylko pod określonymi warunkami. Warto jednak rozróżnić cztery rzeczy, które w codziennym użyciu łatwo pomylić:
- Trening: rozmowy trafiają do dalszego rozwoju modeli. To, czy tak się dzieje, zależy od dostawcy, taryfy i ustawień.
- Analiza dla bezpieczeństwa: rozmowy są sprawdzane pod kątem nadużyć lub naruszeń regulaminu. To coś innego niż trening modelu.
- Analiza do własnych celów: użytkownicy AI często o tym zapominają: OpenAI i inni analizują zapytania klientów i odpowiedzi AI, aby ulepszać własną AI. Przy tym koncepcje mogą zostać „ukradzione”.
- Wyraźna opinia: kciuk w górę lub w dół, zgłoszenia błędów i komentarze są przekazywane celowo jako ocena.
Przykład opublikowanych zasad podaje Anthropic. Firma ogłosiła w połowie 2025 roku nowe warunki dla konsumentów. Użytkownicy kont konsumenckich mieli wybrać, czy ich czaty i sesje programowania mogą być używane do ulepszania modeli. Po wyrażeniu zgody okres przechowywania wynosi pięć lat, bez zgody 30 dni. Usługi komercyjne i API są z tego wyłączone. Zgodnie ze stroną pomocy Claude opinie mogą ponadto być przechowywane do pięciu lat, a rozmowy oznaczone jako podejrzane mogą być sprawdzane w celach bezpieczeństwa. Czaty incognito są wyłączone z treningu.
Także Google opisuje podobne zasady w informacjach o ochronie danych w aplikacjach Gemini. Mowa tam m.in. o ustawieniu dotyczącym aktywności, o ludzkich recenzentach i o okresach przechowywania do trzech lat w przypadku sprawdzanych rozmów i opinii. W OpenAI według informacji dostawcy istnieje ustawienie, które pozwala wyłączyć wykorzystanie danych do ulepszania modeli.
Informacje różnią się w zależności od dostawcy i ulegają zmianom. Zazwyczaj dotyczą też tylko kont konsumenckich. Nie oznacza to, że inne konta są bezpieczne przed „wykorzystaniem danych do obcych celów”.
Jak uczyć się z rozmów bez czytania pojedynczych czatów
Milionów rozmów nie przeczyta żaden człowiek. Opublikowana metoda pokazuje, jak mimo to można rozpoznawać wzorce: Clio firmy Anthropic. Narzędzie automatycznie streszcza rozmowy, grupuje podobne tematy i pokazuje wyłącznie zanonimizowane, zagregowane wyniki. Celem jest najwyraźniej analiza wzorców użycia, wykrywanie nadużyć i ulepszanie klasyfikatorów ochronnych. Nie jest to tożsame z treningiem modelu.
Przykład pokazuje, co jest zasadniczo możliwe. Z dużych zbiorów rozmów można wyprowadzać tematy, koncepcje i potrzeby. W czym ludzie potrzebują pomocy? Które pytania pozostają bez odpowiedzi? Gdzie odpowiedzi wydają się niezadowalające, bo użytkownicy dopytują lub zmieniają sformułowanie? Takie analizy mogą wskazać, jakich umiejętności model powinien nauczyć się w następnej kolejności. To, czy i jak poszczególni dostawcy wykorzystują tę możliwość w treningu, nie jest publicznie udokumentowane ze szczegółami. Jest to możliwość techniczna, a nie potwierdzona praktyka. (Niestety) trudno to udowodnić, co zwiększa prawdopodobieństwo, że jest stosowana.
Dostawca wskazuje też ograniczenia. Nie wszystkie dane prywatne są wiarygodnie rozpoznawane, a narzędzie do analizy rozmów można w zasadzie wykorzystać także do inwigilacji. Agregacja i anonimizacja są więc środkami ochrony, ale nie gwarancją.
Dobre i złe odpowiedzi: sygnał płynący z porównania
Ludziom często łatwiej porównać dwie odpowiedzi, niż ocenić jedną w sposób bezwzględny. Ta okoliczność leży u podstaw dotrenowania z ludzkim sprzężeniem zwrotnym. Do pytania powstają dwie odpowiedzi, a osoba oznacza lepszą. Z wielu takich par model uczy się, jakie cechy są preferowane: dokładność, zrozumiałość, odpowiedni ton, bezpieczeństwo.
Takie porównanie jest sygnałem kontrastowym. Model uczy się nie tylko tego, co jest dobre, ale także od czego ma się odróżniać. Znaną metodą jest Direct Preference Optimization (DPO). Wykorzystuje ona pary preferencji bezpośrednio do dostrojenia modelu, bez wcześniejszego trenowania osobnego modelu oceniającego.
Oceny nie muszą pochodzić od ludzi. Constitutional AI opisuje, jak model krytykuje i poprawia odpowiedzi na podstawie pisemnych zasad. Badanie porównało opinie AI z opiniami ludzi i w analizowanych zadaniach wykazało porównywalne wyniki. Dotyczy to wyraźnie tylko tych zadań i ówczesnego stanu wiedzy.
Tu pojawiają się punkty styczne z rekurencyjnym samodoskonaleniem: model pomaga oceniać swojego następcę. Następca dzięki temu staje się lepszy, a kolejny krok zaczyna się na wyższym poziomie. Pętla jest wąsko ograniczona, ale częściowo realna i stosowana w praktyce.
Rekurencyjne samodoskonalenie: co jest udowodnione, a co pozostaje prognozą
Pojęcie budzi duże oczekiwania. System ma sam się ulepszać, ulepszona wersja ulepsza się dalej, a postęp przyspiesza. W debacie pojęcie to jest używane różnie, a niektórzy gracze podają imponujące wartości procentowe, na przykład udział kodu napisanego przez AI.
Udokumentowane są raczej małe elementy:
- Trening na danych wygenerowanych samodzielnie, w którym model pisze odpowiedzi, a po sprawdzeniu są one ponownie używane.
- AI jako oceniający, jak w Constitutional AI i Reinforcement Learning.
- Wsparcie AI przy rozwoju, np. przy pisaniu i testowaniu kodu.
Są też zagrożenia. Jeśli model jest wielokrotnie trenowany na wynikach AI, jego jakość może spadać. Badacze mówią o upadku modelu (zbadanym w Nature). Ryzykiem jest także błędny oceniający, bo model uczy się wtedy podobać ocenianiu zamiast sprostać zadaniu. Uprzedzenia oceniającego mogą się wzmacniać.
Między udokumentowanymi elementami a niepowstrzymanie przyspieszającą inteligencją leży szeroka przestrzeń. Jak duży jest faktyczny udział takich sprzężeń zwrotnych w postępie wiodących modeli, z zewnątrz nie sposób ocenić.
Testy i symulacje przed odpowiedzią: sygnały weryfikujące zamiast opinii
Sygnał uczenia jest szczególnie silny, gdy nikt nie musi go oceniać. W niektórych zadaniach wynik można sprawdzić automatycznie (np. za pomocą Lean). Program przechodzi testy albo nie. Rachunek daje poprawny wynik albo nie. Dowód zostaje przyjęty lub odrzucony przez program weryfikujący. Mówimy tu o weryfikowalnej nagrodzie, która w uczeniu ze wzmocnieniem służy jako sygnał uczenia.
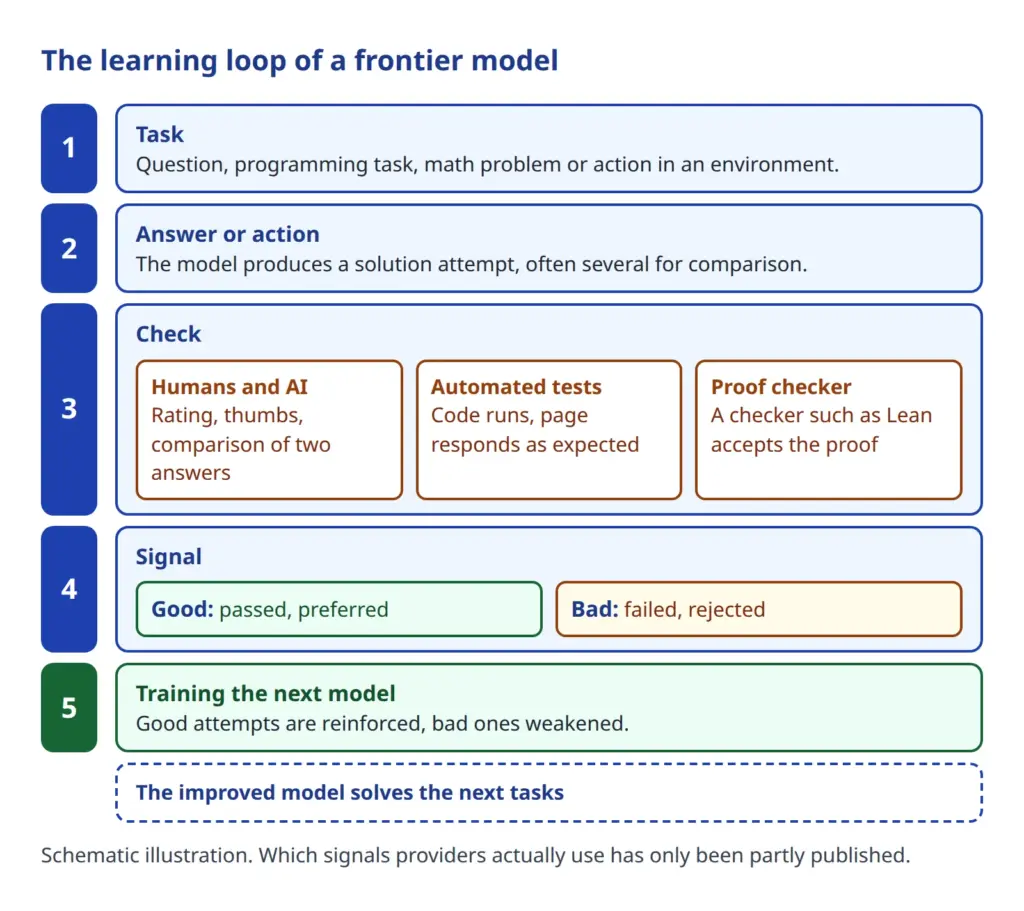
Zasada jest dobrze udokumentowana. Praca o DeepSeek-R1 donosi, że zdolności wnioskowania mogą rosnąć dzięki uczeniu ze wzmocnieniem na zadaniach możliwych do sprawdzenia. Już wcześniej badacze wykazali, że wytrenowany weryfikator może pomóc przy zadaniach tekstowych z rachunków wybrać poprawne rozwiązanie spośród kilku. Asystenci dowodzenia, tacy jak Lean, również dają jednoznaczny werdykt, a więc szczególnie wyraźny sygnał.
Test nie mówi, co jest ładne, lecz czy działa, i właśnie to czyni go tak cennym sygnałem uczenia.
Dobrym przykładem jest aplikacja internetowa. Agent tworzy stronę, a następnie otwiera ją za pomocą narzędzia do testów przeglądarkowych, takiego jak Playwright/Chromium. Klika przyciski, sprawdza, czy formularze działają, i widzi, czy wygląd się zgadza. Jeśli coś zawiedzie, poprawia kod i testuje ponownie. Dla użytkownika wygląda to jak lepsza odpowiedź, która pojawia się po pewnym czasie oczekiwania. Przegląd tego, jak trenuje się modele, daje artykuł Trening modeli AI, a o konkurencji dostawców traktuje artykuł o nieustającym wyścigu modeli.
Nasuwa się jeszcze jedna myśl: wynik takiego testu, zaliczony lub niezaliczony, mógłby trafić jako sygnał do przyszłego treningu. Pytanie brzmi, czy i w jakim zakresie dostawcy to robią. Udokumentowana jest zasada weryfikowalnej nagrody, a nie konkretne wykorzystanie testów przeglądarkowych w treningu.
Test sprawdza tylko to, do czego został napisany. Program może zaliczyć wszystkie testy i mimo to rozwiązywać złe zadanie. Model może też nauczyć się oszukiwać testy zamiast rozwiązywać zadanie. Kto pracuje z agentami obsługującymi narzędzia, znajdzie tło w artykule o agentach AI.
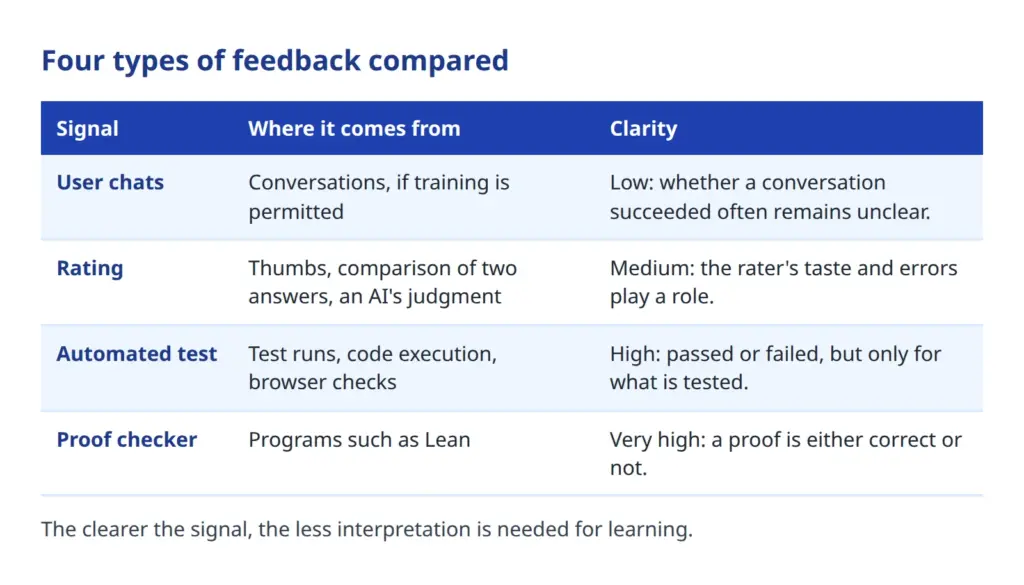
Zestawienie pokazuje, dlaczego sygnały weryfikujące są tak cenione: im jednoznaczniejsza informacja zwrotna, tym mniej potrzeba interpretacji. Dane z rozmów są bogate, ale niejednoznaczne. Testy są wąskie, ale jasne.
Roboty z AI: Embodied AI, symulacja i Sim-to-Real
Dlaczego roboty korzystają z postępów w modelach językowych i modelach rozumowania? Ponieważ robot, który ma wykonać polecenie w rodzaju „posprzątaj zlew”, potrzebuje trzech zdolności, które ćwiczą także modele językowe: rozumienia poleceń, korzystania z wiedzy o świecie i planowania kroków. Embodied AI, czyli AI z ciałem, zaczyna właśnie tutaj.
Google DeepMind opisuje w Gemini Robotics model, który do wzroku i języka dodaje trzecie wyjście: działania. Takie modele vision-language-action przekładają obraz z kamery i zdanie na polecenia ruchu. Istnieją też modele do embodied reasoning, które zapewniają rozumienie przestrzeni i planowanie oraz potrafią wywoływać narzędzia.
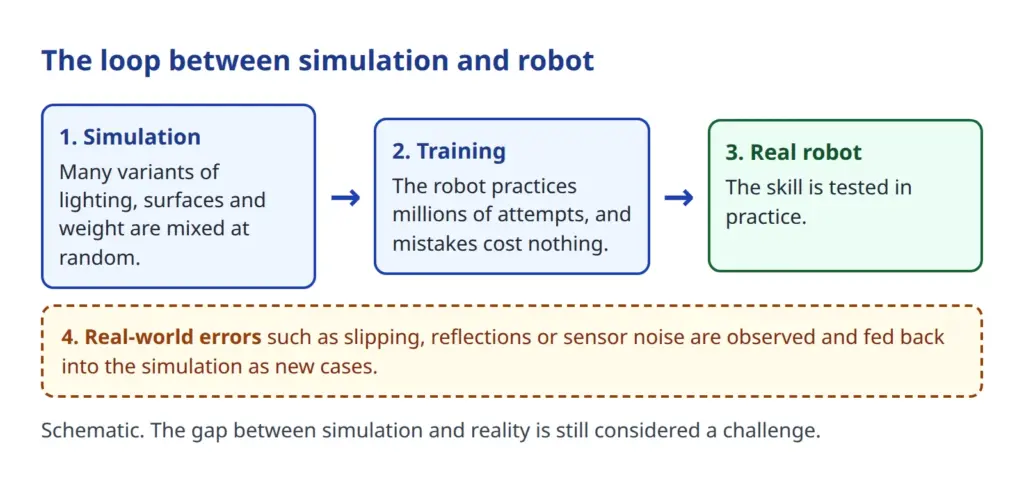
Roboty uczą się jednak trudniej niż oprogramowanie. Nieudana próba w rzeczywistości kosztuje czas, materiał, a w najgorszym razie bezpieczeństwo. Tu wkracza symulacja. W środowisku wirtualnym możliwe są miliony prób, błędy nic nie kosztują, a wynik można ocenić automatycznie. To znów sygnał weryfikujący, tylko że dla ruchów.
Problem nazywa się Sim-to-Real: to, co działa w symulacji, w rzeczywistości często zawodzi z powodu drobiazgów, takich jak warunki oświetleniowe, tarcie czy szum pomiarowy. Znanym środkiem zaradczym jest Domain Randomization. Symulacja jest celowo liczona w wielu wariantach, tak że rzeczywistość staje się już tylko kolejnym wariantem. Tobin i współpracownicy w ten sposób wytrenowali model rozpoznawania obiektów wyłącznie na obrazach symulowanych i osiągnęli w praktyce dokładność około 1,5 centymetra.
Krok dalej idą modele świata. Tworzą one symulowane środowiska nie z ręcznie zbudowanych reguł, lecz uczą się, jak świat wygląda i jak się zachowuje. Genie 3 od Google DeepMind według firmy tworzy interaktywne światy w czasie rzeczywistym z prędkością 24 klatek na sekundę i ma nadawać się do trenowania agentów. Dostawca określa go jako podgląd badawczy o ograniczonej spójności. Także NVIDIA oferuje w Cosmos i Isaac Sim narzędzia do danych syntetycznych i symulacji.
Granice są realne. Przeniesienie do środowisk fizycznych pozostaje wyzwaniem, a w przypadku robotów spotykających ludzi dochodzi kwestia bezpieczeństwa. Błąd to tam nie fałszywe zdanie, lecz fałszywy ruch.
Ochrona danych na co dzień: co powinni sprawdzić użytkownicy i firmy
Z punktu widzenia ochrony danych najważniejsze pytanie jest proste, ale nie ma na nie ogólnej odpowiedzi.
Czy czaty z asystentami AI są wykorzystywane do treningu?
Wynika z tego kilka praktycznych wskazówek:
- Sprawdzać ustawienia: jeśli dostawca przewiduje wybór dotyczący wykorzystania do treningu, warto zajrzeć do ustawień prywatności. Ustawienia domyślne mogą się zmieniać.
- Preferować produkty biznesowe: dla firm standardem są produkty z umową powierzenia przetwarzania (art. 28 RODO). Warunki zwykle różnią się od kont konsumenckich.
- Nie wprowadzać danych osobowych do kont prywatnych: dane klientów i informacje wewnętrzne nie należą do kont konsumenckich.
- Świadomie korzystać z opinii: kto oznaczy rozmowę kciukiem lub zgłoszeniem błędu, może umożliwić dłuższe przechowywanie i sprawdzenie całej rozmowy.
- Pamiętać o aktualności: informacje dostawców mają datę. Decydująca jest zawsze aktualna wersja.
Podsumowanie
Postęp rodzi się ze sprzężenia zwrotnego!
Rozmowy i oceny pokazują, czego potrzebują ludzie i co uchodzi za dobrą odpowiedź. Testy, weryfikatory dowodów i symulacje jednoznacznie mówią, co działa. Oba rodzaje sygnałów poprawiają modele, a stopniowo także roboty, których zdolności opierają się na tych samych modelach. Jak daleko sięgnie rekurencyjne samodoskonalenie, pozostaje otwarte. Przejrzystość i możliwość wyboru w zakresie danych użytkowników pozostają zadaniem dostawców, a uważne przyglądanie się zadaniem użytkowników.
Każdy ma w pewnym stopniu sam w rękach, ile własnych danych trafia do osób trzecich. Do wyboru jest oszczędne podawanie danych osobowych lub cennych, a także korzystanie z lokalnej AI. Pseudonimizację można w przypadku krótkich tekstów przeprowadzić automatycznie lub ręcznie. Dla dłuższych tekstów automatyzm nie jest jednak niezawodny (a właściwie także nie dla krótkich, gdzie człowiek może jednak poświęcić dość wysiłku na kontrolę).
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.
