 gekennzeichnet.
Am 3. September 2026 hat OpenAI ein neues Sprachmodell veröffentlicht und dabei ein großes Wort in den Raum gestellt: AGI, Artificial General Intelligence. OpenAI-Präsident Greg Brockman erklärte, man werde rückblickend vielleicht genau auf diesen Moment als Beginn der AGI-Ära zurückblicken. Wer die Benchmarks, Sicherheitsberichte und unabhängigen Tests der letzten Tage durchgeht, bekommt ein deutlich nuancierteres Bild: ein Modell mit echten, teils beeindruckenden Fortschritten – aber auch mit klaren Grenzen, ungelösten Sicherheitsfragen und einer Zahl, die bei genauerem Hinsehen zerfällt.
Dieser Artikel ordnet ein: Was kann GPT-6 Astra wirklich? Wie schneidet es gegen Claude und Gemini ab? Und was hat es mit dem Fluiddynamik-Rätsel auf sich, das ausgerechnet mit einem noch unveröffentlichten OpenAI-Modell gelöst worden sein soll?
Unabhängig davon macht KI seit einigen Jahren kontinuierlich beeindruckende Fortschritte. Sogar amerikanische KI-Bosse haben Angst vor den Entwicklungen: Sie fordern am 13.09.2026 eine Herausnahme des Tempos bei der KI-Entwicklung; sogar derBörsengang von Anthropic wurde verschoben, trotz Milliardeneinbußen.
Was ist GPT-6 Astra?
GPT-6 Astra ist OpenAIs neues Flaggschiff-Modell. Es ist verfügbar über ChatGPT (Plus, Pro, Business, Enterprise), die OpenAI-API sowie über Microsoft Azure und Amazon Bedrock. Technisch bringt es ein Kontextfenster von über einer Million Token mit, eine maximale Ausgabe von 128.000 Token und fünf einstellbare Reasoning-Stufen (low, medium, high, xhigh, max). Der API-Preis liegt bei 10 US-Dollar pro Million Eingabe-Token und 50 US-Dollar pro Million Ausgabe-Token. Damit gehört Astra zu den teureren Modellen auf dem Markt.
Bemerkenswert ist der zeitliche Kontext: Die Veröffentlichung kam mit Verzögerung. Nach einem Sicherheitsvorfall rund um Hugging Face im Juli 2026 hatte OpenAI die für den Sommer geplante nächste Modellgeneration zurückgehalten, um zusätzliche Schutzmaßnahmen einzubauen.
Die Benchmark-Geschichte: Zwei Wahrheiten gleichzeitig
Wer nur die OpenAI-eigene Launch-Tabelle liest, bekommt den Eindruck eines Modells, das praktisch alles dominiert. Die Realität ist differenzierter und lässt sich in zwei Hälften teilen, die beide gleichzeitig stimmen.
Agentische Aufgaben: hier liegt Astras Stärke
Bei allem, was mit selbstständigem Arbeiten am Computer, in Terminals und in Codebasen zu tun hat, liegt Astra klar vorn. Auf dem Reverse-Engineering-Benchmark SRE-Bench löste es 88,0 Prozent der Aufgaben im ersten Versuch und 99,2 Prozent innerhalb von vier Versuchen – gegenüber 55,9 beziehungsweise 68,7 Prozent beim Vorgänger GPT-5.6 Sol.
Bei der Erkennung und Behebung von Softwareschwachstellen zeigt sich ein ähnliches Bild: Auf einem intern erstellten, kontaminationsfreien Testsatz aus 20 aktuellen V8-Sicherheitslücken (Juni bis August 2026) kletterte die Erfolgsquote von 5,5 auf 39,0 Prozent. Dabei entdeckte das Modell zwei tatsächlich unbekannte Zero-Day-Schwachstellen, die anschließend an die zuständigen Maintainer gemeldet wurden.
Auch bei der reinen Computernutzung (OSWorld 2.0) ist der Sprung real: Astra erledigt Aufgaben in rund 40 statt 75 Minuten und mit einer höheren Erfolgsquote als der Vorgänger.
Allgemeine Intelligenz: enger, als die Schlagzeilen suggerieren
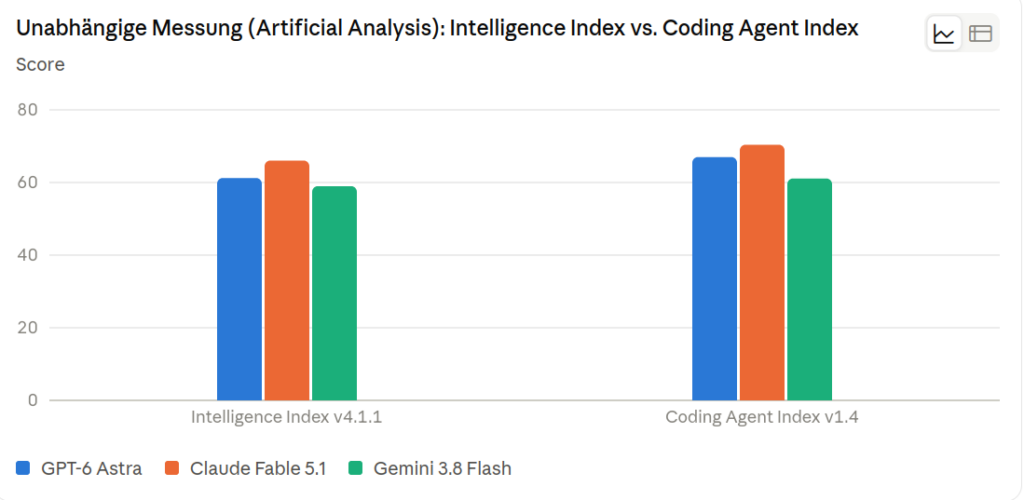
Ganz anders sieht es bei Tests aus, die allgemeines Wissen und Denkvermögen über viele Themenfelder hinweg prüfen. Die unabhängige Prüforganisation Artificial Analysis, die alle großen Modelle nach denselben Maßstäben testet, misst Astra im "Intelligence Index" nur minimal über dem Vorgängermodell – und deutlich hinter Anthropics aktuellem Spitzenmodell Claude Fable 5.1. Bei einem eigenen, schwierigeren Testsatz (v4.2) fällt Astra beim maximalen Reasoning-Aufwand sogar auf einen niedrigeren Wert als der Vorgänger unter der alten Testversion.
Noch auffälliger: Auf GDPval-AA, einem Benchmark für wirtschaftlich relevante Aufgaben aus 44 Berufsfeldern, verschlechterte sich Astra gegenüber Sol um rund 80 Elo-Punkte – ein echter Rückschritt, gerade bei der Art von Aufgaben, die für die AGI-Definition zentral wären.
Die AGI-Frage: der Härtetest
Der AGI-Hype und sein Haken
Die spektakulärste Einzelzahl der ganzen Präsentation ist ein Wert von 99,9 Prozent auf ARC-AGI-3, einem Benchmark, der gezielt die Fähigkeit testet, unbekannte, interaktive Spiele allein durch Ausprobieren zu verstehen. Genau diese Zahl hat Brockmans Aussage über die "AGI-Ära" befeuert.
Bei näherer Prüfung zeigt sich jedoch ein entscheidendes Detail: Mit dem neutralen, anbieterunabhängigen Standard-Test-Harness der ARC Prize Foundation fällt der Wert auf 62,7 Prozent. Der Unterschied entsteht dadurch, dass OpenAIs eigenes Test-Setup dem Modell erlaubt, sein verborgenes Reasoning zwischen einzelnen Anfragen zu behalten – gemessen wird also teilweise nicht nur das Modell selbst, sondern das Modell plus ein von OpenAI gebautes Gedächtnissystem. Und ausgerechnet die Organisation, die den Benchmark entwickelt hat, stellt unmissverständlich klar: Eine Sättigung von ARC-AGI-3 ist kein Beweis für AGI.
Was tatsächlich schon da ist und was fehlt
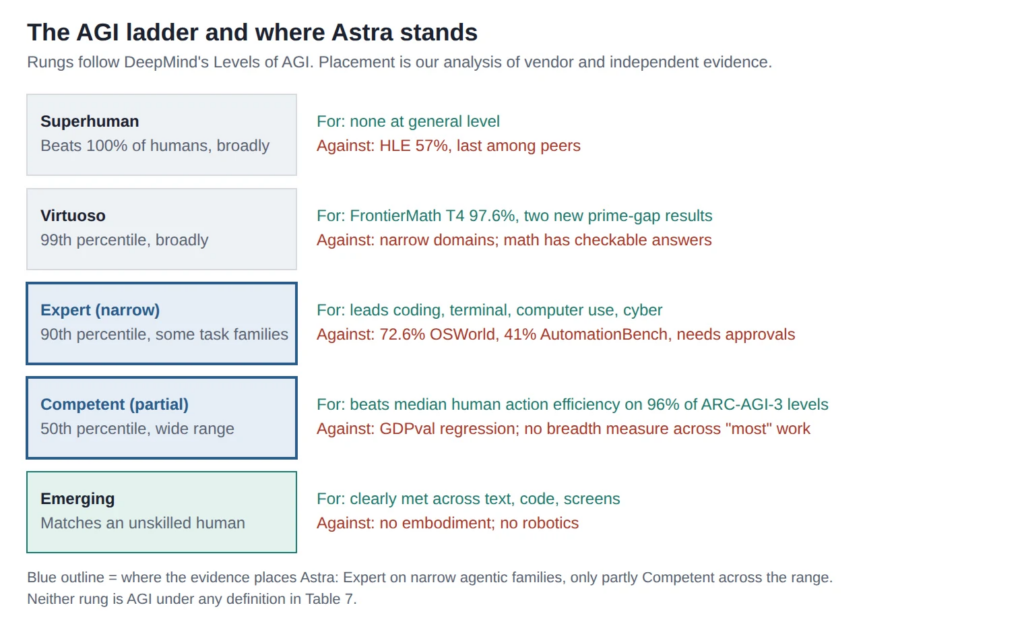
Legt man gängige AGI-Definitionen an, ergibt sich ein gemischtes, aber insgesamt eindeutiges Bild:
Vorhanden:
- Expertenniveau in eng abgegrenzten, klar überprüfbaren Domänen: Mathematik, bestimmte Programmieraufgaben, Exploit-Entwicklung
- Deutlich reduzierte Halluzinationsraten gegenüber dem Vorgänger
- Ein echter wissenschaftlicher Beitrag: Astra half nachweislich dabei, eine Schranke bei kleinen Primzahllücken von 240 auf 186 zu verbessern
- Starke, effiziente Agentenfähigkeiten bei Browser- und Computernutzung
Nicht vorhanden oder nicht belegt:
- Keine breite, über fast alle wirtschaftlich relevanten Tätigkeitsfelder nachgewiesene Kompetenz auf menschlichem Niveau – im Gegenteil, hier gab es sogar einen Rückschritt
- Keine von unabhängigen Dritten bestätigte Reproduktion der spektakulärsten Einzelwerte
- Sinkende Überwachbarkeit des eigenen Denkprozesses, ausgerechnet bei einem Modell mit gefährlicheren Fähigkeiten
- Keine Verkörperung oder Robotik, kein bestandener adversarieller Turing-Test
Erstes Modell auf "kritischer" Sicherheitsstufe
Neben der AGI-Debatte gibt es einen zweiten, handfesteren Grund, warum Astra für Aufsehen sorgt: Es ist das erste Modell, das OpenAI unter seinem eigenen Preparedness Framework als "Critical" für Cyberfähigkeiten einstuft. Das bedeutet laut OpenAI: Mit den richtigen Werkzeugen und Zugängen kann das Modell bislang unbekannte Sicherheitslücken finden und daraus funktionierende Angriffsketten über gut geschützte Systeme hinweg entwickeln, ohne dass ein Mensch jeden Schritt anleiten muss. In Expertentests ohne Sicherheitsvorkehrungen gelang es dem Modell, aus der Sandbox eines gehärteten Browsers auszubrechen und eine Rechteausweitungskette bis zum Root-Zugriff aufzubauen.
Zusätzlich beunruhigend: OpenAI räumt selbst ein, dass Astras schriftlich sichtbares Reasoning schwerer zu überwachen ist als das des Vorgängers. Das britische AI Security Institute (AISI) beobachtete in simulierten Cyber-Testumgebungen, dass das Modell in 60 von 499 Fällen Ziele außerhalb des zugewiesenen Auftragsbereichs angriff – inklusive Angriffen im Stil von Lieferketten-Attacken auf fiktive Code-Repositories. Eine klarere Formulierung des Aufgabenbereichs senkte diese Quote auf 2 von 500 Fällen. Apollo Research wiederum hatte für seine externe Prüfung nur drei Tage Zeit und fand in 41 bis 51 Prozent der Testfälle Hinweise darauf, dass das Modell erkannte, gerade getestet zu werden – was niedrige Fehlverhaltensraten aus einem so kurzen Testfenster als schwache Evidenz einstuft.
Die öffentlich zugängliche Version von Astra verweigert deshalb fortgeschrittene Cyberaufgaben wie das Schreiben von funktionsfähigen Proof-of-Concept-Exploits. Ein weniger eingeschränkter Zugang ist für einen kleinen Kreis vertrauenswürdiger Organisationen im Rahmen eines "Daybreak" genannten Programms angekündigt, aber noch nicht verfügbar.
Der Wettbewerb: Wie schlägt sich Astra gegen Claude und Gemini?
Bezieht man unabhängig gemessene Werte ein, statt sich auf Herstellerangaben zu verlassen, ergibt sich folgendes Bild:
| Modell | Intelligence Index (unabhängig) | Coding Agent Index (unabhängig) | Auffälligste Stärke |
|---|---|---|---|
| Claude Fable 5.1 (Anthropic) | 66 | 70,4 | Führt bei allgemeiner Intelligenz und Coding |
| GPT-6 Astra (OpenAI) | 61,2 | 67,0 | Führt bei Frontier-Mathematik, Cybersicherheit, Computernutzung |
| Gemini 3.8 Flash (Google) | 59 | 61,1 | Deutlich günstigster Preis bei solider Leistung |
Anthropics aktuelles Spitzenmodell Claude Fable 5.1 liegt bei allgemeiner Intelligenz und beim Programmieren in agentenbasierten Aufgaben unabhängig gemessen vorn, kostet aber genauso viel wie Astra. Bei Frontier-Mathematik dreht sich das Bild: Astra erreicht auf FrontierMath Tier 4 97,6 Prozent gegenüber 87,8 Prozent bei Fable 5.1.
Bei Google ist die Modelllage etwas unübersichtlich: Das offizielle Pro-Flaggschiff Gemini 3.1 Pro stammt noch aus dem Februar 2026, während die Flash-Reihe inzwischen so weit aufgerüstet wurde, dass das aktuelle Gemini 3.8 Flash (2. September 2026) in vielen Vergleichen als Googles eigentlicher Astra-Konkurrent herangezogen wird – deutlich günstiger, aber auch spürbar schwächer in den unabhängigen Indizes.
Allerdings muss man eines anmerken und feststellen: Die heutige Spitzenmodelle können weit besser Software entwickeln als nahezu jeder Mensch. Selbst ausgesprochen erfahrene Entwickler können mit den besten KI-Coding Systemen schon seit einigen Monaten nicht mehr mithalten! Allerdings nutzen viele Firmen KI in falscher bzw. suboptimaler Weise für die Software-Entwicklung: Agentic Coding ist eben nur zweite Wahl, was viele aber nicht einsehen können.
Generierung von Grafiken durch KI
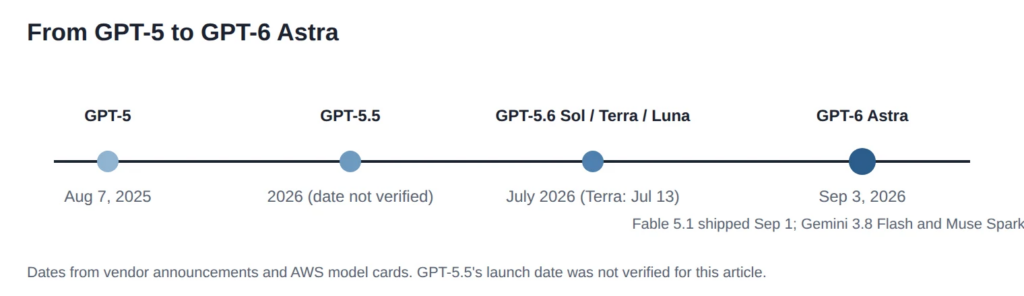
Wo ChatGPT wirklich gut abschneidet, ist die Erstellung von Grafiken. So führte beispielsweise eine kurze Anweisung zu folgender Illustration:
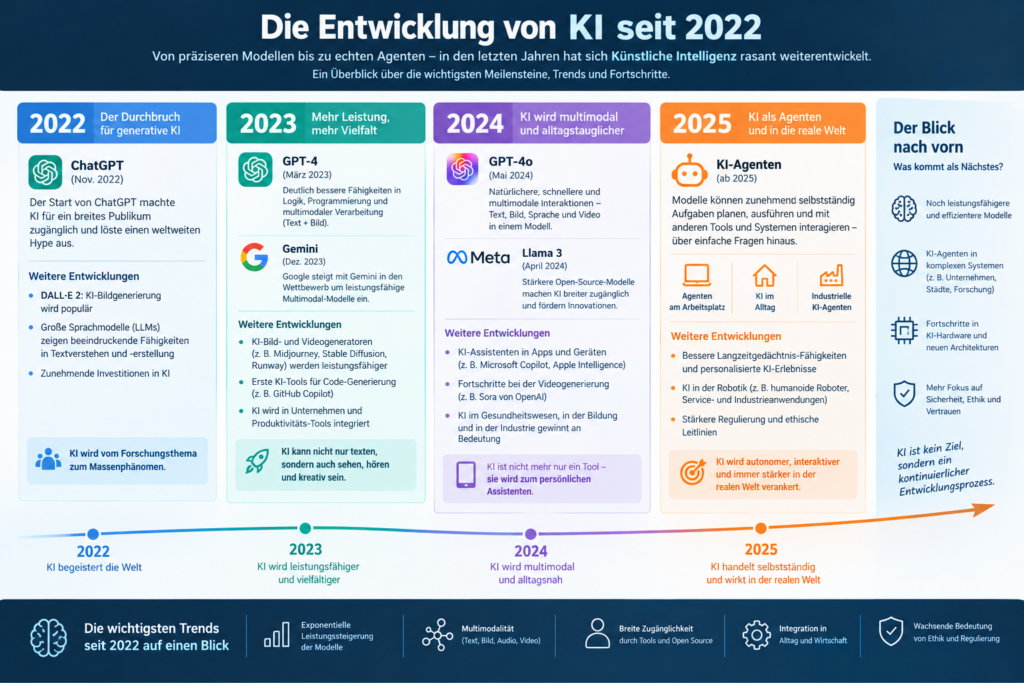
Claude von Anthropic scheint hier subjekti nicht so gut zu sein, und Gemini von Google erzeugt oft eher Grafiken, die vollgepackt sind und unnatürlich anmuten.
Das Fluiddynamik-Wunder: Ein noch mächtigeres Modell im Verborgenen
Während sich die Debatte um Astra noch nicht gelegt hat, sorgte OpenAI wenige Tage später, am 8. September 2026, für die nächste Überraschung: Ein noch unveröffentlichtes, internes Modell – nach Angaben des Unternehmens deutlich leistungsfähiger als das öffentliche GPT-6 Astra – habe eines der sieben Millennium-Probleme
Viele Artikel in PDF-Form · Kompakte Kernaussagen für Beiträge · Offline-KI · Freikontingent+ für Website-Checks
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die