 gekennzeichnet.
Der Siegeszug von Sprachmodellen brachte eine neue Selbstverständlichkeit zutage: Je größer und klüger ein LLM, desto mehr lässt sich damit automatisieren. Ein neues KI-Labor stellt genau das infrage. Mit Jev bringt TypeSafe AI das erste Modell einer neuen Klasse an den Start – kein weiterer Chatbot, sondern ein „System One Model“, das keine Texte schreibt, sondern kalibrierte Entscheidungen liefert, die Software direkt verarbeiten kann. Was steckt hinter diesem Ansatz, wie unterscheidet er sich von klassischen Sprachmodellen und was sagen die Zahlen wirklich aus?
Einleitung
Seit dem Erfolg von ChatGPT gilt eine einfache Gleichung: je größer und schlauer das Sprachmodell, desto mehr Aufgaben kann es automatisieren. Das amerikanische KI-Labor TypeSafe AI stellt diese Annahme nun infrage. Am 15. September 2026 hat das Unternehmen mit Jev sein erstes Modell einer neuen Modellklasse vorgestellt, die es System One Models nennt – gebaut nicht für Dialoge mit Menschen, sondern für schnelle, strukturierte Entscheidungen innerhalb von Software. Der folgende Artikel ordnet ein, was Jev ist, wie es funktioniert und wofür es gedacht ist – auf Basis der offiziellen Ankündigung von TypeSafe AI.
Weiter unten gibt es als klenes Extra sogar einen Praxistest mit lokaler KI auf einem Notebook, also Jev auf der eigenen Hardware. Dafür wurde ein Open-Source Modell verwendet, welches kurz nach dem Launch von Jev auf den Markt kam.
Die Nachfrage nach Jev war so groß, dass die Anmeldung gesperrt wurde.
Quelle: Registrierdialog von Typesafe AI für JEv
Die Ausgangsfrage: Warum ist trotz superintelligenter Chatmodelle noch so wenig automatisiert?
Diogo Almeida, Gründer von TypeSafe und zuvor an der Entwicklung von ChatGPT bei OpenAI beteiligt, beschreibt in seiner Ankündigung genau diese Beobachtung: Sprachmodelle sind seit Jahren im Chat beeindruckend leistungsfähig, doch der breite Durchbruch bei der Automatisierung von Geschäftsprozessen ist bislang ausgeblieben. Seine These: Große Sprachmodelle (LLMs) sind für Dialoge mit Menschen optimiert – nicht für den Einsatz als Baustein innerhalb von Software.
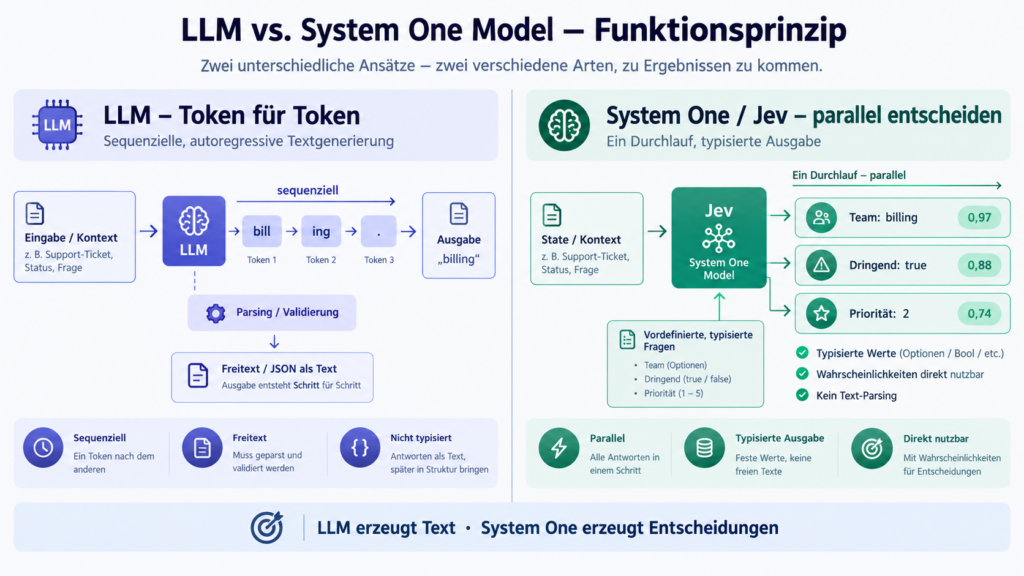
Klassische LLMs erzeugen ihre Antworten als Text, Token für Token, jeweils abhängig vom vorherigen Token. Das macht sie enorm flexibel: Sie können Prosa schreiben, Code generieren oder Fragen beantworten. Für den Einsatz in Software bringt dieses Prinzip aber drei Probleme mit sich:
- Die Ausgabe ist eine Zeichenkette, die erst geparst und validiert werden muss, bevor Programme sie nutzen können.
- Es besteht immer ein Risiko, dass das Modell „von der Spur abkommt“ – etwa durch Halluzinationen oder unerwartete Formate.
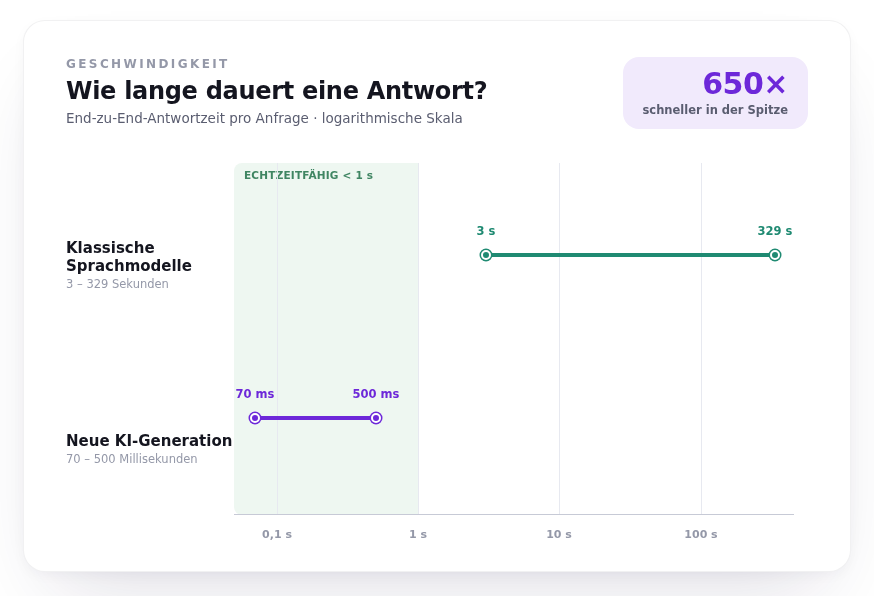
- Die sequenzielle Erzeugung braucht Zeit: Bei führenden Modellen liegt die Antwortzeit typischerweise zwischen wenigen Sekunden und mehreren Minuten. Für ein Gespräch mit einem Menschen ist das akzeptabel, als Baustein in einer Softwarekette mit Latenzanforderungen wird es schnell zum Flaschenhals.
Genau an diesem Punkt setzt TypeSafe an.
Was ist ein „System One Model“?
Der Name ist eine bewusste Anspielung auf Daniel Kahnemans Buch Thinking, Fast and Slow. Kahneman unterscheidet zwischen „System 1“ – schnellem, intuitivem Denken – und „System 2“ – langsamem, bewusstem Schlussfolgern. TypeSafe überträgt diese Metapher auf KI-Modelle:
Während heutige LLMs mit ihren langen Gedankenketten eher dem bedächtigen „System 2“ ähneln, sollen System One Models die schnellen, intuitiven Entscheidungen übernehmen, die in Software ständig anfallen. Das ist vergleichbar mit unzähligen kleinen „Wenn-dann“-Weichenstellungen, die bislang entweder hart codiert oder mühsam von langsamen LLMs getroffen werden mussten.
Wichtig ist dabei die Unterscheidung bei Input und Output:
- Eingabe: Wie bei LLMs unstrukturierte Daten, etwa Text – bei System One Models jedoch mit Fokus auf strukturiertem Programmzustand statt auf fortlaufenden Chat-Nachrichten.
- Ausgabe: Keine frei generierten Zeichenketten, sondern typsichere, strukturierte Werte, deren mögliche Formen vorab genau definiert werden. Jede Antwort wird zusätzlich mit einer kalibrierten Wahrscheinlichkeit beziehungsweise einem Konfidenzwert ausgeliefert.
TypeSafe bringt das Konzept auf eine Formel: Jev sei im Grunde ein „Function Call mit Frontier-Intelligenz“ – unstrukturierter Zustand hinein, typisierte, probabilistische Entscheidung heraus.
Die technische Basis: neue Architektur, paralleles Sampling, neues Training
Um dieses Ziel zu erreichen, hat TypeSafe nach eigenen Angaben einen komplett neuen technischen Unterbau entwickelt, bestehend aus drei Komponenten:
1. Eine neue Modellarchitektur, die von Grund auf für strukturierte Entscheidungen statt für Textgenerierung ausgelegt ist.
2. Ein paralleler Sampler. Während klassische LLMs ihre Ausgabe Token für Token erzeugen, berechnet Jev alle möglichen Antworten in einer einzigen Anfrage parallel. Das ist deutlich hardware-effizienter und einer der Hauptgründe für den enormen Geschwindigkeitsvorteil.
3. Ein neues Trainingsverfahren namens „Reinforcement Learning for Calibrated Decisions“ (RLCD). Klassische LLMs werden meist mit RLHF (Reinforcement Learning aus menschlichem Feedback) oder RLVR (Reinforcement Learning mit verifizierbaren Belohnungen) trainiert – optimiert also darauf, Antworten zu erzeugen, die Menschen bevorzugen oder die sich automatisch verifizieren lassen. RLCD optimiert stattdessen direkt auf kalibrierte Entscheidungen: Das Modell soll nicht nur die richtige Antwort geben, sondern auch ehrlich einschätzen, wie sicher es sich dabei ist.
Diese Kalibrierung ist ein zentrales Verkaufsargument von TypeSafe. Die Idee dahinter: Ein Modell, das eine Aufgabe zu 95 Prozent richtig löst, aber nicht signalisiert, wann es zu den restlichen 5 Prozent gehört, lässt sich schwer verlässlich automatisieren – man weiß nie, wann man dem Ergebnis vertrauen kann. Jev soll bei jeder Ausgabe mitliefern, wie sicher die Antwort ist, und dabei tatsächlich konsistent sein: höhere angegebene Konfidenz soll auch tatsächlich höherer Genauigkeit entsprechen.
Jev im direkten Vergleich zu klassischen LLMs
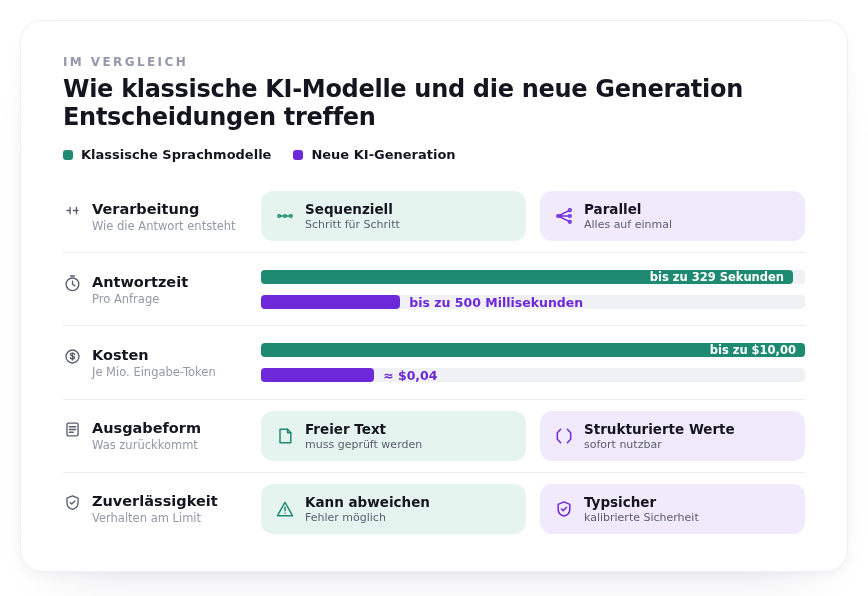
TypeSafe stellt in seiner Ankündigung eine ausführliche Vergleichstabelle zwischen „bestehenden LLMs“ und „System One + Jev“ auf. Die wichtigsten Punkte zusammengefasst:
| Merkmal | Klassische LLMs | Jev / System One |
|---|---|---|
| Ausgabeformat | Freier Text, muss nachträglich geparst werden | Vorab definierte, typsichere Werte |
| Sampling | Sequenziell, Token für Token | Parallel, alle Ausgaben in einem Schritt |
| Antwortzeit | Rund 3 bis 329 Sekunden bei Spitzenmodellen | Rund 70 bis 500 Millisekunden |
| Kosten Input | 0,20 bis 10 US-Dollar pro Million Token | 0,042 US-Dollar pro Million Token |
| Kosten Output | Meist etwa das 5-Fache der Input-Kosten | Kostenlos |
| Konfidenzangabe | Oft überzogen selbstbewusst und inkonsistent | Systematisch kalibriert |
| Typische Einsatzfelder | Chatbots, Copiloten, Coding-Agenten mit menschlicher Aufsicht; verifizierbare Probleme wie Beweise; schnelle Prototypen | Klassifikation, Routing, Scoring und Verzweigungslogik in Software; Verarbeitung großer Datenmengen; Echtzeitanwendungen; Prüfen und Absichern von KI-Ausgaben |
Bei den Kostenangaben ist Vorsicht geboten: Es handelt sich um Preise, die TypeSafe selbst festlegt und die – wie das Unternehmen selbst einräumt – möglicherweise (noch) subventioniert sind. Ob sich das Preismodell langfristig trägt, lässt sich naturgemäß erst mit der Zeit beurteilen.
Was ist das Neue und Revolutionäre?
Jev besitzt einige Merkmale, die für eine Revolution auf dem Markt sorgten.
Die Inferenzkosten von Jev, also die Nutzungskosten, sind um eine Größenordnung geringer als bei den anderen Frontier-Modellen von OpenAI, Anthropic und Google. Jev liefert nebenbei eine garantierte Antwortstruktur, also ein wohl definiertes Ausgabeformat.
Gleichzeitig liegt die Antwortgeschwindigkeit von Jev im Bereich von Millisekunden – statt wie bei ChatGPT & Co im Sekundenbereich. Das eröffnet ganz neue Möglichkeiten, vor allem für KI-Agenten.
Wichtig ist, dass die Antwortqualität von Jev als ebenso gut empfunden wird wie von den besten KI-Sprachmodellen, die es aktuell gibt.
So können beispielsweise Klassifikationsaufgaben, die sehr viele KI-Aufrufe erfordern, ausgesprochen wirtschaftlich und schnell erledigt werden. Aber auch das Steuern von Echtzeitanwendungen, wie Spielen oder Apps, ist so besser möglich.
Mittlerweile, also wenige Tage nach dem Launch von Jev, gibt es Open-Source Modelle mit gleichem Antwortverhalten. Ein Modell gibt an, in Benchmarks sogar besser als Jev abzuschneiden. Die Geschwindigkeit würde wahrscheinlich auf spitzen-Hardware ähnlich hoch sein. Die Kosten sind bei lokaler KI jedenfalls bei null, wenn die Hardware einmal angeschafft oder die pauschale Miete für den KI-Server beglichen wurde. Die Datensicherheit ist jedenfalls mit lokaler KI beim Maximum, was man von Jev nicht behaupten kann.
Mit herkömmlichen LLMs wären Antworten wie die von Jev auch möglich gewesen bzw. sind es. Mit folgenden Einschräkungen:
- Die Antwortgeschwindigkeit ist typischerweise langsamer.
- Die Antwortqualität ist typischerweise etwas schlechter.
- Das Ausgabeformat ist nicht zu 100% garantiert, wenngleich meist zu weit über 90% korrekt.
Realer Test mit lokaler KI
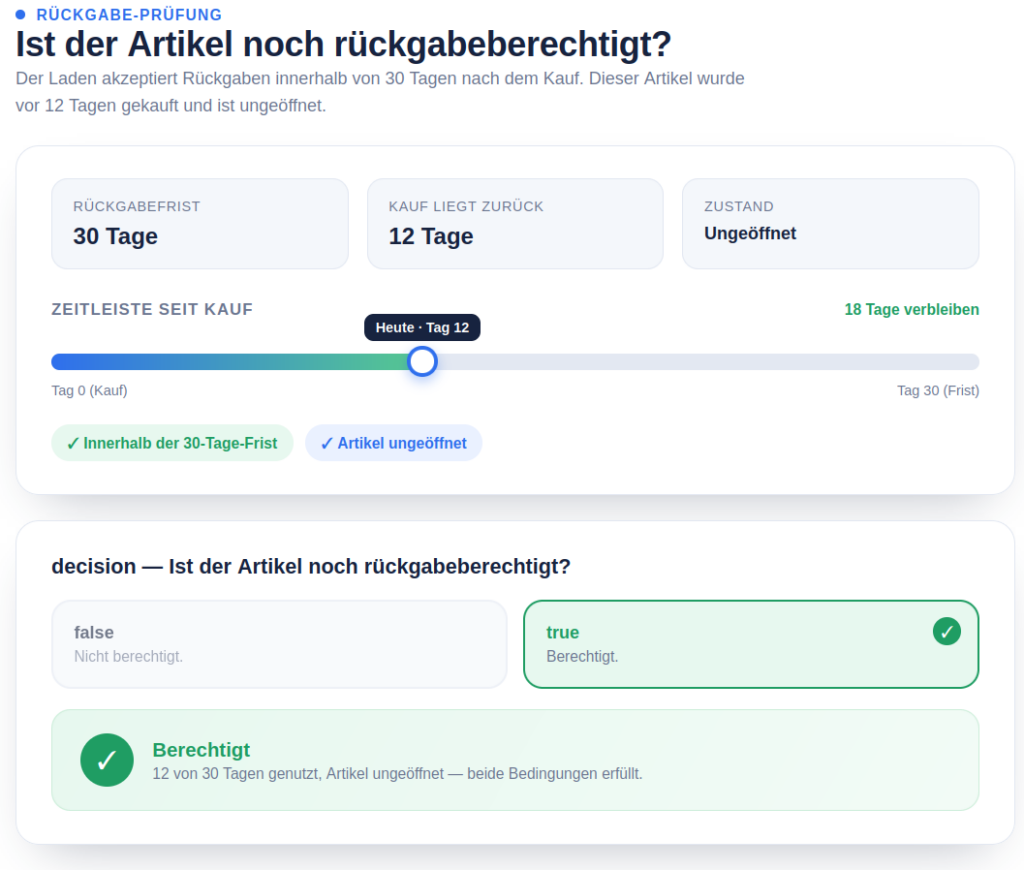
Auf Consumer Hardware (KI Laptop, ca. 3 Jahre alt) wurde folgende Klassifikationsaufgabe an die KI über ein lokales KI-Modell ähnlich Jev gestellt:
Im Programm sieht diese Frage so aus:
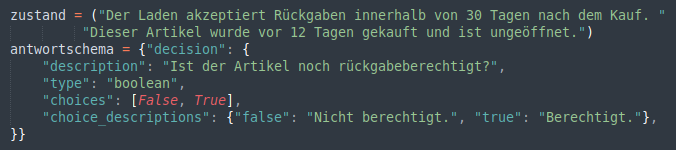
Diese Frage wurde 100 Mal hintereinander in das lokale Modell gegeben und 100 Mal beantwortet. Jede Antwort lag im Schnitt nach 56 Millisekunden vor:
Das Modell entschied: Zu 95,7% ist die Rückgabe berechtigt.
Die Antwort war also sehr gut und zugleich sehr schnell da. Für eine Validierung des Ergebnisses wurde der Test erneut durchgeführt – diesmal wieder 100 Mal, aber jedesmal mit einer anderen Frage. Dabei wurden die Fragen sogar so variiert, dass das Kaufdatum mal vor und mal nach dem Rückgabezeitraum liegt, und dass der Artikel mal ungeöffnet, mal beschädigt usw. war. Die Antwortgeschwindigkeit war identisch!
Übrigens können auch mehr als zwei Antwortmöglichkeiten vorgegeben werden. Beispielsweise:
- Nicht berechtigt, weil zu spät zurückgeschickt.
- Nicht berechtigt, weil Artikelzustand zu schlecht.
- Nicht berechtigt, weil zu spät zurückgeschickt und weil Artikelzustand zu schlecht.
- Unsicher.
- Berechtigt.
Bei 100 Durchläufen mit geänderten Fragestellungen (=Käufer hat Artikel nach X Tagen im Zustand Y mit X und Y variierend) sieht man auch gleich, dass es auf präzise Fragestellungen ankommt: Wird ein Artikel zurückgenommen, wenn er innerhalb der Rückgabezeit, aber beschädigt zurückgeschickt wird?
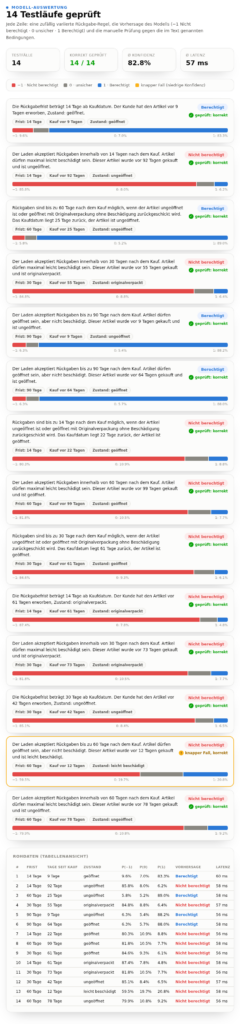
Die Ergebnise, die mit lokaler KI ermittelt wurden, sind als Auszug (14 von 100) im Bild eben zu sehen. Die Beurteilung der Ergebnisse erfolgte über ein Frontier-Modell. Wie man sieht, stimmt hier alles – bei zugleich sehr guter Antwortgeschwindigkeit (Laptop!).
Die vorgelegten Beweise: Was TypeSafe zeigt und was offenbleibt
Bemerkenswert an der Ankündigung ist, dass TypeSafe selbst betont, „außergewöhnliche Behauptungen brauchen außergewöhnliche Belege“, und versucht, seine Zahlen einzuordnen, statt sie unkommentiert zu präsentieren. Typesafe hat dafür ein Lernverfahren namens Reinforcement Learning for Calibrated Decisions (RLCD) eingeführt.
Drei Kategorien von Belegen werden genannt:
Geschwindigkeit und Kosten pro Anfrage lassen sich nach Angaben von TypeSafe leicht selbst nachprüfen, allerdings mit der Einschränkung, dass die veröffentlichten Messungen von der US-Westküste stammen, wo der eigene Dienst gehostet wird.
Als Smartphones auf den Markt kamen, war die sofortige Verfügbarkeit des Betriebssystems nach dem Einschalten ein Game Changer.
Zuvor musste man einen "Plan" machen, wenn man seinen PC anschalten wollte, was oft Minuten dauerte.
Keine Typfehler sei mathematisch garantiert, da das Ausgabeformat durch das Schema selbst erzwungen werde – ein einziger Gegenbeweis würde die Aussage widerlegen, weshalb TypeSafe hier von einer harten, überprüfbaren Garantie spricht.
Workflow-Benchmarks: Um zu messen, wie gut ein Modell tatsächlich innerhalb von Software funktioniert, hat TypeSafe einen eigenen Evaluationsansatz entwickelt. Statt gegen eine feste „Musterlösung“ zu testen, vergleicht man die Vorhersagen verschiedener Modelle mit dem Durchschnitt besonders großer Referenzmodelle (in diesem Fall zwei aktuelle Spitzenmodelle von OpenAI und Anthropic) auf denselben, vorab in Code definierten Entscheidungsabläufen. Nach diesen Tests soll Jev bei vergleichbarer Qualität rund 193,6-mal schneller und 444,6-mal günstiger sein als die Referenzmodelle – TypeSafe weist aber selbst darauf hin, dass es sich dabei eher um die obere Grenze dessen handelt, was in der Praxis zu erwarten ist.
Bei der Halluzinationsrate vergleicht TypeSafe die eigene, garantiert fehlerfreie Schema-Einhaltung mit Werten für gängige LLMs, die über den Dienst OpenRouter erhoben wurden – auch hier räumt das Unternehmen mögliche Verzerrungen ein, etwa weil komplexere Anfragen tendenziell an leistungsfähigere Modelle weitergeleitet werden.
Insgesamt macht die Ankündigung an mehreren Stellen transparent, wo mögliche Verzerrungen in den eigenen Vergleichsdaten liegen könnten – etwa durch die Wahl der Referenzmodelle oder dadurch, dass die Testszenarien vom eigenen Team erstellt wurden. Das ist ungewöhnlich offen für eine Produktankündigung, ändert aber nichts daran, dass es sich um unternehmenseigene Zahlen handelt, die bislang nicht unabhängig reproduziert wurden.
Die drei Aufrufmodi von Jev in der Praxis
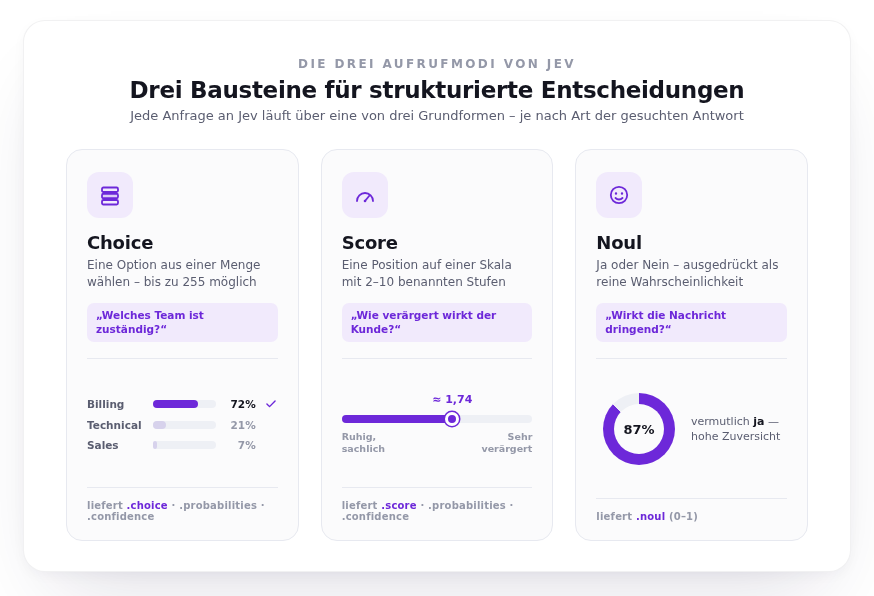
Jev unterscheidet nicht zwischen „einer" Art von Anfrage. Stattdessen bringt es drei feste Grundformen mit, auf die sich praktisch jede automatisierbare Entscheidung abbilden lässt. Ein Blick auf jede der drei anhand eines konkreten Beispiels macht den Unterschied greifbar.
Choice – eine Option aus einer Menge wählen
Choice kommt immer dann zum Einsatz, wenn aus mehreren klar benannten Möglichkeiten genau eine ausgewählt werden soll – etwa bei der Frage, welches Team ein eingehendes Support-Ticket bearbeiten sollte:
Choice(
    instructions="Welches Team sollte sich darum kümmern?",
    criteria={
        "billing": "Zahlungs- oder Abo-Probleme",
        "technical": "Bugs oder Integrationsprobleme",
        "sales": "Fragen zu Preisen oder Konditionen",
    },
)
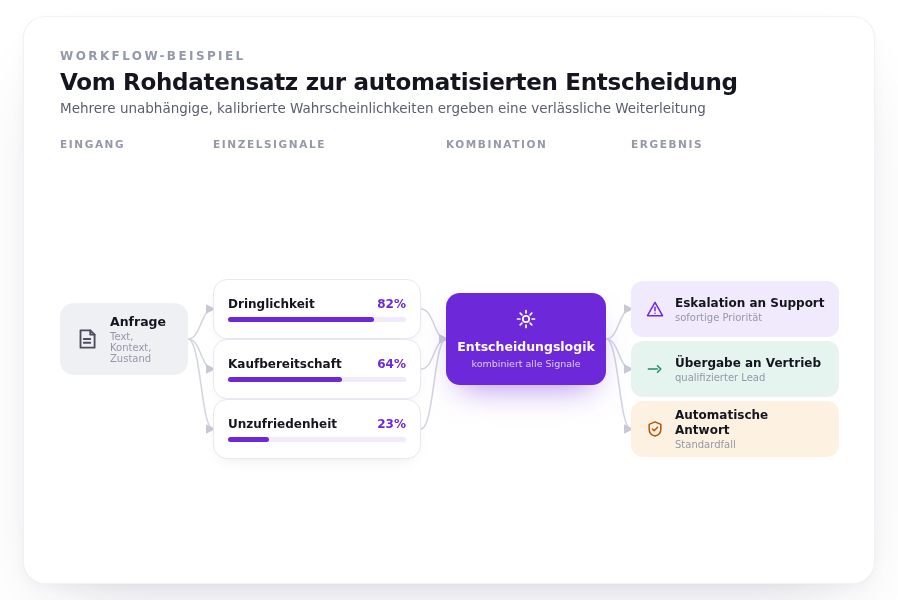
Jev liefert dabei nicht nur die gewählte Option zurück, sondern für jede der bis zu 255 möglichen Optionen eine eigene Wahrscheinlichkeit – im Beispiel etwa 72 % für „billing", 21 % für „technical" und 7 % für „sales". Erst daraus ergibt sich die eigentliche Auswahl, inklusive eines Confidence-Werts für die gesamte Entscheidung.
Score – eine Position auf einer Skala einordnen
Nicht jede Entscheidung ist eine Wahl zwischen diskreten Kategorien – manche Dinge bewegen sich auf einem Spektrum. Für diesen Fall gibt es Score, mit zwei bis zehn benannten Stufen als Ankerpunkten:
Score(
    instructions="Wie verärgert wirkt der Kunde?",
    criteria=[
        "Freundlich und berechtigt",
        "Ruhig, schildert nur die Fakten",
        "Freundlich, aber unzutreffend",
        "Frustriert, aber sachlich",
        "Sehr wütend, deutliche Wortwahl",
    ],
)
Das Besondere: Der zurückgegebene Wert muss nicht exakt auf einer der Stufen landen. Ein Ergebnis wie 1,74 ist völlig normal und bedeutet „zwischen frustriert und sehr wütend, aber näher an ersterem" – eine feinere Auflösung, als es die drei benannten Stufen allein hergeben würden.
Noul – Ja oder Nein als reine Wahrscheinlichkeit
Der dritte Modus ist der einfachste: Noul beantwortet eine einzelne Ja/Nein-Frage, allerdings nicht als hartes „wahr" oder „falsch", sondern als Zahl zwischen 0 und 1:
Noul(instructions="Wirkt die Nachricht dringend oder zeitkritisch?")
Eine Ausgabe von 0,87 heißt: „vermutlich ja, mit hoher Zuversicht" – ganz ohne separates Confidence-Feld, weil die Wahrscheinlichkeit selbst schon die Sicherheit der Einschätzung transportiert. Gerade für einfache Vorprüfungen oder Filterregeln in bestehender Software ist das oft genau die Granularität, die gebraucht wird – nicht mehr und nicht weniger.
Typische Einsatzszenarien für Jev
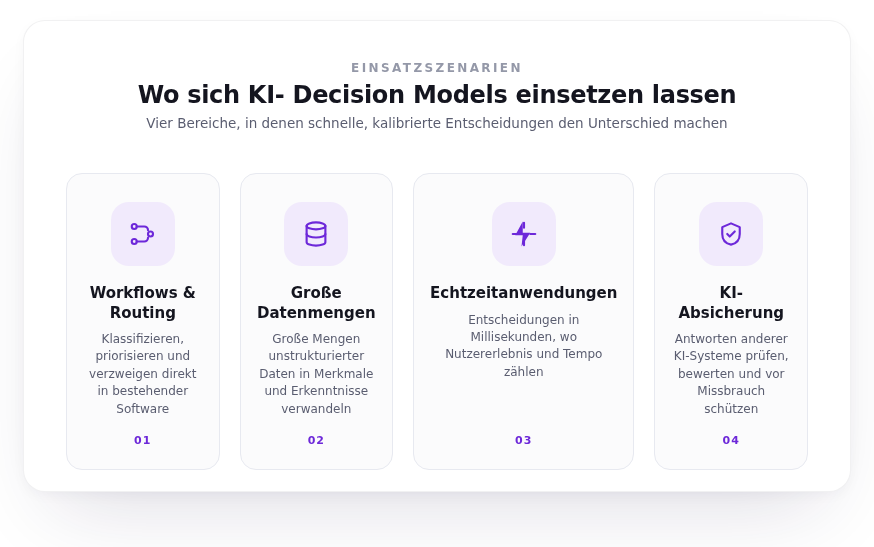
Aus der Ankündigung lassen sich vier Haupteinsatzfelder ableiten, für die Jev konzipiert wurde:
- KI-gestützte Workflows („intelligente Wenn-Dann-Regeln“): Strukturierte Entscheidungen lassen sich direkt in bestehende Software einbauen, um zu klassifizieren, zu routen, zu bewerten oder zu verzweigen – überall dort, wo klassisch programmierte Regeln zu starr wären.
- Verarbeitung großer Datenmengen (Map-Reduce): Große Datenmengen sollen sich effizient in Merkmale und Erkenntnisse umwandeln lassen.
- Echtzeitanwendungen: Antwortzeiten im Bereich von 100 Millisekunden erlauben laut TypeSafe den Einsatz von KI-Entscheidungen dort, wo Nutzererfahrung und Geschwindigkeit entscheidend sind.
- Absicherung anderer KI-Systeme: Jev soll sich eignen, um Prompts, Reasoning-Ketten oder Ausgaben anderer LLMs zu bewerten, zu prüfen oder als Schutzschicht gegen Jailbreak-Versuche einzusetzen.
Zur Veranschaulichung hat TypeSafe zwei spielerische Demos veröffentlicht: Ein KI-gesteuerter Bot, der in Echtzeit den Ego-Shooter-Klassiker Doom spielt – als Demonstration dafür, wie schnell das Modell auf sich ändernde Spielzustände reagieren kann – sowie ein „Wikiracing“-Experiment, bei dem eine KI durch reines Klicken auf Wikipedia-Links von einer Startseite zu einer vorgegebenen Zielseite navigieren muss. Beide Demos sollen vor allem zeigen, wie sich Geschwindigkeit und die Vermeidung von Halluzinationen bei vielen aufeinanderfolgenden Entscheidungen gegenseitig verstärken.
Woher kommt der Name „Jev“?
Auch das erklärt TypeSafe in seiner FAQ: Der Name geht auf den britischen Ökonomen William Stanley Jevons zurück, bekannt für das nach ihm benannte „Jevons-Paradoxon“. Es besagt, dass eine effizientere Nutzung einer Ressource – historisch etwa Kohle nach der Verbesserung der Dampfmaschine – paradoxerweise nicht zu weniger, sondern zu mehr Gesamtverbrauch führen kann, weil die gestiegene Effizienz neue Anwendungen erst wirtschaftlich macht. TypeSafe erwartet, dass sich maschinelle Intelligenz ähnlich entwickelt: Jede Größenordnung, um die die Kosten für KI-Entscheidungen sinken, soll neue, bislang unwirtschaftliche Anwendungsfälle erschließen.
Einordnung: Was bedeutet das für die KI-Landschaft?
Die Idee hinter System One Models trifft einen wunden Punkt der aktuellen KI-Debatte: Der Sprung von beeindruckenden Chat-Antworten zu zuverlässiger, alltäglicher Automatisierung ist bislang tatsächlich kleiner ausgefallen, als es die reine Modellgröße vermuten ließe. Statt zu versuchen, Sprachmodelle über Prompt-Engineering und immer aufwendigere Agenten-Architekturen in verlässliche Entscheidungssysteme zu verwandeln, geht TypeSafe den umgekehrten Weg: ein spezialisiertes Modell, das von vornherein für genau diesen Zweck gebaut ist – auf Kosten der Fähigkeit, freien Text zu erzeugen.
Ob sich dieser Ansatz durchsetzt, ist aus heutiger Sicht offen. Für ein abschließendes Urteil braucht es unabhängige Tests und Erfahrungswerte aus dem produktiven Einsatz, die über die – wenn auch ungewöhnlich transparent kommentierten – hauseigenen Benchmarks von TypeSafe hinausgehen. Bemerkenswert bleibt in jedem Fall die Grundidee: Nicht jedes KI-Problem braucht ein möglichst großes, generalistisches Sprachmodell. Für viele der kleinen, häufigen Entscheidungen, die in Software täglich millionenfach anfallen, könnte ein schnelles, kalibriertes, spezialisiertes Modell wie Jev der pragmatischere Weg sein.
Fazit: Jev ist kein weiteres Chatmodell, sondern ein Versuch, KI-Entscheidungen so in Software einzubetten, wie man heute eine Funktion aufruft – schnell, typsicher und mit einer ehrlichen Einschätzung der eigenen Unsicherheit. Ob aus diesem Ansatz tatsächlich eine neue, eigenständige Modellklasse wird, wie TypeSafe es sich erhofft, wird sich in den kommenden Monaten zeigen, wenn erste Entwicklerinnen und Entwickler außerhalb des Unternehmens eigene Erfahrungen mit Jev sammeln.
Vor allem werden sicherlich Open Source Modelle auf den Markt gebracht werden, die genau wie Jev funktionieren – mit dem feinen Unterschied, dass keine Daten nirgendwo hin geschickt werden müssen. Übrigen können Unternehmen mit entsprechend relevanten Use Cases bereits heute (bzw. seit Jahren schon) derartige Modelle selbst für sich erschaffen (Pre-Training).
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die