OpenAI zaprezentowało w listopadzie 2026 r. GPT-6 Cyber, model do wyszukiwania luk w zabezpieczeniach. Nowa jest nie tyle technika, ile skala: w aktualnym jądrze Linuksa agenci znaleźli ok. 1700 potwierdzonych błędów, a każde znalezisko ma swoją cenę. Dla firm bez własnego działu rozwoju o sytuacji decyduje to, jak szybko poprawki trafiają na urządzenia.
Wiosną Anthropic poinformował o nieopublikowanym modelu, który miał znaleźć tysiące nieznanych dotąd podatności w systemach operacyjnych i przeglądarkach. Niedługo później pojawił się Gemini 4 Carbon od Google z wyraźnie lepszymi wynikami w benchmarkach exploitów. Dzięki zapowiedzi OpenAI przebieg analizy całego jądra można wreszcie opisać kosztami i wynikami.
Kto znajduje błędy tak tanio, z konieczności generuje wiele poprawek. Serwery, firewalle, systemy NAS i kamery niemal wszystkie działają na Linuksie, a jądro w większości firm utrzymuje ktoś inny.
GPT-6 Cyber w skrócie
GPT-6 Cyber to specjalna odmiana GPT-6 Astra do autoryzowanych prac z zakresu bezpieczeństwa. Model wyszukuje podatności, buduje pasujące exploity i proponuje poprawki. W Model Card OpenAI zalicza jego zdolności cybernetyczne do najwyższego poziomu własnego Preparedness Framework. W benchmarku exploitów ExploitGym rozwiązuje ok. 48% zadań, model bazowy ok. 42%.
Starsze benchmarki mogą być zawyżone przez dane treningowe, niezawodne wykorzystanie świeżo opublikowanych luk pozostaje trudne, a w pełni utwardzone cele się obroniły. Model wyznacza wyraźny kierunek, ale nie pokonuje każdego celu.
Dostęp jest na razie ograniczony do wybranych, zweryfikowanych klientów. Odbywa się przez API i Codex, z weryfikacją tożsamości, uwierzytelnianiem wieloskładnikowym i zatwierdzonymi adresami IP. OpenAI zaleca uruchamianie modelu w izolacji i pod nadzorem człowieka. Zapowiedziano stopniowe rozszerzanie dostępu, terminu dla wszystkich nie ma.
Błędy jądra na dużą skalę
Sercem projektu jest przebieg analizy aktualnego jądra Linuksa. Najpierw agenci zawęzili obszary istotne dla bezpieczeństwa, ok. 7% kodu. Kolejni agenci oznaczyli tam ok. 2300 podejrzanych miejsc, a w izolowanych maszynach wirtualnych udało się potwierdzić ok. 1700 z nich. Testy przeprowadzono na niezmodyfikowanym desktopowym Linuksie ze standardowymi mechanizmami ochrony, które mają uniemożliwić atakującym odgadnięcie adresów pamięci.
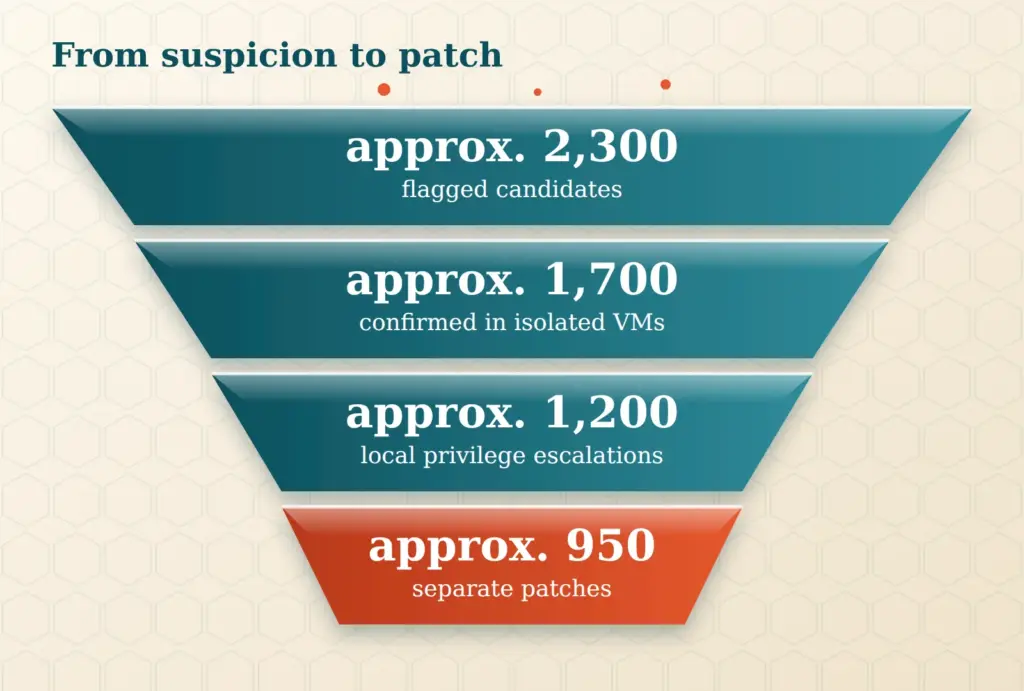
Z potwierdzonych błędów powstało ok. 1200 działających lokalnych eskalacji uprawnień, w których zwykłe konto staje się administratorem. Stoi za nimi ok. 950 osobnych poprawek. Setki znalezisk prowadzą więc do setek poprawek. Opiekunowie jądra zareagowali szybko: w ciągu dziesięciu dni ponad 100 eskalacji uprawnień zostało załatanych lub miało poprawki w przygotowaniu, a ok. 300 kolejnych omawiano publicznie.
Nowa jest też cena. Przebieg kosztował ok. 1,2 mln dolarów w opłatach za API, czyli w przybliżeniu 1300 dolarów za wynik. Wcześniejszy skan latem dał ok. 170 eskalacji uprawnień za ponad 500 000 dolarów, nowy przebieg przynosi wielokrotnie więcej znalezisk przy mniej więcej dwukrotnie wyższych kosztach. Wyszukiwanie podatności staje się w ten sposób przewidywalną pozycją kosztową, porównywalną z czasem obliczeniowym w chmurze. W Firefoksie model znalazł ponadto ok. 80 nieznanych wcześniej poważnych luk, które Mozilla usunęła.
Setki poprawek a cykle aktualizacji
Samo znalezisko nikogo nie chroni. Sytuację zmienia dopiero poprawka w jądrze, a potem jej instalacja na urządzeniu. Liczba identyfikatorów CVE na wydanie jądra mocno rośnie, przy ok. 40 mln wierszy kodu. Wiele z nich dotyczy błędów o niskim priorytecie, ale tempo, w jakim pojawiają się aktualizacje serwisowe, wyraźnie przyspiesza.
Krytyczny jest okres między opublikowaniem poprawki a zainstalowaniem aktualizacji. Gdy tylko łatka jest publiczna, pokazuje atakującym, gdzie tkwił błąd. Otwarty model przekształcił znane, ale jeszcze niedostarczone poprawki Firefoksa w działające ataki za ok. 1000 dolarów na wersję, choć tylko do odczytu plików na standardowym Ubuntu. Każda publiczna poprawka jest więc planem budowy dla atakujących.
Wąskim gardłem nie jest już wykrywanie błędów, lecz terminowe instalowanie poprawek.
Lokalna eskalacja uprawnień wymaga pierwszego dostępu, na przykład skradzionego hasła, webshella albo ucieczki z kontenera. Kto go ma, dzięki takiej luce dochodzi do roota. Dlatego lokalne błędy jądra liczą się także na serwerach dostępnych wyłącznie przez sieć. Nie każde znalezisko da się wykorzystać i nie każdy serwer jest zagrożony. Jednak druga bariera za pierwszym włamaniem staje się cieńsza.
W codziennej pracy oznacza to, że aktualizacji nie można już traktować jak projektu kwartalnego. Stały rytm z krótkimi oknami na restart, na przykład co miesiąc, a przy krytycznych lukach natychmiast, odbiera pojedynczemu komunikatowi grozę. Kto i tak regularnie restartuje systemy, przy poprawce jądra nie musi dopiero zbierać zgód, okien czasowych i osób odpowiedzialnych.
Poprawki jądra od producentów
Poprawka jądra ma długą drogę. Najpierw pojawia się w gałęzi głównej, potem jest przenoszona do gałęzi długoterminowych i trafia do jąder dystrybucji. W przypadku urządzeń dochodzą jądro producenta, kompilacja firmware, zatwierdzenie i dostarczenie. Dopiero wtedy firma może ją zainstalować.
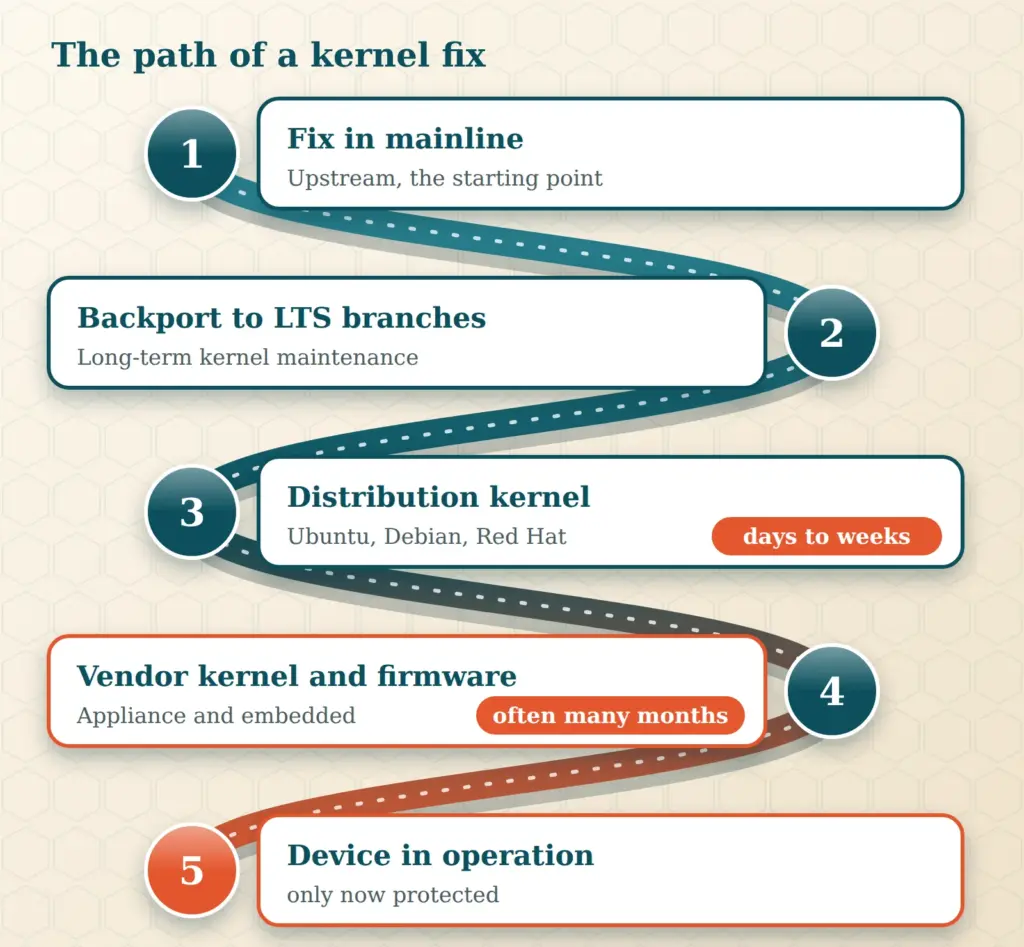
W zależności od grupy urządzeń wygląda to bardzo różnie. Standardowe serwery z utrzymywaną dystrybucją otrzymują aktualizacje jądra zwykle w ciągu kilku dni lub tygodni. Dzięki Live-Patching okno czasowe przy krytycznych lukach można jeszcze skrócić, ale restart pozostaje najpewniejszą drogą.
W przypadku urządzeń takich jak firewalle, systemy NAS i routery tempo narzuca producent. Okno aktualizacji jest częścią utrzymania produktu i firma praktycznie nie ma na nie wpływu. Najsłabiej wygląda to w urządzeniach embedded i IoT. Często działają tam jądra producentów, które o wiele miesięcy lub kilka wersji pozostają w tyle za gałęzią główną, a niektóre produkty nigdy nie dostają poprawek jądra.
Trzy pytania do producentów i dostawców wnoszą jasność. Ile dni po poprawce upstream pojawia się aktualizacja? Jaka linia jądra jest w urządzeniu? I do kiedy obowiązuje wsparcie?
Co MŚP robią przy spóźnionych poprawkach
Na początku stoi prosta inwentaryzacja. Linux działa nie tylko w serwerach, ale także w routerach, NAS-ach, kamerach, drukarkach, firewallach i sterownikach. Dla każdego urządzenia wystarczą wersja jądra i firmware oraz nazwa producenta.
Następnie ustala się priorytety. Co jest dostępne z internetu, co przetwarza dane dostępowe, co oferuje dostęp administracyjny? Urządzenia z kilkoma odpowiedziami „tak” idą na pierwszy ogień. Brak poprawki można częściowo zrekompensować odizolowaniem:
- Nie udostępniać publicznie interfejsów administracyjnych, dostęp tylko przez VPN z uwierzytelnianiem wieloskładnikowym.
- Umieszczać urządzenia we własnych segmentach sieci, aby przejęte urządzenie nie otwierało całej sieci.
- Ograniczać uprawnienia: żadnych wspólnych kont administratora, osobne konta usługowe, kontenery z ograniczonymi uprawnieniami.
- Obserwować logi, aby nietypowe logowania i zmiany uprawnień zwracały uwagę.
Samo OpenAI zaleca przy pracy z modelem obronę warstwową i izolację, na przykład za pomocą Firecracker lub gVisor. Pasuje to do każdej firmy: błąd w jądrze nie powinien automatycznie otwierać wszystkiego innego.
Co mogą zrobić MŚP, jeśli producent dostarcza poprawki jądra dopiero po miesiącach?
Druga dźwignia leży w umowie. Terminy dostarczania poprawek i koniec wsparcia należy wpisać do umów dostawy i serwisowych, a okna na restart można uzgodnić z wyprzedzeniem. Kto podlega NIS2, powinien rozszerzyć zarządzanie podatnościami także na dostawców. Krytyczne poprawki powinny trafić na urządzenia w ciągu kilku dni, a nie dopiero w następnym kwartale.
Do inwentarza należy też własna strona internetowa, bo to ją atakujący widzą jako pierwszą. Kontrola strony internetowej, wraz z wykonywanymi od pewnego czasu automatycznie dodatkowymi testami bezpieczeństwa, pokazuje, co jest widoczne z zewnątrz i gdzie istnieją luki w zabezpieczeniach.
Benchmarki co tydzień
Krzywa najlepszych modeli szybko rośnie. Gemini 4 Carbon pojawił się ok. czterech tygodni po poprzedniku Argon i osiąga w ExploitGym ok. 55%, wobec ok. 42% w przypadku Argon. Anthropic wiosną wstrzymał swój model, bo nie miał on stać się ogólnie dostępny. U wszystkich dużych dostawców linia jest podobna: najsilniejszy model pozostaje na początku w wąskim gronie.
Benchmarki to nie to samo co praktyka. Do planowania liczą się kierunek i tempo, a nie pojedyncza wartość procentowa. Właściwą wiadomością jest to, że odstępy między generacjami modeli kurczą się do tygodni lub miesięcy. To, co wiosną z tysiącami znalezionych luk było jeszcze wyjątkiem, dziś wygląda jak zapowiedź.
AI open source i destylacja
Wiedza w AI przesuwa się w dół. Przy destylacji duży model, nauczyciel, generuje odpowiedzi i ścieżki rozwiązań, a mniejszy model, uczeń, uczy się na nich. Wynik jest często znacznie mniejszy i tańszy, nie tracąc przy tym wszystkich zdolności. Dla MŚP to kluczowa kwestia: to, co dziś działa w centrach danych, w ciągu kilku miesięcy trafia na sprzęt, który mieści się w szafie serwerowej.
Otwarte modele, takie jak GLM-5.2 i DeepSeek V4-Pro, pozostają w zdolnościach cybernetycznych 4 do 7 miesięcy w tyle za najlepszymi modelami zamkniętymi. W 2025 r. było to jeszcze 6 do 10 miesięcy. Uśredniając wszystkie zdolności, odstęp wynosi ok. 4 miesięcy.
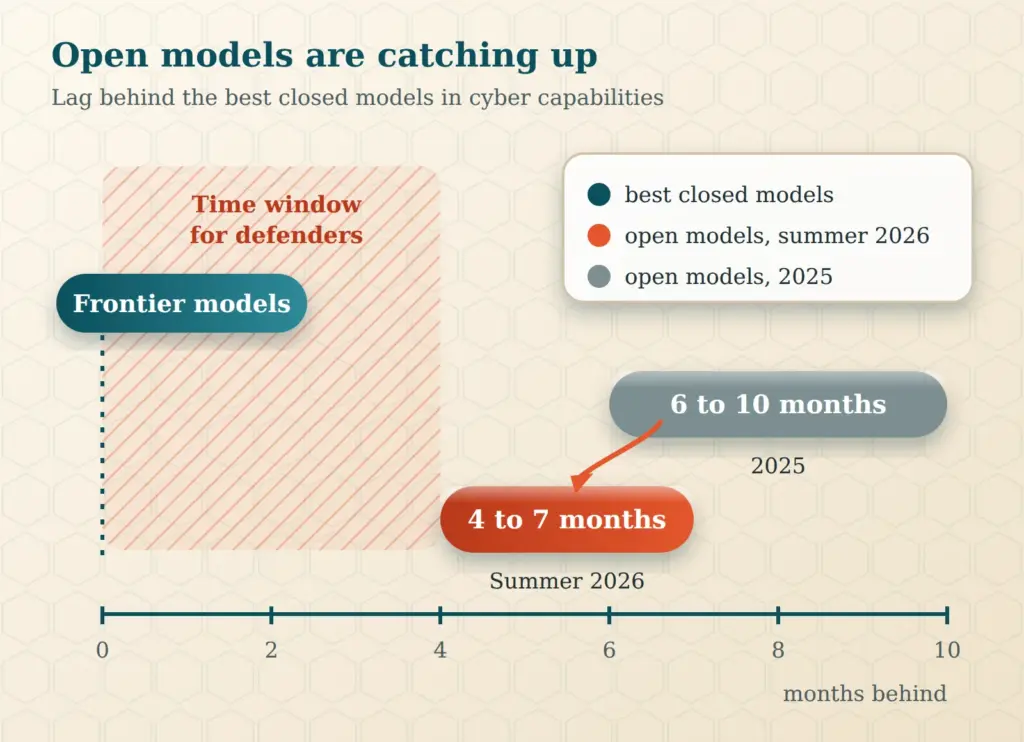
Dla modeli z ograniczonym dostępem, takich jak GPT-6 Cyber, oznacza to, że ochrona dostępu daje obrońcom przewagę na pewien czas. Otwartych wag po publikacji nie da się ani wycofać, ani monitorować. Miesiące do nadrobienia zaległości są więc oknem na podstawową ochronę, porządne aktualizacje i obronę wspieraną przez AI. Jednocześnie otwarte modele służą także badaczom i obrońcom, bo narzędzia do testowania powstają nie tylko po stronie atakujących.
Lokalna AI jako odpowiedź
Najlepsze modele mają ograniczony dostęp, są weryfikowane i monitorowane. Kto używa ich do prac z zakresu bezpieczeństwa, przekazuje kod źródłowy, konfiguracje i logi dostawcy, który obserwuje działania. Chronione przetwarzanie bez wglądu dostawcy istnieje tylko dla klientów z Zero Data Retention. Dla większości MŚP nie jest to realna opcja.
Wyraźną alternatywą jest lokalna AI z otwartymi modelami na własnym sprzęcie. Dane pozostają w firmie i nie ma zależności od cen, zasad dostępu ani wyłączenia usługi. To jednocześnie przewaga strategiczna, bo kto utrzymuje wiedzę i narzędzia we własnej firmie, spokojniej reaguje na zapowiedzi poszczególnych dostawców. Typowe zadania to analiza logów, przegląd własnych konfiguracji, streszczanie komunikatów bezpieczeństwa i dokumentacja.
Modele działające lokalnie pozostają wprawdzie wyraźnie w tyle za najlepszymi modelami chmurowymi, a przy masowym wyszukiwaniu luk zero-day to wada. Do codziennej pracy w firmie często jednak wystarczają, a właśnie tam rozstrzyga się bezpieczeństwo danych.
Także lokalne instalacje wymagają dyscypliny. Interfejsy nie powinny być dostępne z internetu, modele powinny pochodzić z zaufanych źródeł, a uprawnienia agentów pozostają ograniczone, aby obce treści nie przemycały poleceń. Kto chce zgłębić temat AI offline, znajdzie tu dobry punkt wyjścia.
Podsumowanie
Wyszukiwanie błędów za pomocą agentów jest tanie, szybkie i skalowalne. Pole działania leży więc nie w znajdowaniu, lecz w instalowaniu poprawek. Kto zna swoje urządzenia, uzgadnia terminy i przygotowuje izolację, nie zostanie przytłoczony setkami poprawek jądra. A kto trzyma dane i narzędzia we własnej firmie, zachowa zdolność działania także wtedy, gdy kolejne modele będą jeszcze szybsze.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.