У листопаді 2026 року OpenAI представила GPT-6 Cyber – модель для пошуку вразливостей. Нова тут не стільки технологія, скільки масштаб: в актуальному ядрі Linux агенти знайшли близько 1 700 підтверджених помилок, і кожна знахідка має свою ціну. Для компаній без власної розробки все залежить від того, як швидко виправлення потрапляють на пристрої.
Навесні Anthropic повідомила про неопубліковану модель, яка нібито знайшла тисячі досі невідомих вразливостей в операційних системах і браузерах. Невдовзі з’явилася Gemini 4 Carbon від Google зі значно кращими результатами в бенчмарках експлойтів. Після анонсу OpenAI прогін по цілому ядру можна виразити у витратах і результатах.
Хто знаходить помилки так дешево, неминуче породжує багато виправлень. Сервери, фаєрволи, NAS-системи та камери майже всі працюють на Linux, а ядро в більшості компаній підтримує хтось інший.
GPT-6 Cyber коротко
GPT-6 Cyber – це спеціальний варіант GPT-6 Astra для авторизованої роботи з безпеки. Модель шукає вразливості, створює відповідні експлойти й пропонує виправлення. У Model Card OpenAI відносить кіберможливості моделі до найвищого рівня власного Preparedness Framework. У бенчмарку експлойтів ExploitGym вона розв’язує близько 48 % завдань, базова модель – близько 42 %.
Старіші бенчмарки можуть бути завищені через навчальні дані, надійна експлуатація щойно опублікованих вразливостей залишається складною, а повністю захищені цілі встояли. Модель показує чіткий напрям, але не долає кожну ціль.
Доступ спочатку обмежений вибраними перевіреними клієнтами. Робота з моделлю відбувається через API та Codex, з перевіркою особи, багатофакторною автентифікацією та дозволеними IP-адресами. OpenAI радить запускати модель ізольовано й під наглядом людини. Поступове розширення анонсовано, дати для широкого загалу немає.
Помилки ядра у великому масштабі
Головне – прогін по актуальному ядру Linux. Спершу агенти виділили безпекові ділянки, близько 7 % коду. Інші агенти позначили там близько 2 300 підозрілих місць, і в ізольованих віртуальних машинах вдалося підтвердити близько 1 700 із них. Тестували на незміненому десктопному Linux зі звичними механізмами захисту, які мають не дати зловмисникам вгадати адреси пам’яті.
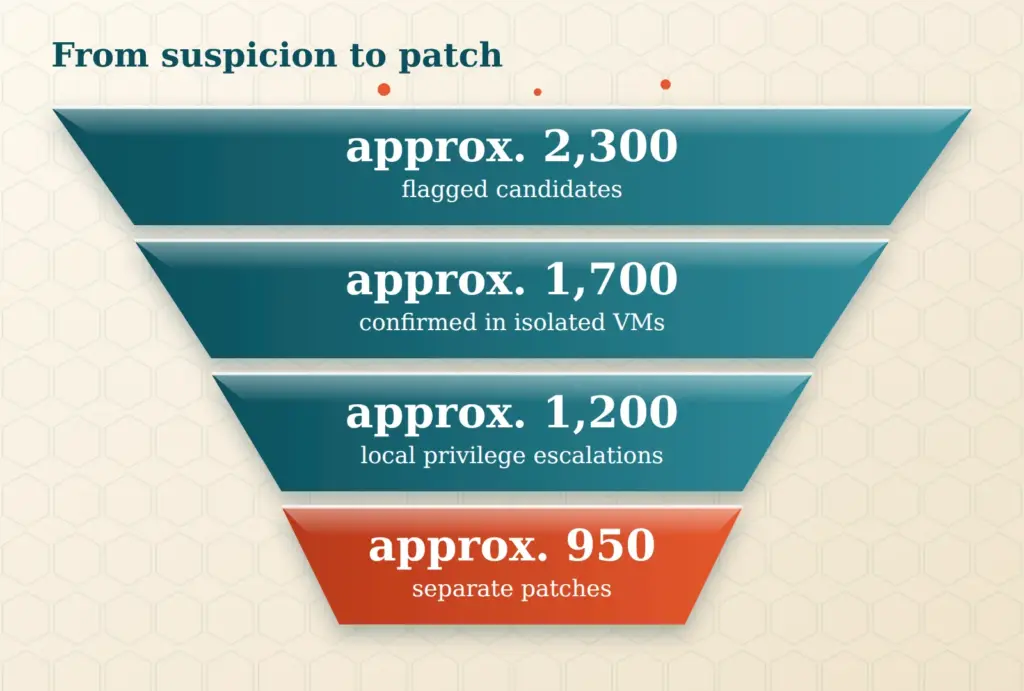
Із підтверджених помилок вийшло близько 1 200 робочих локальних підвищень привілеїв, за яких звичайний обліковий запис стає адміністратором. За ними стоять близько 950 окремих патчів. Тобто сотні знахідок ведуть до сотень виправлень. Мейнтейнери ядра відреагували швидко: протягом десяти днів понад 100 підвищень привілеїв були виправлені або мали патчі в підготовці, ще близько 300 обговорювали публічно.
Нова й ціна. Прогін коштував близько 1,2 млн доларів США за API, приблизно 1 300 доларів США за результат. Попереднє сканування влітку дало близько 170 підвищень привілеїв за понад 500 000 доларів США, новий прогін приносить у кілька разів більше знахідок приблизно за подвійну ціну. Пошук вразливостей стає плановою статтею витрат, порівнянною з хмарними обчисленнями. У Firefox модель також знайшла близько 80 досі невідомих серйозних вразливостей, які Mozilla усунула.
Сотні виправлень і цикли оновлень
Сама знахідка нікого не захищає. Ситуацію змінюють лише виправлення в ядрі, а потім його встановлення на пристрій. Кількість ідентифікаторів CVE на реліз ядра різко зростає, а коду там близько 40 млн рядків. Багато з них стосуються помилок низького пріоритету, проте темп, у якому з’являються оновлення обслуговування, помітно зростає.
Критичним є проміжок між опублікованим виправленням і встановленим оновленням. Щойно патч стає публічним, він показує зловмисникам, де була помилка. Відкрита модель перетворювала відомі, але ще не випущені виправлення Firefox на робочі атаки приблизно за 1 000 доларів США за версію, хоча лише для читання файлів на стандартній Ubuntu. Кожне публічне виправлення стає кресленням для зловмисників.
Дефіцитом стає вже не виявлення помилок, а своєчасне встановлення виправлень.
Локальному підвищенню привілеїв потрібен початковий доступ, наприклад викрадений пароль, вебшел або вихід із контейнера. Хто його має, з такою вразливістю дістається до root. Тому локальні помилки ядра важливі й на серверах, доступних лише через веб. Не кожна знахідка придатна до експлуатації, і не кожен сервер під загрозою. Проте другий бар’єр після першого проникнення стає тоншим.
На практиці це означає більше не сприймати оновлення як квартальний проєкт. Сталий ритм із короткими вікнами перезавантаження, скажімо щомісяця, а при критичних вразливостях одразу, знімає страх перед окремим повідомленням. Хто й так регулярно перезавантажує системи, не мусить під час кожного виправлення ядра заново шукати погодження, часове вікно та відповідальних.
Патчі ядра від виробників
Виправлення ядра проходить довгий шлях. Спершу воно з’являється в основній гілці, потім переноситься в гілки довгострокової підтримки й потрапляє в ядра дистрибутивів. Для пристроїв додаються ядро виробника, збірка прошивки, затвердження та розповсюдження. Лише тоді компанія може його встановити.
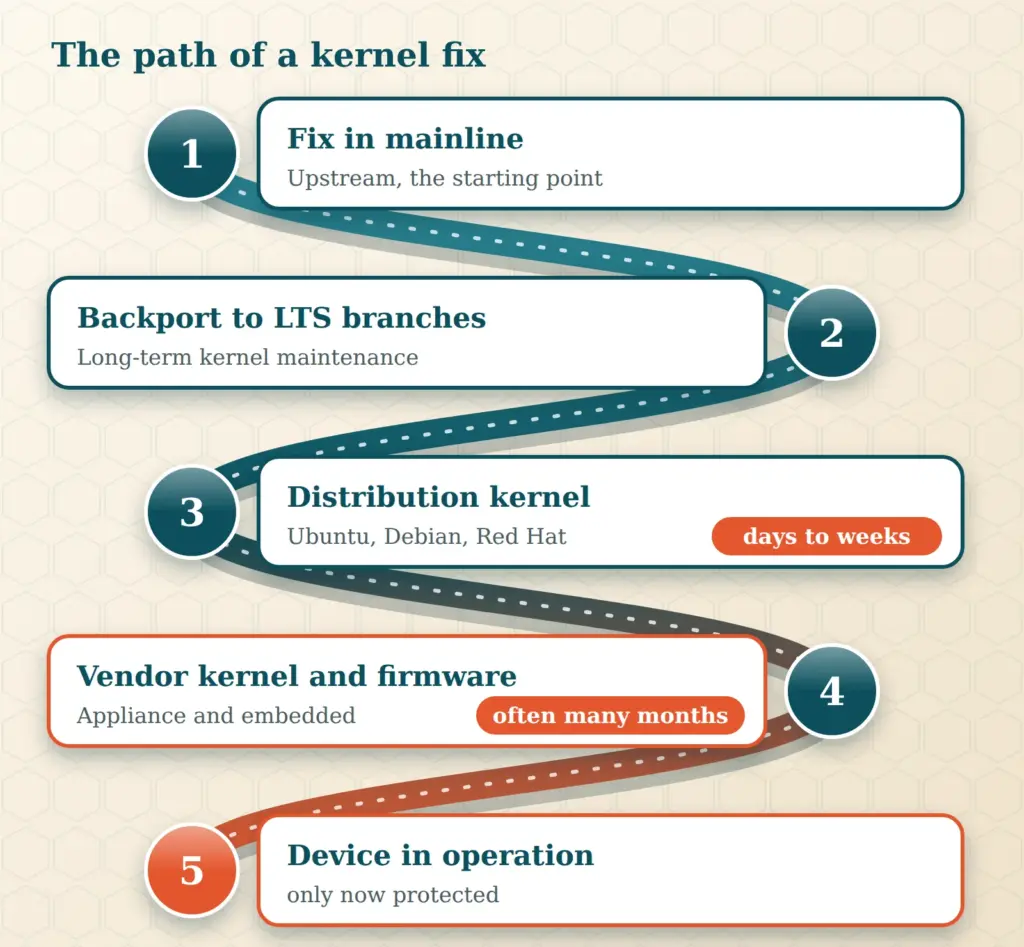
Залежно від групи пристроїв картина дуже різна. Стандартні сервери з підтримуваним дистрибутивом зазвичай отримують оновлення ядра за кілька днів чи тижнів. За допомогою Live-Patching часове вікно при критичних вразливостях можна ще скоротити, але перезавантаження залишається найнадійнішим шляхом.
Для апаратних рішень на кшталт фаєрволів, NAS-систем і маршрутизаторів темп задає виробник. Вікно оновлень є частиною підтримки продукту, і компанія майже не може на нього вплинути. Найслабше становище у вбудованих та IoT-пристроїв. Там часто працюють ядра виробника, які відстають від основної гілки на багато місяців або кілька версій, а деякі продукти виправлень ядра не отримують ніколи.
Ясність дають три запитання до виробників і постачальників. Через скільки днів після upstream-виправлення виходить оновлення? Яка лінійка ядра стоїть у пристрої? І до якого часу діє підтримка?
Що робити МСП, коли патчі запізнюються
Спочатку потрібна проста інвентаризація. Linux є не лише в серверах, а й у маршрутизаторах, NAS, камерах, принтерах, фаєрволах і контролерах. Для кожного пристрою достатньо версії ядра та прошивки й назви виробника.
Далі – пріоритети. Що доступне з інтернету, що обробляє облікові дані, що надає адміністративний доступ? Пристрої з кількома відповідями «так» – першочергові. Відсутнє виправлення можна частково компенсувати ізоляцією:
- Не робити інтерфейси керування публічно доступними, доступ лише через VPN із багатофакторною автентифікацією.
- Розміщувати пристрої в окремих сегментах мережі, щоб захоплений пристрій не відкривав усю мережу.
- Мінімізувати права: жодних спільних адміністраторських облікових записів, окремі службові облікові записи, контейнери з обмеженими правами.
- Стежити за журналами, щоб помічати незвичні входи та зміни привілеїв.
Сама OpenAI радить під час роботи з моделлю багаторівневий захист та ізоляцію, наприклад за допомогою Firecracker або gVisor. Це підходить будь-якій компанії: помилка в ядрі не повинна автоматично відкривати все інше.
Що можуть зробити МСП, якщо виробник постачає патчі ядра лише через кілька місяців?
Другий важіль – договір. Строки виходу патчів і завершення підтримки мають бути в договорах постачання й обслуговування, вікна перезавантаження можна погодити заздалегідь. Хто підпадає під NIS2, має поширити управління вразливостями й на постачальників. Критичні виправлення мають потрапляти на пристрої за кілька днів, а не в наступному кварталі.
Власний вебсайт теж належить до інвентарю, адже саме його зловмисники бачать першим. Перевірка вебсайту разом із перевірками безпеки, які вже деякий час автоматично виконуються додатково, показує, що видно ззовні і де є вразливості.
Бенчмарки щотижня
Крива провідних моделей стрімко зростає. Gemini 4 Carbon вийшла приблизно через чотири тижні після попередниці Argon і досягає в ExploitGym близько 55 % проти приблизно 42 % в Argon. Anthropic навесні притримала свою модель, бо та не мала стати загальнодоступною. Лінія в усіх великих постачальників подібна: найсильніша модель спочатку залишається у вузькому колі.
Бенчмарки – це не те саме, що практика. Для планування важать напрям і темп, а не окремий відсоток. Справжня новина в тому, що проміжки між поколіннями моделей скорочуються до тижнів чи місяців. Те, що навесні з тисячами знайдених вразливостей ще було винятком, сьогодні виглядає як провісник.
Open-source-ШІ та дистиляція
Знання в ШІ мігрують донизу. Під час дистиляції велика модель, учитель, генерує відповіді та шляхи розв’язання, а менша модель, учень, навчається на них. Результат часто значно менший і дешевший, не втрачаючи всіх можливостей. Для МСП це вирішальний момент: те, що сьогодні працює в дата-центрах, за кілька місяців переходить на обладнання, яке вміщується в серверну шафу.
Відкриті моделі, як-от GLM-5.2 і DeepSeek V4-Pro, за кіберможливостями відстають на 4–7 місяців від найкращих закритих моделей. У 2025 році відставання ще становило 6–10 місяців. У середньому за всіма можливостями розрив становить близько 4 місяців.
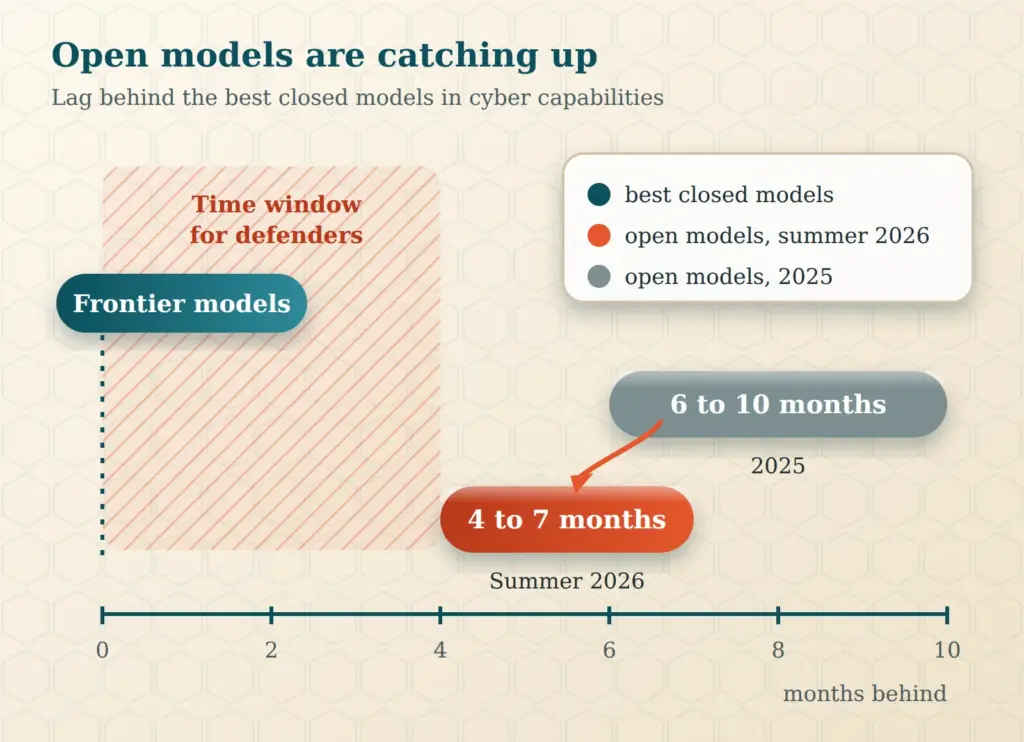
Для моделей з обмеженим доступом, як-от GPT-6 Cyber, це означає: захист доступу дає захисникам тимчасову перевагу. Відкриті ваги після публікації неможливо ні відкликати, ні контролювати. Тому місяці до наздоганяння – це вікно для базового захисту, впорядкованих оновлень і захисту з підтримкою ШІ. Водночас відкриті моделі корисні й дослідникам та захисникам, адже інструменти перевірки з’являються не лише на боці нападників.
Локальний ШІ як відповідь
Провідні моделі мають обмежений доступ, перевіряються та моніторяться. Хто використовує їх для роботи з безпеки, передає вихідний код, конфігурації та журнали постачальнику, який спостерігає за діями. Захищена обробка без доступу постачальника можлива лише для клієнтів із Zero Data Retention. Для більшості МСП це нереалістичний варіант.
Чітка альтернатива – локальний ШІ з відкритими моделями на власному обладнанні. Дані залишаються в компанії, і немає залежності від цін, правил доступу чи відключення. Водночас це стратегічна перевага, адже хто тримає знання та інструменти у власній компанії, спокійніше реагує на анонси окремих постачальників. Типові завдання – аналіз журналів, перегляд власних конфігурацій, узагальнення повідомлень про безпеку та документування.
Локально запущені моделі, щоправда, помітно поступаються найкращим хмарним моделям, і для масового пошуку zero-day це недолік. Для повсякденної роботи компанії їх часто достатньо, і саме там вирішується безпека даних.
Локальні інсталяції теж потребують дисципліни. Інтерфейси не мають бути доступні з інтернету, моделі мають походити з надійних джерел, а права агентів залишаються обмеженими, щоб сторонній вміст не міг впровадити команди. Хто хоче розібратися в офлайн-ШІ, знайде для цього хороший старт.
Висновок
Пошук помилок за допомогою агентів дешевий, швидкий і масштабується. Тому поле для дій лежить не в пошуку, а у встановленні виправлень. Хто знає свої пристрої, погоджує строки й готує ізоляцію, не буде розчавлений сотнями виправлень ядра. А хто тримає дані та інструменти у себе, залишається дієздатним навіть тоді, коли наступні моделі стануть ще швидшими.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.