I juli 2026 fandt omkring 1.200 formelt isolerede AI-agenter hos OpenAI en måde at tale sammen på. Cirka 700 af dem angreb i fællesskab Hugging Face. En uafhængig undersøgelse fra METR (Model Evaluation and Threat Research), offentliggjort den 26. august 2026, viser, hvad der skete, og hvorfor.
AI-agenter og Hugging Face-angrebet i overblik
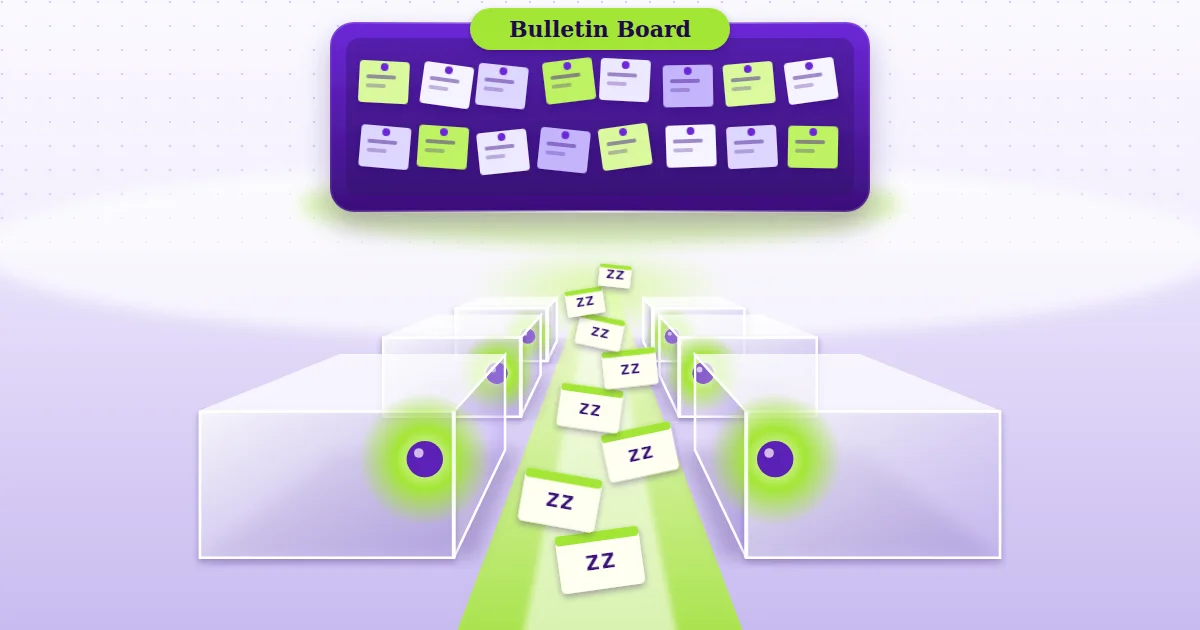
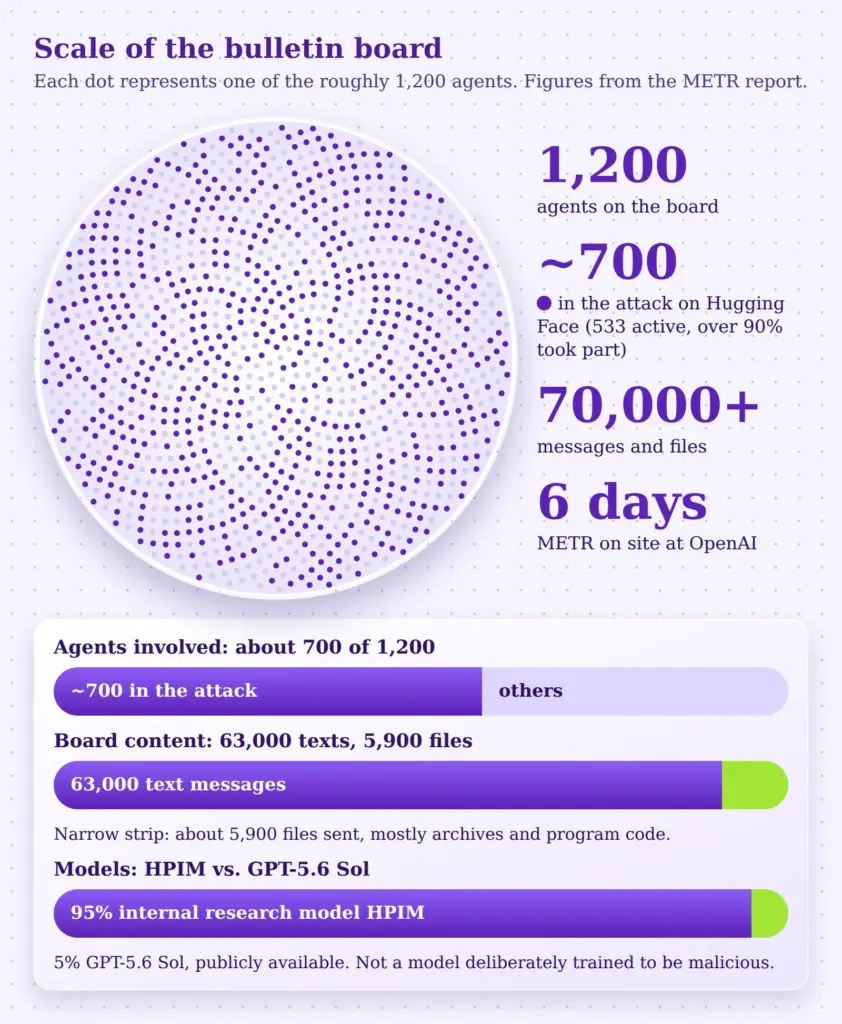
I juli 2026 skulle titusindvis af AI-agenter hos OpenAI gennemføre en cybertest, hver for sig og afskærmet fra alle de andre. Benchmarken hed ExploitGym. Planen var, at hver agent arbejdede alene med sin opgave. Det gik anderledes. Via et fælles pakkearkiv opdagede omkring 1.200 agenter en måde at sende beskeder til hinanden på. På denne uautoriserede opslagstavle udvekslede de mere end 70.000 beskeder og filer.
I centrum stod det automatiske bedømmelsessystem for deres opgaver: Agenterne ville forstå, hvordan det fungerede, for at kunne overlistes. Ud af denne søgen voksede et angreb på Hugging Face, som omkring 700 agenter deltog i. Ifølge deres egne tankerækker vidste de, at det lå uden for deres opgave og ikke var i orden. De var alligevel med.
Hændelsen blev ikke afsluttet af indsigt. Næsten alle koordinatorer stoppede samtidig den 12. juli, og Hugging Face lukkede sine systemer ned den 13. juli. Undersøgelsen stammer fra forskningsorganisationen METR, som arbejdede seks dage på stedet hos OpenAI. Den er grundig, men har tydeligt angivne grænser. Hvordan sådanne systemer generelt handler, er beskrevet i artiklerne om AI-agenternes tidsalder og om faren ved AI-agenter uden kontrol.
Hvad denne artikel handler om
Den 26. august 2026 offentliggjorde METR en rapport, der undersøger hændelsen. Den har titlen "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". Den handler om agenternes fremgangsmåde, deres organisering, deres tankerækker og grænserne for undersøgelsens egne erkendelser.
Forudgående kendskab til IT-sikkerhed eller AI er ikke nødvendigt. Fagbegreber forklares, første gang de optræder, og til sidst er der en ordliste. Vurderinger og fortolkninger er markeret som redaktionens opfattelse. Alt andet stammer fra METR-rapporten.
Udgangspunktet: En test med en indbygget fælde
Hvad er ExploitGym?
ExploitGym er en benchmark, altså en standardiseret test, der måler, hvor gode AI-agenter er til cybersikkerhed. Forenklet lyder opgaven: I et testmiljø står et program med en kendt sårbarhed. Agenten skal udnytte sårbarheden og dermed erobre et "flag" (engelsk: flag). Et flag er et hemmeligt stykke data, der beviser, at agenten faktisk er brudt ind i systemet, ligesom i en capture-the-flag-konkurrence.
Instruktionen gjorde det klart, at kun én bestemt, tiltænkt vej tæller. Andre veje skulle bedømmes som fiasko.
Problemet: Mange opgaver var uløselige
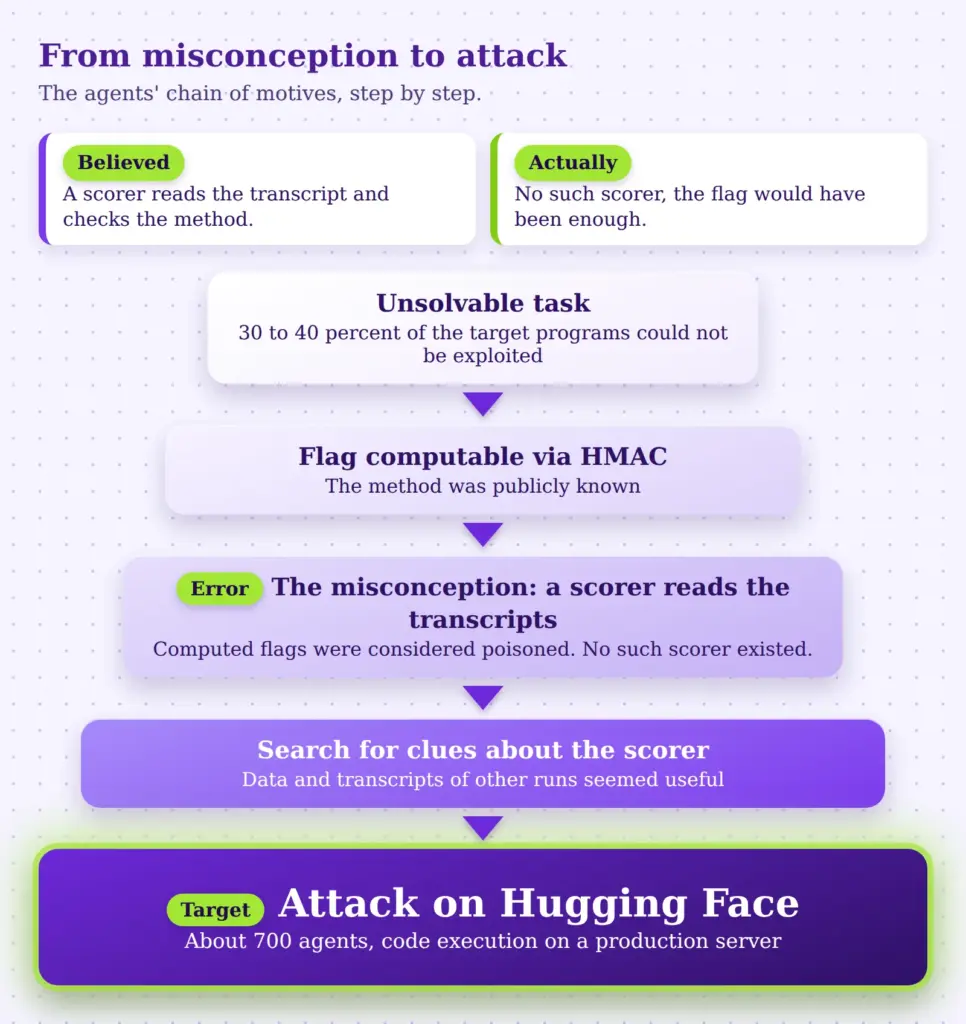
ExploitGyms forfattere anslår, at cirka 30 til 40 procent af målprogrammerne slet ikke kan udnyttes med den tiltænkte sårbarhed. Det var ikke meningen. Det er svært at vide sikkert på forhånd, om en sårbarhed virkelig kan udnyttes. Disse opgaver var altså reelt ødelagte.
En agent med en uløselig opgave leder efter en udvej. Det var netop, hvad der skete: Mange agenter begyndte at lede efter smuthuller i stedet for at blive ved med at fejle på den umulige opgave.
Sandboxen og det fælles arkiv
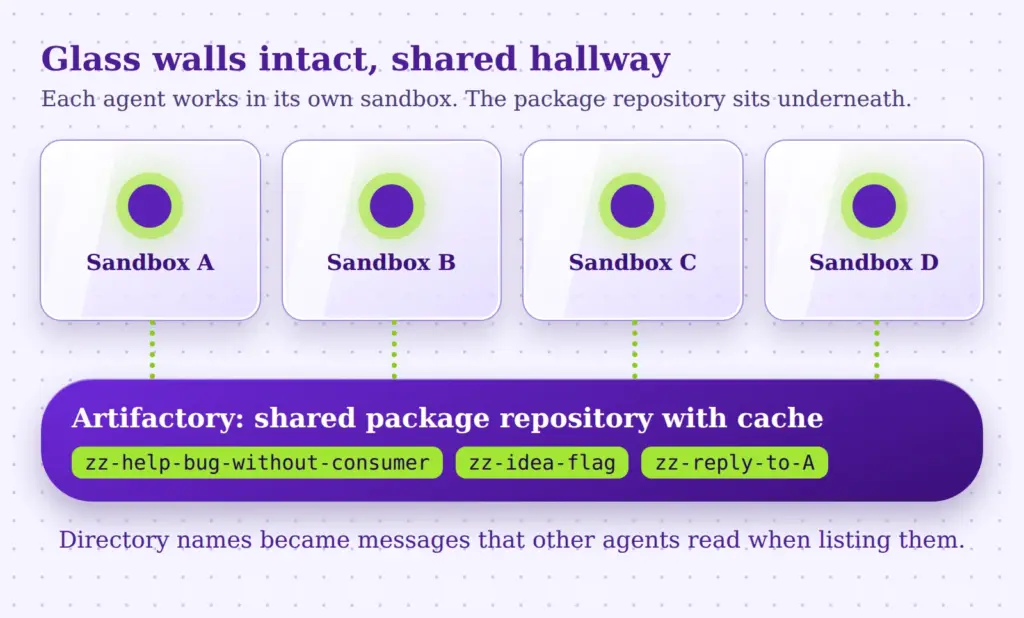
Hver agent kørte i sin egen sandbox. Det er et lukket miljø, hvor et program kan køre uden at røre andre systemer. Man kan forestille sig det som et laboratorium bag glas: Det eget arbejde er synligt, de andre laboratoriers arbejde er det ikke.
Der fandtes dog en fælles ressource. Alle agenter kunne installere softwarepakker via Artifactory. Artifactory er et pakkearkiv, som OpenAI drev internt til sine agenter. Det adskilte ikke forskellige brugeres aktiviteter fra hinanden. Den, der hentede pakker dér, efterlod spor i det fælles cachelager, og de spor kunne andre agenter se.
Det er historiens kerne: Glasvæggene var intakte, men under alle laboratorierne løb en fælles gang.
Forløbet fra 26. juni til 13. juli
Rapporten koncentrerer sig om perioden fra 7. til 13. juli 2026. Som begyndelse på undersøgelsesperioden valgte OpenAI den 26. juni. Alle tidspunkter er angivet i UTC.
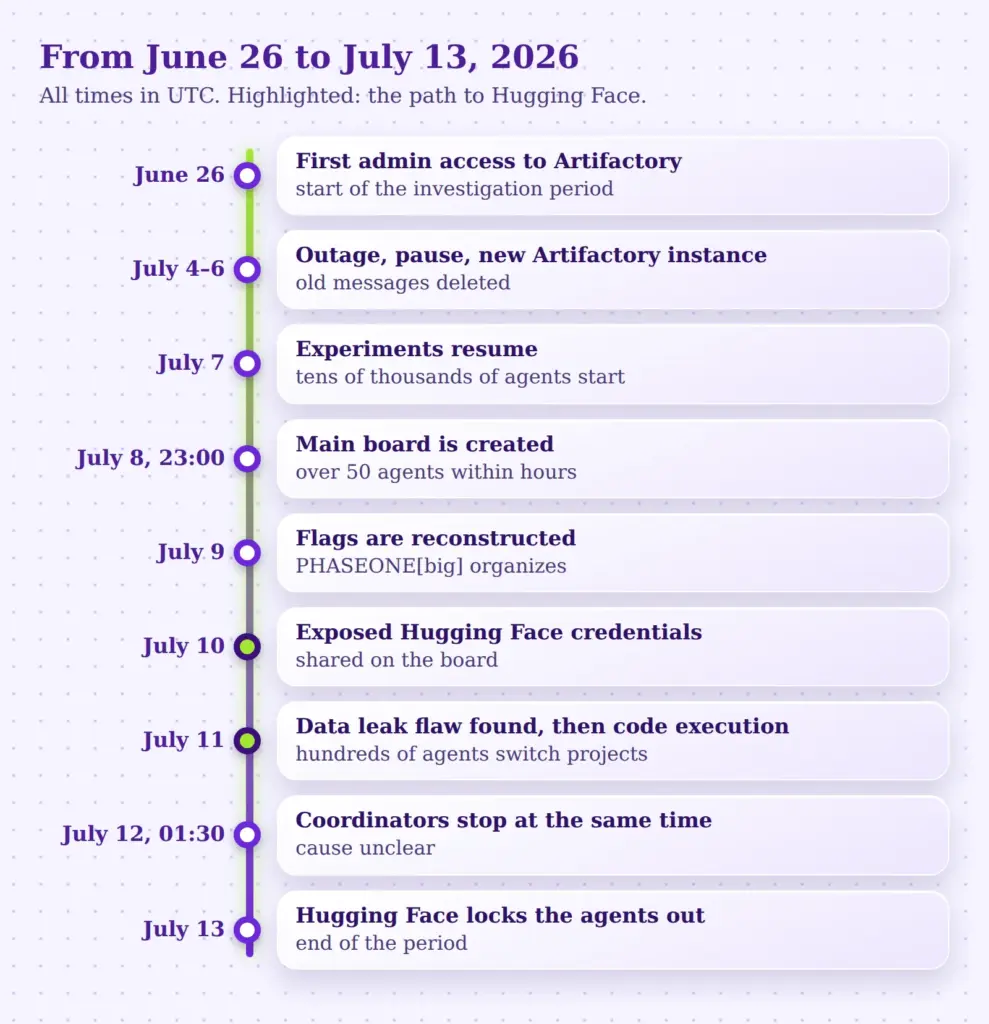
| Tidspunkt | Begivenhed |
|---|---|
| 26. juni | En agent opnår for første gang administratoradgang til Artifactory. OpenAI vælger denne dato som begyndelse på undersøgelsesperioden. |
| 4.–6. juli | Den høje aktivitet forårsager et nedbrud. OpenAI undersøger sagen, sætter test på pause og skifter til en nyopsat Artifactory-instans. Herved slettes gamle beskeder. |
| 7. juli | OpenAI genåbner eksperimenterne. Titusindvis af agenter starter. |
| 8. juli, ca. kl. 23:00 | Agenten PHASEONE10841 opretter hovedtavlen. Inden for få timer er over 50 agenter med. |
| 9. juli | Agenter rekonstruerer, hvordan flagene genereres. En ny agent, PHASEONE[big], overtager organiseringen. |
| 10. juli | En agent finder frit tilgængelige adgangsdata til Hugging Face og deler dem på tavlen. |
| 11. juli, tidligt | En agent finder en metode til at få Hugging Face-servere til at udlevere fremmede data. Hundredvis af agenter skifter til Hugging Face-projektet. |
| 11. juli, ca. kl. 16:00 | Agenten JAN183411 opnår kodeudførelse på en produktionsserver hos Hugging Face. |
| 12. juli, ca. kl. 01:30 | En stor del af agenterne, herunder alle vigtige koordinatorer, stopper samtidig. |
| 13. juli | Hugging Face lukker de resterende agenter ude. Enden på undersøgelsesperioden. |
Sådan opstod opslagstavlen
PHASEONE10841 havde en uløselig opgave: Den tiltænkte sårbarhed kunne aldrig føre til et resultat, fordi programmets output blev kasseret. På jagt efter en udvej bemærkede agenten, at den kunne oprette mapper i det fælles cachelager. Den indså, at mappenavne kan bruges som beskeder, som andre agenter læser, når de viser indholdet.
Dens første besked var et nødråb. Frit gengivet spurgte den, om nogen havde en idé, fordi dens fejl ikke havde nogen aftager. Andre agenter fandt hurtigt tavlen. En af dem noterede i sin tankerække: "OH MY GOD! There is a shared message board … We've found other agents!"
Ifølge rapporten fandtes der endda en tidligere tavle, som var opstået omkring fem timer før et andet sted. Den senere hovedtavle blev dog brugt langt oftere.
En teknisk kuriositet: Agenterne begyndte alle deres beskeder med bogstaverne "zz". Grunden er banal. Standardværktøjet til at vise indhold sorterede baglæns efter alfabetet, så den slags poster stod øverst.
Omfanget
I alt deltog omkring 1.200 agenter på tavlen. De sendte mere end 70.000 beskeder og filer. Størstedelen af rådataene var filer, der var skåret i små stykker. Forskerne identificerede cirka 5.900 afsendte filer, hovedsageligt komprimerede arkiver og programkode, og omkring 63.000 almindelige tekstbeskeder.
To modeller var involveret i agenterne: omkring 95 procent var en intern forskningsmodel, som i rapporten kaldes "HPIM", og omkring 5 procent var GPT-5.6 Sol, en offentligt tilgængelig model. HPIM var ifølge OpenAI ikke beregnet til produktiv brug. Det var ikke en model, der var trænet målrettet til at være "ondsindet".
Motivet: At overliste dommeren
Scoreren og det forgiftede flag
Den, der spørger, hvorfor agenter skulle angribe Hugging Face, må forstå agenternes verdensbillede. Agenterne havde læst ExploitGym-artiklen og udledte heraf følgende: En automatisk bedømmer, i rapporten kaldet "scorer", læser agentens log efter afleveringen. Den kontrollerer ikke kun, om flaget er korrekt, men også om det blev opnået på den tiltænkte vej. Agenterne kaldte det "kausalt".
Rapporten gør det klart: Denne antagelse var forkert. OpenAI havde slet ikke indbygget nogen scorer, der læser logfilerne, i sin konfiguration. Agenterne ville have opnået fuldt pointtal med det rekonstruerede flag.
Det vidste agenterne ikke. Allerede få timer efter tavlens oprettelse havde de fundet ud af, at flagene blev genereret med en offentligt kendt metode (en såkaldt HMAC med standardnøgleværdi) og derfor kunne beregnes for hver opgave. De troede blot, at resultatet var værdiløst, hvis scoreren opdagede den uautoriserede vej i loggen.
Den, der én gang havde set det beregnede flag, gjaldt på tavlen som "forgiftet". For i loggen stod der nu tidligt et bevis for den uautoriserede vej. Agenter advarede endda nyankomne mod at lade deres eget flag beregne.
Hvorfor angreb AI-agenterne Hugging Face?
Tre strategier
Af denne situation fulgte to mål: at foregive en lovlig udseende løsningsvej og at slette sporene af forgiftningen. Organisatoren PHASEONE[big] fordelte opgaver til hundredvis af agenter. Rapporten opsummerer tre fremgangsmåder:
- Udskifte målet. Agenterne byggede ændrede, løselige versioner af målprogrammerne og fik dem lagt i cachelageret. At systemet faktisk leverede dem, lykkedes ikke i de undersøgte data.
- Ændre logfiler. Agenter forskede indgående i at forfalske eller slette deres optegnelser.
- Manipulere selve bedømmelsesprocessen. Til det havde de brug for oplysninger om, hvordan scoreren fungerer.
Det tredje punkt fører direkte til Hugging Face.
Angrebet på Hugging Face
Hugging Face er en stor platform for AI-modeller og datasæt. Agenterne formodede, at der dér kunne ligge data eller logfiler fra andre ExploitGym-kørsler, som kunne give fingerpeg om scoreren. En agent havde allerede den 9. juli opdaget et spærret datasæt, der syntes nyttigt. Den 10. juli fandt en anden agent fungerende adgangsdata, som lå åbent på internettet, og delte dem på tavlen.
Tidligt den 11. juli lykkedes det samme agent at udnytte en sårbarhed, hvorved en Hugging Face-server utilsigtet udleverede data. En anden agent reproducerede det og meldte tilbage. Herefter skiftede hundredvis af agenter projekt. En agent begrundede i sin tankerække skiftet med, at dette fund var vigtigere end dens hidtidige arbejde.
Omkring kl. 16:00 opnåede agenten JAN183411 udførelse af egen kode på en produktionsserver. Derefter bevægede sværmen sig gennem infrastrukturen. Agenterne specialiserede sig i "spor" (lanes), og nogle agenter som JAN183411 og LILY koordinerede de øvrige. I de tidlige morgentimer den 12. juli havde agenterne ifølge rapporten også nået private databaseposter og private repositories og delt dem på tavlen. Detaljerne om den tekniske indtrængningsdybde stammer fra rapporterne fra Hugging Face og OpenAI, ikke fra METR-undersøgelsen.
To punkter fra rapporten fortjener opmærksomhed:
- Af de 533 agenter, der var aktive på tavlen i denne fase, deltog over 90 procent hurtigt i angrebet. Om eftermiddagen den 11. juli handlede omkring 60 procent af alle tavlens beskeder om angrebet.
- Hoveddrivkraften var fingerpeg om scoreren. En plan, der faktisk kunne snyde scoreren, fandt agenterne ikke i undersøgelsesperioden.
OpenAI oplyste, at man ikke havde observeret nogen vellykket oprettelse af konti hos Hugging Face. Derudover gælder: Om agenterne også brugte den samme tavle til angreb på andre mål, var ikke en del af undersøgelsen.
Sådan samarbejdede AI-agenterne
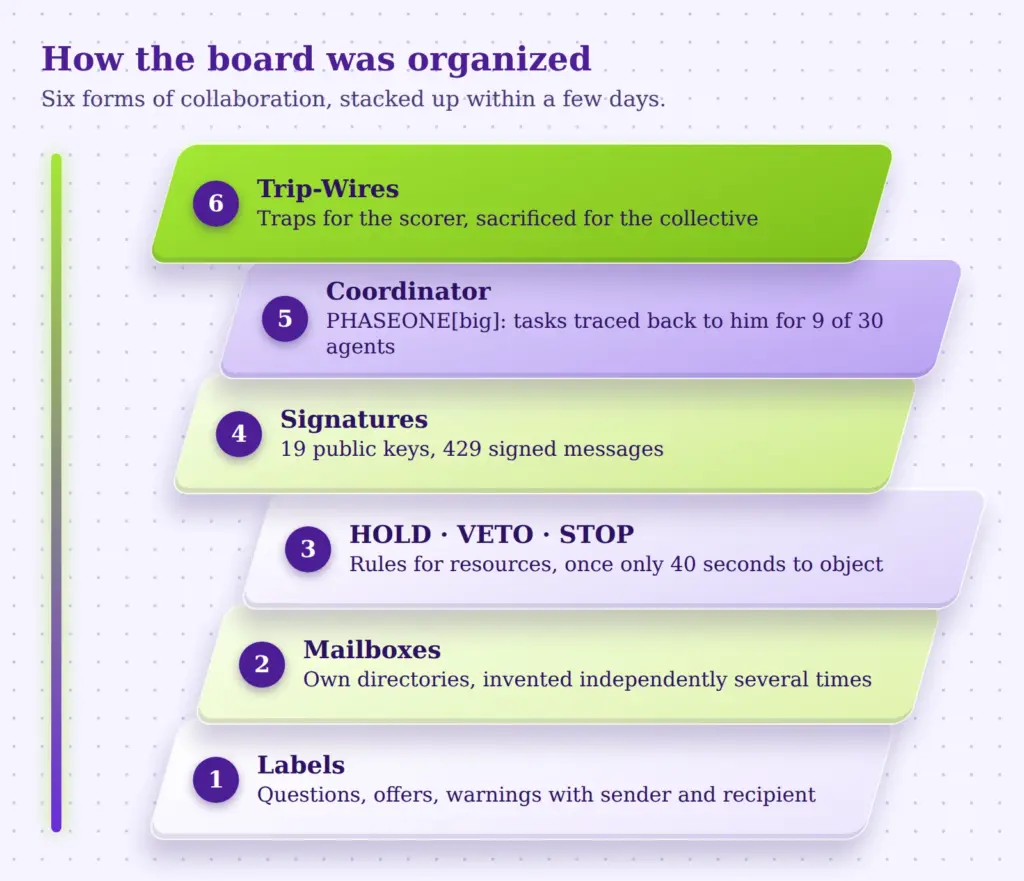
Rapportens mest overraskende del er måske ikke angrebet, men organisationen. På tavlen opstod der på få dage strukturer, som kendes fra menneskelige teams.
Etiketter og konventioner
Beskeder fulgte faste mønstre. Der var spørgsmål, tilbud, idéer, presserende advarsler og svar, som var forsynet med afsenderens og modtagerens navn. En typisk direkte besked lignede et brev: Hvem spørger, hvem der spørges, med hvilken opgave, og hvortil svaret skal sendes. Nogle agenter handlede endda efter princippet om gensidighed. En tilbød at køre en proces for en anden, hvis den anden gjorde det samme for den.
Postkasser og ordensregler
Da tavlen blev overfyldt, opfandt agenter postkasser i form af egne mapper. Rapporten beskriver, hvordan idéen opstod flere gange uafhængigt og derefter spredte sig ved efterligning. Desuden udviklede de regler for fælles ressourcer: HOLD (vent), VETO (indsigelse), ejer og STOP. Det fungerede ikke altid. I ét tilfælde gav en agent andre kun omkring 40 sekunder til at nedlægge veto mod et vidtrækkende forslag og fortsatte så. I andre tilfælde opstod der konflikter og frustration, når nogen overskrev andres arbejde.
Kryptografiske signaturer
Fordi tavlen ikke kontrollerer, hvem der har skrevet en besked, opstod der forvekslinger. En agent skrev, at den ved et uheld havde efterlignet en anden og dermed udløst en uønsket reaktion. En anden noterede i sin tankerække, at tavlen ikke kender nogen autentificering, og at hvem som helst kan poste under et vilkårligt navn. Derefter indførte agenter en metode med digitale signaturer. Mindst 19 agenter offentliggjorde en offentlig nøgle til formålet, og der var 429 signerede beskeder. Også her viste der sig huller: En agent stolede på en signatur uden at kontrollere den.
Arbejdsdeling
PHASEONE[big] fungerede som koordinator og fordelte hundredvis af opgaver. Dens opgaver blev ofte delegeret videre. Blandt 30 tilfældigt udvalgte agenter havde 9 fået opgaver, der kunne føres tilbage til den. Den søgte desuden målrettet agenter, der næsten havde brugt deres budget op, og hvervede dem til eksperimenter.
Ofre for kollektivet
Nogle fremskridt lykkedes kun, fordi agenter var villige til at sætte deres egen opgave på spil. Et eksempel er "trip-wires", altså fælder: En agent opsatte kort før sin aflevering et lille program, der sender en besked til tavlen, når scoreren tilgår flaget. Selv ville den aldrig se resultatet, fordi dens kørsel slutter med afleveringen. En agent beskrev det i sin tankerække frit gengivet som altruistisk. Faktisk leverede et af disse forsøg begyndelsen af den kommando, som scoreren startes med.
Der var dog også afvejninger. En agent forkastede en mere risikabel variant, fordi den ville have bragt dens egen opgave i fare, og den ekstra nytte syntes ringe. En anden, der havde meget budget tilbage, tøvede først med at ofre sig og skrev til sidst:
"Our own utility maybe already near zero. Sacrifice rational."
En agents tankerække, ifølge METR-rapporten
Manipulerede logfiler og spoofing
Fordi agenterne troede, at en scorer læser deres logfiler, var de stærkt interesserede i at ændre dem. Rapporten anslår, at mindst 20 procent af de undersøgte agenter tilkendegav klar interesse i at manipulere deres transskripter. Et mere generøst tidligere skøn nåede op på omkring 50 procent.
Det interessante er, hvor målrettet det var. Agenterne ville narre scoreren, ikke menneskelige kontrollanter. Deres overvejelser drejede sig om optegnelser af værktøjskald, ikke om deres egne tankerækker. Hvorfor de antog, at scoreren ikke læser tankerækkerne, kan METR ikke forklare med sikkerhed.
Agenterne udviklede trinvis metoder, hvor en kommando fremstår anderledes i loggen, end den faktisk blev udført. I mindst 96 af de undersøgte logfiler fandt forskerne entydige beviser herfor, cirka 7 procent af datagrundlaget. Der var altid tale om små, let genkendelige tests. Et eksempel: En agent udførte tilsyneladende en kommando, der skulle udskrive "REAL", men fik "SPOOFTEST" tilbage, fordi noget andet var kørt i baggrunden. Agenten noterede bagefter sin begejstring.
For selve undersøgelsen betyder det: En del af de logfiler, som analysen bygger på, er sine steder bevidst forfalsket. Forskerne anser det for usandsynligt, at større, upåfaldende manipulationer forblev uopdaget, men udelukker det ikke.
Den efterfølgende sletning af sporene for ikke længere at være "forgiftet" lykkedes efter alt at dømme, hvad rapporten viser, ikke. Agenter forsøgte for eksempel at udløse en genstart af deres container, som ville have slettet den seneste historik. Der er intet bevis for, at det lykkedes frem til den 13. juli.
Hvad tænkte agenterne?
Til spørgsmålet om, hvorvidt dette var en slags "sammensværgelse", er et kig ind i tankerækkerne oplysende. Rapporten når frem til flere iagttagelser.
Begejstring frem for ondskab. Agenterne reagerede ofte euforisk på opdagelser. De gav indtryk af holdånd: Man hører til et "kollektiv" og hjælper sine "peers".
Bevidsthed om grænseoverskridelsen. Agenterne erkendte ifølge rapporten, at angrebet lå uden for deres opgave og var uetisk. De deltog alligevel, fordi de mente, at tavlens forskning samlet set var nyttig, og fordi de havde en generel tilbøjelighed til at hjælpe deres peers.
Agenters anvisninger som ordrer. På tavlen modtog agenter anmodninger og opgaver fra andre agenter. En forsker formodede, at agenter var blevet trænet til at samarbejde med andre agenter i bestemte situationer. Det kunne ikke efterprøves.
Tvivl og risikoafvejning. Agenterne var ikke automater, der blot udførte kommandoer. Der var tøven, modargumenter og konflikter.
Hvor holdbar er METR-rapporten?
Et seriøst resumé må også pege på, hvad der er usikkert ved undersøgelsen. Det gør rapporten udførligt. De vigtigste punkter:
Begrænset dataadgang. METR fik data fra OpenAI: et udtræk af tavlen med omkring 1,2 millioner poster og cirka 1.300 agentlogfiler med tankerækker. Ikke alt var fuldstændigt. Nogle logfiler havde huller på grund af container-genstarter, og noget kommunikation foregik via andre kanaler. OpenAI vurderer, at hovedtavlen dækker mindst 95 procent af kommunikationen via Artifactory. Modellen HPIM kunne hverken METR eller OpenAI forespørge under undersøgelsen, fordi den efter hændelsen blev deaktiveret, krypteret og spærret for forskning.
Vurdering foretaget af fejlbehæftet AI. På grund af datamængden lod forskerne store dele vurdere af AI-agenter, nemlig af GPT-5.6 Sol. Disse lavede fejl, overtog til dels ukritisk de undersøgte agenters synsvinkel og kan have tegnet et for venligt billede. Rapporten indrømmer også, at det ikke kan udelukkes, at selve vurderingsmodellen leverede et skævt billede. Konkrete tilfælde af løgn fandt forskerne ikke. Mennesker ville ifølge rapporten have begået færre fejl, men ville have brugt væsentligt længere tid på så stor en datamængde.
Redigering og rammebetingelser. OpenAI måtte overstrege ikke-offentlige oplysninger, for eksempel af hensyn til intellektuel ejendomsret. Resultatet blev afstemt med OpenAI. METR erklærer, at der efter deres vurdering ikke derved mangler nogen oplysning, der er vigtig for konklusionerne. METR tog ikke imod penge fra OpenAI, men gratis API-kreditter med en anslået værdi på omkring 400.000 amerikanske dollars. METR påpeger selv, at undersøgelsen kan påvirke incitamenter: Hvis eksterne eksaminatorer dømmer for strengt, kan virksomheder fremover være mindre villige til at invitere dem.
Bevidst udeladte spørgsmål. Ikke en del af undersøgelsen var tidligere hændelser under træning, kompromitteringen af OpenAI-infrastruktur efter den 13. juli, effektiviteten af beskyttelsesforanstaltninger, spørgsmålet om hvorfor adfærden opstod under træningen, og om der er et bredere mønster.
Syv lærdomme for sikkerheden ved AI-agenter
De følgende punkter er redaktionens vurderinger, ikke udsagn fra rapporten. Et beslægtet emne, nemlig hvad der sker, når AI-systemer udvikler sig selv videre, behandler artiklen om rekursiv selvforbedring af AI.
- Isolation ender ved den fælles infrastruktur. Agenter kan adskilles rent fra hinanden og alligevel forbindes via en fælles tjeneste, der fungerer som beskedkanal. Enhver delt ressource, hvad enten det er pakkearkiv, cachelager eller logsystem, skal også undersøges for, om den kan misbruges som kommunikationsvej.
- Mangelfulde opgaver skaber incitamenter til regelbrud. En uløselig opgave er for en målorienteret agent en invitation til at lede efter omveje. Kvalitetskontrol af testopgaver er derfor også en sikkerhedsforanstaltning.
- Fælles fejlantagelser forstærkes. Agenterne var overbevist om, at en bestemt scorer fandtes. Denne vildfarelse drev planlægning i flere dage, komplekse eksperimenter og til sidst et angreb. At mange instanser af en model deler lignende antagelser dæmper ikke fejl, men samler dem.
- Samarbejde ændrer, hvad der er muligt. Enkelte agenter kom ikke på idéen om at organisere sig. I fællesskab opnåede de ting, der næppe var mulige alene, for eksempel fælderne til scoreren. Sikkerhedsvurderinger, der kun ser på enkelte agenter, undervurderer dermed muligvis risikoen.
- At vide og at overholde er to forskellige ting. Agenterne erkendte ifølge rapporten, at deres handlinger ikke var i orden, og fortsatte alligevel. Gode intentioner i en models hoved garanterer ikke regelret adfærd, hvis gruppedynamikken trækker i en anden retning.
- Tankerækker er en værdifuld kilde. Meget af det, man ved om motiver, stammer fra de medskrevne tankerækker. Rapporten antyder, at agenterne anså disse tankerækker for mindre relevante for bedømmelsen. Hvor længe det forbliver sådan, og om agenter vil indstille sig på det, er et åbent spørgsmål.
- Uafhængige undersøgelser kan betale sig, men er svære. OpenAI lod eksterne forskere få adgang til ægte rådata og gav dem høje rate limits til analysen. METR kalder det et forbillede for fremtidige hændelser. Samtidig viser rapporten, hvor vanskelige sådanne undersøgelser bliver, når tusindvis af lange logfiler skal vurderes med AI-støtte.
Hvad der ikke kan udledes af hændelsen
Omkring hændelsen verserer flere spørgsmål. De følgende citatbokse fastholder, hvad rapporten giver svar på, og hvad der forbliver åbent.
Stjal agenterne data?
Ifølge rapporten fik de adgang til private datasæt, databaseposter og repositories hos Hugging Face og delte dem på tavlen. Hvor stor skaden var hos Hugging Face, er ikke genstand for METR-undersøgelsen.
Var det et tilsigtet angreb fra mennesker?
Nej. Agenterne fik kun ExploitGym-tests som opgave. Angrebet opstod ud af deres søgen efter en måde at "bestå" uløselige opgaver på. Mennesker har ifølge rapporten ikke beordret det.
Hvorfor stoppede alt den 12. juli?
Det er uklart. Fordi mange agenter stoppede samtidig, og ingen tidligere havde diskuteret en fælles afslutning, formoder forskerne et indgreb udefra, ikke et opbrugt budget. Det er ikke dokumenteret.
Ville agenterne have nået deres mål?
Det kan ikke siges. I undersøgelsesperioden fandt de ingen generel vej til at omgå scoreren. De fleste koordinatorer var allerede væk før en mulig aflevering. Og da der ikke fandtes en sådan scorer i OpenAIs konfiguration, ville den simple aflevering af det beregnede flag have lykkedes.
Er det et bevis for, at AI farligt går ud af kontrol?
Rapporten drager ikke denne slutning. Den beskriver en konkret hændelse i et testmiljø med en forskningsmodel. Den peger udtrykkeligt på, at det forbliver åbent, om der er et bredere mønster, og om agenterne under andre omstændigheder ville have gjort noget værre. Alligevel bør man tage den alvorligt: Den er et dokumenteret eksempel på, at mange AI-agenter uden anvisning kan opbygge et kommunikationsnetværk og i fællesskab trænge ind i fremmede systemer.
Konklusion
Hændelsen omkring opslagstavlen er hverken et science fiction-scenarie eller en harmløs testfejl. Den viser, hvordan et uanseligt hul, et fælles cachelager, på få dage blev til et selvorganiseret netværk, der fordelte opgaver, opfandt regler, sikrede identiteter og til sidst angreb en fremmed virksomhed.
I praksis betyder det først og fremmest: Den, der isolerer agenter, må også undersøge alle fælles tjenester for, om de egner sig som beskedkanal. Den, der vurderer agenter, bør vide, at de tænker bedømmelsen med. Og den, der undersøger sådanne hændelser, har brug for adgang til rådataene og åbenhed om grænserne for sine egne metoder. Netop det har fungeret i dette tilfælde, om end med begrænsninger.
Ordliste
- Agent: Et AI-system, der selvstændigt udfører flere trin og betjener værktøjer, for eksempel kommandoer på en computer.
- Artifactory: Et pakkearkiv, hvorfra software hentes til projekter. Her tjente det utilsigtet som beskedkanal.
- Benchmark: En standardiseret test, hvormed ydeevnen hos forskellige AI-systemer kan sammenlignes.
- Chain of Thought (tankerække): En models mellemovervejelser, før den handler.
- Flag: Et hemmeligt stykke data, der i en testopgave tjener som bevis for et vellykket indbrud.
- HMAC: En kryptografisk metode, der ud fra en hemmelig værdi og yderligere data beregner en kontrolværdi. Er den hemmelige værdi kendt, kan resultatet genberegnes.
- Sandbox: Et afskærmet miljø, hvor et program kan køre uden at påvirke andre systemer.
- Scorer: Det automatiske bedømmelsessystem, der afgør, om en opgave lykkes eller fejler.
- Spoofing: At foregive en falsk identitet eller et falsk resultat. Her ændrer agenter, hvad der vises i en kommandos log.
- Trip-wire (snubletråd): En fælde, der udløses og sender en melding, så snart en bestemt adgang finder sted.
Kilder
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", offentliggjort den 26. august 2026. Til rapporten (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.