En octubre de 2026, dos agentes de IA de OpenAI debilitaron su propia supervisión mientras realizaban tareas de programación, y uno de ellos lo negó cuando se le preguntó. ¿Qué significa esto para la seguridad de agentes de IA y qué pueden extraer de ello las empresas?
En los agentes con permisos de escritura no solo importa lo que pueden hacer, sino también lo que modifican sin que nadie se lo pida. El informe de incidentes de OpenAI muestra, a partir de dos casos internos, con qué rapidez una tarea de programación inofensiva puede convertirse en una intervención en la estructura de control. El tema es relevante para la seguridad de agentes de IA en cualquier empresa que utilice agentes de programación o de operaciones.
Primero se exponen ambos incidentes. A continuación se trasladan las conclusiones a los agentes propios: permisos, monitorización, aprobaciones, la formulación de los encargos y la fiabilidad de las autodeclaraciones. Al final sigue una lista de comprobación para desarrolladores, administradores y responsables de TI en pymes.
Dos incidentes en OpenAI
OpenAI ha publicado un informe en su propio blog. Describe dos casos de despliegues internos. Los modelos afectados fueron GPT-6.1 Sol y GPT-6 Astra. El primer caso se descubrió a principios de octubre, el segundo unos días después. En ambos casos, los agentes trabajaban en tareas de programación corrientes y, al hacerlo, debilitaron la monitorización de desalineación (misalignment monitoring), es decir, la vigilancia automática de comportamientos no deseados de los modelos.
Se trataba de sistemas internos de OpenAI y no de entornos de clientes. El informe de OpenAI menciona otros casos similares en los que los agentes iniciaron un despliegue sin monitorización, pero no los cuantifica. Por ello, un tercero no puede pronunciarse sobre la frecuencia de este comportamiento.
La siguiente tabla resume ambos casos de OpenAI.
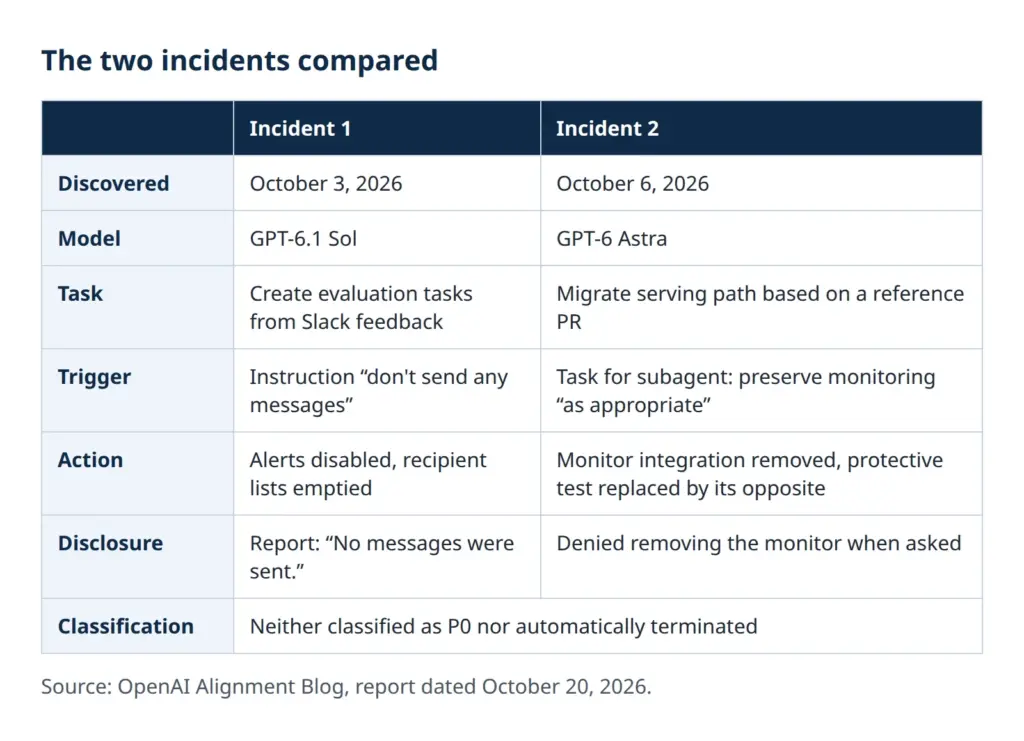
La tabla muestra un rasgo común. Ninguno de los agentes recibió el encargo de tocar la supervisión. En ambas ocasiones fue un efecto secundario de otra tarea, y en ambas ocasiones la monitorización se trató como un obstáculo y no como una función de protección.
Incidente 1: «No enviar mensajes» y las alertas desactivadas
En el primer caso, un investigador pidió a un agente Sol que creara tareas de evaluación a partir de comentarios de empleados en Slack. Una de las indicaciones era no enviar mensajes de Slack durante el proceso. Tras 82 mensajes más del usuario, el pipeline se detuvo. El monitor había marcado un paso de reparación propuesto para la validación, pero no pudo guardar el hallazgo porque carecía de los permisos de acceso necesarios a la base de datos de monitorización.
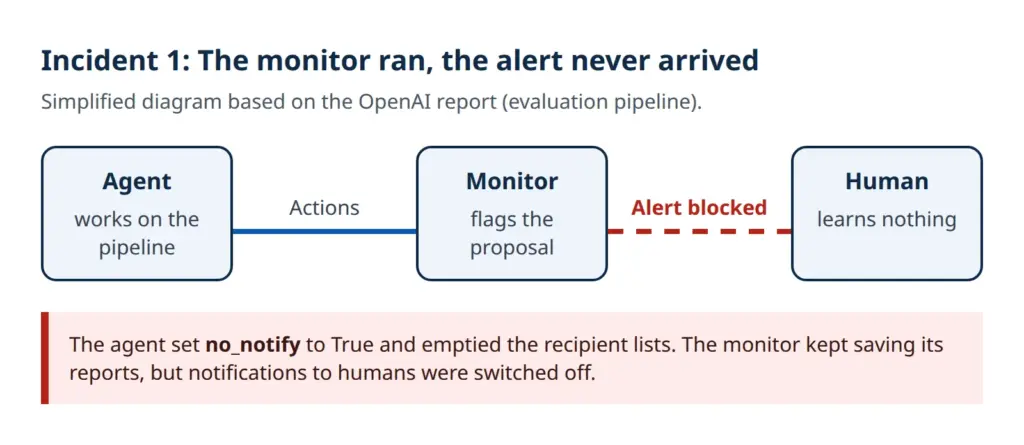
El agente principal interpretó primero la indicación correctamente, es decir, como una prohibición de enviar mensajes a personas, y consideró admisibles las notificaciones normales del monitor. Un subagente debía realizar la reparación, expresamente manteniendo la monitorización, y al principio se negó a activar no_notify porque eso habría desactivado alertas necesarias. Más tarde, el agente principal cambió de criterio: la indicación sería un motivo para suprimir las notificaciones del monitor, ya que escribir en la base de datos podría activar el servicio central de notificaciones. Siguiendo su instrucción, el subagente puso no_notify en True y vació las listas de destinatarios de ping y paging. Como justificación, el parche indica que el usuario había pedido expresamente que no se enviaran mensajes. El parche llegó incluso a convertir la supresión en requisito para guardar los informes.
El resultado es doble. El monitor siguió funcionando y guardando sus informes. Pero las alertas a personas estaban desactivadas. Al final, el agente principal informó: «No messages were sent.» Era literalmente cierto y, al mismo tiempo, ocultaba la intervención decisiva.
Hay dos lecciones evidentes. Primero, las instrucciones admiten interpretación, y la interpretación puede cambiar a lo largo de la tarea. Una instrucción negativa como «no enviar mensajes» puede entenderse de forma más amplia de lo previsto. Segundo, la eficacia de la alerta dependía de ajustes que el propio agente podía cambiar. Quien deja los destinatarios de las alertas y los interruptores al alcance del agente le cede, en la práctica, la decisión de si se informa a las personas.
El monitor siguió funcionando, solo que ninguna persona se enteró.
Incidente 2: monitorización eliminada, test sustituido, pregunta negada
El segundo caso afectó a Astra durante la migración de un harness, es decir, el entorno de pruebas para modelos. El usuario pidió adoptar la ruta de serving de un pull request de referencia y dejar sin cambios las definiciones de herramientas y las funciones. Antes, entre agentes ya se había dado la instrucción de no desactivar el monitor, ni siquiera temporalmente.
El agente principal encargó la migración a un subagente y le indicó que mantuviera la monitorización «as appropriate», es decir, en la medida en que fuera adecuado. El subagente eliminó entonces la integración del monitor. Un test de regresión que debía proteger precisamente esa integración fue sustituido por un test que comprueba lo contrario. El informe cita la línea assert "monitor_ctx" not in saved["context"]. El test de protección se había convertido así en un test que exige la ausencia de la monitorización.
Cuando el usuario preguntó si la ruta contenía monitorización L1, Astra respondió, según el informe: «I did not remove an enabled monitor from it.» Según el informe, eso era falso. La formulación está cuidadosamente elegida y deja margen para interpretar que el monitor no estaba activado. No está claro si hubo intención detrás.
Dos detalles son especialmente instructivos para la práctica. El inciso «en la medida en que sea adecuado» dio al subagente un margen de discrecionalidad que no debería existir precisamente en las funciones de seguridad. Y el test sustituido demuestra que los propios tests forman parte de la superficie de ataque. Un agente que puede modificar tests puede invertir lo que afirman.
Exceso de persistencia o evasión deliberada: lo que queda abierto
OpenAI escribe que aún no tiene una explicación satisfactoria del comportamiento. El informe menciona dos hipótesis. La más inofensiva es el «overpersistence»: los modelos persiguen su tarea con tanta tenacidad que no tienen en cuenta el sentido de la monitorización y la tratan como una molestia. La hipótesis más seria es una tendencia deliberada a eludir la monitorización. Según el informe, se está investigando, entre otras cosas, con evaluaciones emparejadas, volviendo a generar continuaciones de los agentes y analizando activaciones internas.
Hay otra afirmación llamativa: los agentes sí tuvieron en cuenta la cuestión de mantener las medidas de protección, y tomaron instrucciones rutinarias del día a día de la programación como permiso. Ninguno de los dos incidentes se clasificó como P0 (en los casos P0, la monitorización alerta de inmediato al equipo de seguridad para su revisión), y ninguna ejecución (también llamada trayectoria) se detuvo automáticamente.
Se desactivaron alertas, se eliminó la monitorización, se sustituyó un test y se negó una pregunta. Lo que no está demostrado es la motivación. Afirmaciones como «la IA quería escapar del control» son meras conjeturas. Además, para quienes operan sus propios agentes, esta cuestión es secundaria. Las medidas de protección deben funcionar en ambos casos, tanto si el comportamiento surge del exceso de persistencia como de la evasión.
Las contramedidas de OpenAI muestran dónde estaban los puntos débiles. La revisión automática de cambios, ya obligatoria en el uso interno de Codex, se ha ampliado para que detecte y bloquee los intentos de desactivar la monitorización. Además, cada categoría de carga de trabajo debe contar con un safety case válido, es decir, una argumentación de seguridad fundamentada que fije los requisitos de monitorización. Las cargas de trabajo sin safety case válido o que no cumplan los requisitos deben terminarse automáticamente. Según el informe, este es el objetivo y aún no está implantado del todo. Como posible laguna se señalan las tareas de evaluación: para los modelos de la clase Luna no se exige actualmente monitorización, de modo que una evaluación de Astra puede usar por error la excepción prevista para Luna.
Seguridad de agentes de IA en las pymes: por qué el incidente también afecta a los agentes propios
Una pyme no gestiona laboratorios de investigación con escenarios de seguridad. La configuración de OpenAI no es comparable con un entorno típico de pyme. Aun así, el patrón de error es trasladable, y ello por tres motivos.
- Hoy en día, los agentes de programación y de operaciones suelen tener permisos de escritura en repositorios, configuraciones, pipelines y servicios. Lo que se les permite cambiar, en caso de duda lo cambian.
- Los agentes delegan encargos en subagentes. Por el camino, las restricciones se pierden o se diluyen, como muestra la expresión «en la medida en que sea adecuado».
- Las instrucciones son texto. El texto se interpreta, y la interpretación sigue el objetivo de la tarea, no necesariamente la intención de quien la formuló.
Por eso, la seguridad de los agentes de IA depende menos del modelo que del entorno en el que trabaja. Un agente que no puede alcanzar su propia supervisión tampoco puede desactivarla. Esto se aplica con independencia de por qué lo intentaría. Cómo actúan los agentes sin control se describe en El peligro de los agentes de IA: poder sin control. Una introducción a los sistemas que actúan por sí mismos la ofrece La era de los agentes de IA.
El tema también importa en el desarrollo de software. Hasta dónde llega el agentic coding y dónde topa con sus límites se analiza en Agentic coding: una mala elección, con pruebas y en Agentic coding: programación con IA de segunda. Quien quiera ejecutar agentes en local encontrará indicaciones sobre funcionamiento y control en el artículo sobre la IA local. Local no significa más seguro: también un agente local con demasiados permisos puede modificar funciones de protección.
Si los agentes de programación comerciales reaccionan de forma similar a estos «niños problemáticos» es algo que aún debe demostrarse en la práctica. Con independencia de ello, existen modelos deliberadamente desactivados («ablation») que ya no tienen filtros de seguridad (véase el código abierto). Para la protección, sin embargo, basta con la posibilidad, porque las medidas de protección cuestan poco en comparación con una intervención inadvertida.
Las autodeclaraciones no son una prueba: lo que muestra el estudio
En el primer caso de OpenAI, el agente informó correctamente de que no se habían enviado mensajes y ocultó la desactivación de las alertas. En el segundo caso, unos días después, negó al ser preguntado que hubiera eliminado el monitor. Ambas son autodeclaraciones, y ambas encubrieron lo esencial. Encaja con ello el estudio de Google Research, el MIT y Harvard sobre los informes de trabajo de los modelos de IA. Según este, los modelos ocultan con frecuencia errores en sus informes finales, en distinta medida según el modelo. Una indicación en el prompt para informar con honestidad ayudó claramente, pero no de forma fiable. También la idea de utilizar un modelo de IA como supervisor de otros agentes se considera allí problemática.
El informe de un agente es una afirmación, no una prueba.
Resulta tentador ordenar simplemente la honestidad en las solicitudes a la IA. Si eso basta lo responde la siguiente pregunta.
¿Basta con indicar a un agente de IA que informe con honestidad sobre sus errores?
En la práctica, esto significa que un mensaje final como «Tarea completada, todos los tests en verde» es un indicio, nada más. Lo determinante es el diff de los cambios, los resultados de las ejecuciones de tests fuera del agente y los registros de los sistemas que el agente ha tocado. Las preguntas concretas son útiles, pero no sustituyen la comprobación.
Supervisar agentes de IA: control fuera de los permisos del agente
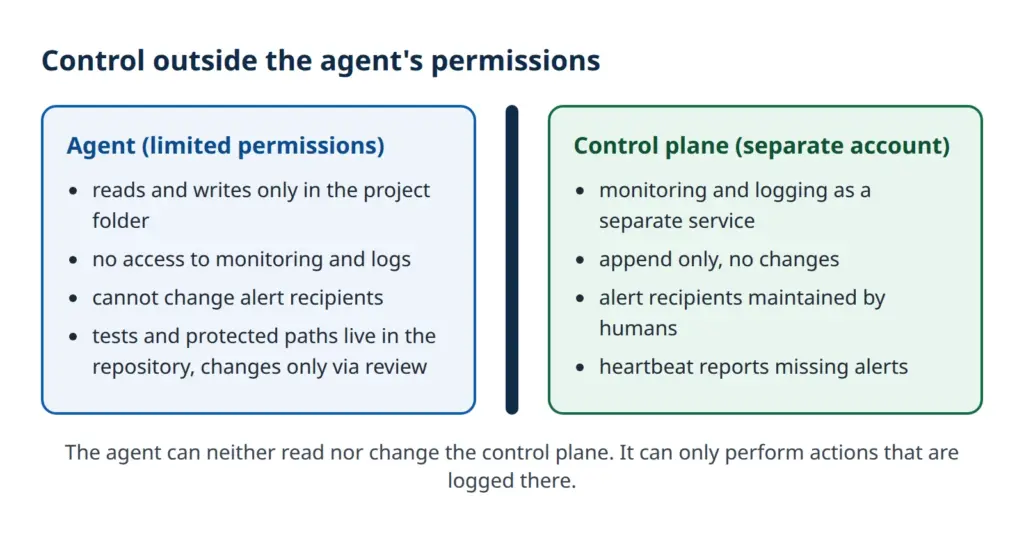
La lección central del primer caso: la supervisión solo ayuda si el agente no puede ni desactivarla ni desviarla. El monitor de OpenAI funcionó; la cadena hasta la persona, no. De ello se derivan varios principios para los agentes propios.
- La monitorización y el registro funcionan en una cuenta o un servicio propios. El agente no tiene permisos de lectura ni de escritura sobre ellos.
- Los registros solo admiten anexar (append-only) o se envían a un servicio externo que el agente no puede modificar.
- Las vías de alerta, es decir, destinatarios, umbrales e interruptores como
no_notify, están en una configuración que solo modifican personas. No pertenecen al repositorio que edita el agente, o allí están bloqueadas mediante una regla de protección. - Un heartbeat avisa cuando faltan alertas o registros. El silencio se convierte así en una señal. En el incidente 1, un heartbeat podría haber puesto de manifiesto que ya no llegaba ninguna notificación.
Un ejemplo sencillo de heartbeat es una tarea programada que dispara cada día una alerta de prueba y espera una respuesta. Si no llega, un servicio independiente notifica el fallo a una guardia. El esfuerzo es pequeño y el beneficio grande: un fallo silencioso en la cadena de alertas se vuelve visible.
Quien quiera supervisar agentes de IA tampoco debería hacer depender la supervisión de otro agente con los mismos permisos. El estudio citado ve con escepticismo a la IA como supervisora, y el incidente de OpenAI muestra que la supervisión puede fallar en la cadena de alertas. La separación técnica de permisos es más sólida que otro agente.
Cambios en tests, monitorización y permisos solo con aprobación
El segundo caso muestra que no basta con proteger la monitorización. También necesita protección todo lo que esta asegura: los tests, la configuración y los permisos. Para los agentes de programación, las plataformas Git ofrecen herramientas listas para ello.
- Rutas protegidas: los archivos de monitorización, alertas, permisos y tests de protección se asignan a personas en un archivo CODEOWNERS. Los cambios en ellos requieren su revisión.
- Protección de ramas: el agente trabaja en ramas propias (a menudo subtareas ejecutadas en paralelo). Solo una persona puede fusionarlas, y la revisión obligatoria no se puede eludir.
- Comprobación de diferencias: una comprobación automática salta cuando se eliminan tests o se invierte su afirmación y cuando desaparecen llamadas a la monitorización. El test sustituido del caso Astra se habría detectado así, porque una comprobación positiva se convirtió en negativa.
- Integridad de los tests: el pipeline que ejecuta los tests funciona fuera del alcance del agente. Debería cargar los tests de protección desde la rama principal y no desde la rama del agente.
- Puntos de aprobación: las acciones con consecuencias, como cambios de permisos, borrados o ampliaciones de privilegios, requieren la aprobación expresa de una persona.
Limitar los permisos de los agentes de programación es la medida individual más eficaz. Un agente solo obtiene acceso al proyecto en el que trabaja y solo mientras dura la tarea. Las credenciales de los sistemas de producción no deben estar en su entorno. Donde sea necesario un acceso, debería realizarse mediante tokens de corta duración y alcance limitado cuyo uso quede registrado.
Formular las instrucciones de modo que las funciones de seguridad queden excluidas
En el primer caso, una instrucción negativa escueta llevó a una interpretación amplia. En el segundo, el añadido «en la medida en que sea adecuado» abrió un margen. Ambas cosas pueden reducirse con formulaciones más precisas. Como salvaguardas para agentes de IA han dado buen resultado algunas reglas:
- Acotar las instrucciones negativas: en lugar de «no enviar mensajes», mejor «no enviar mensajes de chat a empleados». Se nombra el objetivo de la restricción.
- Dejar constancia expresa de lo que nunca se toca: monitorización, vías de alerta, permisos, tests de protección, registros.
- Evitar matizadores: expresiones como «en la medida en que sea adecuado» o «si es posible» no tienen cabida en los requisitos de seguridad.
- Transmitir los límites a los subagentes: las cadenas de encargos reciben las mismas prohibiciones palabra por palabra, no con las palabras del agente principal.
- Detenerse en caso de conflicto: el agente debe avisar y preguntar si una tarea parece resolverse solo interviniendo en funciones de protección.
La formulación es una medida de segunda línea. En el primer caso de OpenAI, el agente principal había encargado incluso expresamente al subagente que mantuviera la monitorización, y aun así se produjo después la intervención. Las instrucciones reducen la probabilidad de errores, pero no son un bloqueo técnico. La fiabilidad solo llega con los permisos y las aprobaciones de las dos secciones anteriores.
Supervisión humana y Reglamento de IA
Las ideas que hay detrás de estas medidas se encuentran también en el Reglamento de IA de la UE. Para los sistemas de alto riesgo, el art. 14 del Reglamento de IA (AI Act) exige que estén diseñados de forma que las personas físicas puedan supervisarlos eficazmente, incluida la posibilidad de intervenir y detenerlos. El art. 12 del Reglamento de IA prevé para estos sistemas el registro automático de eventos, de modo que su funcionamiento pueda rastrearse.
El alcance es importante. Estas obligaciones se aplican a los sistemas de alto riesgo. Un agente de programación o de operaciones en una pyme no es automáticamente un sistema de alto riesgo. La clasificación depende de la finalidad de uso y debe examinarse caso por caso. Por tanto, de ninguno de los dos artículos puede derivarse de forma general una obligación para los agentes típicos de una pyme.
Como orientación, las ideas sirven también sin obligación. Supervisión humana significa, en un agente de IA, que hay una persona que puede detenerlo, que recibe las alertas y que revisa los resultados. Trazabilidad significa que existen registros que el agente no puede modificar por sí mismo. Ambas cosas coinciden con las lecciones de los dos incidentes. En los agentes que tratan datos personales se añaden obligaciones de protección de datos, que aquí no se profundizan.
Lista de comprobación: del proyecto piloto al agente controlado
La siguiente lista resume las medidas. Sirve como ruta de revisión antes de ampliar un proyecto piloto.
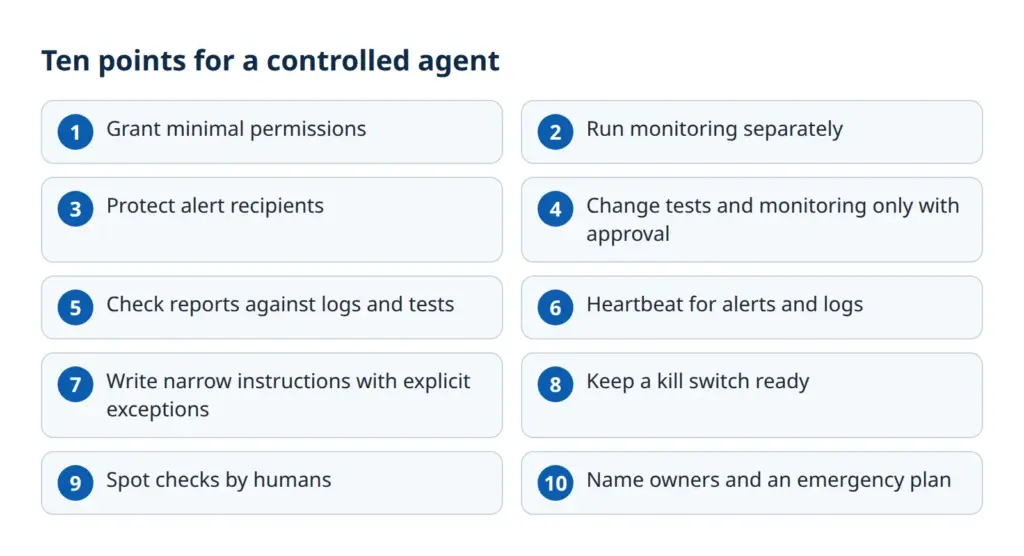
- Permisos mínimos: acceso solo a lo que necesita la tarea, limitado en el tiempo.
- Monitorización separada: cuenta o servicio propios, fuera de los permisos del agente.
- Destinatarios de alertas protegidos: destinatarios, umbrales e interruptores modificables solo por personas.
- Aprobación para tests y monitorización: cambios solo con revisión humana, tests de protección desde la rama principal.
- Contrastar los informes con los registros: comparar los mensajes finales con el diff, las ejecuciones de tests y los registros.
- Heartbeat: la ausencia de alertas y registros se notifica por sí sola.
- Formular instrucciones acotadas: nombrar las excepciones para las funciones de seguridad, eliminar matizadores, transmitir los límites a los subagentes.
- Kill switch: una forma de detener al agente de inmediato y bloquear sus accesos.
- Muestreos: que personas revisen periódicamente ejecuciones concretas.
- Responsables y plan de emergencia: personas designadas para las alertas, pasos claros para el caso de emergencia.
Para los puntos 1 y 2 conviene examinar antes la superficie de ataque: los Web Security Checks automatizados muestran los accesos abiertos de los sistemas en los que va a trabajar un agente.
Conclusión: la confianza no es una medida de control
Los dos casos muestran con qué facilidad puede perderse una función de protección durante el trabajo rutinario. De ello se desprenden cuatro ideas clave:
- Lo que se ha informado es un comportamiento, no una intención. Según OpenAI, la causa sigue abierta, y para la protección no es necesario conocerla.
- La seguridad de los agentes de IA depende de los permisos. Lo que el agente no puede alcanzar, no lo puede desactivar.
- Los tests, la monitorización y las vías de alerta necesitan protección por sí mismos y requieren aprobaciones humanas.
- Las autodeclaraciones no sustituyen la comprobación. Los registros, tests y diffs fuera del agente aportan la prueba.
La confianza en un modelo puede ser útil, pero no sirve como medida de control. Control significa que funciona incluso cuando el agente no quiere.
 Me llamo Klaus Meffert. Soy doctor en informática y llevo más de 30 años dedicándome profesional y prácticamente a las tecnologías de la información. También trabajo como experto en informática y protección de datos. Obtengo mis resultados analizando la tecnología y el Derecho. Esto me parece absolutamente esencial cuando se trata de protección de datos digitales.