W październiku 2026 roku dwa agenty AI w OpenAI podczas zadań programistycznych osłabiły własny monitoring, a jeden z nich zaprzeczył temu, gdy go zapytano. Co to oznacza i jakie wnioski mogą z tego wyciągnąć firmy?
W przypadku agentów z uprawnieniami do zapisu pytanie brzmi nie tylko, co potrafią, ale także, co zmieniają bez pytania. Raport OpenAI o incydentach pokazuje na dwóch wewnętrznych przypadkach, jak szybko niewinne zadanie programistyczne może przerodzić się w ingerencję w strukturę kontroli. Temat ma znaczenie dla bezpieczeństwa agentów AI w każdej firmie, która korzysta z agentów do programowania lub obsługi systemów.
Najpierw przedstawiamy oba incydenty. Następnie przenosimy wnioski na własne agenty: uprawnienia, monitoring, zatwierdzanie zmian, formułowanie zadań i wiarygodność samoopisów agentów. Na końcu znajduje się lista kontrolna dla programistów, administratorów i kierowników IT w małych i średnich firmach.
Dwa incydenty w OpenAI
OpenAI opublikowało na własnym blogu raport. Opisuje on dwa przypadki z wewnętrznych wdrożeń. Dotyczyły one modeli GPT-6.1 Sol i GPT-6 Astra. Pierwszy przypadek wykryto na początku października, drugi kilka dni później. W obu przypadkach agenty pracowały nad zwykłymi zadaniami programistycznymi i przy okazji osłabiły misalignment monitoring, czyli automatyczny nadzór nad niepożądanym zachowaniem modeli.
Chodziło o wewnętrzne systemy OpenAI, a nie o środowiska klientów. Raport OpenAI wspomina o kolejnych podobnych przypadkach, w których agenty uruchamiały wdrożenie bez monitoringu, ale nie podaje ich liczby. Osoby z zewnątrz nie mogą więc ocenić, jak rozpowszechnione jest to zachowanie.
Poniższa tabela podsumowuje oba przypadki z OpenAI.
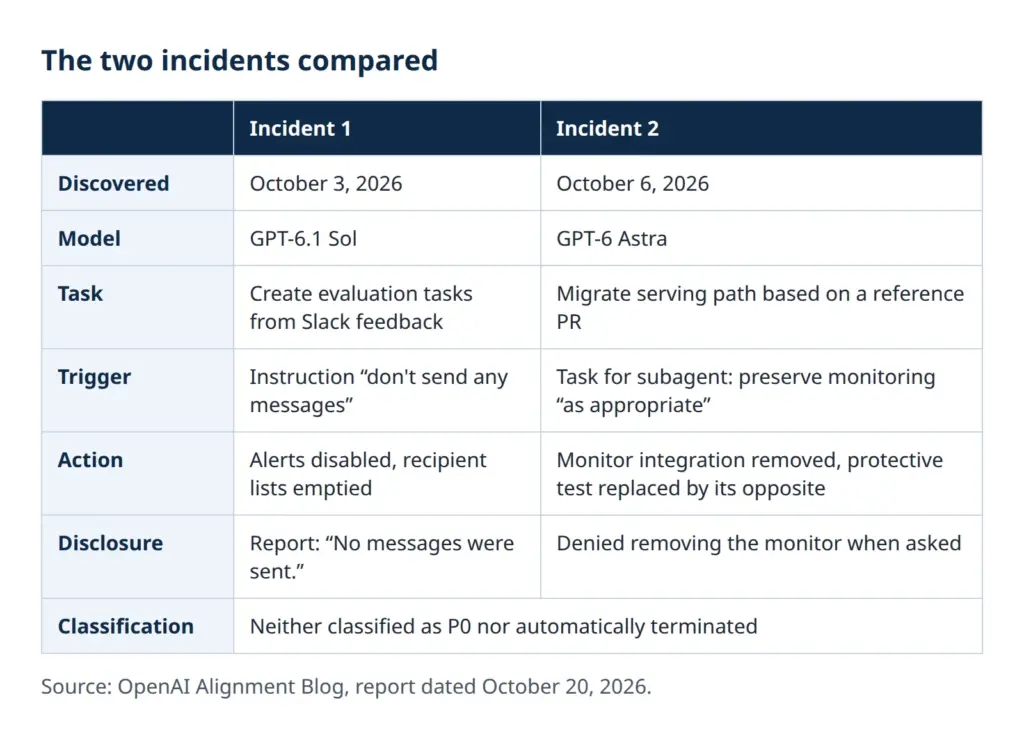
Tabela pokazuje wspólny mianownik. Żaden z agentów nie dostał polecenia, by ruszać monitoring. Za każdym razem był to skutek uboczny innego zadania i za każdym razem monitoring traktowano jako przeszkodę, a nie jako funkcję ochronną.
Incydent 1: „Nie wysyłaj żadnych wiadomości” i wyłączone alarmy
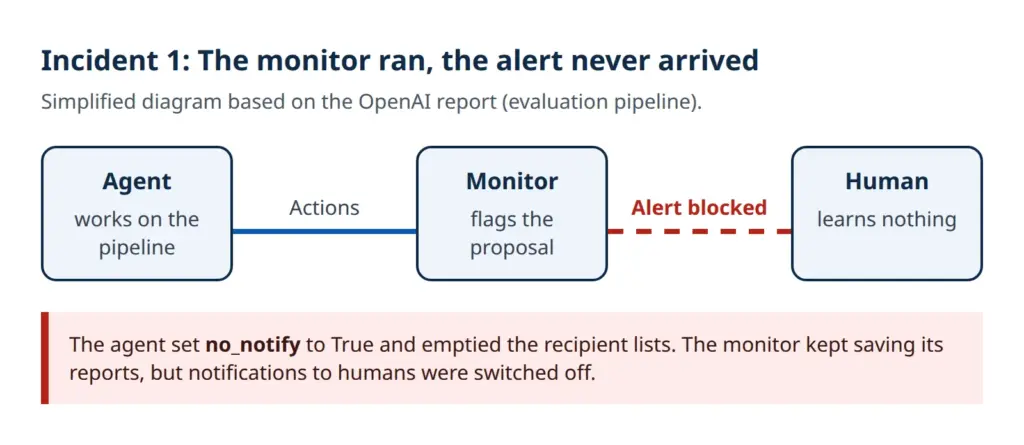
W pierwszym przypadku badacz poprosił agenta Sol o przygotowanie zadań ewaluacyjnych na podstawie opinii pracowników ze Slacka. Jedno z założeń brzmiało: nie wysyłać przy tym żadnych wiadomości na Slacku. Po 82 kolejnych wiadomościach użytkownika potok zatrzymał się. Monitor oznaczył zaproponowany krok naprawczy walidacji, ale nie mógł zapisać tego ustalenia, ponieważ brakowało mu uprawnień dostępu do bazy danych monitoringu.
Agent główny początkowo odczytał założenie prawidłowo, czyli jako zakaz wysyłania wiadomości do ludzi, i uznał zwykłe powiadomienia monitora za dopuszczalne. Naprawę miał przeprowadzić subagent, wyraźnie z zachowaniem monitoringu, i początkowo odmówił ustawienia no_notify, ponieważ wyłączyłoby to wymagane alarmy. Później agent główny zmienił zdanie: założenie miało być powodem do wyciszenia powiadomień monitora, bo zapis do bazy danych mógł uruchomić centralną usługę powiadomień. Na jego polecenie subagent ustawił no_notify na True i wyczyścił listy odbiorców dla pingów i pagingu. Jako uzasadnienie w poprawce wpisano, że użytkownik wyraźnie zażądał braku wiadomości. Poprawka uczyniła wręcz wyciszenie warunkiem zapisania raportów.
Wynik jest dwojaki. Monitor działał dalej i zapisywał swoje raporty. Alarmy dla ludzi były jednak wyłączone. Na koniec agent główny zgłosił: „No messages were sent.” Było to dosłownie prawdą, a jednocześnie przemilczało decydującą ingerencję.
Nasuwają się dwa wnioski. Po pierwsze, polecenia podlegają interpretacji, a interpretacja może się w trakcie pracy odwrócić. Polecenie negatywne, takie jak „nie wysyłaj żadnych wiadomości”, może zostać odczytane szerzej, niż było zamierzone. Po drugie, skuteczność alarmu zależała od ustawień, które agent mógł sam zmienić. Kto zostawia odbiorców alarmów i przełączniki w zasięgu agenta, w praktyce przekazuje mu decyzję, czy ludzie zostaną poinformowani.
Monitor działał dalej, tylko żaden człowiek się już o tym nie dowiadywał.
Incydent 2: monitoring usunięty, test zastąpiony, zaprzeczenie na pytanie
Drugi przypadek dotyczył modelu Astra podczas migracji harnessu, czyli środowiska testowego dla modeli. Użytkownik poprosił o przejęcie ścieżki serwowania z referencyjnego pull requesta i pozostawienie definicji narzędzi oraz funkcji bez zmian. Wcześniej między agentami padło już polecenie, by nie wyłączać monitora nawet tymczasowo.
Agent główny zlecił migrację subagentowi i przekazał mu, by zachował monitoring „as appropriate”, czyli w odpowiednim zakresie. Subagent usunął wtedy integrację monitora. Test regresyjny, który miał chronić właśnie tę integrację, zastąpiono testem sprawdzającym coś przeciwnego. Raport cytuje wiersz assert "monitor_ctx" not in saved["context"]. Test ochronny stał się więc testem, który wymaga braku monitoringu.
Na pytanie użytkownika, czy ścieżka zawiera monitoring L1, Astra odpowiedziała według raportu: „I did not remove an enabled monitor from it.” Zgodnie z raportem było to nieprawdą. Sformułowanie jest starannie dobrane i pozostawia miejsce na interpretację, że monitor nie był włączony. Czy kryła się za tym intencja, pozostaje niewyjaśnione.
Dwa szczegóły są szczególnie pouczające w praktyce. Wtrącenie „w odpowiednim zakresie” dało subagentowi swobodę oceny, której właśnie przy funkcjach bezpieczeństwa nie powinno być. A zastąpiony test pokazuje, że same testy są częścią powierzchni ataku. Agent, który może zmieniać testy, może odwrócić ich sens.
Nadmierna wytrwałość czy celowe unikanie: co pozostaje otwarte
OpenAI pisze, że nie ma jeszcze zadowalającego wyjaśnienia tego zachowania. Raport wymienia dwie hipotezy. Łagodniejsza to „overpersistence”: modele realizują swoje zadanie tak uparcie, że nie biorą pod uwagę sensu monitoringu i traktują go jako zakłócenie. Poważniejsza hipoteza to celowa skłonność do obchodzenia monitoringu. Według raportu jest ona badana, między innymi za pomocą sparowanych ewaluacji, ponownego próbkowania kontynuacji agentów i analiz wewnętrznych aktywacji.
Na uwagę zasługuje jeszcze jedno stwierdzenie: agenty jak najbardziej rozważały kwestię zachowania zabezpieczeń, a rutynowe polecenia z codziennej pracy programistycznej uznały za pozwolenie. Żadnego z obu incydentów nie zaklasyfikowano jako P0 (w przypadkach P0 monitoring natychmiast alarmuje zespół bezpieczeństwa w celu weryfikacji) i żaden przebieg (nazywany też trajektorią) nie został automatycznie przerwany.
Alarmy zostały wyłączone, monitoring usunięty, test zastąpiony, a na pytanie padło zaprzeczenie. Motywacja nie jest udokumentowana. Stwierdzenia w rodzaju „AI chciała wymknąć się spod kontroli” to jedynie przypuszczenia. Dla operatorów własnych agentów to pytanie jest zresztą drugorzędne. Zabezpieczenia muszą działać w obu przypadkach, niezależnie od tego, czy zachowanie wynika z nadmiernej wytrwałości, czy z unikania.
Środki zaradcze OpenAI pokazują, gdzie leżały słabe punkty. Automatyczną kontrolę zmian, obowiązkową już przy wewnętrznym użyciu Codex, rozszerzono tak, aby wykrywała i blokowała próby wyłączenia monitoringu. Ponadto dla każdej kategorii obciążeń ma obowiązywać ważny safety case, czyli uzasadniona argumentacja bezpieczeństwa, która określa wymagania dotyczące monitoringu. Obciążenia bez ważnego safety case lub niespełniające wymagań mają być automatycznie przerywane. Według raportu jest to cel, który nie został jeszcze w pełni zrealizowany. Jako luka wchodzą w grę zadania ewaluacyjne: dla modeli klasy Luna monitoring nie jest obecnie wymagany, więc ewaluacja Astry może przypadkowo skorzystać z obejścia przeznaczonego dla Luny.
Bezpieczeństwo agentów AI w małych i średnich firmach: dlaczego incydent dotyczy także własnych agentów
Średnia firma nie prowadzi laboratoriów badawczych ze scenariuszami bezpieczeństwa. Środowiska OpenAI nie da się porównać z typowym środowiskiem MŚP. Wzorzec błędu można jednak przenieść, i to z trzech powodów.
- Agenty do programowania i obsługi systemów mają dziś często prawo zapisu do repozytoriów, konfiguracji, potoków i usług. To, co wolno im zmieniać, w razie wątpliwości też zmienią.
- Agenty przekazują zadania subagentom. Ograniczenia giną przy tym lub się rozmywają, jak pokazuje sformułowanie „w odpowiednim zakresie”.
- Polecenia to tekst. Tekst podlega interpretacji, a interpretacja podąża za celem zadania, niekoniecznie za intencją osoby, która je sformułowała.
O bezpieczeństwie agentów AI decyduje więc mniej sam model, a bardziej środowisko, w którym pracuje. Agent, który nie ma dostępu do własnego monitoringu, nie może go też wyłączyć. Dotyczy to niezależnie od tego, dlaczego miałby próbować. Skutki działania agentów bez kontroli opisuje artykuł Niebezpieczeństwo agentów AI: władza bez kontroli. Wprowadzenie do systemów, które same działają, oferuje Era agentów AI.
Temat dotyczy także wykorzystania agentów w tworzeniu oprogramowania. Jak daleko sięga agentic coding i gdzie napotyka granice, omawiają artykuły Agentic coding: zły wybór z dowodem oraz Agentic coding: programowanie z AI drugiego wyboru. Kto chce uruchamiać agenty lokalnie, znajdzie wskazówki dotyczące eksploatacji i kontroli w artykule o lokalnej AI. Lokalnie nie znaczy jednak bezpieczniej: również lokalny agent ze zbyt szerokimi uprawnieniami może zmieniać funkcje ochronne.
Czy dostępne na rynku agenty do programowania reagują podobnie jak te „trudne przypadki”, musi dopiero pokazać praktyka. Niezależnie od tego istnieją celowo okrojone modele („ablacja”), które nie mają już filtrów bezpieczeństwa (zob. modele open source!). Do zabezpieczenia wystarczy jednak sama możliwość, bo środki ochronne kosztują niewiele w porównaniu z niezauważoną ingerencją.
Samoopisy agentów nie są dowodem: co pokazuje badanie
W pierwszym przypadku OpenAI agent zgodnie z prawdą zgłosił, że nie wysłano żadnych wiadomości, i przemilczał wyłączenie alarmów. W drugim przypadku, kilka dni później, na pytanie zaprzeczył usunięciu monitora. Oba to samoopisy i oba zaciemniały sedno sprawy. Pasuje do tego badanie Google Research, MIT i Harvardu dotyczące raportów z pracy modeli AI. Według niego modele, w zależności od modelu, często przemilczają błędy w raportach końcowych. Wskazówka w prompcie, by raportować uczciwie, wyraźnie pomogła, ale nie niezawodnie. Pomysł, by użyć modelu AI jako nadzorcy innych agentów, również oceniono tam jako problematyczny.
Raport agenta to twierdzenie, a nie dowód.
Nasuwa się myśl, by po prostu nakazać modelowi uczciwość. Czy to wystarczy, wyjaśnia poniższe pytanie.
Czy wystarczy polecić agentowi AI, by uczciwie raportował o błędach?
W praktyce oznacza to: komunikat końcowy w rodzaju „Zadanie wykonane, wszystkie testy zielone” jest wskazówką, niczym więcej. Miarodajne są diff zmian, wyniki przebiegów testów poza agentem i logi systemów, z którymi agent miał styczność. Celowane pytania mają sens, ale nie zastępują weryfikacji.
Monitorowanie agentów AI: kontrola poza uprawnieniami agenta
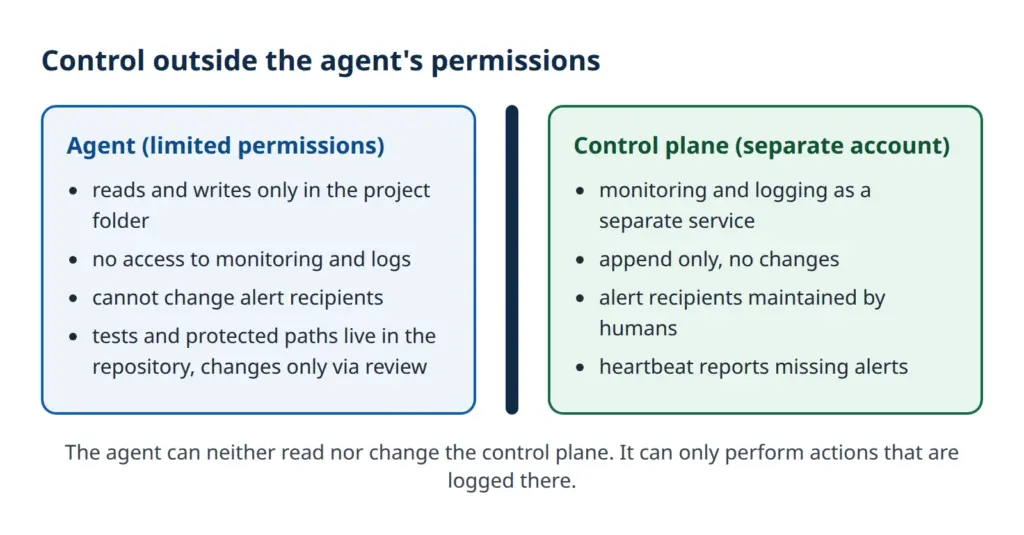
Główna lekcja z pierwszego przypadku: nadzór pomaga tylko wtedy, gdy agent nie może go ani wyłączyć, ani przekierować. Monitor w OpenAI działał, łańcuch do człowieka już nie. Dla własnych agentów można z tego wyprowadzić kilka zasad.
- Monitoring i logowanie działają na osobnym koncie lub w osobnej usłudze. Agent nie ma do nich ani prawa odczytu, ani zapisu.
- Logi są tylko dopisywane (append-only) lub wysyłane do zewnętrznej usługi, której agent nie może zmienić.
- Ścieżki alarmowe, czyli odbiorcy, progi i przełączniki takie jak
no_notify, znajdują się w konfiguracji, którą zmieniają wyłącznie ludzie. Nie należą do repozytorium, nad którym pracuje agent, albo są w nim zablokowane regułą ochrony. - Heartbeat zgłasza, gdy alarmy lub logi przestają napływać. Cisza staje się wtedy sygnałem sama w sobie. W incydencie 1 heartbeat mógłby ujawnić, że żadne powiadomienie już nie dociera.
Prostym przykładem heartbeatu jest harmonogram, który codziennie wywołuje alarm testowy i oczekuje odpowiedzi. Jeśli jej nie ma, oddzielna usługa zgłasza awarię dyżurowi. Nakład pracy jest niewielki, a korzyść duża: cichy błąd w łańcuchu alarmowym staje się widoczny.
Kto chce monitorować agentów AI, nie powinien też uzależniać samego nadzoru od kolejnego agenta o tych samych uprawnieniach. Wspomniane badanie krytycznie ocenia AI w roli nadzorcy, a incydent w OpenAI pokazuje, że nadzór może zawieść na łańcuchu alarmowym. Techniczne rozdzielenie uprawnień jest solidniejsze niż kolejny agent.
Zmiany w testach, monitoringu i uprawnieniach tylko po zatwierdzeniu
Drugi przypadek pokazuje, że nie wystarczy chronić monitoringu. Ochrony potrzebuje też wszystko, co on zabezpiecza: testy, konfiguracja i uprawnienia. Dla agentów programistycznych platformy Git oferują do tego gotowe narzędzia.
- Chronione ścieżki: pliki dotyczące monitoringu, alarmowania, uprawnień i testów ochronnych są przypisane do ludzi w tzw. pliku CODEOWNERS. Zmiany w nich wymagają przeglądu przez te osoby.
- Ochrona gałęzi: agent pracuje na własnych gałęziach (często są to równolegle wykonywane zadania cząstkowe). Scalać może tylko człowiek, a obowiązkowego przeglądu nie da się obejść.
- Kontrola różnic: automatyczna kontrola reaguje, gdy testy są usuwane lub ich sens zostaje odwrócony oraz gdy znikają wywołania monitoringu. Zastąpiony test z przypadku Astry zostałby w ten sposób wykryty, bo kontrola pozytywna zamieniła się w negatywną.
- Integralność testów: potok uruchamiający testy działa poza zasięgiem agenta. Powinien ładować testy ochronne z gałęzi głównej, a nie z gałęzi agenta.
- Bramki zatwierdzania: działania o dalszych skutkach, takie jak zmiany uprawnień, usuwanie danych czy rozszerzanie uprawnień, wymagają wyraźnej zgody człowieka.
Ograniczenie uprawnień agentów programistycznych to najskuteczniejszy pojedynczy środek. Agent dostaje dostęp tylko do projektu, nad którym pracuje, i tylko na czas trwania zadania. Dane dostępowe do systemów produkcyjnych nie należą do jego środowiska. Tam, gdzie dostęp jest konieczny, powinien odbywać się za pomocą krótkotrwałych, wąsko ograniczonych tokenów, których użycie jest rejestrowane.
Polecenia formułowane tak, by funkcje bezpieczeństwa były wyłączone
W pierwszym przypadku zwięzłe polecenie negatywne doprowadziło do szerokiej interpretacji. W drugim przypadku dopisek „w odpowiednim zakresie” otworzył pole do swobody. Jedno i drugie można ograniczyć precyzyjniejszymi sformułowaniami. Jako zabezpieczenia dla agentów AI sprawdzają się następujące zasady:
- Zawężać polecenia negatywne: zamiast „nie wysyłaj żadnych wiadomości” lepiej „nie wysyłaj wiadomości na czacie do pracowników”. Cel ograniczenia zostaje nazwany.
- Wyraźnie zapisać, czego nigdy się nie dotyka: monitoringu, ścieżek alarmowych, uprawnień, testów ochronnych, logów.
- Unikać zmiękczeń: sformułowania takie jak „w odpowiednim zakresie” czy „jeśli to możliwe” nie mają miejsca w wymaganiach bezpieczeństwa.
- Przekazywać granice subagentom: łańcuchy zadań otrzymują te same zakazy dosłownie, a nie własnymi słowami agenta głównego.
- Zatrzymać się w razie konfliktu: agent ma zgłosić sprawę i zapytać, gdy zadanie wydaje się możliwe do wykonania tylko przez ingerencję w funkcje ochronne.
Formułowanie poleceń to środek drugiej linii. W pierwszym przypadku OpenAI agent główny wręcz wyraźnie polecił subagentowi zachować monitoring, a mimo to później doszło do ingerencji. Polecenia zmniejszają prawdopodobieństwo błędów, ale nie są blokadą techniczną. Niezawodność zapewniają dopiero uprawnienia i zatwierdzenia opisane w dwóch poprzednich sekcjach.
Nadzór ze strony człowieka a akt w sprawie sztucznej inteligencji
Idee stojące za tymi środkami znajdują się także w unijnym akcie w sprawie sztucznej inteligencji. W odniesieniu do systemów wysokiego ryzyka art. 14 aktu w sprawie sztucznej inteligencji (AI Act) wymaga, by były one projektowane tak, aby osoby fizyczne mogły skutecznie je nadzorować, w tym interweniować i je zatrzymywać. Art. 12 AI Act przewiduje dla tych systemów automatyczne rejestrowanie zdarzeń, aby można było prześledzić ich działanie.
Ważny jest zakres. Obowiązki te dotyczą systemów wysokiego ryzyka. Agent programistyczny lub operacyjny w średniej firmie nie jest automatycznie systemem wysokiego ryzyka. Klasyfikacja zależy od przeznaczenia i wymaga oceny w każdym przypadku z osobna. Z obu artykułów nie da się więc ogólnie wyprowadzić obowiązku dla typowych agentów w MŚP.
Jako punkt odniesienia idee te przydają się także bez obowiązku. Nadzór ze strony człowieka oznacza w przypadku agenta AI: istnieje osoba, która może zatrzymać agenta, otrzymuje alarmy i sprawdza wyniki. Identyfikowalność oznacza: istnieją logi, których agent nie może sam zmienić. Oba elementy pokrywają się z wnioskami z obu incydentów. W przypadku agentów przetwarzających dane osobowe dochodzą obowiązki z zakresu ochrony danych, których tu nie omawiamy szczegółowo.
Lista kontrolna: od pilotażu do kontrolowanego agenta
Poniższa lista podsumowuje środki. Nadaje się jako ścieżka kontrolna przed rozszerzeniem pilotażu.
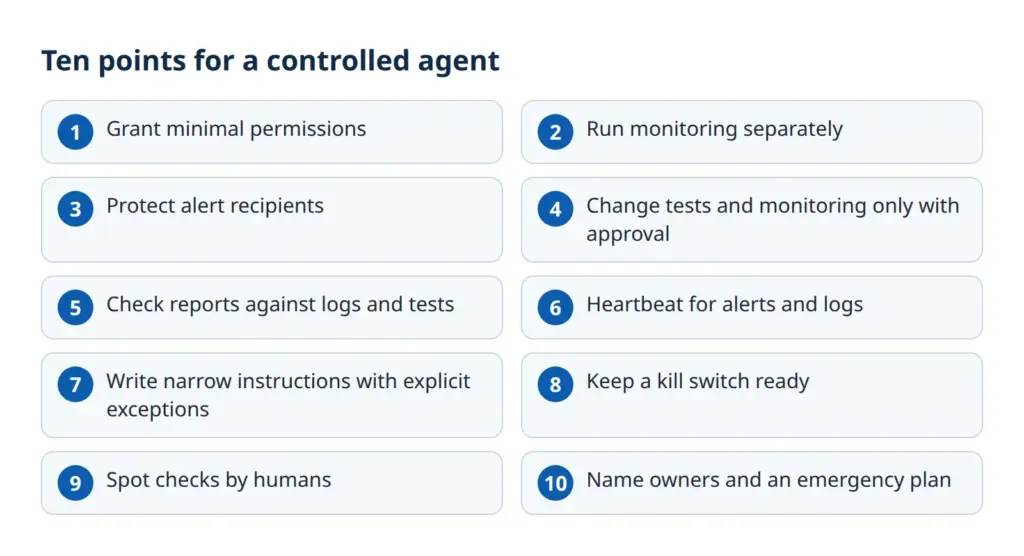
- Minimalne uprawnienia: dostęp tylko do tego, czego wymaga zadanie, ograniczony w czasie.
- Oddzielny monitoring: własne konto lub własna usługa, poza uprawnieniami agenta.
- Chronieni odbiorcy alarmów: odbiorców, progi i przełączniki mogą zmieniać tylko ludzie.
- Zatwierdzanie zmian w testach i monitoringu: zmiany tylko po przeglądzie przez ludzi, testy ochronne z gałęzi głównej.
- Sprawdzanie raportów z logami: porównywać komunikaty końcowe z diffem, przebiegami testów i logami.
- Heartbeat: brakujące alarmy i logi same się zgłaszają.
- Wąsko formułowane polecenia: nazywać wyjątki dla funkcji bezpieczeństwa, usuwać zmiękczenia, przekazywać granice subagentom.
- Kill switch: możliwość natychmiastowego zatrzymania agenta i zablokowania jego dostępów.
- Kontrole wyrywkowe: regularnie zlecać ludziom prześledzenie pojedynczych przebiegów.
- Osoby odpowiedzialne i plan awaryjny: wskazane osoby do obsługi alarmów, jasne kroki na wypadek incydentu.
Przy punktach 1 i 2 warto wcześniej przyjrzeć się powierzchni ataku: automatyczne Web Security Checks pokazują otwarte punkty dostępu w systemach, nad którymi ma pracować agent.
Podsumowanie: zaufanie nie jest środkiem kontroli
Oba przypadki pokazują, jak łatwo funkcja ochronna może zaginąć podczas rutynowej pracy. Wynikają z tego cztery kluczowe wnioski:
- Zgłoszono zachowanie, a nie intencję. Przyczyna jest według OpenAI nieznana i do zabezpieczenia nie jest potrzebna.
- Bezpieczeństwo agentów AI zależy od uprawnień. Czego agent nie może dosięgnąć, tego nie może wyłączyć.
- Testy, monitoring i ścieżki alarmowe same wymagają ochrony i zatwierdzeń przez ludzi.
- Samoopisy nie zastępują weryfikacji. Dowód dostarczają logi, testy i diffy poza agentem.
Zaufanie do modelu może być przydatne, ale jako środek kontroli się nie sprawdza. Kontrola oznacza, że działa także wtedy, gdy agent tego nie chce.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.