Szef Google Sundar Pichai mówi, że branża jest wciąż daleko od stanu końcowego samodoskonalącej się AI, czyli rekurencyjnego samodoskonalenia. Jednocześnie opisuje pętle, w których agenci AI już dziś pomagają budować nowe modele. Na podstawie dzisiejszej wiedzy można ocenić, co z tego jest udokumentowane i co oznacza to dla wykorzystania AI w małych i średnich przedsiębiorstwach. Czy ludzkość jest zagrożona?
Punktem wyjścia jest wywiad, o którym Big Technology poinformowało 23.10.2026. Pada w nim zdanie o samodoskonalącej się AI, które łatwo zacytować: branża jest wciąż daleko od stanu końcowego RSI. RSI to skrót od Recursive Self-Improvement, czyli rekurencyjnego samodoskonalenia. Chodzi o obieg, w którym systemy AI ulepszają swoich następców, a ci z kolei budują jeszcze lepszych następców.
Podstawy działania takich pętli przedstawia artykuł o rekurencyjnym samodoskonaleniu AI. Wypowiedzi z wywiadu, deklaracje producentów, praca badawcza i prognoza osób z branży zostały poniżej przedstawione osobno, obok siebie.
Co Pichai powiedział, a czego nie
Sedno jest krótkie. Według relacji Alexa Kantrowitza Pichai powiedział: „To be very clear. We are pretty far from the end state of RSI.” Znaczy to mniej więcej: „Mówiąc jasno: od stanu końcowego rekurencyjnego samodoskonalenia branża jest jeszcze dość daleko.” Kantrowitz zestawia to zdanie z oczekiwaniem niektórych osób z branży AI, że eksplozja inteligencji jest tuż-tuż, a AI wkrótce będzie się doskonalić w pełnej pętli bez udziału człowieka.
Zaraz potem padają dwa kolejne zdania, które dla oceny są ważniejsze niż pierwsze. Pichai powiedział: „You have RSI loops along with AI researchers in various aspects of model development.” Oraz: „You almost have agents helping AI researchers in some automated way work together to build these models.” W skrócie: w różnych obszarach rozwoju modeli istnieją pętle sprzężenia zwrotnego wspólnie z badaczami, a agenci pomagają im, częściowo w sposób zautomatyzowany, w budowaniu modeli.
Dosłownie udokumentowane jest więc to, że pętle częściowe już działają, i to razem z badaczami. O modelu, który bez nadzoru sam się przebudowuje, w tych zdaniach nie ma mowy. Zdanie o stanie końcowym można odczytać tak, że chodzi właśnie o ten obraz.
Jako wątek poboczny Big Technology pisze o mocy obliczeniowej. Pichai mówi, że brakuje jej wszystkim, nie tylko Google: „The compute we have today is a function of decisions I made in 2024.” Według relacji mówi też, że biznes chmurowy raz po raz rezygnuje z krótkoterminowych przychodów, ponieważ moc obliczeniowa jest rezerwowana na rozwój czołowych modeli. Dla samodoskonalenia ma to znaczenie, bo każda pętla złożona z pomysłu, eksperymentu i oceny kosztuje czas obliczeniowy. Tam, gdzie go brakuje, hamuje on również zautomatyzowane badania.
Nieudokumentowane są ramy czasowe. Relacje z drugiej ręki, takie jak DigitalToday, podają „przyszły rok” jako termin dalszych postępów.
Poniżej interpretacja, która nie pochodzi od Pichaia. Kto mówi o stanie końcowym, zakłada, że istnieje do niego droga i że ta droga się już rozpoczęła. Dlatego zdanie to można odczytać także jako wypowiedź na rzecz RSI: rozwój trwa, Google napędza go dużym nakładem sił, a za kilka lat możliwe są wielkie sukcesy. To oczekiwanie jest własną oceną. Odpowiedniej wypowiedzi Pichaia w przeczytanych źródłach nie ma.
Możliwe odczytanie: kto mówi o stanie końcowym, zakłada, że droga do niego już się rozpoczęła. Zdanie byłoby wtedy nie tyle uspokojeniem, ile określeniem obecnej pozycji.
Samodoskonaląca się AI: pętla agentów a zmiana wag
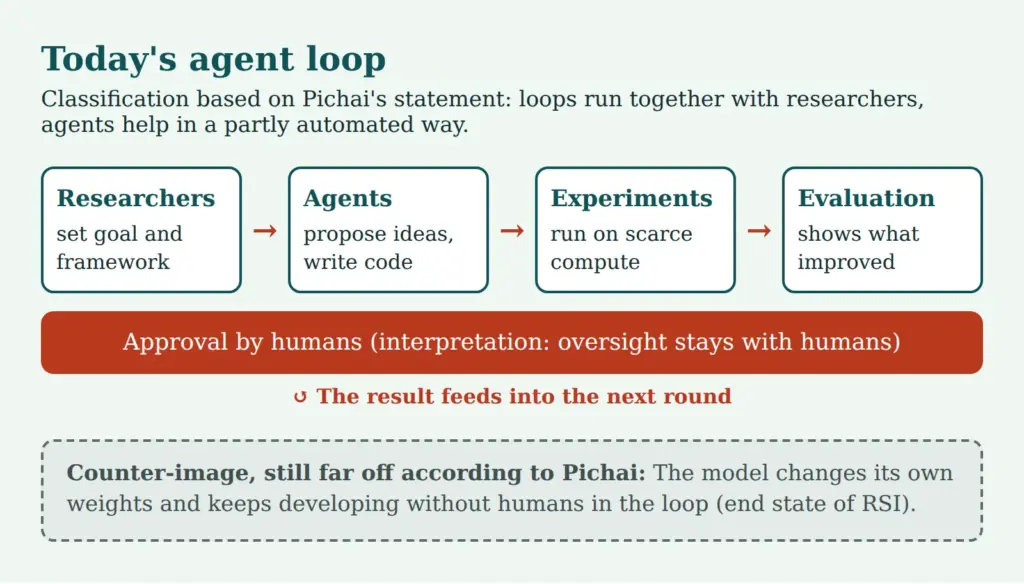
Za tym pojęciem kryją się dwie bardzo różne rzeczy, które na co dzień często się miesza. Pierwszą jest pętla agentów. Tutaj agenci AI współpracują przy rozwoju: proponują eksperymenty, piszą i zmieniają kod, uruchamiają przebiegi treningowe, oceniają wyniki i przekazują informację zwrotną. Ludzie wyznaczają cele, sprawdzają wyniki i decydują o zmianach. Ten obieg ulepsza procesy, narzędzia i przebieg pracy.
Drugą jest zmiana wag. W tym przypadku model zmieniałby własne wagi tak, aby jego następca był lepszy, i to bez udziału człowieka, który zatwierdza wyniki po drodze. To właśnie ten obraz stoi za pojęciem eksplozji inteligencji. I właśnie od tego, jak można odczytać słowa Pichaia, branża jest jeszcze daleko.
Między tymi biegunami nie ma przełącznika, lecz spektrum. Liczba kroków, które agenci wykonują bez pytania, może rosnąć. Wraz z nią rośnie część rozwoju, którą ludzie kontrolują już tylko wyrywkowo. Jak agenci działają w praktyce i dlaczego wymaga to kontroli, opisuje artykuł o erze agentów AI.
Kluczowe pytanie zasługuje na rzeczową odpowiedź. Można ją wyprowadzić z udokumentowanych zdań.
Czy Google już prowadzi rekurencyjne samodoskonalenie, skoro AI pomaga budować kolejne modele?
Dla MŚP ta różnica nie jest akademicka. Pętla agentów przyspiesza cykle modeli, przy czym utrata kontroli nie jest tu tematem. Zmiana wag bez nadzoru rodziłaby pytanie, czy ludzie są jeszcze w stanie prześledzić zmiany. Oba pytania wymagają różnych odpowiedzi, a w praktyce dziś pojawia się tylko pierwsze.
Co Google i inni mówią o własnych postępach
Wypowiedzi producentów o własnych postępach to deklaracje własne. Mogą być prawdziwe, ale nie zostały niezależnie sprawdzone. Dotyczy to wszystkiego, co znajduje się w tej sekcji.
Aktualnym przykładem jest Flint. Firma Recursive przedstawia model w swoim ogłoszeniu jako szybki model do programowania na lokalny sprzęt, z łącznie 40 miliardami parametrów i 2,5 miliarda aktywnych na token (czyli model typu Mixture of Experts). Według własnego opisu mały zespół ludzi i agentów zbudował go w niecałe cztery miesiące. Zautomatyzowany system badawczy, „Eureka Machine”, miał współtworzyć niemal każdy element łańcucha budowy modelu, od danych i receptur treningowych po inferencję. Benchmarki pochodzą od producenta i nie zostały niezależnie zweryfikowane. Recursive sam ostrzega, że Flint może wymagać więcej wskazówek niż duże zamknięte modele.
Dla firm jest to interesujące z dwóch powodów. Po pierwsze, przypadek ten pokazuje, że zautomatyzowane badania już dziś dają produkty, także w małych zespołach. Po drugie, model działa lokalnie. Kto nie chce wysyłać wrażliwych danych do dostawców chmury, zyskuje dodatkową opcję, przy czym deklaracje producenta nie zostają przez to udowodnione. Jak ocenić lokalne modele w firmie, pokazuje przegląd lokalnej AI w przedsiębiorstwie.
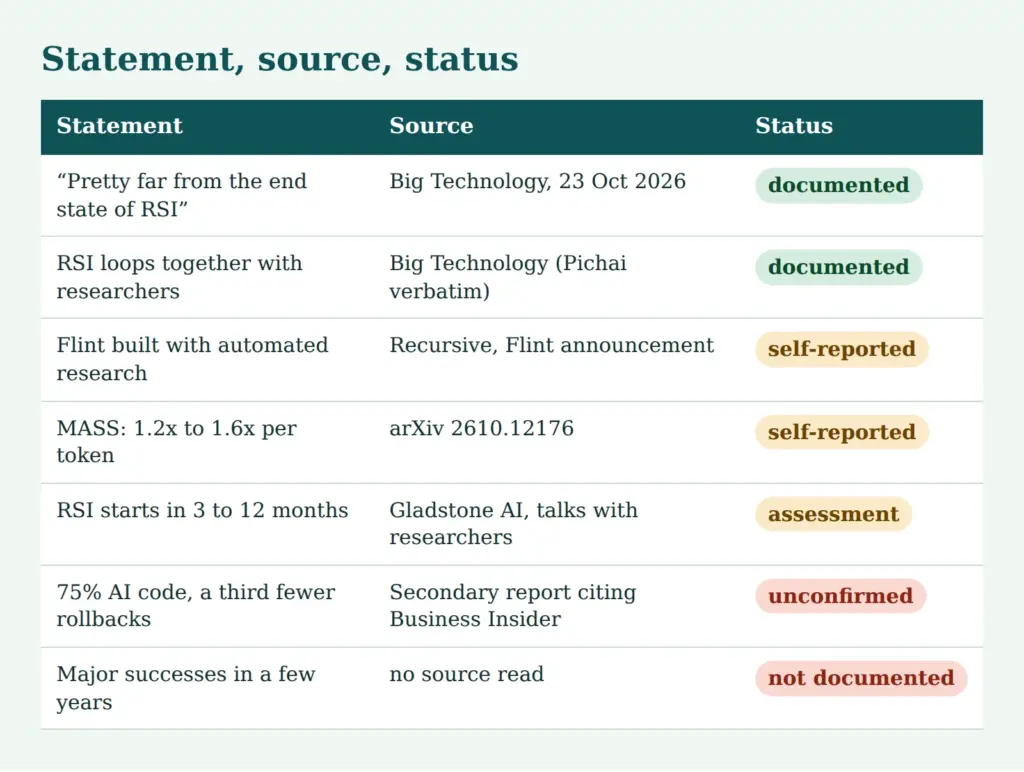
Zestawienie pokazuje, jak należy klasyfikować wypowiedzi z tego artykułu. Udokumentowane są dwa zdania Pichaia w brzmieniu z relacji. Liczby producentów i badaczy pochodzą z deklaracji własnych. Gladstone to ocena oparta na rozmowach z badaczami, a nie pomiar. Liczba dotycząca kodu pozostaje niepotwierdzona, a rzekome ramy czasowe „za kilka lat” nie są udokumentowane jako wypowiedź Pichaia.
Co pokazują badania i gdzie się kończą
Pewna praca badawcza pozwala zobaczyć, jak taka pętla może wyglądać. Pod tytułem „Recursive Self-Improvement through Multi-Agent Self-Supervision” (zgłoszona 8 października 2026) opisano metodę MASS. Pojedynczy model bazowy, w pracy Qwen3.6-27B, proponuje przepływy pracy z wieloma agentami, wykonuje je i sam je ocenia. Następnie jest dotrenowywany na własnych przebiegach, a procedura się powtarza.
Po dwóch cyklach abstrakt podaje 1,2- do 1,6-krotną wydajność na token wyjściowy w czterech otwartych benchmarkach. Ponadto model trenowany na przebiegach wielu agentów miał być lepszy od modelu trenowanego na przebiegach pojedynczego agenta z 40 procentami więcej danych treningowych.
Ograniczenia widać w samym materiale. Chodzi o jeden model i dwa cykle. Sygnał poprawy pochodzi z samooceny. W dwóch benchmarkach programistycznych, Terminal-Bench 2.0 i SWE-bench Verified, na jednym z wykresów w pracy widnieją wartości 0,96 i 0,94, czyli w przeliczeniu na token nieco poniżej wartości wyjściowej. W tych dwóch testach wykres nie pokazał więc zysku na token.
Punkt wyjścia autorów pasuje do (nadrzędnego) tematu „nadzoru”. Piszą oni, że pojedynczy model ma trudność z krytyką i ulepszaniem własnych złożonych rozumowań, gdy pracuje w jednorodnej pętli. Dlatego stawiają na wiele instancji o różnych rolach. Gdy ten sam model generuje i ocenia, wspólne błędy mogą pozostać niewykryte. To wniosek wynikający z podejścia. Sformułowania pracy dotyczą metody, a nie firm.
Badania dowodzą, że pomysł może działać i że wąskim gardłem jest weryfikacja. Nie dowodzą, że modele w codziennej praktyce niezawodnie doskonalą się bez ludzi. To zgadza się ze zdaniem Pichaia i mu nie przeczy.
Jak szybko to może pójść: Gladstone i granice prognozy
Badacze z Anthropic, OpenAI i Google DeepMind spodziewali się, że rekurencyjne samodoskonalenie rozpocznie się w ciągu najbliższych trzech do dwunastu miesięcy, być może wcześniej, przy założeniu, że rząd USA nie zainterweniuje ani nie przyhamuje.
Ankietowani mają własny interes w dynamice tej dziedziny, a autorzy to organizacja skupiona na polityce bezpieczeństwa.
Zautomatyzowane badania mogą być technicznie możliwe, nie będąc opłacalnymi. Wąskim gardłem nie są dobre pomysły, lecz czas obliczeniowy potrzebny do ich przetestowania. Zgadza się to z uwagą Pichaia o niedoborze mocy obliczeniowej.
Te wypowiedzi się nie wykluczają. „Początek” i „stan końcowy” to różne punkty na tej samej drodze. Pichai mówi, że droga jest długa, i jednocześnie opisuje, że pętle działają razem z badaczami. Gladstone oczekuje, że część z tego wkrótce stanie się bardziej autonomiczna. Kto czyta jedno i drugie, otrzymuje obraz, w którym rekurencyjne samodoskonalenie narasta krok po kroku. Opieranie planowania wyłącznie na podanych liczbach miesięcy jest ryzykowne, ponieważ pochodzą one z niewielkiego grona rozmówców.
Skutki dla MŚP: testować cykle modeli i zmiany modeli
W firmach efekt nie objawia się jako eksplozja inteligencji, lecz w kalendarzu i w technice. Gdy agenci odciążają badaczy, nowe wersje modeli mogą pojawiać się częściej. Dla działalności liczy się jednak, niezależnie od przyczyny, jedno: modele zmieniają się szybciej, niż działy merytoryczne dostosowują procesy.
Ma to praktyczne konsekwencje. Model może przy tym samym prompcie odpowiadać inaczej niż jego poprzednik. Ton, format, rodzaje błędów i koszty na zadanie się przesuwają. Dostawcy wycofują starsze wersje, czasem z krótkim wyprzedzeniem. A kto polega na aliasie „latest”, dostaje zmiany na produkcji bez pytania.
Wynika z tego prosta procedura zmiany modelu. Po pierwsze, korpus testowy z prawdziwych zadań, na przykład 50 do 200 zanonimizowanych przypadków ze znaną dobrą odpowiedzią (częściowo można je nawet wygenerować za pomocą AI!). Po drugie, przebieg porównawczy nowego modelu z aktualną wersją przy niezmienionych promptach. Po trzecie, zatwierdzenie przez wskazaną z nazwiska osobę, która widziała jakość, koszty i obraz błędów. Po czwarte, ścieżka powrotu (rollback), czyli ustalona wersja modelu i zachowana konfiguracja, aby przełączenie z powrotem udało się w kilka minut.
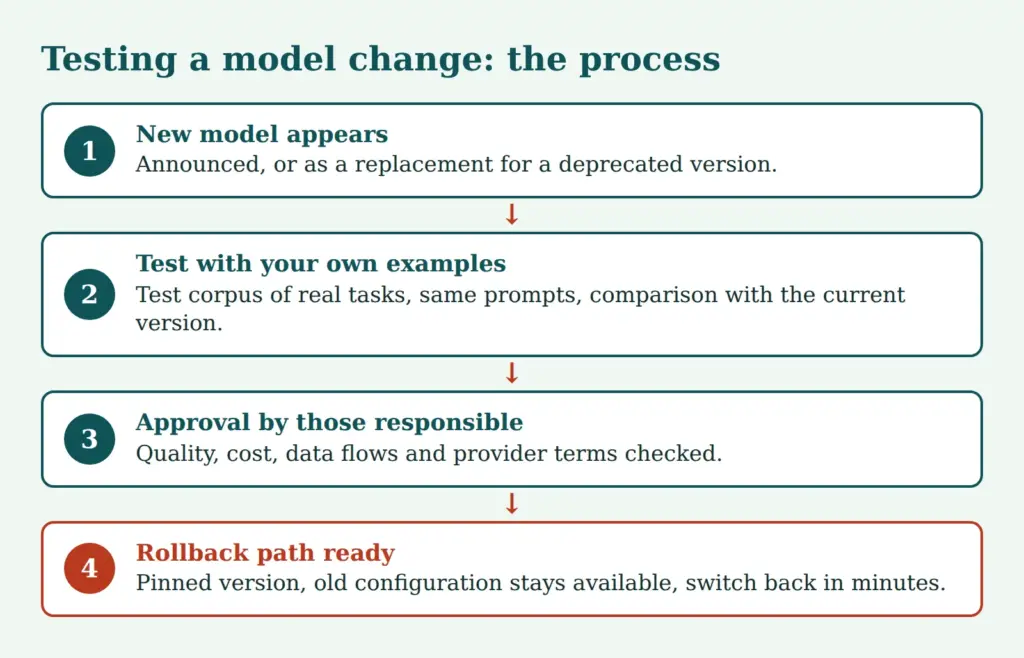
Przy zmianie dostawcy lub nowym modelu dotychczasowego dostawcy dochodzą ochrona danych i umowa. Trzeba wyjaśnić przepływy danych, lokalizację serwerów, powierzenie przetwarzania danych oraz to, czy dane wejściowe są wykorzystywane do treningu. Automatyczne przechodzenie na najnowszy model nie powinno być dozwolone na produkcji. Modele lokalne przesuwają to pytanie: usuwają zależność od dostawcy, ale wymagają własnego utrzymania, zob. przegląd lokalnej AI.
Małe firmy nie muszą w tym celu tworzyć własnego działu testów. Na początek wystarczą arkusz z przykładami, skrypt, który przepuszcza je przez oba modele, i krótka notatka o zatwierdzeniu.
Zachować nadzór i zatwierdzenia: co pozostaje zadaniem człowieka
Gdy programiści we własnej firmie używają agentów z uprawnieniami do zapisu, w małej skali powstaje ta sama pętla co w laboratoriach: agent zmienia kod, uruchamiają się testy, agent poprawia. Nadzór można zorganizować według tego samego wzorca. Agent może proponować i testować, ale zmiany w systemach produkcyjnych, konfiguracjach i danych zatwierdza wskazana z nazwiska osoba.
Należą do tego logi, które pozwalają prześledzić, co zrobił agent, oraz uprawnienia tak wąskie, jak to konieczne. Usuwanie, wysyłanie i płacenie to działania, które zasługują na dodatkowe potwierdzenie. Jakie ryzyka niesie agent bez kontroli, opisuje artykuł Zagrożenie związane z agentami AI.
Ważne jest też pytanie, kto sprawdza. Gdy ten sam model generuje i ocenia, pozostają te same martwe punkty. W praktyce oznacza to: jedna AI może sprawdzać drugą, ale tylko dodatkowo. Wiarygodna kontrola krzyżowa pochodzi z testów, od innego dostawcy lub od człowieka.
AI wiarygodnie sprawdza AI tylko wtedy, gdy kontrola krzyżowa jest niezależna: poprzez testy, innego dostawcę lub człowieka.
Odpowiedzialność pozostaje po stronie firmy, która używa agenta. Dotyczy to niezależnie od tego, jak duża część rozwoju jest zautomatyzowana w tle. Stwierdzenie, że AI sama się doskonali, nie zwalnia operatora z odpowiedzialności.
Lista kontrolna
Lista kontrolna ma pomóc odpowiedzieć na pytanie, co należy zrobić teraz, a czego nie:
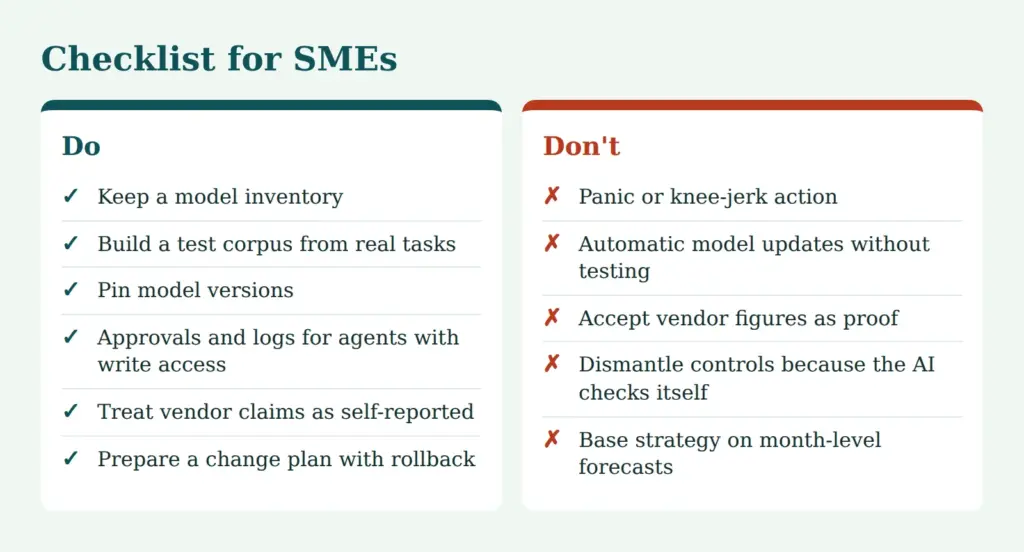
Poszczególne punkty:
Inwentarz modeli rejestruje, jakie modele w jakiej wersji działają w jakim miejscu, kto za nie odpowiada i jakie dane przepływają. Korpus testowy rośnie z każdym błędem, który ujawni się w praktyce. Wersje są ustalone i zmieniane wyłącznie po testach. Dla agentów z uprawnieniami do zapisu obowiązują zatwierdzenia i logi. Deklaracje producentów, czy to dotyczące benchmarków, czy udziału AI w kodzie, traktuje się jako deklaracje własne, a nie jako dowód.
Niezalecane są panika i pochopne działania, ponieważ udokumentowana sytuacja to pętla częściowa z udziałem ludzi. Tak samo nie należy ograniczać kontroli dlatego, że AI sama się sprawdza. A strategie opierające się na liczbach miesięcy z prognoz stoją na grząskim gruncie. Kto chce dodatkowo sprawdzić stronę techniczną, na przykład uprawnienia i powierzchnię ataku systemów, znajdzie punkt wyjścia w testach bezpieczeństwa na wwwschutz.de.
Podsumowanie
Podsumowując, wypowiedzi i obecny stan, który może zmieniać się z dnia na dzień, można uporządkować następująco.
Pichai potwierdza, że istnieją pętle sprzężenia zwrotnego z udziałem badaczy i że stan końcowy bez ludzi jest jeszcze daleko. Nie jest to powód do uspokojenia. Możliwe odczytanie jest takie, że droga już trwa, a wielkie postępy są możliwe za kilka lat.
Dla MŚP liczą się krótsze cykle modeli, testy przed każdą zmianą, ustalone wersje i zatwierdzenia dla agentów. Czy pętla stanie się wyraźnie bardziej autonomiczna za trzy miesiące, czy za trzy lata, nikt dziś nie wie na pewno. Kto opanował testy, zatwierdzenia i rollback, jest przygotowany na oba scenariusze.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.