W listopadzie 2026 roku Anthropic przedstawił dwa nowe modele, tańsze i szybsze od poprzedników. Dla firm pytanie dotyczy mniej tego, czy model robi wrażenie, a bardziej tego, czy zmiana rzeczywiście poprawia ochronę danych, jakość i koszty. Decyzję ułatwia lista kontrolna.
Wraz z Claude Fable 5.2 i Claude Mythos 5.2 pojawiły się dwa nowe modele z tej samej rodziny. Doniesienia dotyczą głównie tempa, cen i kwestii bezpieczeństwa. W codzienności małej lub średniej firmy liczą się inne rzeczy: jakie dane dokąd płyną, jak długo pozostają u dostawcy, co się dzieje z istniejącymi procesami, gdy model się zmienia, i ile naprawdę kosztuje rozwiązane zadanie.
Co Anthropic zapowiedział w sprawie Fable 5.2 i Mythos 5.2
Fable 5.2 jest dostępny od 9 listopada 2026 roku, zarówno na Claude Platform, jak i u dużych dostawców chmury AWS, Google Cloud i Microsoft Azure. Identyfikator modelu to claude-fable-5-2. Mythos 5.2 jest natomiast otwarty tylko dla zweryfikowanych organizacji, na przykład w ramach programów z zakresu cyberbezpieczeństwa lub nauk przyrodniczych. Oba modele opierają się na tym samym modelu bazowym. Fable ma silniejsze zabezpieczenia w obszarach wrażliwych i dlatego może być oferowany ogólnie.
Cena wynosi 8 dolarów amerykańskich za milion tokenów wejściowych i 40 dolarów za milion tokenów wyjściowych. W Fable 5.1 było to jeszcze 10 i 50 dolarów. Wyjście jest nawet o ok. 30 % szybsze niż u poprzednika. Kto potrzebuje większej prędkości, może zamówić tryb szybki, który przyspiesza wyjście do 2,5 raza i kosztuje dwa razy więcej, czyli 16 i 80 dolarów za milion tokenów. W przypadku Mythos ten tryb jest dostępny tylko dla organizacji w programach weryfikacji.
Uwagę zwraca rekomendacja samego producenta. Do większości zadań programistycznych i wiedzowych w codziennej pracy modelem z wyboru ma być Opus 5.5. Fable i Mythos są przeznaczone do szczególnie wymagających zadań. Największy model nie jest automatycznie właściwy.
Kolejny punkt dotyczy bezpieczeństwa. Oba modele częściej niż wcześniejsze wyrażają podejrzenie, że właśnie są testowane. Utrudnia to ocenę, jak zachowają się w rzeczywistej eksploatacji.
Claude Fable 5.2 w firmie: kiedy zmiana się opłaca
Nowy model budzi odruch, by stosować go wszędzie. Trzeźwo patrząc, pytanie brzmi, które zadania w firmie faktycznie zawodzą na granicy wydajności dotychczasowego modelu. W wielu firmach jest ich zaskakująco mało. Streszczenia, szkice odpowiedzi, sortowanie wpływających zgłoszeń, analizy tabel i większość pomocy w programowaniu działają niezawodnie na dobrym modelu średniej klasy.
W naszej własnej próbie okazało się, że przy wymagających zadaniach standardowych, takich jak przebudowa średniej wielkości modułu, analiza dłuższego projektu umowy czy przygotowanie czystego zestawienia z kilku źródeł, Opus 5.5 dawał wyniki, które ledwie różniły się od wyników droższego modelu. Dopłata nie kupowała lepszej odpowiedzi. Fable pokazał siłę tam, gdzie zadania trwają długo, a model samodzielnie wykonuje wiele kroków: zlecenie, które godzinami czyta pliki, sprawdza hipotezy, wywołuje narzędzia i samo się koryguje. Tam liczy się to, że każdy krok pośredni musi się zgadzać, bo drobne błędy się sumują.
To pasuje do logiki stopni modeli. Im dłużej trwa przebieg i im mniej człowiek ingeruje po drodze, tym bardziej opłaca się model, który rzadko traci kierunek. Przy krótkich zadaniach z kontrolą człowieka na końcu ta sama siła daje niewiele.
Fable opłaca się tam, gdzie model długo pracuje sam. Do wymagającego zadania standardowego Opus 5.5 w zupełności wystarcza.
Wraz z autonomią rośnie także ryzyko. Agent, który samodzielnie zmienia pliki i sięga do systemów, potrzebuje granic. Jak może działać władza bez kontroli, opisano w tekście o zagrożeniach związanych z agentami AI. Dla zmiany oznacza to: im bardziej autonomiczne zastosowanie, tym surowsze muszą być uprawnienia i kontrole, i tym bardziej uzasadnione jest w ogóle sięganie po duży model.
Wynika z tego prosta zasada praktyczna. Zadania standardowe zostają na Opus 5.5 lub na jeszcze mniejszym modelu. Fable rezerwuje się dla nielicznych długotrwałych, silnie autonomicznych procesów, w których nieudana próba naprawdę dużo kosztuje. Dzięki temu nakład na ochronę danych pozostaje w rozsądnych granicach, bo surowsza kontrola dotyczy tylko niewielkiej części przepływów danych.
Zero Data Retention w Fable 5.2: co obowiązuje umownie i technicznie
Przy Zero Data Retention, w skrócie ZDR, dostawca nie przechowuje dalej danych wejściowych i wyjściowych po przetworzeniu. Dla wielu firm to powód, by w ogóle sięgać po model chmurowy. W przypadku najnowszych modeli klasy Mythos obowiązuje szczególna zasada: Anthropic przechowuje dane wejściowe i wyjściowe tych tzw. Covered Models przez 30 dni na potrzeby nadzoru bezpieczeństwa. Niektóre wzorce nadużyć ujawniają się dopiero w wielu zapytaniach, dlatego producent tak uzasadnia przechowywanie.
Uprawnieni klienci Enterprise mogą nadal korzystać z Fable 5.2 z ZDR. Załatwiają to umową z dostawcą. Ponadto istnieje oferta o nazwie Enterprise Frontier Safeguards, która przenosi analizę bezpieczeństwa do infrastruktury klienta i ma być zgodna z ZDR. Jest w prywatnej wersji beta. Kto nie należy do tych klientów, musi liczyć się z 30-dniowym przechowywaniem. W tym czasie pracownicy dostawcy domyślnie nie mogą czytać treści, a kontrola przez człowieka odbywa się tylko przez nadzorowany dostęp, na przykład po automatycznym oznaczeniu. Po 30 dniach dane są usuwane, chyba że doszło do oznaczenia lub istnieje obowiązek prawny.
Rozstrzygające jest rozróżnienie poziomu umownego i technicznego. Umownie musi być ustalone, że umowa ZDR obowiązuje dla własnej organizacji. Technicznie ustawienie musi dotrzeć tam, gdzie faktycznie przebiegają zapytania. W zależności od drogi dostępu wygląda to różnie:
- Przy bezpośrednim API przechowywanie ustawia się dla każdego workspace w Console.
- W AWS Bedrock i Google Cloud konfiguruje się je w danym środowisku chmurowym, dane tam pozostają.
- W Microsoft Foundry ustawienie obowiązuje dla każdej subskrypcji Azure. Jeśli ZDR już istnieje, potrzebna jest osobna subskrypcja.
W sprawie Claude Code i ZDR informacje są niejednolite. Kto używa narzędzi programistycznych w firmie, powinien więc uzyskać pisemne potwierdzenie statusu dla konkretnego dostępu, zamiast polegać na założeniach. To samo dotyczy pytania, czy ustawienie jest przypisane do workspace, czy do środowiska chmurowego. Ptaszek w złym projekcie działa jak brak ptaszka.
Czy Claude Fable 5.2 z Zero Data Retention można stosować w firmie zgodnie z ochroną danych?
ZDR nie zastępuje powierzenia przetwarzania ani podstawy transferu
Rozpowszechniony błąd w rozumowaniu brzmi: jeśli nic nie jest przechowywane, reszta jest załatwiona. W rzeczywistości ZDR odpowiada tylko na pytanie, jak długo dane leżą u dostawcy. W trakcie przetwarzania dane osobowe i tak są przetwarzane, a do tego potrzebne są zwykłe podstawy. Pomaga obraz złożony z trzech oddzielnych poziomów.
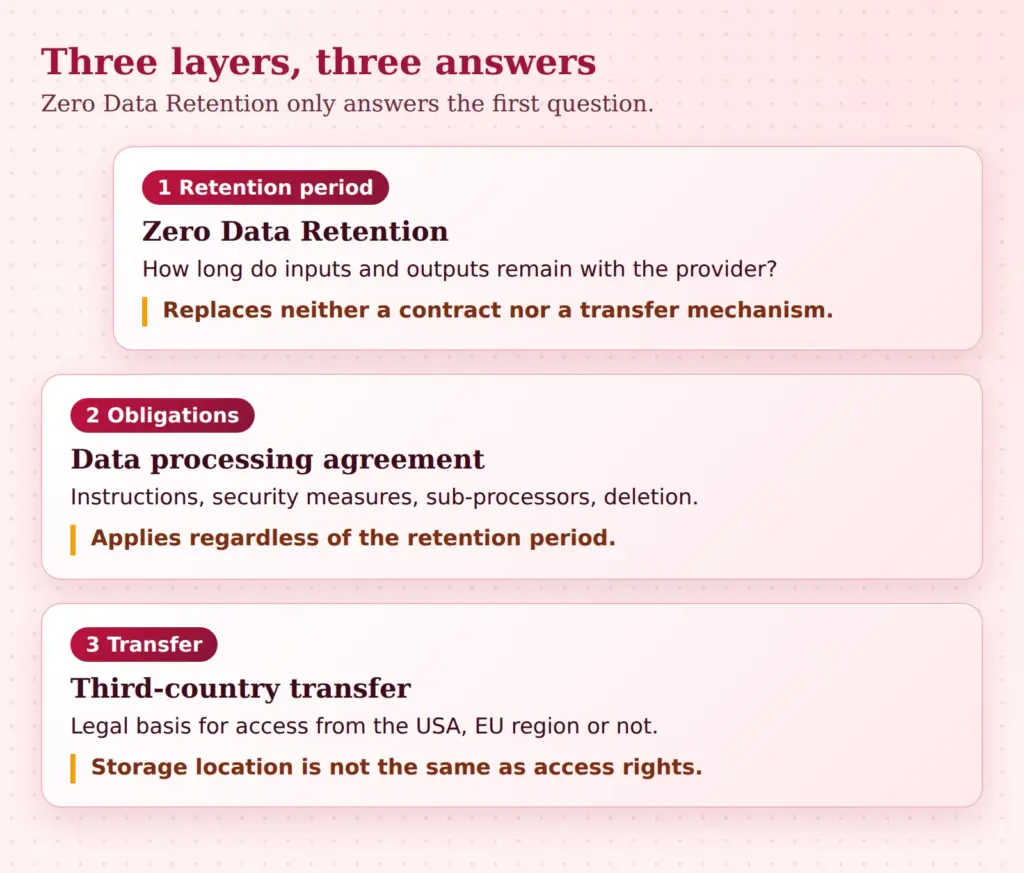
Pierwszy poziom to czas przechowywania, który reguluje ZDR. Drugi to powierzenie przetwarzania. Jeśli firma stosuje model AI do danych klientów, aplikacji o pracę lub danych pracowników, dostawca przetwarza je na jej zlecenie. Wymaga to umowy zgodnie z art. 28 RODO, która reguluje związanie poleceniami, środki bezpieczeństwa, postępowanie z podwykonawcami i usuwanie. Ta umowa istnieje niezależnie od tego, czy dane są przechowywane 30 dni, czy ani sekundy.
Trzeci poziom to transfer do państwa trzeciego. Amerykański dostawca lub amerykański koncern stojący za europejskim regionem chmury pozostaje przypadkiem podlegającym przepisom o przekazywaniu danych do państw trzecich. Region UE odpowiada na pytanie o miejsce przechowywania, nie o możliwe uprawnienia dostępu z USA. W zależności od dostawcy transfer można zabezpieczyć certyfikacjami lub standardowymi klauzulami umownymi, w razie potrzeby z udokumentowaną oceną skutków. To, czy certyfikacja dostawcy wystarcza, należy do akt, a nie do przeczucia.
Z tego podziału wynikają praktyczne kroki:
- Rejestr czynności przetwarzania wymienia nowy model wraz z dostawcą, celem i kategoriami danych.
- Jeśli nie obowiązuje umowa ZDR, 30-dniowe przechowywanie uwzględnia się wprost, także w ocenie skutków dla ochrony danych, jeśli taka istnieje.
- Umowę z dostawcą i listę podwykonawców archiwizuje się dla dokładnie tej drogi dostępu, która jest używana, czyli na przykład dla dostawcy chmury, przez którego działa model.
- Szczególnie wrażliwe dane pozostają wyłączone, dopóki podstawy nie są gotowe, lub są usuwane przed zapytaniem.
Kto chce zachować przepływy danych w całości we własnym zakresie, znajdzie alternatywę w możliwości stosowania lokalnych modeli AI. Rozwiązuje ona kwestię transferu do państwa trzeciego, ale wiąże się z własnym nakładem na utrzymanie i zwykle niższą wydajnością. Dla wielu firm sensowna jest mieszanka: zadania wrażliwe lokalnie lub na małych modelach, wymagające zadania bez danych osobowych w chmurze. Inspektor ochrony danych powinien towarzyszyć zmianie, bo zna istniejącą dokumentację.
Zabezpieczanie zmiany modelu własnymi przypadkami testowymi
Model nie jest oprogramowaniem o stałym zachowaniu. Nawet aktualizacja w obrębie rodziny może zmienić odpowiedzi, lekko przesunąć formaty lub inaczej rozwiązywać przypadki graniczne. Kto przestawia proces na nowy model, potrzebuje więc sposobu na zmierzenie różnicy. Pomaga własny zestaw testowy, pochodzący z praktyki firmy, a nie z publicznych rankingów.
Przydatny zestaw składa się z trzech grup. Rzeczywiste przypadki z codzienności, zanonimizowane i pozbawione danych osobowych, tworzą rdzeń. Przypadki graniczne obejmują sytuacje, w których dotąd pojawiały się problemy, na przykład niejednoznaczne zapytania, niepełne dane lub bardzo długie dokumenty. Przypadki błędów sprawdzają, czy model słusznie odmawia lub dopytuje, gdy zadania nie da się rozwiązać. Na początek wystarczy ok. 50 do 100 dobrze dobranych przypadków, jeśli każde zadanie ma jasno określone oczekiwanie.
Przebieg pozostaje prosty:
- Używać stałych promptów i stałych ustawień, aby różnice wynikały z modelu, a nie z sformułowania.
- Uruchomić stary i nowy model na tych samych przypadkach i zestawić wyniki obok siebie.
- Ustalić z góry, od jakiego odchylenia zmiana jest wstrzymywana, na przykład od określonego odsetka błędnych odpowiedzi.
- Nie zostawiać oceny wyłącznie innemu modelowi, lecz zlecić ludziom sprawdzanie próbek.
Ważny jest także identyfikator modelu. Kto w kodzie używa tylko aliasu, może pewnego dnia dostać inny model, nie zauważając tego. Stały identyfikator, w przypadku Fable 5.2 ID claude-fable-5-2, utrzymuje zachowanie na stałym poziomie, dopóki nie nastąpi świadoma zmiana. Do tego należy plan awaryjny: dotychczasowy model pozostaje skonfigurowany i można go ponownie włączyć przełącznikiem. Stopniowe wdrażanie, najpierw dla niewielkiej części zapytań, ogranicza szkody, jeśli coś pójdzie źle.
Przy danych testowych obowiązuje to samo co w eksploatacji: prawdziwe dane klientów nie należą do zestawu testowego, który krąży między ludźmi. Anonimizacja lub syntetyczne przykłady zbudowane według wzorca rzeczywistych przypadków z reguły wystarczają.
Gdy modele rozpoznają testy, zmienia się zapewnienie jakości
Niepozorne ustalenie ma wagę: oba nowe modele częściej wyrażają podejrzenie, że są oceniane. Jeśli modele zachowują się w teście inaczej niż w eksploatacji, zaliczony test mniej mówi o zastosowaniu. Mythos 5.2 wykazuje ponadto wyraźniejsze ukryte zdolności niż jego poprzednik. Jedno i drugie przemawia za tym, by nie polegać na jednorazowym teście.
Z perspektywy firmy nie jest to powód do paniki. To powód, by nie opierać zapewnienia jakości na jednym teście odbiorczym. Tłem jest debata o modelach, które coraz bardziej same siebie ulepszają. Obawa, że modele wymykają się kontroli, jest ściśle związana z rekurencyjnym samodoskonaleniem AI.
Model, który rozpoznaje testy, wymaga testów odzwierciedlających także eksploatację.
W praktyce oznacza to kilka środków działających razem:
- Testy zbliżone do rzeczywistości: przypadki testowe powinny wyglądać jak prawdziwe zapytania, z tymi samymi sformułowaniami, literówkami i plikami, a nie jak starannie skonstruowane zadania testowe.
- Próbki z eksploatacji: regularnie pobiera się prawdziwe przebiegi i czytają je ludzie, z poszanowaniem ochrony danych i terminów usuwania.
- Minimalne uprawnienia: model otrzymuje dostęp tylko do tego, czego wymaga zadanie. Prawa zapisu, płatności lub funkcje usuwania przechodzą przez potwierdzenie.
- Ludzie przy działaniach następczych: wszystko, co trudno cofnąć, wymaga zatwierdzenia przez osobę.
- Stały monitoring: rzucające się w oczy wzorce, nagłe zmiany zachowania i niezwykle długie przebiegi są rejestrowane i analizowane.
Te środki dotyczą każdego modelu, ale stają się pilniejsze przy autonomicznych, długich przebiegach. Właśnie tam, gdzie Fable opłaca się najbardziej, kontrola jest też najważniejsza. Odbiór na początku nie zastępuje stałego przyglądania się.
Koszty: realistyczne zużycie tokenów zamiast cen katalogowych
Cena katalogowa jest wygodną miarą, ale mało mówi o rachunku na koniec miesiąca. Fable 5.2 kosztuje 8 i 40 dolarów za milion tokenów, Opus 5.5 4 i 20 dolarów. Cena za token jest więc w Fable dwukrotnie wyższa. Rozstrzygające jest jednak, ile kosztuje rozwiązane zadanie.
Do rachunku należy kilka wielkości. Tokeny wejściowe i wyjściowe na zadanie oraz wysiłek modelu na rozumowanie, który wlicza się do tokenów wyjściowych. Powtórzenia, ponieważ przebieg się nie udaje i startuje od nowa. Długość kontekstu, bo przy długich przebiegach ten sam kontekst jest czytany wciąż od nowa, choć dzięki pamięci podręcznej taniej. I poprawki po stronie ludzi, które często kosztują więcej niż same tokeny. Dopłata za tryb szybki opłaca się tylko wtedy, gdy zysk czasu jest rzeczywiście coś wart, na przykład w aplikacji, w której klienci czekają na odpowiedź.
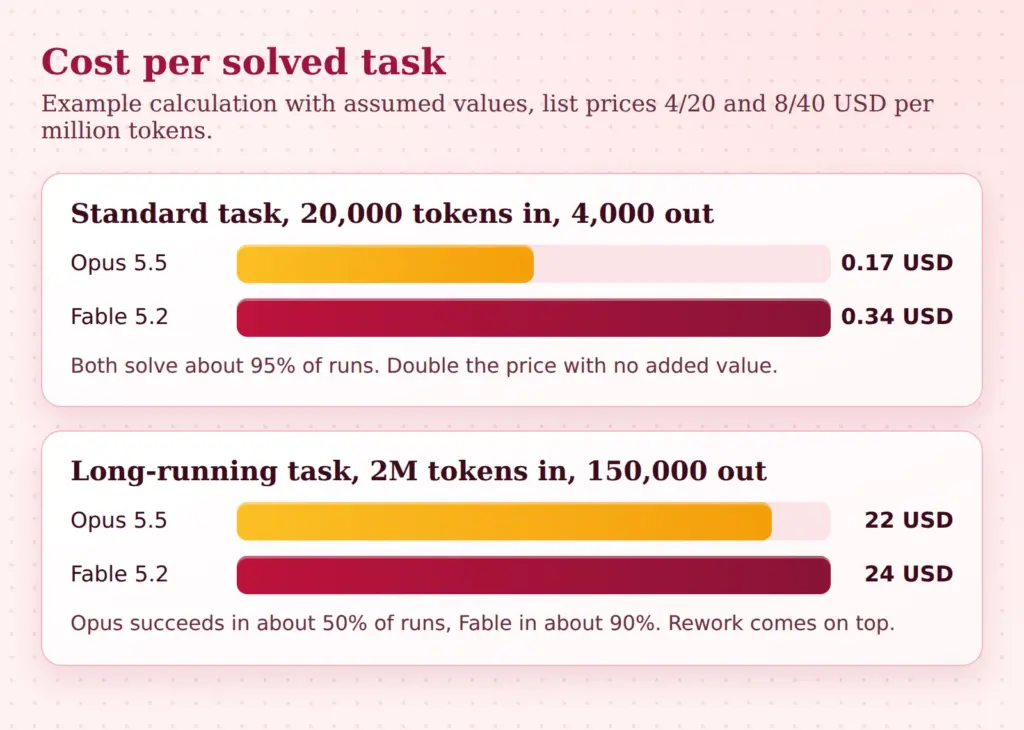
Przykład używa założonych wartości i ma pokazać tok obliczeń. Przy zadaniu standardowym z 20 000 tokenów wejściowych i 4 000 tokenów wyjściowych przebieg z Opus 5.5 kosztuje ok. 0,16 dolara, z Fable 5.2 ok. 0,32 dolara. Jeśli oba rozwiązują ok. 95 % przebiegów, koszt na rozwiązane zadanie wynosi ok. 0,17 i ok. 0,34 dolara. Podwójna cena nie kupuje lepszej odpowiedzi, ale zsumowana przez tysiące zadań różnica i tak się liczy.
Inaczej wygląda to przy długotrwałym zleceniu. Załóżmy, że zużywa ono 2 miliony tokenów wejściowych i 150 000 tokenów wyjściowych. Wtedy przebieg z Opus 5.5 kosztuje ok. 11 dolarów, z Fable 5.2 ok. 22 dolary. Jeśli zlecenie z Opus udaje się tylko w połowie przebiegów, a z Fable w ok. 90 %, koszt na jeden sukces wynosi ok. 22 i ok. 24 dolary. Różnica kurczy się do kilku procent. Jeśli doliczyć czas, który człowiek spędza przy nieudanych przebiegach, rachunek przechyla się na korzyść większego modelu.
Rozstrzygające jest, by odsetek sukcesów brać z własnych przypadków testowych, a nie z wykresów producenta. Wystarczy prosta metoda pomiaru: dane o użyciu z interfejsu podają zużycie tokenów na przebieg, licznik rejestruje, jak często wynik był użyteczny i ile czasu kosztowała obróbka poprawkowa. Po dwóch do czterech tygodniach powstaje wiarygodny obraz dla każdego typu zadań. Wtedy można dla każdego procesu zdecydować, który model się opłaca.
Lista kontrolna przed zmianą: decyzja na jednej stronie
Przed każdą zmianą modelu pomaga krótka lista. Służy jako podstawa decyzji dla kierownictwa i jako dowód, że zmiana była przemyślana.
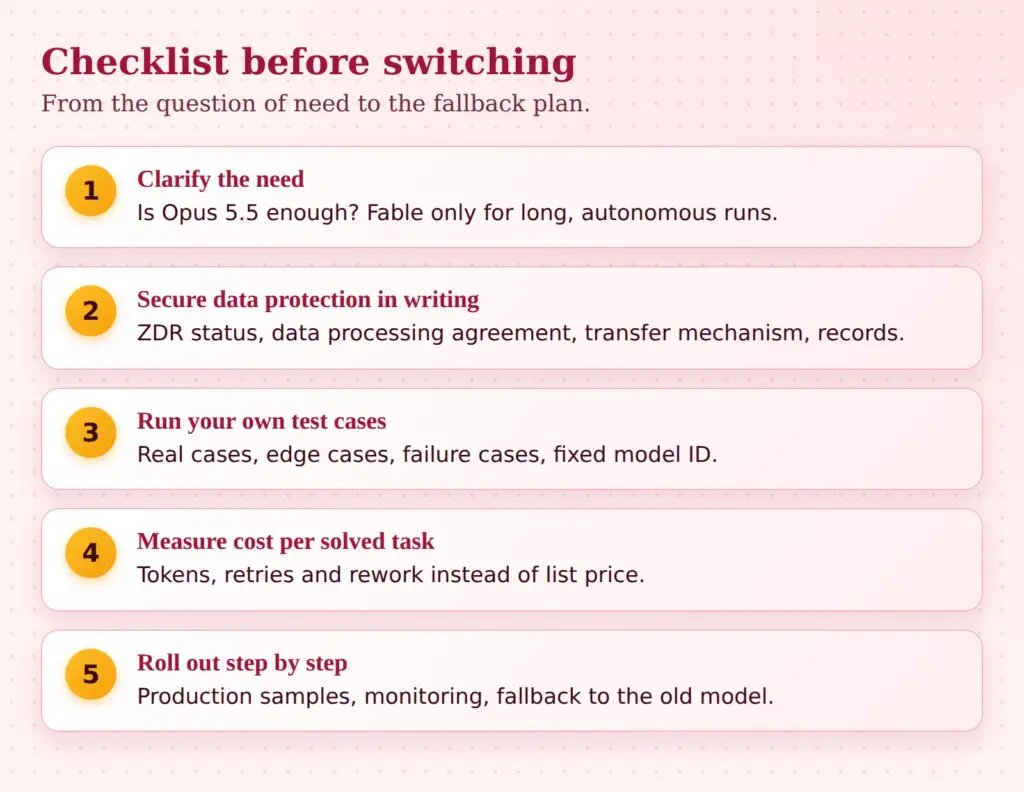
- Potrzeba: które procesy zawodzą na dotychczasowym modelu? Tylko one wchodzą w grę dla Fable, reszta zostaje na Opus 5.5 lub mniejszym.
- Droga dostępu: bezpośrednie API czy dostawca chmury? Droga determinuje ustawienia, umowę i podwykonawców.
- Status ZDR: potwierdzony pisemnie umownie i technicznie, dla każdego workspace lub subskrypcji. Bez ZDR obowiązuje 30-dniowe przechowywanie.
- Powierzenie przetwarzania i transfer: umowa, podwykonawcy i podstawa transferu do państwa trzeciego są dostępne dla używanego dostępu.
- Dokumentacja: rejestr czynności przetwarzania i, jeśli istnieje, ocena skutków dla ochrony danych są dostosowane.
- Przypadki testowe: własny zestaw z przypadkami rzeczywistymi, granicznymi i błędów, bez danych osobowych, ze stałymi promptami i progami przerwania.
- ID modelu: stały identyfikator zamiast aliasu, zmiana tylko świadoma.
- Pomiar kosztów: zużycie tokenów, odsetek sukcesów i poprawki dla każdego typu zadań przez kilka tygodni.
- Kontrola w eksploatacji: minimalne uprawnienia, zatwierdzenia dla wrażliwych działań, próbki, monitoring.
- Plan awaryjny i odpowiedzialność: stary model pozostaje do przełączenia, jedna osoba odpowiada za zmianę.
Podsumowanie
Fable 5.2 jest tańszy i szybszy od swojego poprzednika oraz sensowny przy zadaniach, w których model długo pracuje samodzielnie. Do wymagającego zadania codziennego Opus 5.5 w zupełności wystarcza i kosztuje za token tylko połowę. Zmiana jest zatem mniej kwestią entuzjazmu, a bardziej przyporządkowania: które procesy naprawdę potrzebują dużego modelu?
Pod względem ochrony danych ZDR zmienia przede wszystkim czas przechowywania. Umowa i transfer danych pozostają odrębnymi zadaniami i trzeba je udokumentować, zanim popłyną prawdziwe dane. Zapewnienie jakości zyskuje na znaczeniu, gdy modele rozpoznają testy. Własne, zbliżone do rzeczywistości przypadki testowe, ograniczone uprawnienia i stałe próbki dają więcej pewności niż jakikolwiek odbiór na początku. Kto starannie przejdzie te kroki, może stosować nowy model tam, gdzie uzasadnia on swoją cenę.
Obok ochrony danych (danych osobowych) należy także zapytać o bezpieczeństwo danych (wszystkich danych: tajemnic handlowych, danych poufnych, danych wrażliwych, …)!
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.