gekennzeichnet.


Früher kamen KI-Antworten in Sekunden. Heute arbeiten Assistenten oft minutenlang, prüfen ihr Ergebnis selbst und liefern dadurch häufig Besseres. Der Beitrag zeigt, wofür sich die KI Denkzeit lohnt, was Aufwandstufen bedeuten und wann Geduld nichts bringt.
Antworten dauern länger und werden oft besser
Eine persönliche Beobachtung steht am Anfang: Seit einigen Wochen brauchen KI-Antworten im Arbeitsalltag spürbar länger als früher, und die Ergebnisse fallen oft besser aus. Gemessene Zahlen dazu liegen nicht vor, es bleibt ein subjektiver Eindruck, den Gespräche mit Kollegen bestätigen. Auffällig ist, dass das Warten kaum noch als Störung empfunden wird, solange die Antwort stimmt.
Hinter diesem Eindruck steckt ein Mechanismus: Die Systeme prüfen und korrigieren ihre Arbeit, bevor sie antworten. Das hilft bei manchen Aufgaben sehr, bei anderen kaum, und es verbraucht Nutzungskontingent.
Wenn Warten zum Qualitätsmerkmal wird
Lange galt bei digitalen Diensten eine einfache Regel: schneller ist besser. Eine Suchmaschine, die erst nach einer Minute antwortet, wäre unbrauchbar. Bei KI-Assistenten gilt diese Regel nur noch eingeschränkt. Eine schnelle Antwort ist bei einer Rückfrage oder einer Umformulierung willkommen. Bei einem Skript, einer Auswertung oder einer Recherche zählt dagegen, ob das Ergebnis stimmt. Dafür wird zunehmend Zeit in Kauf genommen.
Zwei Alltagsbilder helfen bei der Einordnung. Ein Zuruf am Flur ist schnell, ein Gutachten braucht Zeit, und gerade deshalb wird ihm mehr vertraut. Ebenso ist ein Handwerker, der nach der Arbeit einen Probelauf macht, nicht langsamer, sondern gründlicher als einer, der nach zehn Minuten wieder wegfährt. Bei KI-Systemen ist es ähnlich: Wenn erkennbar ist, dass vor der Ausgabe geprüft wurde, steigt das Vertrauen in das Ergebnis, und die Wartezeit wird zum Teil der Leistung.
Die Anbieter reagieren darauf mit Reglern. Bei Claude gibt es Aufwandstufen, die sich je nach Modell und Oberfläche einstellen lassen. Der Nutzer entscheidet also selbst, ob eine Anfrage schnell oder gründlich bearbeitet werden soll. Welche Modelle und Schalter gerade aktuell sind, ändert sich dabei laufend. Der ständige Modell-Wettlauf zwischen GPT, Gemini, Claude und anderen sorgt dafür, dass einzelne Namen schnell veralten. Das Prinzip bleibt davon unberührt.
Wer die Aufwandstufe selbst wählt, weiß, warum er wartet.
Warten wird akzeptiert, wenn es einen erkennbaren Grund hat, wenn es steuerbar ist und wenn am Ende ein Ergebnis steht, das sich prüfen lässt.
KI Denkzeit: Was in der Wartezeit passiert
Ein klassisches Sprachmodell erzeugt Wort für Wort eine Antwort, ohne vorher zu überlegen. Sogenannte Reasoning-Modelle gehen anders vor. Diese Modelle erzeugen zunächst Zwischenschritte, die für den Nutzer oft gar nicht oder nur zusammengefasst sichtbar sind, und formulieren erst danach die eigentliche Antwort. Fachleute sprechen davon, dass zur Antwortzeit mehr Rechenaufwand eingesetzt wird (Test-Time Compute). Die KI Denkzeit ist also keine Verzögerung ohne Inhalt, sondern zusätzliche Arbeit vor der Ausgabe.
Die Forschung stützt diese Idee in Grenzen. Eine Arbeit von Snell und Kollegen aus dem Jahr 2024 kommt zu dem Ergebnis, dass zusätzliche Rechenzeit bei der Antwort unter Umständen mehr bringen kann als ein größeres Modell. Entscheidend ist dabei die Schwierigkeit der Aufgabe: Der Effekt hängt davon ab, wie anspruchsvoll die Frage ist. Ein allgemeines Gesetz lässt sich daraus nicht ableiten.
Prüfen vor der Ausgabe
Der eigentliche Kern der Verschiebung ist das Prüfen vor der Ausgabe. Das System erstellt einen Entwurf, führt ihn in einer Testumgebung aus oder vergleicht ihn mit den Anforderungen, korrigiert die gefundenen Fehler und testet erneut. Das wiederholt sich, bis die Prüfung besteht. Erst dann erscheint die Antwort. Die Dokumentation zu Claude Code nennt eine prüfbare Rückmeldung in den Best Practices als wichtigsten Hebel für gute Ergebnisse. Wer dem System ein Kriterium mitgibt, an dem es sich selbst messen kann, erhält verlässlichere Arbeit.
Was als Prüfung gelten kann, hängt von der Aufgabe ab:
- Bei Programmen läuft ein Testlauf in einer abgeschotteten Umgebung. Schlägt er fehl, wird der Fehler gelesen und der Code angepasst.
- Bei Illustrationen und 3D-Dateien wird das Ergebnis gerendert und angesehen. Fehlt ein Teil oder liegt Text über einer Grafik, folgt eine Korrektur.
- Bei Mathematik wird der Rechenweg gegengerechnet oder das Ergebnis eingesetzt.
- Bei Recherchen werden Aussagen mit den gefundenen Quellen abgeglichen.
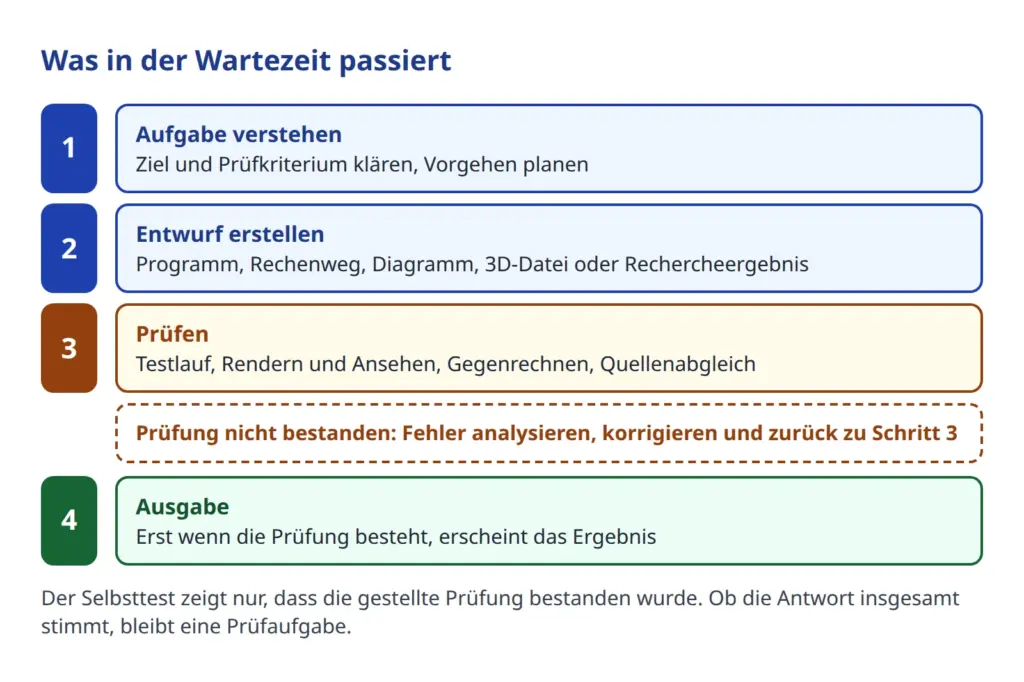
Ein Selbsttest ist kein Wahrheitsbeweis. Ein Test findet nur das, wofür er gebaut wurde. Ein Programm kann alle Tests bestehen und trotzdem die falsche Aufgabe lösen. Wer sich für das Thema selbstständig arbeitender Systeme interessiert, findet im Beitrag zum Zeitalter der KI-Agenten eine Einordnung. Das Prüfen im Kreis spielt auch dort eine Rolle, und es hängt eng mit der Frage zusammen, wie weit sich Systeme durch eigene Rückmeldung verbessern lassen.
Wo sich das Warten am meisten lohnt
Am stärksten zahlt sich eine längere KI-Bearbeitungszeit bei Aufgaben aus, deren Ergebnis sich prüfen lässt. Die Faustregel lautet: Gibt es ein Kriterium, das sich testen lässt, hilft Zeit. Gibt es keines, hilft sie wenig.
Typische Beispiele aus dem Arbeitsalltag, bewusst allgemein gehalten:
- Programme und Skripte. Ein Skript zur Bereinigung einer Datentabelle läuft zunächst auf Beispieldaten. Findet sich dabei ein Fehler bei Datumsformaten, wird er behoben, bevor das Skript ausgeliefert wird. Wie weit das tragen kann, zeigt der Beitrag zu Agentic Coding.
- Tabellenkalkulation. Formeln lassen sich an Stichproben gegenrechnen. Eine Summe, die nicht zum Einzelwert passt, fällt dann vor der Ausgabe auf.
- Illustrationen und Diagramme. Ein Diagramm, das beim ersten Rendern abgeschnittene Beschriftungen zeigt, wird im zweiten Durchlauf korrigiert. Ohne Blick auf das Ergebnis bliebe der Fehler stehen.
- 3D-Dateien. Ein Modell mit fehlerhaften Flächen oder falschen Maßen lässt sich anzeigen und vermessen, bevor es weitergegeben wird.
- Mathematik und Schlussfolgerungen. Mehrere Bedingungen müssen zugleich erfüllt sein. Das System kann Zwischenergebnisse gegen jede Bedingung prüfen.
- Recherchen. Ein längerer Lauf kann mehrere Quellen lesen, Widersprüche erkennen und Aussagen belegen, statt eine einzelne Fundstelle zu übernehmen.
Das Gegenstück sind Aufgaben ohne prüfbares Kriterium: ein Slogan, eine Idee, ein Tonfall. Hier gibt es nichts, was sich testen ließe. Mehr Denkzeit führt dann nicht automatisch zu einem besseren Ergebnis, sondern manchmal nur zu einem längeren.
Auch nach langem Warten bleibt das Überprüfen von KI-Antworten eine Aufgabe des Menschen. Das gilt besonders bei Zahlen, Quellenangaben und Rechtsthemen. Stichproben genügen oft: Zwei oder drei Angaben nachschlagen, eine Rechnung nachvollziehen, einen Link öffnen. Stimmen die Stichproben, steigt das Vertrauen. Stimmen sie nicht, ist die Stufe oder die Aufgabenstellung zu überdenken.
Aufwandstufen von low bis max: Kontrolle statt Ungewissheit
Die Aufwandstufen sind der wichtigste Regler. Laut der Dokumentation von Anthropic heißen die Stufen low, medium, high, xhigh und max. Die Stufen legen fest, wie viel Aufwand das Modell in eine Antwort steckt. Dazu zählen auch das Nachdenken und die Zahl der Werkzeugaufrufe. Eine niedrige Stufe bedeutet knappere Arbeit, eine hohe Stufe gründlichere.
Die Stufen sind kein fester Zeitplan. Die Dokumentation beschreibt den Aufwand als Verhaltenssignal und nicht als striktes Budget an Rechenschritten. Auch bei niedriger Stufe denkt das Modell bei schwierigen Aufgaben noch nach, nur weniger als bei einer höheren. Die Standardstufe ist je nach Modell verschieden: Bei den meisten dokumentierten Modellen ist es high, bei einzelnen medium. Welche Stufen zur Wahl stehen, hängt zudem von Modell und Oberfläche ab, also davon, ob Programmierschnittstelle, App oder Claude Code genutzt wird. Nicht überall stehen alle fünf zur Verfügung.
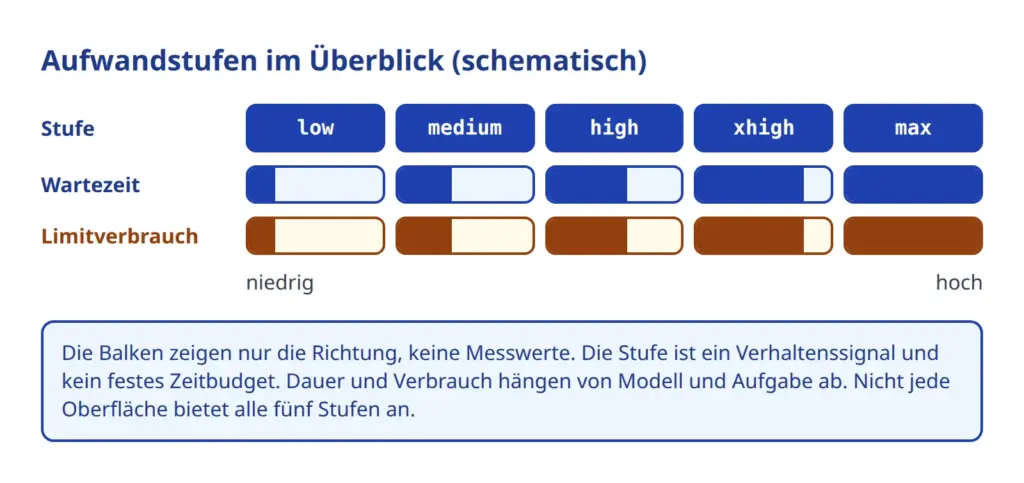
Auch andere Anbieter kennen solche Regler. OpenAI beschreibt in der Dokumentation zum Reasoning je nach Modell unterschiedliche Werte, darunter none, minimal, low, medium, high, xhigh und max. Der Zielkonflikt ist derselbe: mehr Gründlichkeit gegen mehr Zeit und mehr Kosten.
Für das Erleben der Wartezeit ist ein Punkt entscheidend. Wer die Stufe selbst gesetzt hat, kennt den Grund für die Dauer. Die lange Antwort ist dann kein unerklärliches Hängen, sondern das Ergebnis einer eigenen Entscheidung. Das ist eine Einordnung und keine gemessene Wirkung, sie passt aber zu dem, was über die Wahrnehmung von Wartezeit bekannt ist.
Warum Menschen gerne länger warten, wenn sie wissen, wofür
Die Nielsen Norman Group beschreibt seit Langem, wie Menschen Wartezeiten bei Software wahrnehmen. Bis etwa zehn Sekunden bleibt die Aufmerksamkeit beim Dialog. Dauert ein Vorgang länger, braucht es sichtbare Rückmeldung, etwa eine Fortschrittsanzeige. Diese zeigt, dass das System nicht abgestürzt ist, gibt einen Anhaltspunkt für die Dauer und macht das Warten weniger frustrierend. Nachzulesen ist das im Artikel Response Times: The 3 Important Limits.
Moderne KI-Assistenten erfüllen diese Rolle teilweise von selbst. Assistenten melden einen Plan, zeigen Prüfschritte und liefern Teilergebnisse. Wer sieht, dass gerade ein Test läuft oder eine Quelle gelesen wird, kann das Warten einordnen. Hinzu kommt das Gefühl von Kontrolle: Die Wahl von Modell und Stufe, sichtbare Arbeitsschritte und die Möglichkeit abzubrechen machen aus passivem Ausharren eine bewusste Entscheidung.
Seit Opus 5.5 lohnt die Nutzung von Fable quasi nicht mehr.
Erkenntnis des Autors aus eigenen Versuchen.
Das ist eine Deutung und kein Nachweis. Eine belastbare Verhaltensstudie dazu, dass Nutzer KI-Wartezeit nachweislich akzeptieren, wurde bei der Recherche nicht gefunden. Die These bleibt deshalb eine Deutung: Wartezeit lässt sich leichter ertragen, wenn sie einen Grund hat und sich beeinflussen lässt.
Wann längeres Denken nicht hilft
So verlockend die Gleichung aus mehr Zeit und besseren Antworten klingt, sie geht nicht immer auf. Die Studie Inverse Scaling in Test-Time Compute hat gezeigt, dass bei bestimmten Aufgaben die Genauigkeit sinkt, wenn das Modell länger nachdenkt. Untersucht wurden konstruierte Aufgaben, etwa Zählen mit ablenkenden Informationen, Vorhersagen mit irreführenden Merkmalen und Schlussfolgerungen mit mehreren Bedingungen. Einzelne Modelle ließen sich bei langem Nachdenken eher von irrelevanten Details ablenken.
Diese Befunde sind mit Vorsicht zu lesen. Es handelt sich um gezielt gebaute Testaufgaben und um bestimmte Modelle zu einem bestimmten Zeitpunkt. Daraus folgt nicht, dass Denkzeit im Alltag schadet. Es folgt nur, dass mehr nicht automatisch besser bedeutet.
Lohnt es sich, auf eine KI-Antwort länger zu warten?
Auch die Herstellerdokumentation rät zur Zurückhaltung. Für Claude Sonnet 5.5 und Claude Haiku 5.5 heißt es, xhigh und max seien nur dort sinnvoll, wo eigene Tests einen Qualitätsgewinn zeigen. Für das ältere Modell Claude Opus 4.7 warnt sie deutlicher: Die Stufe max bringe bei den meisten Aufgaben hohe Mehrkosten für einen kleinen Gewinn und könne zu Überdenken führen. Welche Empfehlung gilt, hängt vom Modell ab und ändert sich mit neuen Versionen.
Daraus ergeben sich einfache Faustregeln:
- Einfache Fragen und Umformulierungen erhalten eine niedrige Stufe.
- Schwierige, aber prüfbare Aufgaben erhalten eine höhere Stufe.
- Die oberste Stufe ist keine Standardeinstellung, sondern eine begründete Ausnahme.
- Reicht ein Ergebnis nicht aus, hilft meist eine höhere Stufe oder ein klareres Prüfkriterium, nicht ein immer länger werdender Auftrag.
Nutzungslimit und Modellwahl: Was die Denkzeit kostet
Mehr Denkzeit ist keine Garantie, sondern eine Wahl mit Preis.
Der Preis zeigt sich im KI Nutzungslimit. Laut der Hilfeseite von Anthropic verbrauchen lange und komplexe Unterhaltungen, bestimmte Funktionen, das gewählte Modell und höhere Aufwandstufen das Kontingent schneller. Bei bezahlten Plänen gibt es ein Sitzungslimit, das sich alle fünf Stunden zurücksetzt, und ein Wochenlimit. Wer häufig lange Läufe mit hoher Stufe startet, spürt das schneller als jemand, der überwiegend kurze Fragen stellt.
Die Hilfeseite nennt dazu praktische Tipps:
- Für Routineaufgaben eine niedrigere Aufwandstufe wählen.
- Erweitertes Denken ausschalten, wenn es nicht gebraucht wird.
- Bei langen Verläufen eine neue Unterhaltung beginnen, weil lange Chats mehr vom Limit verbrauchen.
- Nicht benötigte Verbindungen und Apps trennen, da Werkzeuge viel Verbrauch verursachen.
Bei der Nutzung über eine Programmierschnittstelle wird der Preis als Geld sichtbar. Laut OpenAI sind Reasoning-Tokens, also die Textbausteine des unsichtbaren Nachdenkens, zwar nicht einsehbar, werden aber wie Ausgabe-Tokens abgerechnet. Eine höhere Stufe kostet also auch dann mehr, wenn vom Nachdenken nichts zu sehen ist.
Für die Tarifwahl folgt daraus ein nüchterner Gedanke. Ein teurer Tarif kauft mehr Spielraum für Denkzeit, aber nicht zwangsläufig bessere Antworten. Entscheidend ist das Aufgabenprofil: Wer viele prüfbare, anspruchsvolle Aufgaben bearbeitet, profitiert von einem größeren Kontingent und hohen Stufen. Wer überwiegend Texte glättet und kurze Fragen stellt, zahlt für Reserven, die kaum gebraucht werden. Die Alternative zum teuren Tarif ist die bewusste Modellwahl je Anfrage: ein kleineres, schnelleres Modell für Routine, ein größeres mit hoher Stufe für die schwere Aufgabe.
Konkrete Kontingente und Preise ändern sich häufig und werden hier deshalb nicht als Zahl festgehalten. Maßgeblich sind jeweils die aktuellen Seiten der Hersteller.
Praxis: Modell und Aufwandstufe je Aufgabe wählen
Die folgende Übersicht dient als Einstieg. Die Tabelle ist eine Faustregel und keine Garantie, die Stufen sind je nach Modell und Oberfläche verschieden.
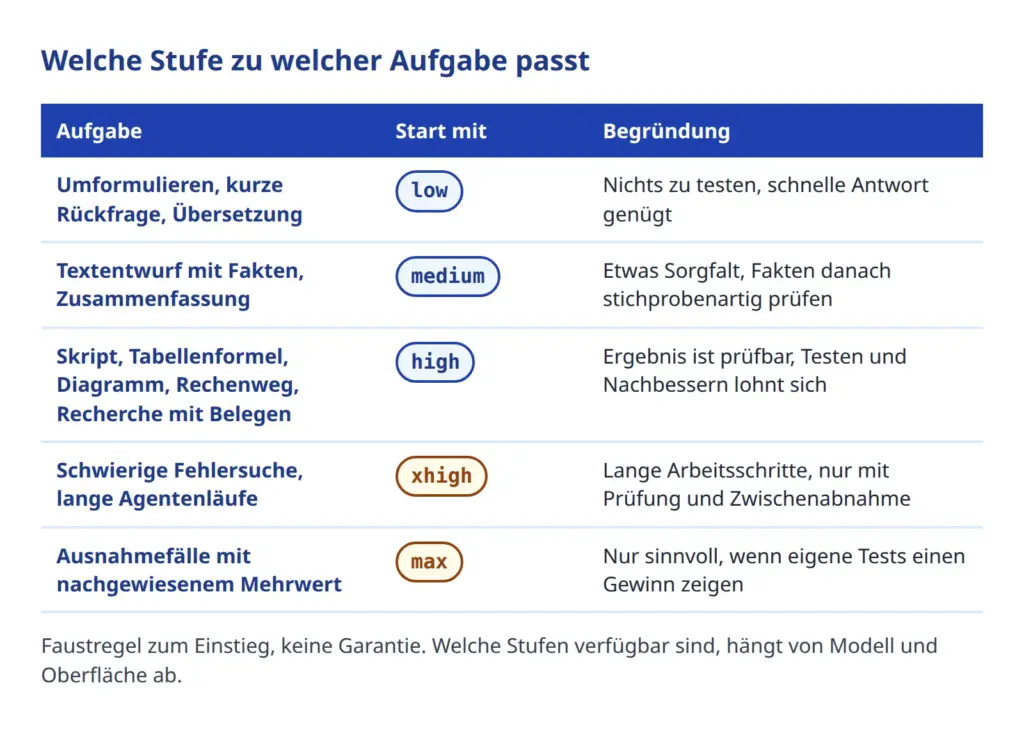
Ein paar Gewohnheiten machen die Wartezeit produktiver:
- Prüfkriterium nennen. Sätze wie „Der Test muss bestehen“ oder „Das Diagramm muss lesbar sein“ geben dem System etwas, woran es sich messen kann.
- Teilergebnisse abnehmen. Bei langen Läufen lohnt eine Zwischenkontrolle, bevor das System in die falsche Richtung weiterarbeitet.
- Stufe erhöhen statt Auftrag verbiegen. Die Dokumentation zum älteren Modell Claude Opus 4.7 rät bei flachem Nachdenken auf schweren Aufgaben, die Stufe anzuheben, statt den Auftrag zu umgehen. Bei neueren Modellen empfiehlt sie, Stufen an eigenen Aufgaben auszuprobieren.
- Stichproben ziehen. Zahlen, Quellen und rechtliche Aussagen werden auch nach langem Warten stichprobenartig geprüft.
Ein Seitenblick auf den Datenschutz
Je länger und selbstständiger ein Assistent arbeitet, desto mehr passiert im Hintergrund. Testumgebung, Websuche und angebundene Werkzeuge verarbeiten möglicherweise mehr Daten und Zwischenergebnisse als eine einzelne Antwort. Vor dem Einsatz mit personenbezogenen Daten ist deshalb zu klären, welche Dienste und Funktionen aktiv sind und ob ein Vertrag zur Auftragsverarbeitung nach Art. 28 DSGVO besteht. Das ist ein Hinweis zur Orientierung und keine Rechtsberatung.
Der Gedanke vom Prüfen vor dem Ausliefern gilt übrigens nicht nur für KI. Auch bei Webseiten lohnt der Blick auf das Ergebnis, bevor es online geht, etwa mit dem DSGVO Website Check. Wo Testumgebungen und Web-Auftritte technisch abgesichert werden sollen, bieten die Web Security Checks eine Möglichkeit zur Überprüfung.
Fazit: Die Verschiebung ist eine Frage der Wahl
Die KI Denkzeit verändert die Erwartung an Assistenten. Warten wird akzeptiert, wenn es erklärt, steuerbar und prüfbar ist. Die Wahl der Aufwandstufe ersetzt den Wunsch nach „immer sofort“ durch die Frage, wie viel Gründlichkeit eine Aufgabe verdient. Das Nutzungslimit macht diese Wahl zu einem Budgetthema, bei dem Tarif und Modell zum Aufgabenprofil passen sollten. Und weil auch lange Läufe Fehler enthalten können, muss der Mensch das Ergebnis am Ende selbst gegenprüfen.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die