 gekennzeichnet.
Wenn Sie eine Frage in einen KI-Chatbot eingeben, wirkt der Moment beinahe intim: Sie formulieren einen Gedanken, drücken Enter, und wenige Sekunden später erscheint eine passende Antwort. Diese scheinbare Unmittelbarkeit verschleiert, wie viel im Hintergrund geschieht. Zwischen Ihrer Eingabe und der fertigen Antwort liegt eine komplexe Kette aus Systemen, die Ihre Daten prüfen, verarbeiten und weiterleiten – lange bevor überhaupt ein Sprachmodell „antwortet". Für einen bewussten Umgang mit KI-Assistenten lohnt es sich, diese unsichtbare Infrastruktur zu verstehen: sie bestimmt maßgeblich, wie viel ein Anbieter tatsächlich über Sie weiß.
Was Ihr KI-Assistent über Sie sammelt
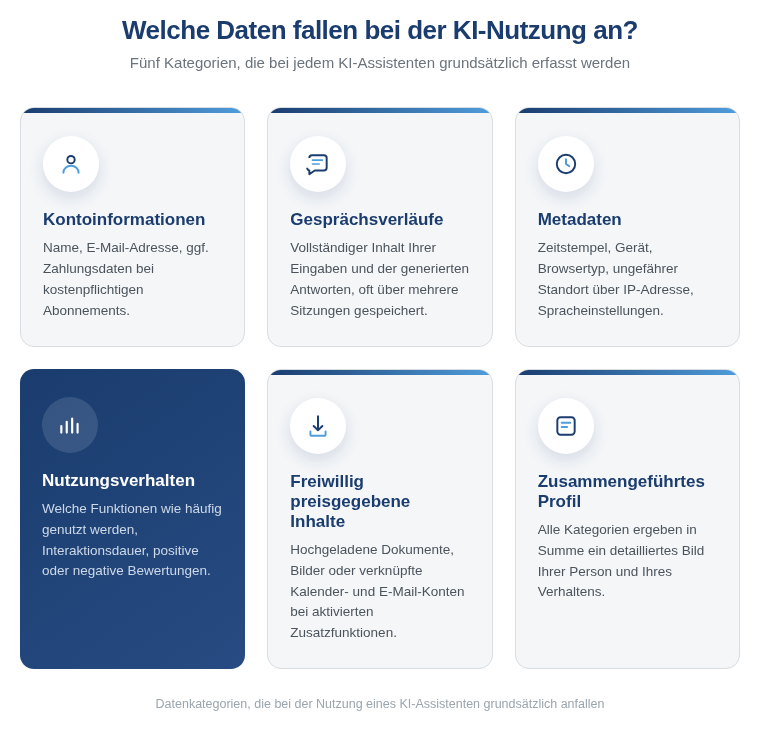
Bevor wir uns der technischen Verarbeitung widmen, lohnt sich ein Blick auf die Datenkategorien, die bei der Nutzung eines KI-Assistenten grundsätzlich anfallen:
- Kontoinformationen: Name, E-Mail-Adresse, gegebenenfalls Zahlungsdaten bei kostenpflichtigen Abonnements.
- Gesprächsverläufe: der vollständige Inhalt Ihrer Eingaben und der generierten Antworten, häufig über mehrere Sitzungen hinweg gespeichert.
- Metadaten: Zeitstempel, verwendetes Gerät, Browsertyp, ungefährer Standort über die IP-Adresse, Spracheinstellungen.
- Nutzungsverhalten: welche Funktionen Sie wie häufig nutzen, wie lange Sie interagieren, welche Antworten Sie positiv oder negativ bewerten.
- Freiwillig preisgegebene Inhalte: hochgeladene Dokumente, Bilder oder verknüpfte Kalender- und E-Mail-Konten, sofern Sie entsprechende Funktionen aktivieren.
Diese Liste allein wäre schon Grund genug für Zurückhaltung. Das eigentlich Bemerkenswerte spielt sich jedoch nicht in einem einzelnen System ab, sondern in einer ganzen Kette von Diensten, die bei jeder einzelnen Anfrage durchlaufen wird.
Die unsichtbare Tool-Chain: Was bei jedem Prompt tatsächlich passiert
Viele Menschen stellen sich ein KI-Sprachmodell als eine einzelne, in sich geschlossene „Blackbox" vor: Eingabe rein, Antwort raus. In Wirklichkeit durchläuft praktisch jede Anfrage bei kommerziellen KI-Anbietern eine mehrstufige Verarbeitungskette, an der zahlreiche unterschiedliche Systeme beteiligt sind – von denen die wenigsten Nutzer je etwas mitbekommen. Diese Grundarchitektur ist weitgehend unabhängig davon, welcher konkrete Anbieter oder welches Modell im Hintergrund arbeitet, und bleibt auch dann bestehen, wenn sich einzelne Produkte oder Modellversionen ändern.
1. Vorverarbeitung und Tokenisierung
Noch bevor ein Sprachmodell Ihre Anfrage „liest", wird der Text in kleinere Einheiten (sogenannte Tokens) zerlegt. Diese Vorverarbeitung entscheidet mit, wie Ihre Formulierungen technisch interpretiert werden, und läuft in aller Regel über eigene Systeme, getrennt vom eigentlichen Modell. Bereits an dieser Stelle wird technisch protokolliert, was Sie eingegeben haben.
2. Sicherheits- und Moderationsfilter
Praktisch jeder ernstzunehmende KI-Anbieter schaltet vor und nach dem eigentlichen Modellaufruf automatisierte Klassifikatoren, die Eingaben und Ausgaben auf problematische Inhalte prüfen. So können oft Gewaltdarstellungen, sexualisierte Inhalte oder Anleitungen zu gefährlichen Handlungen erkannt werden. Diese Klassifikatoren sind eigenständige Systeme, die Ihren Prompt zusätzlich zum eigentlichen Sprachmodell analysieren. Das bedeutet: Ihr Text wird nicht nur einmal, sondern gleich mehrfach von unterschiedlichen Modellen „gelesen", bevor überhaupt eine Antwort entsteht.
3. Kontext- und Gedächtnissysteme
Viele moderne Assistenten verfügen über Funktionen, die sich frühere Gespräche oder hinterlegte Vorlieben „merken", um Antworten zu personalisieren. Dafür werden Inhalte aus vergangenen Sitzungen in separaten Datenbanken abgelegt und bei jeder neuen Anfrage automatisch wieder abgerufen und in den Kontext eingespeist.
Diese Gedächtnisfunktion ist praktisch, bedeutet aber auch, dass Informationen aus einem Gespräch vor Wochen unbemerkt in ein aktuelles Gespräch einfließen können.
4. Werkzeug- und Funktionsaufrufe
Sobald ein Assistent auf externe Werkzeuge zugreift (etwa eine Websuche durchführt, einen Taschenrechner nutzt, eine Verbindung zu einem Kalender herstellt oder eine Anfrage an einen Drittanbieter-Dienst weiterleitet), verlässt ein Teil Ihrer Anfrage die Infrastruktur des eigentlichen KI-Anbieters. Eine Suchanfrage, die im Zuge Ihres Prompts automatisch generiert wird, landet bei einer Suchmaschine; eine Kalenderabfrage bei einem weiteren Dienst. Jede dieser Stationen kann eigene Protokolle führen, die Sie als Nutzerin oder Nutzer in der Regel nicht direkt einsehen können.
5. Modellinferenz auf verteilter Infrastruktur
Die eigentliche Berechnung der Antwort erfolgt selten auf einem einzelnen Server, sondern verteilt über große Rechenzentren, häufig betrieben von spezialisierten Cloud-Anbietern. Selbst wenn ein KI-Unternehmen sein Modell selbst entwickelt, läuft die Infrastruktur oft bei einem externen Cloud-Anbieter – ein weiterer Subunternehmer, der technisch Zugriff auf die verarbeiteten Daten hat, auch wenn er vertraglich zur Vertraulichkeit verpflichtet ist.
6. Nachbearbeitung und Ausgabefilter
Auch nach der eigentlichen Texterzeugung ist der Prozess nicht beendet. Die generierte Antwort durchläuft häufig weitere Filterstufen, etwa zur Formatierung, zur nochmaligen Sicherheitsprüfung oder zur Zitationsprüfung bei Suchergebnissen. Erst danach erreicht der Text Ihren Bildschirm.
7. Protokollierung, Analyse und Qualitätssicherung
Parallel zur eigentlichen Antwortgenerierung speisen viele Systeme Nutzungsdaten in Analyse-Pipelines ein: Wie lange hat die Anfrage gedauert, wie hat das System reagiert, gab es Fehler oder ungewöhnliche Muster. Diese Protokolle dienen primär der technischen Qualitätssicherung, enthalten aber häufig auch Metadaten zu Ihrer Anfrage und mitunter Ausschnitte des Gesprächsinhalts.
Der entscheidende Punkt dieser Beschreibung ist nicht, dass jede einzelne Station böswillig agiert – die meisten dieser Systeme existieren aus legitimen technischen oder Sicherheitsgründen. Relevant ist vielmehr die schiere Anzahl der Stationen: Jede zusätzliche Verarbeitungsstufe ist ein weiterer Punkt, an dem Daten gespeichert, protokolliert, mit anderen Diensten geteilt oder im Fehlerfall versehentlich offengelegt werden können. Eine einzelne Anfrage an einen KI-Assistenten kann so, ohne dass Sie es bemerken, mehrere Unternehmen und Dutzende Server durchlaufen.
Cloud-Verarbeitung versus lokale Verarbeitung
Ein weiterer, oft übersehener Aspekt betrifft den Ort der Verarbeitung. Die weit überwiegende Mehrheit kommerzieller KI-Assistenten verarbeitet Ihre Anfragen in der Cloud, also auf Servern des Anbieters oder eines Subunternehmers – unabhängig davon, ob Sie die Anwendung über den Browser, eine App oder eine in Software integrierte Funktion nutzen. Nur wenige, meist kleinere oder spezialisierte Modelle laufen vollständig lokal auf Ihrem eigenen Gerät, ohne dass Daten das Gerät verlassen.
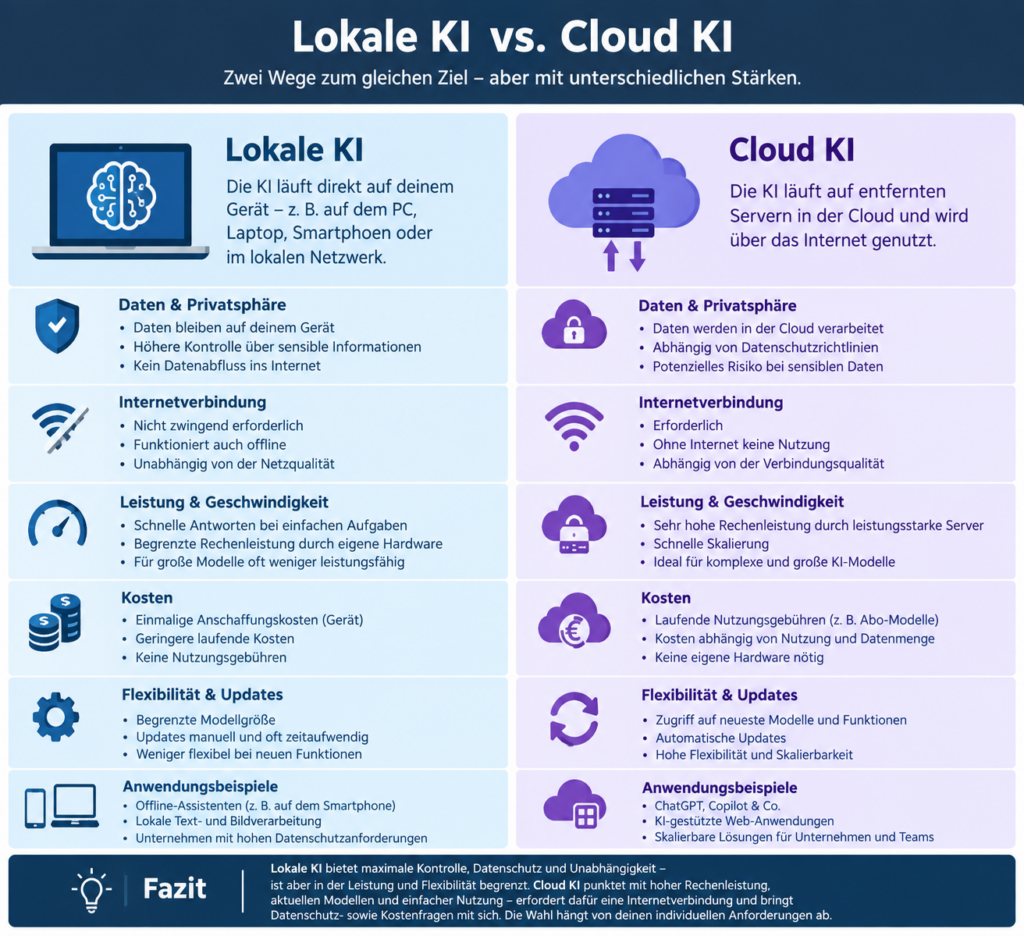
Lokale Verarbeitung bietet einen klaren Datenschutzvorteil, geht jedoch in der Regel mit geringerer Rechenleistung und eingeschränkteren Fähigkeiten einher. Für die meisten leistungsfähigen Assistenten gilt daher: Ihre Daten verlassen Ihr Gerät, sobald Sie eine Anfrage absenden.
Was mit Ihren Gesprächen langfristig geschieht
Neben der unmittelbaren Verarbeitung stellt sich die Frage, was mit Ihren Daten über die einzelne Anfrage hinaus passiert. Grundsätzlich lassen sich hier mehrere Verwendungszwecke unterscheiden, die je nach Anbieter und Ihren individuellen Einstellungen unterschiedlich ausgestaltet sind:
- Speicherung zur Verlaufsanzeige: Damit Sie frühere Gespräche wiederfinden, werden diese üblicherweise dauerhaft in Ihrem Konto gespeichert, bis Sie sie aktiv löschen.
- Nutzung zu Trainingszwecken: Manche Anbieter verwenden Gesprächsinhalte – meist nach Anonymisierung und häufig nur, sofern Sie dem nicht widersprochen haben – zur Verbesserung künftiger Modellversionen.
- Menschliche Überprüfung: Ausgewählte Konversationen können, etwa bei gemeldeten Problemen oder zu Qualitätszwecken, von Mitarbeitenden oder beauftragten Dienstleistern eingesehen werden.
- Aufbewahrung aus rechtlichen Gründen: Selbst nach einer Löschung im Nutzerkonto können Daten aus regulatorischen oder sicherheitstechnischen Gründen für einen begrenzten Zeitraum in Backup-Systemen verbleiben.
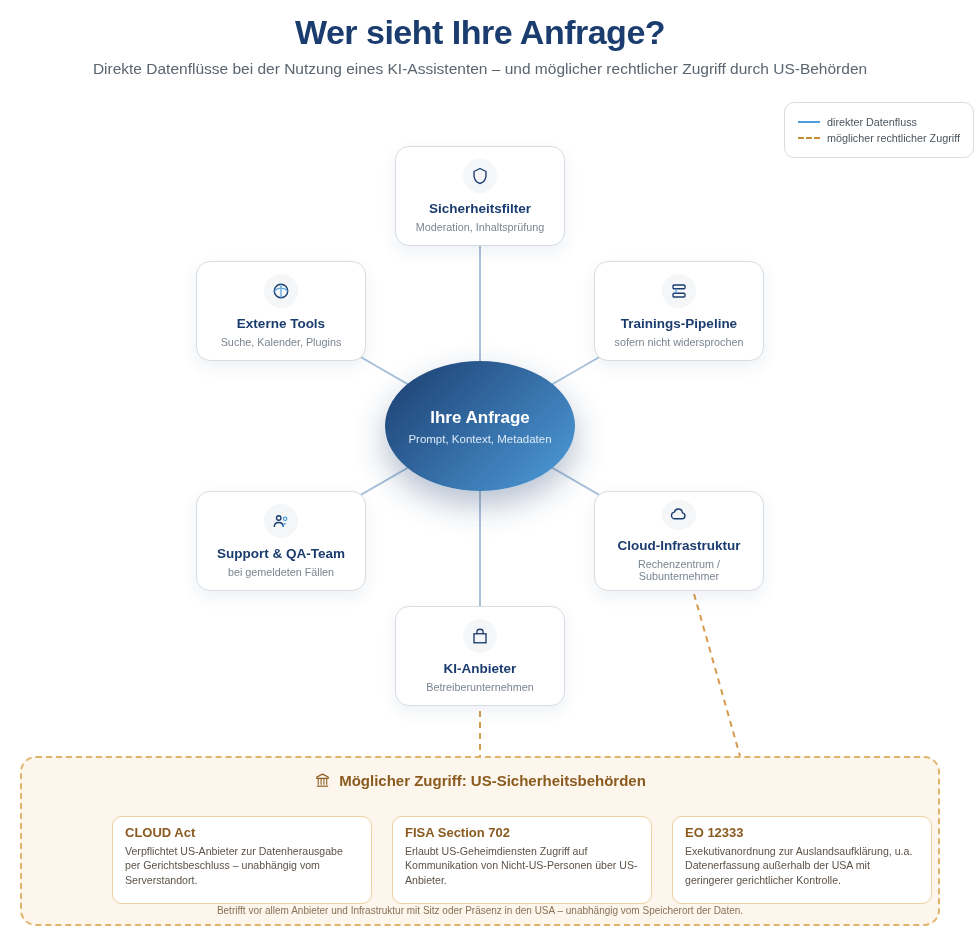
Da sich diese Praktiken zwischen Anbietern und im Zeitverlauf unterscheiden, lohnt sich vor der Nutzung eines KI-Assistenten stets ein Blick in die aktuellen Datenschutzhinweise des jeweiligen Dienstes.
Rechtlicher Rahmen: Was Ihnen zusteht
Innerhalb der Europäischen Union unterliegt die Verarbeitung personenbezogener Daten durch KI-Anbieter grundsätzlich der Datenschutz-Grundverordnung (DSGVO). Daraus ergeben sich für Sie als Nutzerin oder Nutzer mehrere zentrale Rechte:
- Recht auf Auskunft: Sie können von einem Anbieter erfahren, welche Daten zu Ihrer Person gespeichert sind.
- Recht auf Löschung: Unter bestimmten Voraussetzungen können Sie die Löschung Ihrer Daten verlangen.
- Recht auf Datenübertragbarkeit: Sie können verlangen, Ihre Daten in einem gängigen, maschinenlesbaren Format zu erhalten.
- Widerspruchsrecht gegen die Nutzung zu Trainingszwecken: Viele Anbieter räumen die Möglichkeit ein, der Verwendung Ihrer Gespräche für das Training künftiger Modelle zu widersprechen.
Ergänzend verpflichten europäische Regelungen zur künstlichen Intelligenz Anbieter von KI-Systemen zu bestimmten Transparenzpflichten, etwa zur Kennzeichnung, wenn Sie mit einem Chatbot statt mit einem Menschen interagieren. Diese Pflichten betreffen in erster Linie die Transparenz gegenüber Nutzerinnen und Nutzern und ersetzen nicht die grundsätzlichen datenschutzrechtlichen Anforderungen der DSGVO.
Woran Sie einen datenschutzbewussten Anbieter erkennen
Unabhängig von tagesaktuellen Entwicklungen lassen sich einige zeitlose Kriterien benennen, an denen Sie die Datenschutzkultur eines KI-Anbieters einschätzen können:
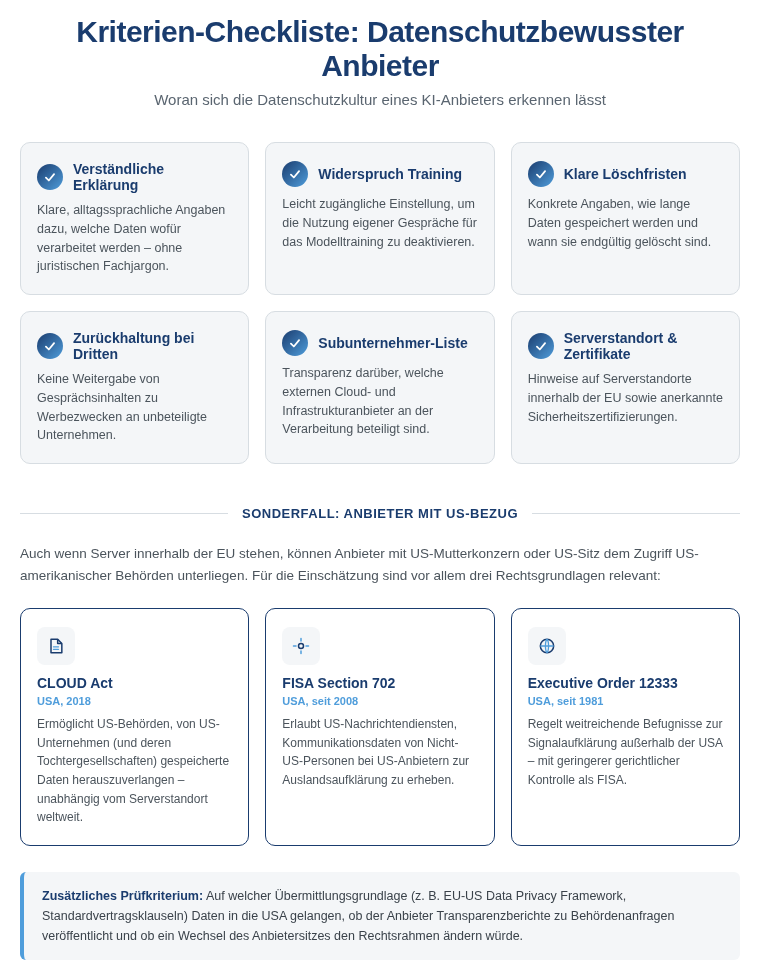
- Verständliche Datenschutzerklärung: Klare, in Alltagssprache formulierte Angaben dazu, welche Daten wofür verarbeitet werden – ohne sich in juristischem Fachjargon zu verlieren.
- Widerspruchsmöglichkeit gegen Trainingsnutzung: Eine leicht zugängliche Einstellung, mit der Sie die Nutzung Ihrer Gespräche für das Modelltraining deaktivieren können.
- Klare Löschfristen: Konkrete Angaben dazu, wie lange Daten gespeichert werden und wann sie endgültig gelöscht sind.
- Zurückhaltung bei der Weitergabe an Dritte: Keine Weitergabe von Gesprächsinhalten zu Werbezwecken an unbeteiligte Unternehmen.
- Nachvollziehbare Subunternehmer-Liste: Transparenz darüber, welche externen Cloud- und Infrastrukturanbieter an der Verarbeitung beteiligt sind.
- Serverstandort und Zertifizierungen: Hinweise auf Serverstandorte innerhalb der EU sowie anerkannte Sicherheitszertifizierungen können ein zusätzliches Indiz für ein durchdachtes Datenschutzkonzept sein.
Praktische Empfehlungen für den bewussten Umgang mit KI-Assistenten
Angesichts dieser vielschichtigen Verarbeitungskette lassen sich einige grundsätzliche Verhaltensregeln ableiten, die unabhängig vom jeweiligen Anbieter Bestand haben:
- Vermeiden Sie sensible Angaben. Geben Sie keine Sozialversicherungsnummern, Passwörter, Gesundheitsdaten oder vertrauliche Geschäftsinformationen in einen Chatbot ein, sofern dies nicht unbedingt erforderlich ist.
- Prüfen Sie die Datenschutzeinstellungen. Viele Anbieter erlauben es, die Nutzung von Gesprächen für das Modelltraining zu deaktivieren oder einen „temporären" Modus zu nutzen, bei dem Verläufe nicht dauerhaft gespeichert werden.
- Seien Sie zurückhaltend bei verknüpften Diensten. Jede zusätzliche Verbindung – etwa zu E-Mail-Konten, Kalendern oder Cloud-Speichern – vergrößert die Angriffsfläche und die Anzahl der beteiligten Systeme.
- Löschen Sie nicht mehr benötigte Verläufe. Regelmäßiges Aufräumen reduziert die Menge an Daten, die im Falle eines Sicherheitsvorfalls betroffen sein könnten.
- Lesen Sie die Datenschutzhinweise – zumindest in Auszügen. Insbesondere die Abschnitte zu Datenweitergabe an Dritte und zu Speicherfristen geben Aufschluss darüber, wie ernst ein Anbieter den Datenschutz nimmt.
- Nutzen Sie geschäftliche Konten mit Bedacht. Für sensible berufliche Anwendungsfälle bieten manche Anbieter Unternehmenslösungen mit strengeren Datenschutzgarantien an, die sich von den Standard-Consumer-Produkten unterscheiden können.
Fazit
Die Frage, wie viel ein KI-Assistent über Sie weiß, lässt sich nicht allein mit einem Blick auf das sichtbare Chatfenster beantworten. Hinter jeder Anfrage steht eine mehrstufige technische Kette aus Vorverarbeitung, Sicherheitsprüfung, Gedächtnisabruf, externen Werkzeugaufrufen, verteilter Rechenleistung und Protokollierung – eine Infrastruktur, die weitgehend unsichtbar bleibt, aber maßgeblich bestimmt, wie Ihre Daten verarbeitet und mitunter weitergegeben werden.
Wer diese Zusammenhänge kennt, kann bewusster entscheiden, welche Informationen er einem KI-Assistenten anvertraut und welche besser im eigenen Kopf oder in einem verschlüsselten Dokument bleiben. Datenschutzbewusster Umgang mit künstlicher Intelligenz bedeutet daher nicht, auf die Technologie zu verzichten, sondern sie mit einem klaren Verständnis ihrer tatsächlichen Funktionsweise zu nutzen. Mittlerweile ist Open-Source KI so gut, dass Unternehmen kostengünstig eine lokaleKI betreiben können, mit maximal möglicher Datensicherheit.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die