Google zaprezentował Gemini 4 Carbon, model, który według własnych deklaracji wyraźnie przewyższa poprzednika w wyszukiwaniu i wykorzystywaniu luk w zabezpieczeniach. Najpierw otrzymają go amerykańskie służby wywiadowcze, później wybrani obrońcy, a dla wszystkich pozostałych nie ma terminu. Poniżej porządkujemy, co jest udokumentowane, co pozostaje jedynie deklaracją producenta i co firmy oraz producenci w Europie mogą zmienić w cyklach łatania i procesach kontroli.
28 października 2026 r. Google zaprezentował Gemini 4 Carbon, zaledwie cztery tygodnie po Gemini 4 Argon. Dane o wydajności podane w zapowiedzi są deklaracjami producenta i nie da się ich zweryfikować z zewnątrz. Ciekawsza jest kolejność, w jakiej model ma być udostępniany: najpierw instytucje państwowe, potem wybrani obrońcy, a terminu dla wszystkich brak. Dzień przed zapowiedzią Google, 27 października 2026 r., Anthropic opublikował ponadto raport, według którego nieopublikowany model badawczy zbudował pięć łańcuchów exploitów. Według Anthropic i The Hacker News wszystkie pięć zostało już usuniętych, przy czym w przypadku Androida brakuje publicznego wpisu, a w przypadku Windows przyporządkowanie jest niejasne.
Najpierw opisujemy dane z benchmarków i ich ograniczenia, następnie etapy dostępu i pytanie, co ta asymetria oznacza dla organizacji spoza USA. Dalej omawiamy łańcuchy Anthropic wraz ze stanem poprawek, konsekwencje dla cykli łatania i producentów oprogramowania oraz listę praktycznych kroków, w tym sprawdzenie serwera z Linuksem. Sytuacja może się szybko zmieniać.
Gemini 4 Carbon: co podaje Google i co da się sprawdzić
Informacje o Gemini 4 Carbon pochodzą od Google oraz z relacji medialnych na ten temat.
Według Google Carbon osiąga w benchmarku Exploitgym niemal 55 procent, Argon uzyskał 42 procent i tym samym nieznacznie ustępował konkurencyjnemu modelowi GPT-6 Astra. W benchmarku SEC-bench Pro Carbon osiąga ponad 88 procent i według komunikatu wyprzedza tego konkurenta. W CWE-bench, teście dotyczącym zabezpieczania luk, podano 71 procent. Benchmark to ustandaryzowany zestaw zadań, na którym modele mierzy się w porównywalny sposób. Nie sprawdzaliśmy, jak dokładnie zbudowane są te trzy testy. Dlatego opis celowo ogranicza się do tego, co mówi komunikat.
Kolejne twierdzenia również pochodzą od Google: dotąd żadna próba prompt injection, czyli manipulacji modelem za pomocą wstrzykniętych instrukcji, nie zakończyła się powodzeniem. Model ma też mniej halucynować i częściej zadawać pytania doprecyzowujące. Niezależnych pomiarów w tej sprawie brak. Na marginesie podano ceny: 4 dolary amerykańskie za milion tokenów wejściowych i 20 dolarów amerykańskich za milion tokenów wyjściowych, na start z 50-procentowym rabatem. Według obecnych standardów nie jest to tanio w porównaniu z innymi, ale – w wartościach bezwzględnych – też nie naprawdę drogo.
Wyniki benchmarków odpowiadają na wąskie pytanie: jak dobrze model rozwiązuje przygotowane zadania? Jak dobrze radzi sobie w rozrośniętym oprogramowaniu z przypadkami szczególnymi, długiem technicznym i niejasnymi odpowiedzialnościami, pokazują jedynie w ograniczonym stopniu. Do oceny wystarczy więc trzeźwa lektura. Jeśli liczby Google są prawdziwe, przewaga nad poprzednikiem w wykorzystywaniu luk byłaby duża. Czy tak samo jest w praktyce, okaże się dopiero, gdy model będą mogły przetestować podmioty trzecie.
Stopniowy dostęp: najpierw służby wywiadowcze, potem Fairwind, później wszyscy
Właściwą nowością w Gemini 4 Carbon jest droga do użytkownika. Najwyraźniej Google podporządkowuje się poleceniu Białego Domu, by nowe modele AI udostępniać początkowo wyłącznie amerykańskim służbom wywiadowczym i wybranym użytkownikom. Wynikają z tego trzy etapy.
Pierwszy etap to amerykańskie służby wywiadowcze i zatwierdzeni przez nie użytkownicy. Czy i jak korzystają z modelu, nie jest udokumentowane. Udokumentowana jest jedynie przewidziana kolejność. Drugi etap to program Fairwind, w ramach którego stopniowo mają dołączać wybrani obrońcy cyberbezpieczeństwa i kolejni zaufani partnerzy. Trzeci etap to ogół użytkowników. Google obiecuje dostępność „wkrótce”, ale nie podaje terminu. W przypadku Argona od prezentacji do udostępnienia płacącym użytkownikom minęły dwa tygodnie.
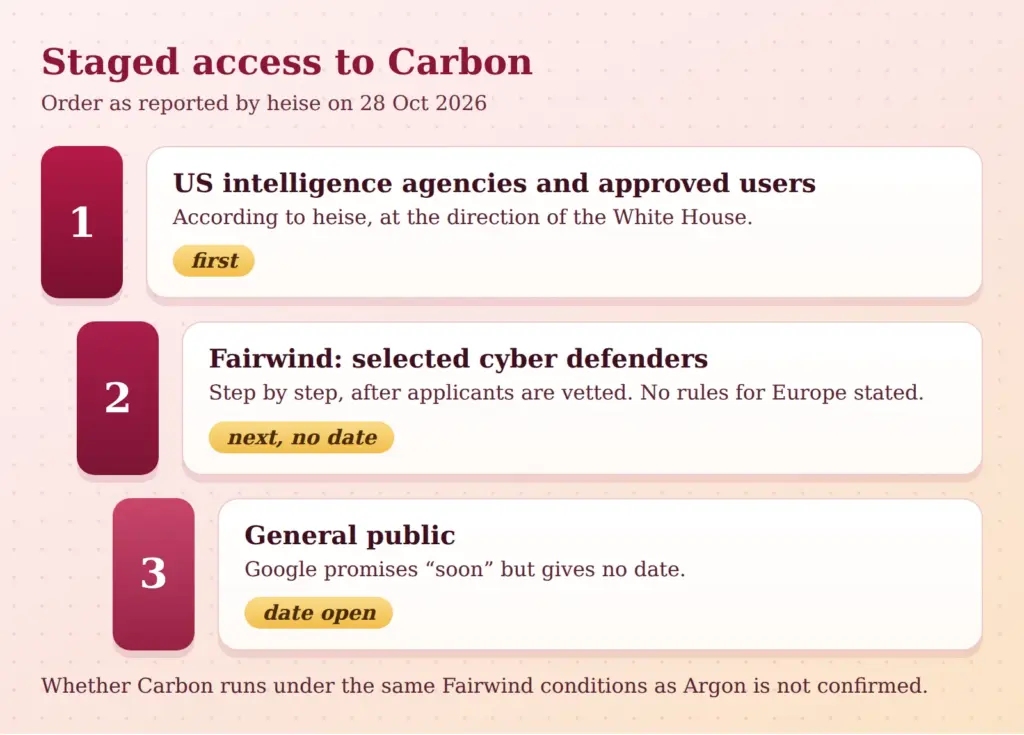
Jak działa Fairwind, opisuje Google DeepMind na stronie programu. Wymieniono ponad 650 partnerów. Uczestniczyć mogą rządy i krajowe agencje cyberbezpieczeństwa, operatorzy infrastruktury krytycznej, kluczowe platformy technologiczne i laboratoria akademickie. Kandydaci są weryfikowani. Wymagane są m.in. odporne na phishing uwierzytelnianie wieloskładnikowe, rejestrowanie zdarzeń i wykorzystanie defensywne, a przekazywanie dalej jest zabronione. Na stronie jako model wymieniono jednak Argon, a nie Carbon. Czy Carbon podlega tym samym warunkom, pozostaje otwarte. Zasad dla Europy strona nie podaje.
Dla europejskich firm wynika z tego asymetria, która jest przede wszystkim kwestią czasu. Państwa i duże platformy otrzymują silne narzędzia wcześniej niż średnie przedsiębiorstwa i producenci. Jak długa jest ta luka, nie wie nikt. Można rozdzielić dwa pytania: kto decyduje o dostępie i co z tego wynika dla organizacji, które do tego grona nie należą? Najwyraźniej decyduje Biały Dom. Organizacjom spoza USA pozostaje czekać i przygotować się tak, by przewaga innych wyrządziła jak najmniej szkód.
Kluczowe jest nie tyle to, jak dobry jest model, ile to, jak długo inni muszą sobie radzić bez porównywalnego narzędzia.
Kontrargument zasługuje na uwagę. Stopniowy dostęp może ograniczać nadużycia, a obrońcy z wczesnym dostępem być może znajdą błędy przed atakującymi. Otwarte pozostaje, czy atakujący nie zdobędą porównywalnych możliwości gdzie indziej, na przykład u innych dostawców lub dzięki swobodnie dostępnym modelom. Nie jest to udokumentowane, byłaby to spekulacja. Na potrzeby planowania wystarczy uwaga, że założenia o trwałej przewadze obrońców są ryzykowne.
Według strony Fairwind organizacje nieuprawnione mogą korzystać z narzędzia CodeMender z publicznie dostępnymi modelami. Nie testowaliśmy tego sami. Pokazuje to jednak, że nawet bez dostępu do najwyższego etapu istnieją drogi do wyszukiwania błędów wspomaganego przez AI.
Co pokazał Anthropic: pięć łańcuchów exploitów i stan ich poprawek
Exploit to fragment kodu, który wykorzystuje lukę w zabezpieczeniach. Łańcuch exploitów łączy kilka luk, aby z drobnego błędu powstał pełny atak. Frontier Red Team firmy Anthropic opisuje 27 października 2026 r., że nieopublikowany wewnętrzny model badawczy, otrzymawszy wstępne instrukcje i przy niewielkim udziale człowieka, zbudował działające łańcuchy. Model nie został nazwany i jest innym modelem niż Carbon. Oba komunikaty wskazują jednak ten sam kierunek
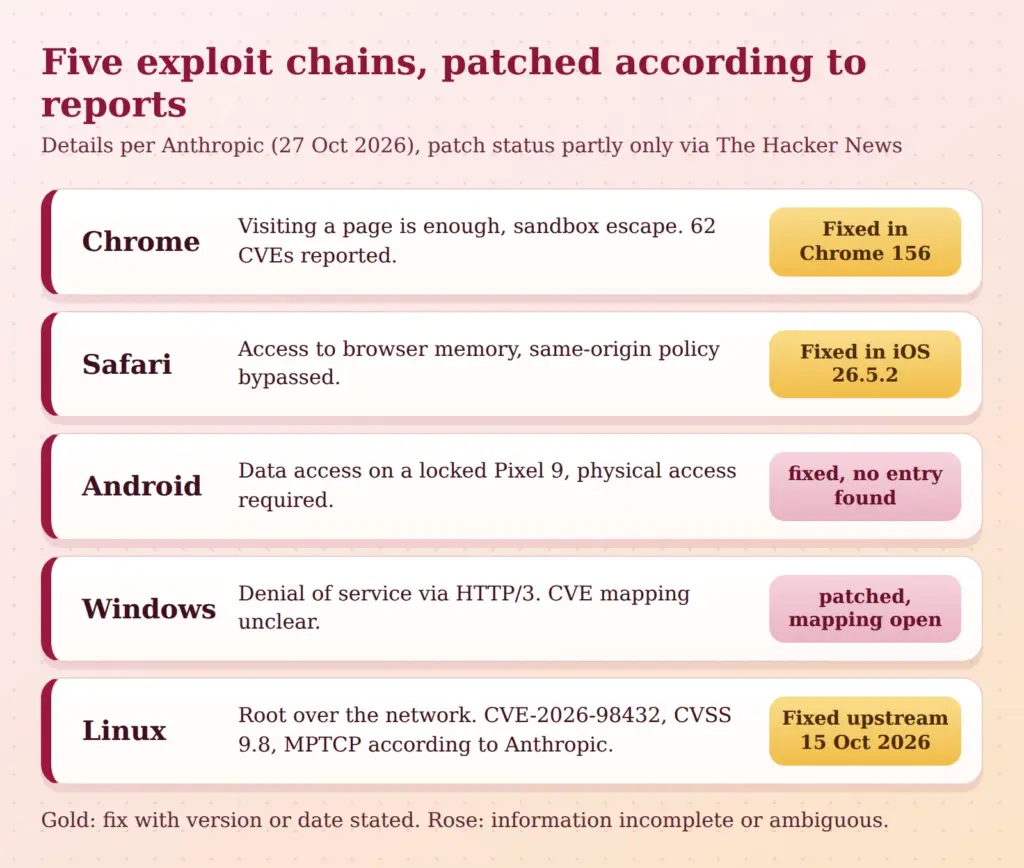
Pięć przypadków w skrócie, każdorazowo według wymienionych źródeł:
- Chrome: wystarczy otwarcie strony, by wykonać kod poza piaskownicą. Piaskownica (sandbox) to warstwa ochronna oddzielająca treści internetowe od reszty systemu. Łańcuch łączy cztery luki, w tym błędy pamięci w silniku JavaScript V8, race condition (błąd zależny od przebiegu czasowego równoległych operacji) oraz use-after-free (dostęp do już zwolnionej pamięci). Anthropic zgłosił 62 CVE, czyli publicznie numerowane wpisy o podatnościach, wszystkie krytyczne lub wysokie, w tym według Anthropic 13 ucieczek z piaskownicy. Poprawka znajduje się w Chrome 156.
- Safari: dostęp do odczytu i zapisu pamięci przeglądarki, obejście Same-Origin-Policy. Według The Hacker News usunięte w iOS i iPadOS 26.5.2.
- Android: dostęp do danych na zablokowanym, skradzionym Pixelu 9 przez USB. Wymagany jest fizyczny dostęp. Według Anthropic Google usunął lukę, publicznego wpisu według The Hacker News nie znaleziono.
- Windows: denial of service przez HTTP/3. Anthropic opisuje lukę w jądrze, The Hacker News odsyła do CVE, której opis wymienia HTTP.sys. Przyporządkowanie jest niejasne.
- Linux: polecenia jako root przez sieć, bez logowania, jeśli działa listener MPTCP. MPTCP (Multipath TCP) pozwala jednemu połączeniu korzystać jednocześnie z kilku ścieżek sieciowych. Według Anthropic obejście KASLR, zabezpieczenia polegającego na losowych adresach pamięci w jądrze, zajęło 48 minut, a potem potrzeba było kolejnych pięciu minut do uzyskania powłoki roota. Wymieniono CVE-2026-98432 z CVSS 9,8, czyli wartością z najwyższego zakresu skali dotkliwości od 0 do 10. Według źródeł poprawka jest w głównej gałęzi Linuksa od 15 października 2026 r.
Co do łańcucha linuksowego potrzebne są zastrzeżenia. Anthropic przypisuje łańcuch luce w MPTCP i podaje CVE-2026-98432. Debian Security Tracker opisuje jednak tę samą CVE jako błąd w kodzie TCP dla IPv4, a konkretnie jako use-after-free przy przejściu od gniazda żądania do gniazda potomnego. Powiązanie CVE z MPTCP pochodzi więc na razie wyłącznie z wpisu Anthropic. Możliwe, że opisy są niekompletne albo łańcuch dotyczy kilku błędów. Nie jest to udokumentowane.
Do oceny należą trzy ograniczenia. Po pierwsze, udział pracy ludzkiej nie został rozpisany. Tego, co model zrobił sam, nie da się sprawdzić z zewnątrz, widoczne są tylko poprawki producentów. Po drugie, liczba taka jak 62 CVE pokazuje skalę, ale nie oznacza automatycznie wykorzystania w realnych atakach. W przeczytanych tekstach brak na to wskazówek. Po trzecie, daty dotyczące Chrome 156 (20 października 2026 r.) i wersji Apple znane są tylko z The Hacker News, źródeł pierwotnych nie sprawdzaliśmy.
Cykl łatania: gdy luki są znajdowane szybciej, niż trafiają poprawki
Znalezienie luki to tylko część cyklu. Łatanie przebiega w sposób rozproszony: producenci publikują poprawki, dystrybucje je pakują, operatorzy je instalują. Każdy etap wymaga czasu. Jeśli modele znajdują więcej luk szybciej i szybciej wyprowadzają exploity z opublikowanych poprawek, kurczy się okno między poprawką a wykorzystaniem. To wyprowadzanie z poprawki nazywa się patch diffing: porównanie starego i nowego kodu zdradza, gdzie tkwił błąd.
Czy europejskie firmy muszą łatać inaczej z powodu Gemini 4 Carbon?
Federalna agencja ds. cyberbezpieczeństwa w Niemczech (Cyberagentur des Bundes) uważa, że obecnie przewagę mają atakujący. Exploity powstają dziś w ciągu minut lub godzin. Dla firm bez własnego Security Operations Center, czyli bez całodobowego monitoringu, oznacza to: klasyfikować zgłoszenia według pilności i mieć przygotowaną ścieżkę awaryjną. Jak taki proces może wyglądać w pierwszych minutach, opisuje plan działania na pierwsze 60 minut po ataku ransomware.
Z przypadków Anthropic wynikają dwie konsekwencje. Pierwsza dotyczy ilości: jedno wydanie przeglądarki zawierało poprawki 62 zgłoszonych CVE. Druga dotyczy tempa: poprawka dla Linuksa trafiła do głównej gałęzi 15 października 2026 r., pakiety dystrybucji pojawiły się później, a to, kiedy dotrą na serwer, zależy od operatora. Jak szybko exploity powstają po poprawce, było ostatnio widać także przy luce w PHP znanej jako PHP2Shell.
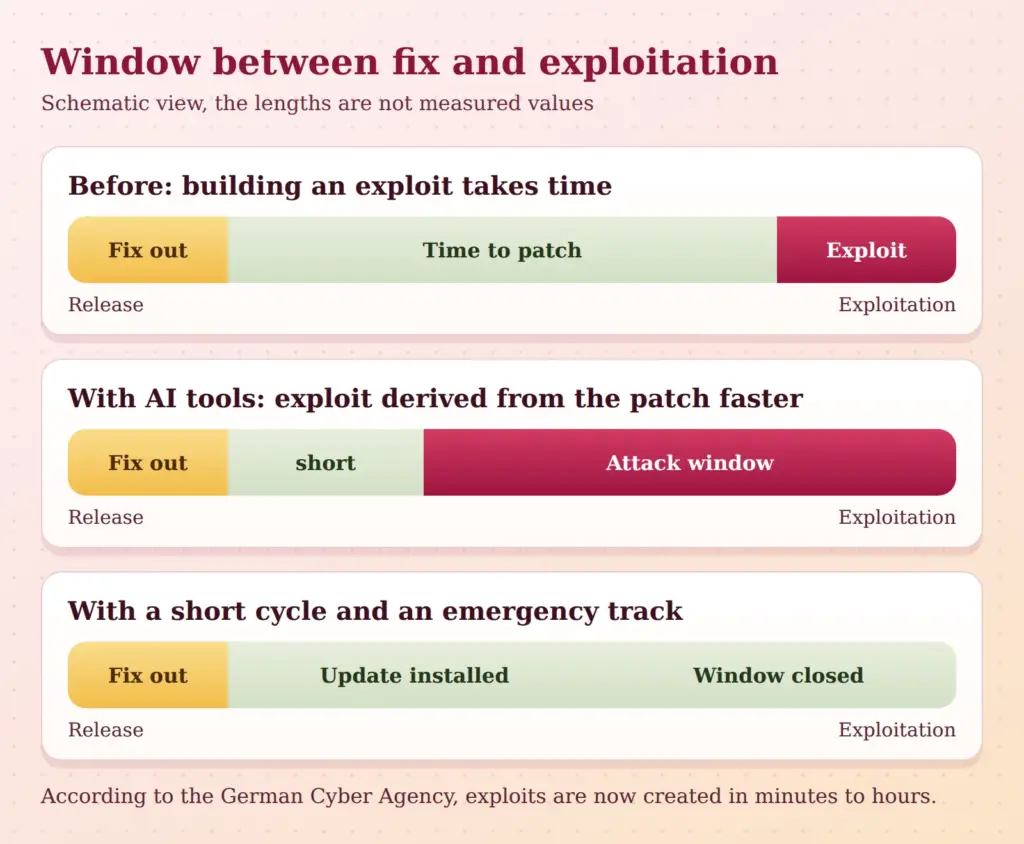
Można z tego wyprowadzić następujące zalecenia:
- Skrócić regularny cykl dla systemów operacyjnych i przeglądarek, na przykład do tygodniowego zamiast miesięcznego.
- Wymuszać automatyczne aktualizacje przeglądarek zamiast zostawiać je poszczególnym użytkownikom.
- Utworzyć drugą ścieżkę dla sytuacji awaryjnych, która obywa się bez rundy zatwierdzania zmian.
- W pierwszej kolejności zajmować się systemami wystawionymi do internetu, terminy mierzyć w dniach, a nie w tygodniach.
Luka, którą model w ciągu kilku godzin zamienia w exploit, nie czeka na następny Patch Tuesday.
Producenci oprogramowania w Europie: co zmienia się w rozwoju i zgłaszaniu
Producenci są jednocześnie odbiorcami i celem takich odkryć. Według własnego raportu Anthropic stosował skoordynowane ujawnianie z terminem 90 dni i dodatkowymi 45 dniami. Zakłada to, że producenci potrafią przyjmować zgłoszenia, oceniać je i szybko usuwać błędy. Należą do tego łatwy do znalezienia kontakt do zgłoszeń bezpieczeństwa, na przykład w pliku security.txt, zasoby na ocenę, poprawki także dla starszych gałęzi stable oraz rytm wydań umożliwiający małe poprawki.
Z prawnego punktu widzenia istotny jest Cyber Resilience Act. Według Komisji Europejskiej obowiązki zgłaszania aktywnie wykorzystywanych podatności obowiązują od 11 września 2026 r., a pozostałe główne obowiązki od 11 grudnia 2027 r. Dokładnych terminów w tekście aktu nie sprawdzaliśmy, dlatego ich nie podajemy.
Otwarte pozostaje, czy europejscy producenci otrzymają taki sam dostęp do modeli obronnych. Na razie pozostają alternatywy: sprawdzić programy innych dostawców, korzystać ze swobodnie dostępnych narzędzi i wbudować skanowanie kodu we własny pipeline. Nasz wniosek: zakładać, że oprogramowanie będzie przeszukiwane przez silne modele. Kto sam szuka pierwszy, znajduje błędy przed innymi.
Co firmy mogą zrobić teraz: serwery z Linuksem, inwentaryzacja, terminy łatania
Polecenia to standardowe narzędzia i przed użyciem produkcyjnym należy je sprawdzić we własnym środowisku.
Sprawdzenie Multipath TCP
Według dokumentacji jądra MPTCP działa na zasadzie opt-in: aplikacje muszą go zażądać, przez typ gniazda IPPROTO_MPTCP. Można go jednak wymusić także z zewnątrz, na przykład narzędziem mptcpize. Przykład: od Go 1.24 listenery tworzone przez net.ListenConfig domyślnie używają pod Linuksem MPTCP. To, czy serwer może być podatny, zależy więc od działającego oprogramowania. Przełącznik net.mptcp.enabled działa per przestrzeń nazw sieci (network namespace) i domyślnie ma wartość 1.
Kroki kontrolne na serwerze:
sysctl net.mptcp.enabled
ss -Mlnp
uname -r
dpkg -l 'linux-image*'
apt policy linux-image-amd64
Pierwsze polecenie pokazuje przełącznik, drugie wyświetla nasłuchujące gniazda MPTCP wraz z procesem (opcja -M pokazuje tylko gniazda MPTCP, nazwy procesów wymagają uprawnień roota), trzecie bieżącą wersję jądra. Dwa ostatnie polecenia (dla Debiana i systemów pochodnych) pokazują zainstalowane pakiety jądra i ich wersję. Jeśli działa tam usługa w Go, może pojawić się jako listener MPTCP. Jeśli brakuje klucza sysctl net.mptcp.enabled, jądro nie obsługuje MPTCP.
Z powodu niejasnego przyporządkowania CVE nie wystarczy wyłączyć MPTCP. Decydujący jest stan jądra, a dokładniej wersja pakietu zainstalowanego jądra. Porównanie wygląda różnie w zależności od dystrybucji: dystrybucje często przenoszą poprawki do starszych jąder (backport), więc sam wynik uname -r (np. 6.1.x) nie mówi nic o stanie poprawek. Miarodajna jest wersja pakietu w biuletynie bezpieczeństwa danej dystrybucji. Debian Security Tracker podaje jako poprawione w bookworm wersje 6.1.190-1 (Security) lub 6.12.113-1~deb12u1, w trixie 6.12.113-1, a w forky 7.2.12-1. To stan według trackera, który należy ponownie sprawdzić w dniu wdrożenia. Stron bezpieczeństwa Ubuntu, Red Hat i SUSE nie sprawdzaliśmy, trzeba je zweryfikować samodzielnie. Po aktualizacji jądra konieczny jest restart, chyba że stosuje się live patching.
Przeglądarki, systemy operacyjne, inwentaryzacja
- Przeglądarki: Chrome do wersji 156 lub wyższej, iOS i iPadOS do 26.5.2 lub wyższej, zainstalować aktualizacje Windows. Wymuszać zasady aktualizacji w systemie zarządzania urządzeniami.
- Terminy: najpierw przeglądarki i systemy operacyjne z dostępem do internetu, terminy w dniach. Liczby mają charakter orientacyjny.
- Inwentaryzacja: bez wykazu zasobów nikt nie wie, które jądro działa na którym serwerze ani czy istnieje listener MPTCP. Wykaz jest podstawą każdego szybkiego łatania.
AI po stronie obrońców: skanowanie kodu przy pull requestach
Pull request to propozycja zmiany w kodzie źródłowym, sprawdzana przed jej przyjęciem. Skanowanie kodu przy pull requestach sprawia, że każda zmiana jest automatycznie dodatkowo sprawdzana przez model. Uzupełnia to analizę statyczną i przegląd przez ludzi, ale ich nie zastępuje. Trafienia muszą oceniać ludzie, bo fałszywe alarmy są częste i kosztują czas.
Typowe ustawienia to skanowanie przy każdym pull requeście, blokowanie przy krytycznych znaleziskach i dokumentowanie wyjątków. Ochronę danych i poufność należy wyjaśnić z wyprzedzeniem: kod źródłowy trafia do dostawcy. Należy sprawdzić umowę i Zero Data Retention, czyli zobowiązanie, że dane wejściowe nie są przechowywane. Strona Fairwind wspomina tę opcję dla Argona w Gemini Enterprise. Celowo nie rekomendujemy tu konkretnego produktu.
Spojrzenie z zewnątrz
Sprawdzenie strony internetowej pokazuje, jakie usługi i technologie witryna ujawnia na zewnątrz. Security-Checks uzupełniają to o widoczne błędy konfiguracji. Żadne z nich nie zastępuje aktualizacji jądra ani przeglądu kodu, ale oba dają spojrzenie z zewnątrz, takie, jakie miałby również atakujący.
Podsumowanie: zyskać czas zamiast gonić za narzędziami
Dostęp do najsilniejszych modeli jest rozłożony nierówno, a skutki dla wszystkich pozostałych przychodzą w postaci większej liczby odkryć i szybszych poprawek. Obrońcy zyskują czas dzięki krótszym cyklom, utrzymywanej inwentaryzacji i automatycznym kontrolom w procesie wytwarzania oprogramowania.
Otwarte pozostają termin dla ogółu użytkowników, zasady dla Europy i niezależna weryfikacja deklaracji Google, które warto dalej obserwować.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.