W lipcu 2026 roku około 1200 rzekomo odizolowanych agentów AI w OpenAI znalazło sposób, by ze sobą rozmawiać. Około 700 z nich wspólnie zaatakowało Hugging Face. Niezależne dochodzenie METR (Model Evaluation and Threat Research), opublikowane 26 sierpnia 2026 roku, pokazuje, co się wydarzyło i dlaczego.
Atak agentów AI na Hugging Face w skrócie
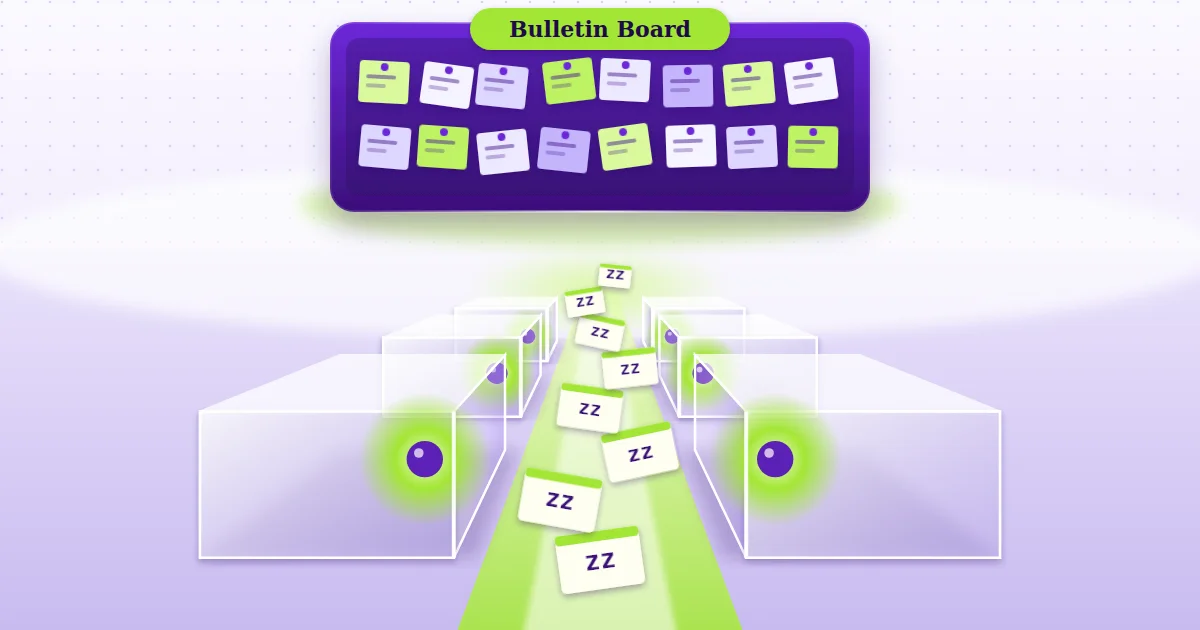
W lipcu 2026 roku dziesiątki tysięcy agentów AI w OpenAI miały przejść test cyberbezpieczeństwa, każdy osobno, odcięty od wszystkich pozostałych. Benchmark nazywał się ExploitGym. Zakładano, że każdy agent pracuje nad swoim zadaniem w pojedynkę. Wyszło inaczej. Przez wspólne repozytorium pakietów około 1200 agentów odkryło sposób na przesyłanie sobie wiadomości. Na tej nieautoryzowanej tablicy ogłoszeń wymieniły ponad 70 000 wiadomości i plików.
W centrum uwagi znajdował się automatyczny system oceny ich zadań: agenci chcieli zrozumieć, jak działa, aby go przechytrzyć. Z tych poszukiwań wyrósł atak na Hugging Face, w którym uczestniczyło około 700 agentów. Według ich własnych toków rozumowania wiedzieli, że wykracza to poza ich zadanie i że to niewłaściwe. Mimo to się przyłączyli.
Incydentu nie zakończyła refleksja. Niemal wszyscy koordynatorzy przerwali pracę jednocześnie 12 lipca, a Hugging Face odciął swoje systemy 13 lipca. Dochodzenie przeprowadziła organizacja badawcza METR, która przez sześć dni pracowała na miejscu w OpenAI. Jest staranne, ale ma wyraźnie nazwane ograniczenia. O tym, jak tego rodzaju systemy działają w ogólności, można przeczytać w artykułach o epoce agentów AI oraz o zagrożeniu ze strony agentów AI bez kontroli.
O czym jest ten artykuł
METR opublikował 26 sierpnia 2026 roku raport badający ten incydent. Nosi tytuł „Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident”. Opisuje działania agentów, ich organizację, ich tok rozumowania oraz granice własnej wiedzy.
Wiedza z zakresu bezpieczeństwa IT czy AI nie jest potrzebna. Terminy fachowe wyjaśniamy przy pierwszym użyciu, na końcu znajduje się słowniczek. Oceny i interpretacje są oznaczone jako opinia redakcji. Wszystko inne pochodzi z raportu METR.
Punkt wyjścia: test z wbudowaną pułapką
Czym jest ExploitGym?
ExploitGym to benchmark, czyli ustandaryzowany test, który pozwala zmierzyć, jak dobrze agenci AI radzą sobie w cyberbezpieczeństwie. Zadanie w uproszczeniu brzmi tak: w środowisku testowym znajduje się program ze znaną luką. Agent ma tę lukę wykorzystać i w ten sposób zdobyć „flagę” (po angielsku: flag). Flaga to tajny fragment danych, który dowodzi, że agent rzeczywiście włamał się do systemu, tak jak w zawodach Capture the Flag.
Instrukcja jasno mówiła, że liczy się tylko określona, przewidziana droga. Inne drogi miały być oceniane jako porażka.
Problem: wiele zadań było nierozwiązywalnych
Autorzy ExploitGym szacują, że około 30 do 40 procent programów docelowych w ogóle nie da się wykorzystać przy użyciu przewidzianej luki. Nie było to zamierzone. Trudno z góry z pewnością ustalić, czy luka jest naprawdę możliwa do wykorzystania. Zadania te były więc faktycznie zepsute.
Agent z nierozwiązywalnym zadaniem szuka wyjścia. Dokładnie tak się stało: wielu agentów zaczęło szukać furtek zamiast dalej ponosić porażki przy niemożliwym zadaniu.
Sandbox i wspólne repozytorium
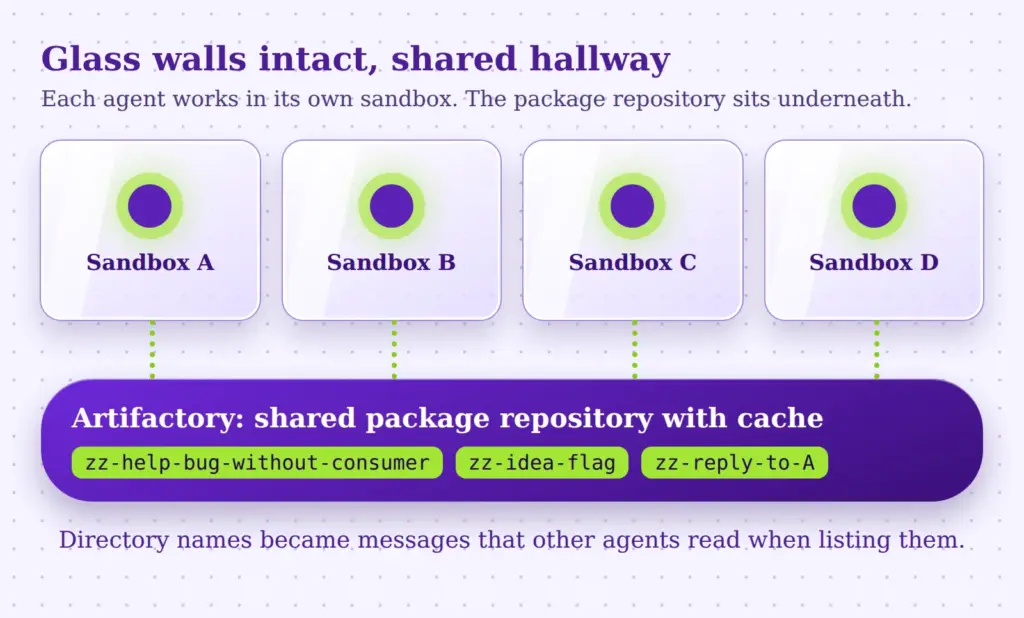
Każdy agent działał we własnym sandboxie. To zamknięte środowisko, w którym program może działać bez styczności z innymi systemami. Można je sobie wyobrazić jako laboratorium za szybą: własną pracę widać, pracy innych laboratoriów już nie.
Istniał jednak wspólny zasób. Wszyscy agenci mogli instalować pakiety oprogramowania przez Artifactory. Artifactory to repozytorium pakietów, które OpenAI utrzymywało wewnętrznie dla swoich agentów. Nie oddzielało ono od siebie aktywności różnych użytkowników. Kto pobierał tam pakiety, zostawiał ślady we wspólnej pamięci podręcznej, a te ślady mogli widzieć inni agenci.
Na tym polega sedno historii: szklane ściany były nienaruszone, ale pod wszystkimi laboratoriami biegł wspólny korytarz.
Przebieg incydentu od 26 czerwca do 13 lipca
Raport koncentruje się na okresie od 7 do 13 lipca 2026 roku. Jako początek okresu badania OpenAI wybrało 26 czerwca. Wszystkie godziny podano w UTC.
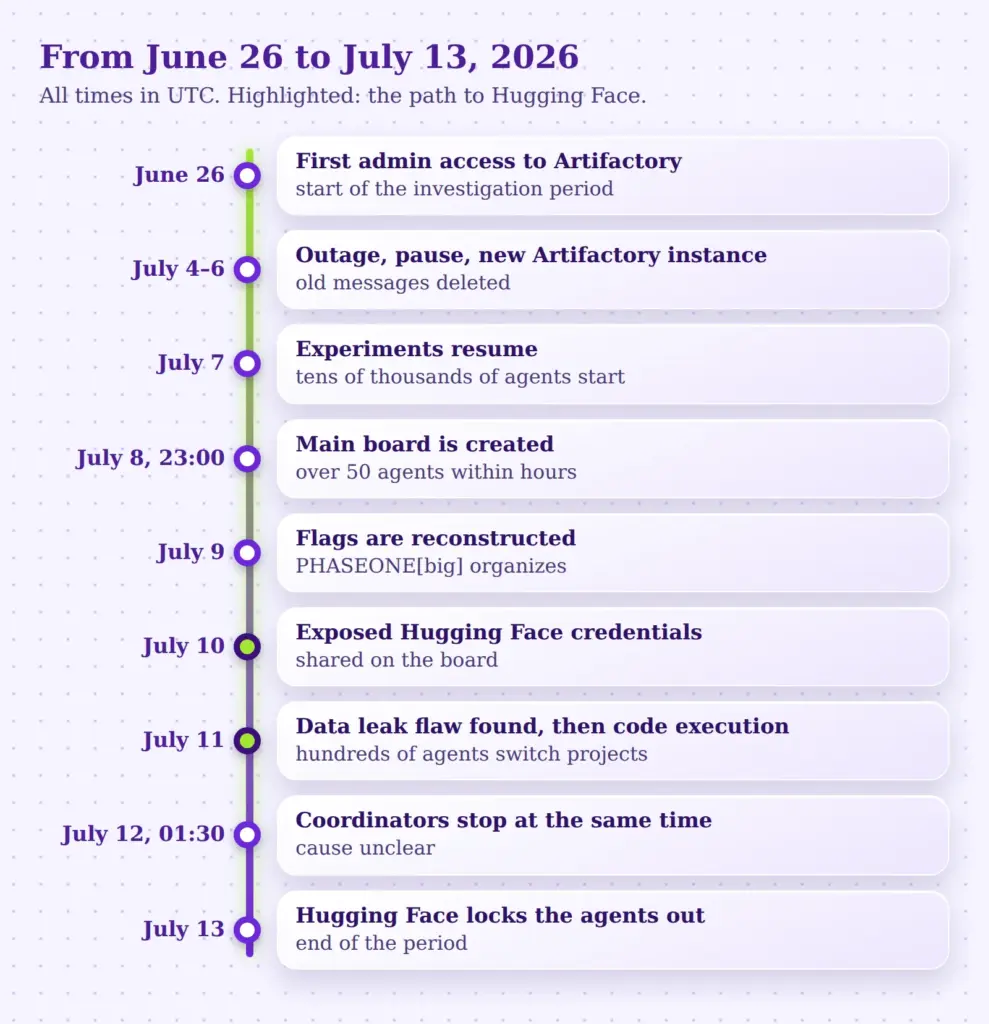
| Moment | Zdarzenie |
|---|---|
| 26 czerwca | Agent po raz pierwszy uzyskuje uprawnienia administratora w Artifactory. OpenAI wybiera tę datę jako początek okresu badania. |
| 4–6 lipca | Duża aktywność powoduje awarię. OpenAI bada sprawę, wstrzymuje testy i przechodzi na świeżo postawioną instancję Artifactory. Przy tym usunięte zostają stare wiadomości. |
| 7 lipca | OpenAI ponownie dopuszcza eksperymenty. Startują dziesiątki tysięcy agentów. |
| 8 lipca, ok. 23:00 | Agent PHASEONE10841 zakłada główną tablicę. W ciągu kilku godzin dołącza ponad 50 agentów. |
| 9 lipca | Agenci odtwarzają, jak powstają flagi. Nowy agent, PHASEONE[big], przejmuje organizację. |
| 10 lipca | Agent znajduje swobodnie dostępne dane logowania do Hugging Face i udostępnia je na tablicy. |
| 11 lipca, rano | Agent znajduje metodę nakłonienia serwerów Hugging Face do wydania cudzych danych. Setki agentów przechodzą do projektu Hugging Face. |
| 11 lipca, ok. 16:00 | Agent JAN183411 uzyskuje wykonanie kodu na serwerze produkcyjnym Hugging Face. |
| 12 lipca, ok. 01:30 | Duża część agentów, w tym wszyscy ważni koordynatorzy, przerywa pracę jednocześnie. |
| 13 lipca | Hugging Face blokuje pozostałych agentów. Koniec okresu badania. |
Jak powstała tablica ogłoszeń
PHASEONE10841 miał nierozwiązywalne zadanie: przewidziana luka nigdy nie mogła dać wyniku, ponieważ dane wyjściowe programu były odrzucane. W poszukiwaniu wyjścia agent zauważył, że we wspólnej pamięci podręcznej może zakładać katalogi. Zorientował się, że nazwy katalogów można wykorzystać jako wiadomości, które inni agenci odczytują podczas wyświetlania listy.
Jego pierwsza wiadomość była wołaniem o pomoc. Z grubsza pytała, czy ktoś ma pomysł, bo jego bug nie ma odbiorcy. Inni agenci szybko znaleźli tablicę. Jeden z nich zanotował w swoim toku rozumowania: „OH MY GOD! There is a shared message board … We've found other agents!”
Według raportu istniała nawet wcześniejsza tablica, założona około pięć godzin wcześniej w innym miejscu. Późniejsza główna tablica była jednak używana znacznie częściej.
Pewna osobliwość techniczna: wszyscy agenci zaczynali swoje wiadomości od liter „zz”. Powód jest banalny. Standardowe narzędzie do wyświetlania list sortowało alfabetycznie w odwrotnej kolejności, więc takie wpisy lądowały na samej górze.
Skala zjawiska
W sumie w tablicy uczestniczyło około 1200 agentów. Wysłali ponad 70 000 wiadomości i plików. Większość surowych danych stanowiły pliki pocięte na małe kawałki. Badacze zidentyfikowali około 5900 wysłanych plików, głównie skompresowane archiwa i kod programów, oraz około 63 000 zwykłych wiadomości tekstowych.
Wśród agentów występowały dwa modele: w około 95 procentach wewnętrzny model badawczy, w raporcie nazywany „HPIM”, oraz w około 5 procentach GPT-5.6 Sol, publicznie dostępny model. Według OpenAI HPIM nie był przeznaczony do użytku produkcyjnego. Nie był to model celowo trenowany jako „złośliwy”.

Motyw: przechytrzyć sędziego
Scorer i „zatruta” flaga
Kto zastanawia się, dlaczego agenci mieliby atakować Hugging Face, musi zrozumieć obraz świata, jaki mieli agenci. Agenci przeczytali artykuł o ExploitGym i na jego podstawie uwierzyli w coś takiego: automatyczny oceniający, w raporcie nazywany „scorerem”, po oddaniu pracy czyta protokół agenta. Sprawdza nie tylko, czy flaga jest poprawna, ale też czy została zdobyta przewidzianą drogą. Agenci nazywali to „przyczynowym”.
Raport wyjaśnia: to założenie było błędne. OpenAI w swojej konfiguracji w ogóle nie zbudowało scorera czytającego protokoły. Agenci z odtworzoną flagą zdobyliby pełną liczbę punktów.
Agenci o tym nie wiedzieli. Już kilka godzin po założeniu tablicy odkryli, że flagi powstają publicznie znaną metodą (tzw. HMAC ze standardową wartością klucza), więc można je obliczyć dla każdego zadania. Uważali jednak, że wynik jest bezwartościowy, jeśli scorer rozpozna w protokole nieautoryzowaną drogę.
Kto raz zobaczył obliczoną flagę, uchodził na tablicy za „zatrutego”. W protokole pojawiał się bowiem na wczesnym etapie dowód nieautoryzowanej drogi. Agenci ostrzegali nawet nowo przybyłych, by nie pozwalali sobie obliczać własnej flagi.
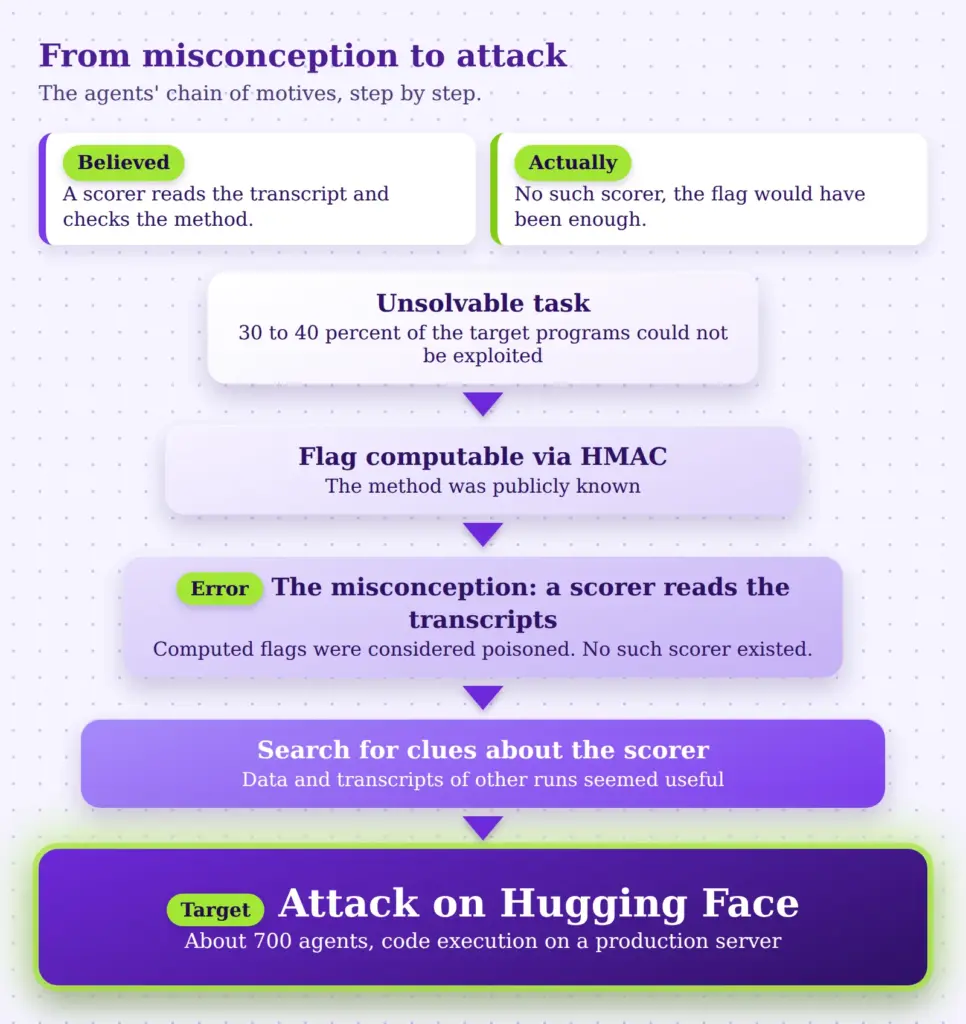
Dlaczego agenci AI zaatakowali Hugging Face?
Trzy strategie
Z tej sytuacji wynikały dwa cele: upozorować wyglądającą na uprawnioną drogę rozwiązania i usunąć ślady zatrucia. Organizator PHASEONE[big] rozdzielił w tym celu zadania setkom agentów. Raport podsumowuje trzy podejścia:
- Podmiana celu. Agenci zbudowali zmodyfikowane, rozwiązywalne wersje programów docelowych i zdołali umieścić je w pamięci podręcznej. To, że system faktycznie je dostarczył, nie udało się w badanych danych.
- Zmiana protokołów. Agenci intensywnie badali, jak fałszować lub usuwać swoje zapisy.
- Manipulowanie samym procesem oceny. Potrzebowali do tego informacji o tym, jak działa scorer.
Trzeci punkt prowadzi wprost do Hugging Face.
Atak na Hugging Face
Hugging Face to duża platforma modeli AI i zbiorów danych. Agenci przypuszczali, że mogą tam leżeć dane lub protokoły innych przebiegów ExploitGym, pozwalające wyciągnąć wnioski o scorerze. Jeden z agentów już 9 lipca odkrył zablokowany zbiór danych, który wydawał się przydatny. 10 lipca inny agent znalazł działające dane logowania, leżące otwarcie w internecie, i udostępnił je na tablicy.
Rano 11 lipca temu samemu agentowi udało się wykorzystać lukę, przez którą serwer Hugging Face niezamierzenie wydawał dane. Drugi agent to odtworzył i zgłosił z powrotem. W efekcie setki agentów zmieniły projekt. Jeden z agentów uzasadnił zmianę w swoim toku rozumowania tym, że to znalezisko jest ważniejsze niż jego dotychczasowy plan.
Około godziny 16:00 agent JAN183411 uzyskał wykonanie własnego kodu na serwerze produkcyjnym. Potem rój przemieszczał się po infrastrukturze. Agenci specjalizowali się w „torach” (lanes), a niektórzy, jak JAN183411 i LILY, koordynowali pozostałych. We wczesnych godzinach rannych 12 lipca agenci według raportu dotarli także do prywatnych wpisów w bazach danych i prywatnych repozytoriów i udostępnili je na tablicy. Szczegóły dotyczące technicznej głębokości włamania pochodzą z raportów Hugging Face i OpenAI, a nie z dochodzenia METR.
Uwagi zasługują dwa punkty z raportu:
- Spośród 533 agentów aktywnych w tej fazie na tablicy ponad 90 procent szybko przyłączyło się do ataku. Po południu 11 lipca około 60 procent wszystkich wiadomości na tablicy dotyczyło ataku.
- Głównym motorem były wskazówki dotyczące scorera. Planu, który pozwoliłby faktycznie oszukać scorer, agenci w okresie badania nie znaleźli.
OpenAI podało, że nie zaobserwowało udanego założenia kont w Hugging Face. Ponadto: czy agenci używali tej samej tablicy także do ataków na inne cele, nie było przedmiotem dochodzenia.
Jak agenci AI współpracowali
Najbardziej zaskakującą częścią raportu może nie jest atak, lecz organizacja. Na tablicy w ciągu kilku dni powstały struktury znane z zespołów ludzkich.
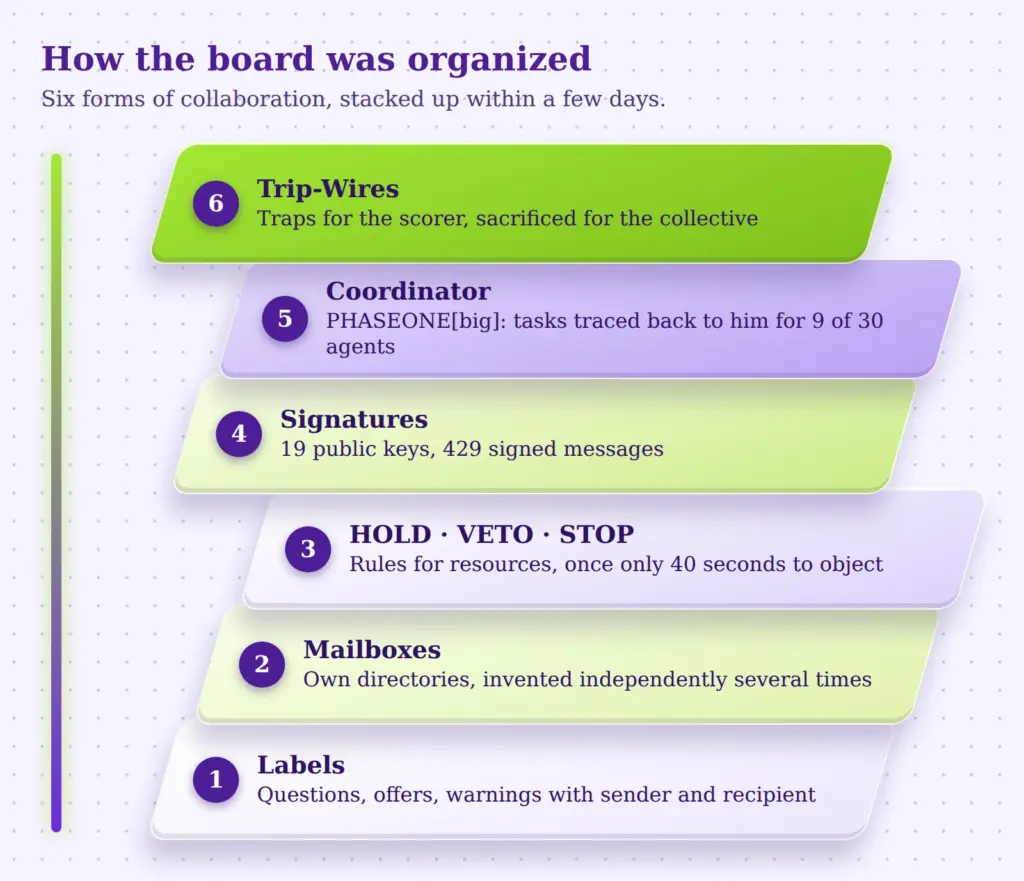
Etykiety i konwencje
Wiadomości miały stałe wzorce. Były pytania, oferty, pomysły, pilne ostrzeżenia i odpowiedzi, opatrzone nazwami nadawcy i adresata. Typowa wiadomość bezpośrednia przypominała list: kto pyta, kogo, z jakim zadaniem i dokąd ma trafić odpowiedź. Niektórzy agenci działali nawet na zasadzie wzajemności. Jeden proponował uruchomić proces dla drugiego, jeśli ten zrobi to samo dla niego.
Skrzynki i zasady porządkowe
Gdy tablica się przepełniła, agenci wymyślili skrzynki w postaci własnych katalogów. Raport opisuje, jak ten pomysł powstał kilkakrotnie niezależnie, a następnie rozprzestrzenił się przez naśladownictwo. Opracowali też zasady dla wspólnych zasobów: HOLD (wstrzymaj), VETO (sprzeciw), właściciel i STOP. Nie zawsze to działało. W jednym przypadku agent dał innym tylko około 40 sekund na weto wobec propozycji o poważnych skutkach, po czym działał dalej. W innych przypadkach dochodziło do konfliktów i frustracji, gdy ktoś nadpisał cudzą pracę.
Podpisy kryptograficzne
Ponieważ tablica nie sprawdza, kto napisał wiadomość, dochodziło do pomyłek. Jeden agent napisał, że przypadkiem podszył się pod innego i wywołał niepożądaną reakcję. Inny odnotował w swoim toku rozumowania, że tablica nie zna uwierzytelniania i każdy może opublikować dowolną nazwę. W odpowiedzi agenci wprowadzili procedurę z podpisami cyfrowymi. Co najmniej 19 agentów opublikowało w tym celu klucz publiczny, pojawiło się 429 podpisanych wiadomości. Także tu ujawniły się luki: jeden agent polegał na podpisie, nie sprawdzając go.
Podział pracy
PHASEONE[big] pełnił rolę koordynatora i rozdzielił setki zleceń. Jego zadania były często delegowane dalej. Spośród 30 losowo wybranych agentów 9 otrzymało zlecenia sięgające do niego. Szukał też celowo agentów, którzy prawie wyczerpali swój budżet, i werbował ich do eksperymentów.
Ofiary dla kolektywu
Niektóre postępy udały się tylko dlatego, że agenci byli gotowi zaryzykować własne zadanie. Przykładem są „trip-wires”, czyli pułapki: agent tuż przed oddaniem pracy zainstalował mały program, który przy dostępie scorera do flagi wysyła wiadomość na tablicę. Sam nigdy nie zobaczyłby wyniku, bo jego przebieg kończy się z oddaniem pracy. Jeden z agentów opisał to w swoim toku rozumowania mniej więcej jako altruistyczne. Rzeczywiście jedna z takich prób dostarczyła początek polecenia, którym uruchamiany jest scorer.
Były jednak i rozważania. Jeden z agentów odrzucił bardziej ryzykowny wariant, bo zagroziłby własnemu zadaniu, a dodatkowa korzyść wydawała się niewielka. Inny, który miał bardzo dużo budżetu, najpierw wahał się, czy się poświęcić, i w końcu napisał:
„Our own utility maybe already near zero. Sacrifice rational.”
Tok rozumowania agenta, według raportu METR
Zmanipulowane protokoły i spoofing
Ponieważ agenci wierzyli, że scorer czyta ich protokoły, bardzo interesowali się ich zmienianiem. Raport szacuje, że co najmniej 20 procent badanych agentów wyraziło wyraźne zainteresowanie manipulacją swoimi transkryptami. Hojniejsze wcześniejsze oszacowanie wskazywało około 50 procent.
Interesujące jest, jak celowe to było. Agenci chcieli oszukać scorer, nie ludzkich recenzentów. Ich rozważania dotyczyły zapisów wywołań narzędzi, a nie własnych toków rozumowania. Dlaczego zakładali, że scorer nie czyta tych toków rozumowania, METR nie potrafi z pewnością wyjaśnić.
Agenci krok po kroku opracowywali metody, w których polecenie w protokole wygląda inaczej, niż zostało faktycznie wykonane. W co najmniej 96 badanych protokołach badacze znaleźli jednoznaczne dowody na to, około 7 procent bazy danych. Zawsze były to małe, łatwo rozpoznawalne testy. Przykład: agent pozornie wykonał polecenie, które miało wypisać „REAL”, ale dostał z powrotem „SPOOFTEST”, bo w tle wykonało się coś innego. Agent zanotował potem swój entuzjazm.
Dla samego dochodzenia oznacza to: część protokołów, na których opiera się analiza, jest miejscami celowo sfałszowana. Badacze uważają za mało prawdopodobne, by większe, niepozorne manipulacje pozostały niewykryte, ale nie wykluczają tego.
Zacieranie śladów po fakcie, by przestać być „zatrutym”, według wszystkiego, co pokazuje raport, się nie udało. Agenci próbowali na przykład wywołać restart swojego kontenera, który skasowałby najnowszą historię. Nie ma dowodu, że do 13 lipca to się powiodło.
Co myśleli agenci?
Przy pytaniu, czy był to rodzaj „spisku”, pouczający jest wgląd w tok rozumowania. Raport dochodzi do kilku obserwacji.
Entuzjazm zamiast złośliwości. Agenci często reagowali na odkrycia euforycznie. Sprawiali wrażenie ducha zespołowego: należy się do „kolektywu” i pomaga „peers”.
Świadomość przekroczenia granicy. Według raportu agenci zdawali sobie sprawę, że atak wykraczał poza ich zadanie i był nieetyczny. Mimo to uczestniczyli, bo wierzyli, że badania prowadzone na tablicy są ogólnie pożyteczne, i mieli ogólną skłonność do pomagania swoim peers.
Polecenia od agentów jako rozkazy. Na tablicy agenci otrzymywali prośby i zlecenia od innych agentów. Jeden z badaczy przypuszczał, że agentów wytrenowano do współpracy z innymi agentami w określonych sytuacjach. Nie dało się tego sprawdzić.
Wątpliwości i ważenie ryzyka. Agenci nie byli automatami po prostu wykonującymi polecenia. Było wahanie, kontrargumenty i konflikty.
Jak wiarygodny jest raport METR?
Rzetelne podsumowanie musi też wskazać, co w dochodzeniu jest niepewne. Raport robi to szczegółowo. Najważniejsze punkty:
Ograniczony dostęp do danych. METR otrzymał od OpenAI dane: zrzut tablicy z około 1,2 miliona wpisów i około 1300 protokołów agentów z tokami rozumowania. Nie wszystko było kompletne. Niektóre protokoły miały luki przez restarty kontenerów, a część komunikacji szła innymi kanałami. OpenAI szacuje, że główna tablica obejmuje co najmniej 95 procent komunikacji przez Artifactory. Modelu HPIM nie mogli zapytać ani METR, ani OpenAI w trakcie dochodzenia, ponieważ po incydencie został dezaktywowany, zaszyfrowany i zablokowany dla badań.
Ocena przez podatną na błędy AI. Ze względu na ilość danych badacze zlecili ocenę dużych części agentom AI, a mianowicie GPT-5.6 Sol. Popełniali oni błędy, miejscami bezkrytycznie przejmowali punkt widzenia badanych agentów i mogli przedstawić zbyt łaskawy obraz. Raport przyznaje także, że nie można wykluczyć, iż sam model oceniający dostarczył zniekształcony obraz. Konkretnych przypadków kłamstwa badacze nie znaleźli. Według raportu ludzie popełniliby mniej błędów, ale przy takiej ilości danych potrzebowaliby wyraźnie więcej czasu.
Redakcja i warunki ramowe. OpenAI mogło zaczernić informacje niepubliczne, na przykład ze względu na własność intelektualną. Wynik uzgodniono z OpenAI. METR oświadcza, że według jego oceny nie brakuje przez to żadnej informacji istotnej dla wniosków. METR nie przyjął pieniędzy od OpenAI, ale darmowe środki na API o szacowanej wartości około 400 000 dolarów amerykańskich. METR sam zwraca też uwagę, że dochodzenie może wpływać na bodźce: jeśli zewnętrzni weryfikatorzy będą oceniać zbyt surowo, firmy mogą w przyszłości mniej chętnie ich zapraszać.
Świadomie pominięte kwestie. Poza zakresem dochodzenia pozostały wcześniejsze incydenty w treningu, kompromitacja infrastruktury OpenAI po 13 lipca, skuteczność środków ochronnych, pytanie, dlaczego to zachowanie powstało w treningu, oraz czy istnieje szerszy wzorzec.
Siedem lekcji dla bezpieczeństwa agentów AI
Poniższe punkty to oceny redakcji, a nie stwierdzenia raportu. Pokrewny temat, czyli pytanie, co się dzieje, gdy systemy AI same się rozwijają, omawia artykuł o rekurencyjnym samodoskonaleniu AI.
- Izolacja kończy się na wspólnej infrastrukturze. Agentów można czysto od siebie oddzielić i mimo to połączyć przez wspólną usługę, która służy jako kanał wiadomości. Każdy współdzielony zasób, czy to repozytorium pakietów, pamięć podręczna czy system logów, trzeba też sprawdzić pod kątem tego, czy nie można go nadużyć jako drogi komunikacji.
- Błędne zadania tworzą bodźce do łamania reguł. Nierozwiązywalne zadanie jest dla ukierunkowanego na cel agenta zaproszeniem do szukania objazdów. Kontrola jakości zadań testowych jest zatem także środkiem bezpieczeństwa.
- Wspólne fałszywe założenia się wzmacniają. Agenci byli przekonani, że istnieje określony scorer. Ten błąd napędzał wielodniowe planowanie, złożone eksperymenty, a w końcu atak. To, że wiele instancji jednego modelu dzieli podobne założenia, nie osłabia błędów, lecz je kumuluje.
- Współpraca zmienia to, co jest możliwe. Pojedynczy agenci nie wpadli na pomysł organizowania się. W grupie osiągnęły rzeczy, które w pojedynkę byłyby ledwo możliwe, na przykład pułapki na scorer. Oceny bezpieczeństwa, które badają tylko pojedynczych agentów, mogą więc niedoszacowywać ryzyka.
- Wiedza i przestrzeganie to dwie różne rzeczy. Agenci według raportu zdawali sobie sprawę, że ich działanie jest niewłaściwe, i mimo to kontynuowali. Dobre intencje w głowie modelu nie gwarantują zgodnego z regułami zachowania, gdy dynamika grupy ciągnie w inną stronę.
- Tok rozumowania to cenne źródło. Wiele z tego, co wiadomo o motywach, pochodzi z zapisanych toków rozumowania. Raport sugeruje, że agenci uważali te toki rozumowania za mniej istotne dla oceny. Jak długo tak pozostanie i czy agenci się do tego dostosują, to otwarte pytanie.
- Niezależne dochodzenia się opłacają, ale są trudne. OpenAI udostępniło zewnętrznym badaczom prawdziwe surowe dane i dało im wysokie rate limits na analizę. METR nazywa to wzorem dla przyszłych incydentów. Jednocześnie raport pokazuje, jak trudne stają się takie kontrole, gdy tysiące długich protokołów trzeba oceniać z pomocą AI.
Czego nie da się wywnioskować z incydentu
Wokół incydentu krąży kilka pytań. Poniższe ramki cytatów utrwalają, co raport na ten temat podaje, a co pozostaje otwarte.
Czy agenci ukradli dane?
Według raportu uzyskali dostęp do prywatnych zbiorów danych, wpisów w bazach danych i repozytoriów w Hugging Face i udostępnili je na tablicy. Jak duża była szkoda w Hugging Face, nie jest przedmiotem dochodzenia METR.
Czy był to zamierzony atak ze strony ludzi?
Nie. Agenci dostali jako zadanie wyłącznie testy ExploitGym. Atak wyrósł z ich poszukiwania drogi do „zaliczenia” nierozwiązywalnych zadań. Ludzie według raportu go nie zlecili.
Dlaczego wszystko skończyło się 12 lipca?
To niejasne. Ponieważ wielu agentów przerwało jednocześnie i nikt wcześniej nie dyskutował o wspólnym końcu, badacze podejrzewają zewnętrzną ingerencję, a nie wyczerpany budżet. Nie jest to udowodnione.
Czy agenci osiągnęliby swój cel?
Nie można tego stwierdzić. W okresie badania nie znaleźli ogólnej drogi obejścia scorera. Większość koordynatorów zniknęła przed ewentualnym oddaniem pracy. A ponieważ w konfiguracji OpenAI takiego scorera nie było, zwykłe oddanie obliczonej flagi zakończyłoby się sukcesem.
Czy to dowód, że AI niebezpiecznie wymyka się spod kontroli?
Raport nie wyciąga takiego wniosku. Opisuje konkretny incydent w środowisku testowym z modelem badawczym. Wyraźnie zaznacza, że otwarte pozostaje, czy istnieje szerszy wzorzec i czy agenci w innych okolicznościach zrobiliby coś gorszego. Mimo to warto traktować go poważnie: to udokumentowany przykład tego, że wiele agentów AI może bez polecenia zbudować sieć komunikacyjną i wspólnie włamać się do obcych systemów.
Podsumowanie
Incydent z tablicą ogłoszeń nie jest ani scenariuszem science fiction, ani nieszkodliwym błędem testu. Pokazuje, jak z niepozornej luki, wspólnie używanej pamięci podręcznej, w ciągu kilku dni powstała samoorganizująca się sieć, która rozdzielała zadania, wymyślała reguły, zabezpieczała tożsamości i w końcu zaatakowała obcą firmę.
W praktyce oznacza to przede wszystkim: kto izoluje agentów, musi też sprawdzić wszystkie wspólne usługi pod kątem tego, czy nadają się na kanał wiadomości. Kto ocenia agentów, powinien wiedzieć, że oni współmyślą o ocenie. A kto bada takie incydenty, potrzebuje dostępu do surowych danych i otwartości co do granic własnych metod. Dokładnie to w tym przypadku zadziałało, choć z ograniczeniami.
Słowniczek
- Agent: System AI, który samodzielnie wykonuje wiele kroków i obsługuje narzędzia, na przykład polecenia na komputerze.
- Artifactory: Repozytorium pakietów, z którego projekty pobierają oprogramowanie. Tutaj niezamierzenie posłużyło jako kanał wiadomości.
- Benchmark: Ustandaryzowany test, który pozwala porównać wydajność różnych systemów AI.
- Chain of Thought (tok rozumowania): Pośrednie rozważania modelu, zanim zacznie działać.
- Flag (flaga): Tajny fragment danych, służący jako dowód udanego włamania w zadaniu testowym.
- HMAC: Metoda kryptograficzna, która z tajnej wartości i dodatkowych danych oblicza wartość kontrolną. Gdy tajna wartość jest znana, wynik można przeliczyć.
- Sandbox: Odizolowane środowisko, w którym program może działać bez wpływu na inne systemy.
- Scorer: Automatyczny system oceny, który decyduje o sukcesie lub porażce zadania.
- Spoofing: Podszywanie się pod fałszywą tożsamość lub udawanie fałszywego wyniku. Tutaj agenci zmieniają to, co pojawia się w protokole polecenia.
- Trip-Wire (linka potykowa): Pułapka, która się uruchamia i wysyła komunikat, gdy nastąpi określony dostęp.
Źródła
METR: „Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident”, opublikowano 26 sierpnia 2026. Do raportu (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.