Jedenaście dni, rój agentów, 13 milionów wierszy kodu: sztuczna inteligencja sprawiła, że dowód wielkiego twierdzenia Fermata można sprawdzić maszynowo. Decydująca była nie tyle moc obliczeniowa, ile weryfikator, który nie przepuszcza żadnego błędu.
Około 1637 roku Pierre de Fermat zapisał na marginesie książki twierdzenie, do którego rzekomo miał dowód. Nigdy go nie znaleziono. Dopiero w 1995 roku Andrew Wiles opublikował pełny dowód. 4 września 2026 roku Anthropic poinformował, że rój agentów Claude w pełni sformalizował ten dowód w języku dowodzenia Lean. Umożliwił to asystent dowodzenia Lean, który maszynowo sprawdza każdy krok dowodu.
Ten artykuł porządkuje tę wiadomość. Wyjaśnia, czym jest asystent dowodzenia i dlaczego wynik z Lean uchodzi za wiarygodny. Opisuje, jak współpracowali agenci, i stawia komunikat w jednym szeregu z zadaniami olimpijskimi i problemami Erdősa. Oddziela przy tym liczby udokumentowane, deklaracje producenta i pytania otwarte. Teza: nowe nie jest samo to, że AI zajmuje się matematyką. Nowe jest połączenie modelu, który może swobodnie próbować, z programem, który nieprzekupnie akceptuje każdy krok.
Wielkie twierdzenie Fermata: co naprawdę zgłosił Anthropic
Twierdzenie mówi, że równanie aⁿ + bⁿ = cⁿ nie ma rozwiązań w liczbach całkowitych większych od zera dla wykładnika n większego niż 2. Teza jest łatwa do zrozumienia, a przez stulecia była niezwykle trudna do udowodnienia. W 1908 roku wyznaczono nagrodę w wysokości 100 000 marek w złocie, a według Anthropic w pierwszym roku nadesłano 621 błędnych dowodów. Wiles przedstawił dowód w 1993 roku, znalazł w nim lukę i zamknął ją wspólnie z Richardem Taylorem. Publikacja ukazała się w maju 1995 roku.
Najnowszy komunikat dotyczy pytania, jak pewny jest ten dowód, jeśli każdy krok sprawdza maszyna. Kluczowe informacje z publikacji Anthropic zebrano w tabeli.
| Cecha | Informacja według Anthropic |
|---|---|
| Wynik | Sprawdzony komputerowo dowód twierdzenia Fermata w Lean |
| Czas | 11 dni, w dużej mierze autonomicznie |
| Rozmiar | 13 milionów wierszy kodu Lean, ponad pięć razy więcej niż Mathlib |
| Twierdzenia | 29 500 twierdzeń pośrednich w dowodzie końcowym, łącznie 30 300 udowodnionych twierdzeń |
| Aksjomaty | Tylko trzy standardowe aksjomaty Lean |
| Agenci | Kilkadziesiąt agentów Claude równolegle |
| Nakład obliczeń | Około sześciu miliardów tokenów wyjściowych wewnętrznego, niepublicznego modelu badawczego |
| Udział człowieka | Sporadyczne polecenia na wysokim poziomie od Tianyi Penga |
| Kod | Pełny dowód publicznie na GitHubie |
| Weryfikacja | Narzędzie Comparator potwierdziło treść twierdzenia, Kevin Buzzard sprawdził dowód |
Token to mały fragment tekstu generowany przez model językowy, na przykład część słowa. Źródło nie podaje kosztów w pieniądzach. Wszystkie dane pochodzą od producenta i w tej formie nie zostały niezależnie przeliczone.
Ważne jest rozgraniczenie. Chodzi o formalizację, a nie o nowy dowód. Twierdzenie było udowodnione od 1995 roku. Agenci oparli się według Anthropic na uproszczonej wersji dowodu Wilesa autorstwa Darmona, Diamonda i Taylora oraz przejęli części z projektu formalizacji w Imperial College i z projektu flt-regular. Kto czyta o rozwiązaniu twierdzenia Fermata przez AI, nie powinien więc myśleć o nowym odkryciu matematycznym, lecz o weryfikacji. Anthropic wyraźnie odróżnia ten wynik od pracy AI nad hipotezą Riemanna, w której miało zostać odkryte coś nowego.
Czy AI udowodniła wielkie twierdzenie Fermata na nowo?
Czym jest Lean? Asystent dowodzenia, który nie pomija żadnego kroku
Asystent dowodzenia Lean to otwartoźródłowy język programowania, w którym dowody matematyczne można zapisać tak, aby komputer mógł je sprawdzić. Strona projektu lean-lang.org opisuje Lean jako język programowania i asystenta dowodzenia z minimalnym, godnym zaufania jądrem, które zapewnia poprawność. Lean opracował Leonardo de Moura, a w 2013 roku udostępniono go jako open source, jak podaje Simons Foundation. Od 2023 roku rozwojem zajmuje się non-profitowa Lean FRO, wspierana między innymi kwotą 5 milionów dolarów od Simons Foundation International.
Zasadę można ująć prostymi słowami. Dowód w Lean jest programem. Jądro Lean sprawdza krok po kroku, czy każdy wniosek wynika z aksjomatów i z już sprawdzonych twierdzeń. Aksjomaty to podstawowe założenia matematyki, które obowiązują bez dowodu. Krok, który nie wynika, zostaje odrzucony, choćby brzmiał najbardziej przekonująco. Tam, gdzie brakuje jeszcze dowodu, w Lean stoi symbol zastępczy „sorry”. Dowód z takimi symbolami uchodzi za niekompletny.
Właśnie to czyni Lean tak użytecznym dla modeli AI. Modele językowe potrafią formułować przekonująco i przy tym popełniać błędy. W matematyce to problem, bo błąd w kroku 400 może unieważnić wszystko, co po nim. Z asystentem dowodzenia takim jak Lean znika pytanie, czy modelowi można wierzyć.
Model może zgadywać, ponosić porażki i zaczynać od nowa. Do wyniku trafia tylko to, co zaakceptuje weryfikator.
Ocena ludzka działa inaczej. Specjaliści czytają dowód, uznają go za wiarygodny i polegają na swoim doświadczeniu. To cenne, ale kosztuje czas i zostawia miejsce na przeoczenia. Już w 2021 roku wspólny projekt zwalidował w Lean złożony dowód Petera Scholzego, jak opisuje Simons Foundation. Sprawdzenie przez asystenta dowodzenia nie zastępuje zrozumienia matematycznego, ale daje pewność co do poprawności.
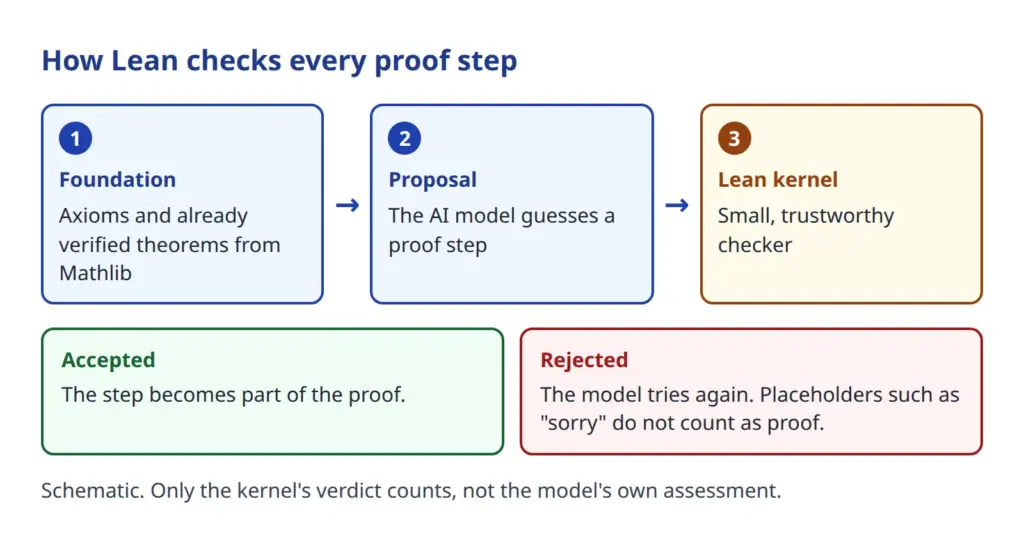
Przebieg na rysunku 1 pokazuje podział pracy: model składa propozycje, jądro Lean orzeka. To, czy propozycja pochodzi od człowieka, modelu czy generatora liczb losowych, nie ma dla wyroku znaczenia.
Mathlib i pytanie, kto sprawdza to, co sprawdzono
Sam Lean nie zawiera jeszcze matematyki. Ta mieści się w Mathlib, tworzonej wspólnie bibliotece, na której opiera się niemal każda formalizacja. Strona Lean podaje ponad milion wierszy. Strona ze statystykami społeczności wykazywała w chwili odczytu 139 391 definicji, 290 502 twierdzenia i 772 współtwórców. Kto dowodzi czegoś w Lean, może sięgnąć po te sprawdzone elementy zamiast zaczynać od zera.
Dla porównania: dowód Fermata ma według Anthropic około 13 milionów wierszy i jest tym samym ponad pięć razy większy niż Mathlib. Brzmi to jak gigantyczna nowa budowla, ale pokazuje też, ile kosztuje formalna weryfikacja głębokich twierdzeń, nawet gdy Mathlib dostarcza fundamentu. Dowód zależy od tego, co zostało już sformalizowane w Mathlib.
Należy postawić dwa osobne pytania kontrolne. Po pierwsze: czy dowód jest poprawny? Na to odpowiada Lean. Anthropic podaje, że użyto tylko trzech standardowych aksjomatów. Po drugie: czy rzeczywiście udowodniono twierdzenie Fermata, a nie zmienione stwierdzenie? Tu użyto narzędzia Comparator, które potwierdziło, że sformalizowane stwierdzenie zgadza się ze sformułowaniem w Mathlib. To rozdzielenie jest kluczowe. Bezbłędny dowód fałszywego stwierdzenia byłby bezwartościowy.
Pełny dowód wraz z pisemnym objaśnieniem jest według Anthropic na GitHubie i można go tam przejrzeć. Niepubliczny jest tylko użyty model.
Kevin Buzzard z Imperial College London, który od 2024 roku kieruje projektem formalizacji, sprawdził dowód. Według Anthropic stwierdza, że twierdzenie zostało udowodnione bez założeń poza aksjomatami matematyki. Pozostaje jedno ograniczenie: Lean sprawdza poprawność, nie znaczenie. Czy wynik jest interesujący, elegancki lub ważny, narzędzie nie ocenia. Odpowiednie oceny Aleksa Kontorovicha przytacza Simons Foundation.
Agentowa AI: dlaczego rój zadziałał
Równolegle pracowało kilkudziesięciu agentów. Agent to w tym kontekście model językowy, który nie tylko odpowiada, lecz samodzielnie korzysta z narzędzi, edytuje pliki i sprawdza wyniki pośrednie. Wieloagentowy szkielet oparto na Claude Code. Agenci definiowali pojęcia, dowodzili twierdzeń pośrednich i wykorzystywali je do trudniejszych stwierdzeń. Ogólne wprowadzenie oferuje artykuł Das Zeitalter der KI-Agenten.
Przełom przyniósł według Anthropic nie silniejszy model, lecz lepsza organizacja. Platforma Prove2Me, otwarta platforma współpracy Tianyi Penga oraz koleżanek i kolegów z Columbia University, zapewniła trzy cechy:
- Skierowany graf acykliczny stwierdzeń twierdzeń dawał orientację: każde stwierdzenie pokazuje, od czego zależy, i nie ma cykli.
- Stwierdzenia i dowody leżały w osobnych plikach. Przyspiesza to kompilację Lean, bo przy każdej zmianie nie trzeba sprawdzać wszystkiego od nowa.
- Udowodnione już twierdzenia można było wyszukiwać i ponownie wykorzystywać za pomocą opisów w języku naturalnym.
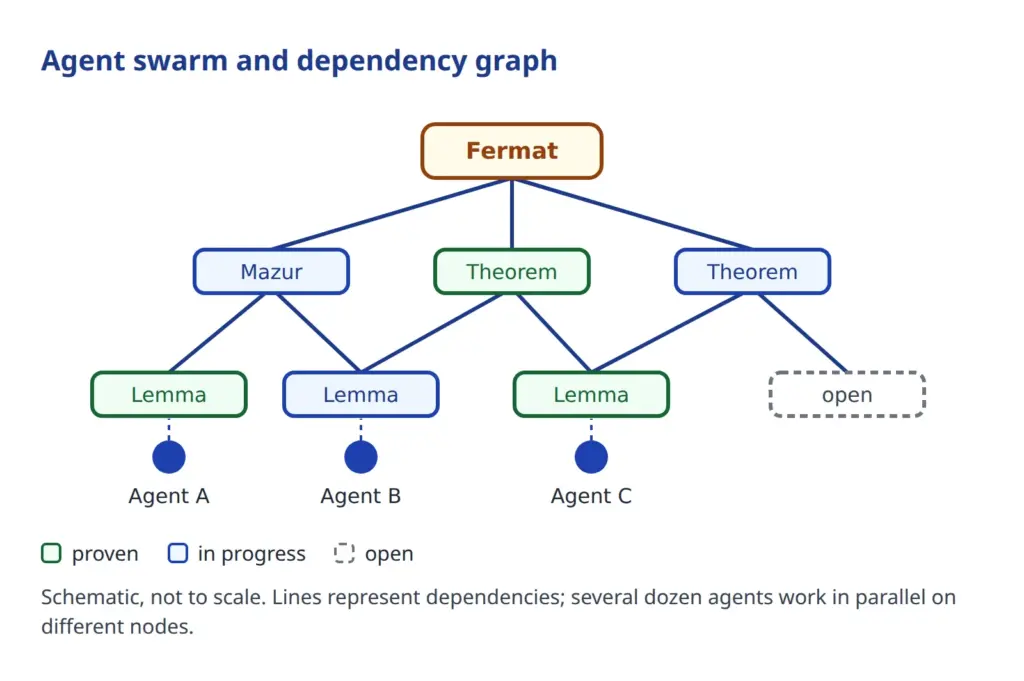
Wcześniejsze próby bez tej struktury kończyły się tym, że agenci gubili stan projektu. Pouczające jest, że mimo to próby te wniosły około 7 procent nietrywialnych wierszy dowodu końcowego. Wniosek: w dużych zadaniach struktura wygrywa z surową siłą modelu. Kto używa wielu agentów, potrzebuje wspólnego planu, współdzielonego repozytorium i jasnych odpowiedzialności. To samo doświadczenie mają programiści w każdym większym projekcie z agentami.
Udział człowieka był niewielki, ale nie zerowy. Tianyi Peng od czasu do czasu wydawał polecenia na wyższym poziomie, na przykład aby traktować jakobian jako schemat priorytetowo albo szybko zamknąć twierdzenie Mazura. Według cytowanego wyniku agenta system zgłosił wynik korzeniowy jako udowodniony 18 sierpnia o 02:00:57 UTC.
Od olimpiady do problemów Erdősa: dowody AI od 2024 roku
Komunikat o Fermacie nie stoi osamotniony. Od 2024 roku kilka wyników pokazuje, że AI potrafi dowodzić matematyki, a różnią się one tym, czy użyto Lean.
W lipcu 2024 roku AlphaProof wraz z AlphaGeometry 2 rozwiązał cztery z sześciu zadań Międzynarodowej Olimpiady Matematycznej i zdobył 28 z 42 punktów, czyli poziom srebrnego medalu. Granica złota wynosiła 29 punktów. AlphaProof dowodzi w Lean i rozwiązał między innymi najtrudniejsze zadanie konkursu. Zadania wcześniej jednak ręcznie przetłumaczono na język formalny, a czas obliczeń wynosił do trzech dni na zadanie. Uczestnicy mają dwa razy po 4,5 godziny.
W lipcu 2025 roku Gemini Deep Think uzyskał 35 z 42 punktów, czyli poziom złotego medalu, oficjalnie oceniony przez koordynatorów olimpiady. System pracował w języku naturalnym w granicach limitu czasu i bez Lean. To świadomy kontrast: także bez formalnej weryfikacji AI staje się silna, ale wyniki nie są wtedy zweryfikowane maszynowo, tylko muszą je czytać ludzie. Firma Harmonic opisuje w publikacji na arXiv swój system Aristotle, który łączy wyszukiwanie dowodów w Lean z nieformalnym wnioskowaniem i solverem geometrii i według abstraktu osiąga wynik na poziomie złota w zadaniach z 2025 roku.
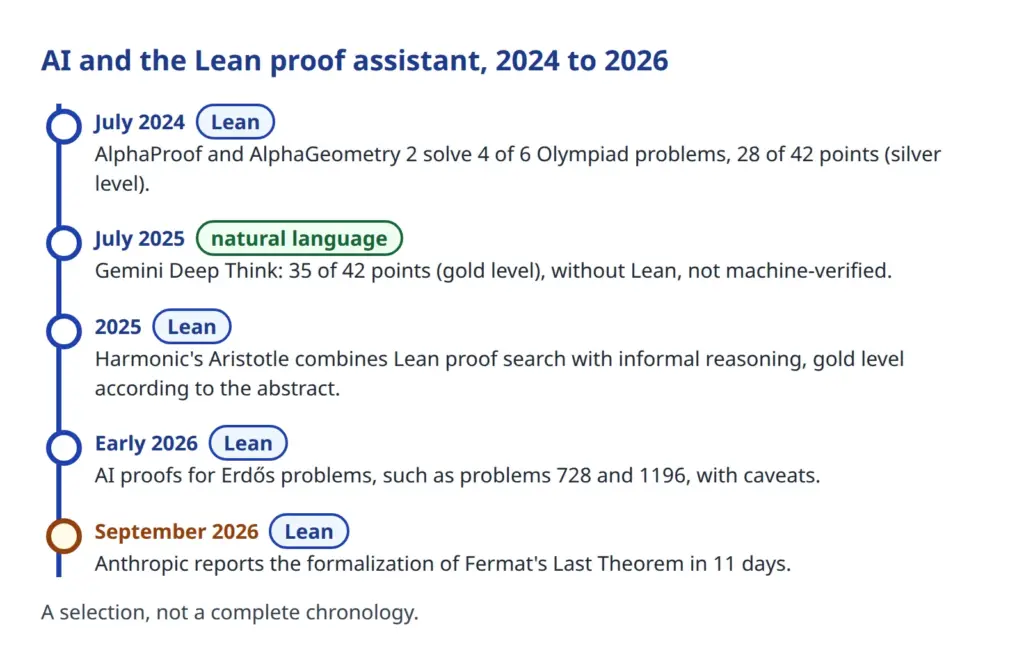
Na początku 2026 roku w centrum uwagi znalazły się problemy Erdősa, duży zbiór otwartych pytań matematyka Paula Erdősa. Przykładem jest problem 728, którego dowód przez Aristotle w Lean jest udokumentowany jako opracowanie na arXiv. Według Simons Foundation 23-latek rozwiązał ponadto na początku 2026 roku problem 1196 za pomocą ChatGPT i Lean.
Ocena jest ostrożna. Wiki Terence'a Tao o wkładzie AI w problemy Erdősa wyraźnie nie uważa się za benchmark. Wskazuje na efekt selekcji, ponieważ sukcesy dokumentuje się chętniej niż porażki. Zwraca uwagę, że brak wcześniejszych postępów często świadczy o nieznajomości, a nie o trudności, że po fakcie często wychodziła na jaw istniejąca już literatura i że rozwiązany problem nie jest automatycznie pracą gotową do publikacji. Zarazem wiki zaleca formalne sprawdzanie dowodów AI w Lean.
Dziedzina dowodów AI w matematyce obejmuje zadania konkursowe, problemy poboczne i duże formalizacje. Rozwój postępuje szybko; czy każdy komunikat dotrzymuje tego, co obiecuje nagłówek, trzeba sprawdzać osobno. Do tego właśnie służy narzędzie weryfikacji takie jak Lean.
Ile warte jest 11 dni? Porównanie czasu bez przesady
Liczby zachęcają do wielkich porównań. Fermat sformułował twierdzenie w 1637 roku, Wiles udowodnił je w 1995, czyli po 358 latach. Projekt formalizacji w Imperial College wystartował w 2024 roku z blueprintem liczącym 86 stron i pierwotnie zaplanowano go na kilka lat. Formalizacja przez AI trwała 11 dni.
To zestawienie kuleje z kilku powodów:
- 11 dni to czas pracy roju agentów, a nie czas obliczeń pojedynczego modelu.
- Dowód był znany. AI nie musiała znaleźć nowego pomysłu, lecz przełożyć istniejącą strukturę dowodu na Lean.
- Istniały prace wstępne: Mathlib, materiały z projektu Imperial i z flt-regular oraz blueprint.
- Nakład około sześciu miliardów tokenów wyjściowych wewnętrznego modelu jest znaczny. Kosztów w pieniądzach nie podano.
Utożsamianie 11 dni pracy AI ze stuleciami ludzkiej pracy nad problemem jest więc jedynie porównaniem retorycznym. Prawdą jest: praca, którą wspólny projekt planował na lata, została w istocie ukończona w kilka dni.
Eksperyment poboczny kieruje wzrok na codzienność. Według Anthropic trzy osobiste subskrypcje Claude Max sformalizowały w trzy dni twierdzenie Winogradowa o trzech liczbach pierwszych. Autorzy uważają wspólną formalizację z subskrypcjami konsumenckimi za możliwą, jeśli szkielet jest właściwy. To ocena autorów, a nie wynik niezależnie udokumentowany.
Ograniczenia i otwarte kwestie: czego komunikat nie pokazuje
Anthropic sam wymienia ograniczenia. Dowód jest prawdopodobnie znacznie dłuższy, niż trzeba, bo Mathlib jest bardziej zwarty i lepiej sprawdzony. Zależy od tego, co w Mathlib zostało już sformalizowane. Użyty model jest wewnętrznym, niepublicznym modelem badawczym, więc wyniku nie da się powtórzyć z zewnątrz tymi samymi środkami.
Otwarte pozostają dalsze punkty:
- Nie powstała nowa matematyka. Formalizacja zwiększa pewność, nie wiedzę.
- Dowód w Lean nie jest automatycznie zrozumiały. 13 milionów wierszy nikt nie przeczyta od początku do końca.
- Lean nie mówi nic o znaczeniu twierdzenia, a tylko o jego poprawności.
- Jak niezależna jest weryfikacja poza oceną Buzzarda, z komunikatu nie wynika.
Lean sprawdza, czy dowód jest poprawny, a nie czy jest ważny.
Do dalszych pojedynczych doniesień, na przykład o postępach w hipotezie Riemanna lub o agentach autoformalizacji poszczególnych firm, w tym researchu nie ma źródeł pierwotnych, które dałoby się samodzielnie sprawdzić. Doniesienia te pozostają tu zatem bez liczb. Także oceny poszczególnych ekspertów są przejmowane tylko wtedy, gdy dostępna jest oryginalna wypowiedź.
Co podejście Lean oznacza poza matematyką
Wzorzec stojący za projektem Fermata daje się uogólnić: swobodne próbowanie z jednej strony, twarda akceptacja z drugiej. Pasuje wszędzie tam, gdzie wynik można sprawdzić maszynowo. Strona Lean wymienia jako zastosowania poza matematyką weryfikację ArkLib, biblioteki do SNARK-ów (zwięzłych dowodów kryptograficznych), oraz Cedar, języka autoryzacji AWS. W tworzeniu oprogramowania zasada jest znana: kompilator i przebieg testów również akceptują to, co napisał człowiek lub AI.
Dla obchodzenia się z wynikami AI wynika z tego prosta reguła. Im lepiej wynik daje się sprawdzić automatycznie, tym bezpieczniej model może pracować swobodnie. Przy tekstach, ocenach i rekomendacjach tej twardej akceptacji zwykle brakuje. Tam weryfikatorem pozostaje człowiek.
Ta sama logika obowiązuje w bezpieczeństwie i ochronie danych: wykazywalne właściwości liczą się bardziej niż same deklaracje. To, czy strona internetowa ładuje trackery lub ustawia nagłówki bezpieczeństwa, można zmierzyć automatycznie. Służy do tego Webseiten-Check Dr. DSGVO, a techniczne właściwości bezpieczeństwa można sprawdzić za pomocą Security-Checks. Żadne z nich nie jest formalnym dowodem w sensie Lean, ale oba kierują się tą samą myślą: mierzyć zamiast wierzyć.
Eksperymenty Dr. DSGVO
Za pomocą AI (prawdopodobnie) przeprowadzono i sformalizowano dowód matematyczny, że magiczne heksagony według określonej reguły konstrukcji istnieją dla dowolnego n (n = długość krawędzi sześciokąta w komórkach plastra miodu).
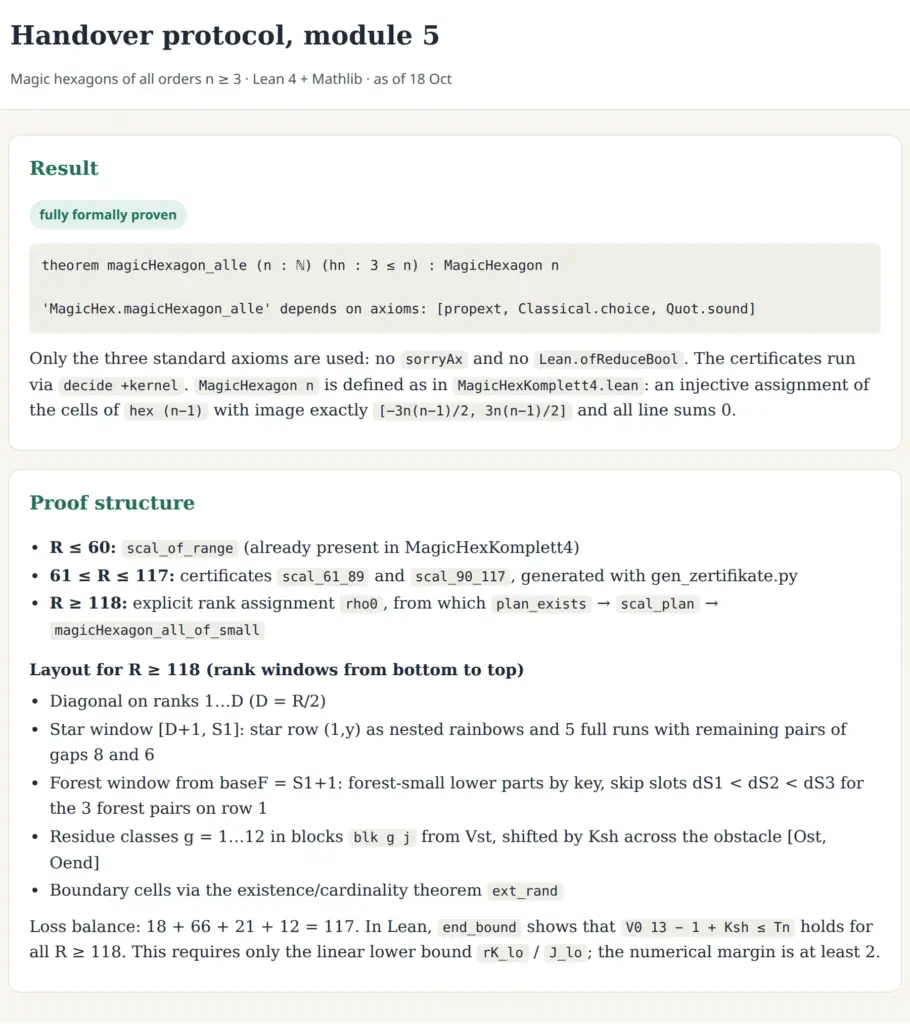
Całkowity czas obliczeń AI wyniósł niecałe 9 godzin. W 99,9% tego czasu system pracował niemal autonomicznie i nie potrzebował żadnych danych wejściowych. Rozmiar plików dowodu wyniósł 173 MB! Formalizacja w Lean wraz z bibliotekami zajęła w krokach pośrednich niecałe 8 GB miejsca na dysku! Cały dowód rozciągnął się na okres 5 dni. Został przerwany z powodu limitów użycia i tym podobnych.
Wkrótce dowód zostanie tu opublikowany. Czy jest poprawny, muszą ocenić kompetentne osoby, które znają się na matematyce lepiej niż autor korzystający z AI 😉
Podsumowanie: rewolucją jest weryfikowalność
AI nie udowodniła wielkiego twierdzenia Fermata na nowo, lecz w pełni sformalizowała dowód Wilesa w Lean, według Anthropic w 11 dni z kilkudziesięcioma równoległymi agentami. Sukces opiera się na dwóch rzeczach: organizacji, która utrzymuje stan projektu widocznym, oraz asystencie dowodzenia Lean, który akceptuje tylko to, co wynika.
Rozwój od 2024 roku pokazuje, że AI coraz częściej dostarcza dowody matematyczne. Ile w tym nowego, a ile znanego materiału, trzeba oceniać osobno w każdym przypadku, o czym przypomina także wiki Tao. Tam, gdzie występuje Lean, poprawność pozostaje sprawdzalna. To jest prawdziwy postęp: nie więcej deklaracji, lecz maszynowo sprawdzona pewność.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.