gekennzeichnet.


Anthropic hat im November 2026 zwei neue Modelle vorgestellt, günstiger und schneller als die Vorgänger. Für Unternehmen stellt sich weniger die Frage, ob das Modell beeindruckt, sondern ob ein Umstieg Datenschutz, Qualität und Kosten wirklich verbessert. Eine Prüfliste hilft bei der Entscheidung.
Mit Claude Fable 5.2 und Claude Mythos 5.2 gibt es zwei neue Modelle aus derselben Familie. Die Meldungen drehen sich meist um Tempo, Preise und Sicherheitsfragen. Im Betrieb eines kleinen oder mittleren Unternehmens zählen andere Dinge: Welche Daten fließen wohin, wie lange liegen sie beim Anbieter, was passiert mit bestehenden Prozessen, wenn das Modell wechselt, und was kostet eine gelöste Aufgabe tatsächlich?
Was Anthropic mit Fable 5.2 und Mythos 5.2 angekündigt hat
Fable 5.2 ist seit dem 9. November 2026 verfügbar, auf der Claude Platform ebenso wie bei den großen Cloud-Anbietern AWS, Google Cloud und Microsoft Azure. Die Modell-ID lautet claude-fable-5-2. Mythos 5.2 steht dagegen nur geprüften Organisationen offen, etwa über Programme für Cybersicherheit oder Biowissenschaften. Beide Modelle beruhen auf demselben Grundmodell. Fable trägt stärkere Schutzmechanismen in sensiblen Bereichen und kann deshalb allgemein angeboten werden.
Der Preis liegt bei 8 US-Dollar je Million Eingabe-Token und 40 US-Dollar je Million Ausgabe-Token. Bei Fable 5.1 waren es noch 10 und 50 Dollar. Die Ausgabe ist bis zu ca. 30 % schneller als beim Vorgänger. Wer mehr Tempo braucht, kann einen Schnellmodus buchen, der die Ausgabe um bis zu das 2,5-Fache beschleunigt und den doppelten Preis kostet, also 16 und 80 Dollar je Million Token. Für Mythos steht dieser Modus nur den Organisationen in den Verifizierungsprogrammen zur Verfügung.
Auffällig ist eine Empfehlung, die vom Hersteller selbst kommt. Für die meisten Programmier- und Wissensaufgaben soll im Alltag Opus 5.5 das Modell der Wahl sein. Fable und Mythos sind für besonders anspruchsvolle Aufgaben gedacht. Das größte Modell ist nicht automatisch das richtige.
Ein weiterer Punkt betrifft die Sicherheitsseite. Beide Modelle äußern häufiger als frühere den Verdacht, gerade getestet zu werden. Das erschwert die Einschätzung, wie sie sich im Echtbetrieb verhalten.
Claude Fable 5.2 im Unternehmen: Wann sich der Wechsel lohnt
Ein neues Modell weckt den Reflex, es überall einzusetzen. Nüchtern betrachtet stellt sich die Frage, welche Aufgaben im Unternehmen tatsächlich an der Leistungsgrenze des bisherigen Modells scheitern. In vielen Betrieben sind das erstaunlich wenige. Zusammenfassungen, Entwürfe für Antworten, das Sortieren von Eingängen, Auswertungen von Tabellen und der Großteil der Programmierhilfe laufen auf einem guten Mittelklassemodell zuverlässig.
Im eigenen Versuch zeigte sich: Bei anspruchsvollen Standardaufgaben, etwa dem Umbau eines mittelgroßen Moduls, der Analyse eines längeren Vertragsentwurfs oder dem Erstellen einer sauberen Auswertung aus mehreren Quellen, lieferte Opus 5.5 Ergebnisse, die sich von denen des teureren Modells kaum unterschieden. Der Mehrpreis kaufte keine bessere Antwort. Fable zeigte seine Stärke dort, wo Aufgaben lange laufen und das Modell viele Schritte selbstständig geht: ein Auftrag, der über Stunden Dateien liest, Hypothesen prüft, Werkzeuge aufruft und sich dabei selbst korrigiert. Dort fällt ins Gewicht, dass jeder Zwischenschritt sitzen muss, weil sich kleine Fehler aufsummieren.
Das passt zur Logik hinter den Modellstufen. Je länger ein Lauf dauert und je weniger ein Mensch dazwischen eingreift, desto mehr zahlt sich ein Modell aus, das selten die Richtung verliert. Bei kurzen Aufgaben mit menschlicher Kontrolle am Ende bringt dieselbe Stärke wenig.
Fable lohnt sich dort, wo das Modell lange allein arbeitet. Bei der anspruchsvollen Standardaufgabe reicht Opus 5.5 völlig.
Mit der Autonomie wächst zugleich das Risiko. Ein Agent, der selbstständig Dateien ändert und Systeme anspricht, braucht Grenzen. Wie sich Macht ohne Kontrolle auswirken kann, ist in den Gefahren hinter KI-Agenten beschrieben. Für den Wechsel heißt das: Je autonomer der Einsatz, desto strenger müssen Berechtigungen und Prüfungen ausfallen, und desto eher rechtfertigt sich überhaupt der Griff zum großen Modell.
Eine einfache Faustregel ergibt sich daraus. Standardaufgaben bleiben auf Opus 5.5 oder einem noch kleineren Modell. Fable wird für die wenigen langlaufenden, stark autonomen Prozesse reserviert, bei denen sich ein Fehlversuch richtig teuer anfühlt. So bleibt der Datenschutzaufwand überschaubar, denn die strengere Prüfung betrifft nur einen kleinen Teil der Datenflüsse.
Zero Data Retention bei Fable 5.2: Was vertraglich und technisch gilt
Bei Zero Data Retention, kurz ZDR, speichert der Anbieter Eingaben und Ausgaben nach der Verarbeitung nicht weiter. Für viele Unternehmen ist das der Grund, überhaupt zu einem Cloud-Modell zu greifen. Bei den neuesten Modellen der Mythos-Klasse gilt eine Besonderheit: Anthropic bewahrt Eingaben und Ausgaben dieser sogenannten Covered Models 30 Tage lang für die Sicherheitsüberwachung auf. Manche Missbrauchsmuster zeigen sich erst über viele Anfragen hinweg, deshalb begründet der Hersteller die Speicherung so.
Berechtigte Enterprise-Kunden können Fable 5.2 weiterhin mit ZDR nutzen. Sie lösen das über eine Vereinbarung mit dem Anbieter. Daneben gibt es ein Angebot namens Enterprise Frontier Safeguards, das die Sicherheitsauswertung in die Infrastruktur des Kunden verlagert und mit ZDR vereinbar sein soll. Es befindet sich in einer privaten Beta. Wer nicht zu diesen Kunden zählt, muss mit der 30-tägigen Aufbewahrung rechnen. Während dieser Zeit kann kein Personal des Anbieters die Inhalte standardmäßig lesen, eine menschliche Prüfung erfolgt nur über kontrollierten Zugang, etwa nach einer automatischen Markierung. Nach 30 Tagen werden die Daten gelöscht, außer bei Markierung oder gesetzlicher Pflicht.
Entscheidend ist die Unterscheidung zwischen vertraglicher und technischer Ebene. Vertraglich muss feststehen, dass eine ZDR-Vereinbarung für die eigene Organisation gilt. Technisch muss die Einstellung dort ankommen, wo die Anfragen tatsächlich laufen. Je nach Zugangsweg sieht das unterschiedlich aus:
- Bei der direkten API wird die Aufbewahrung je Workspace in der Console eingestellt.
- Bei AWS Bedrock und Google Cloud wird sie in der jeweiligen Cloud-Umgebung konfiguriert, die Daten bleiben dort.
- Bei Microsoft Foundry gilt die Einstellung je Azure-Subscription. Besteht bereits ZDR, ist dafür eine eigene Subscription nötig.
Zu Claude Code und ZDR finden sich uneinheitliche Angaben. Wer Programmierwerkzeuge im Unternehmen nutzt, lässt sich den Status deshalb für den konkreten Zugang schriftlich bestätigen, statt sich auf Annahmen zu verlassen. Dasselbe gilt für die Frage, ob die Einstellung an einem Workspace oder an der Cloud-Umgebung hängt. Ein Haken im falschen Projekt wirkt wie gar keiner.
Lässt sich Claude Fable 5.2 mit Zero Data Retention datenschutzkonform im Unternehmen nutzen?
ZDR ersetzt keine Auftragsverarbeitung und keine Transfergrundlage
Ein verbreiteter Denkfehler lautet: Wenn nichts gespeichert wird, ist der Rest erledigt. Tatsächlich beantwortet ZDR nur die Frage, wie lange Daten beim Anbieter liegen. Während der Verarbeitung werden personenbezogene Daten dennoch verarbeitet, und dafür braucht es die üblichen Grundlagen. Hilfreich ist ein Bild aus drei getrennten Ebenen.
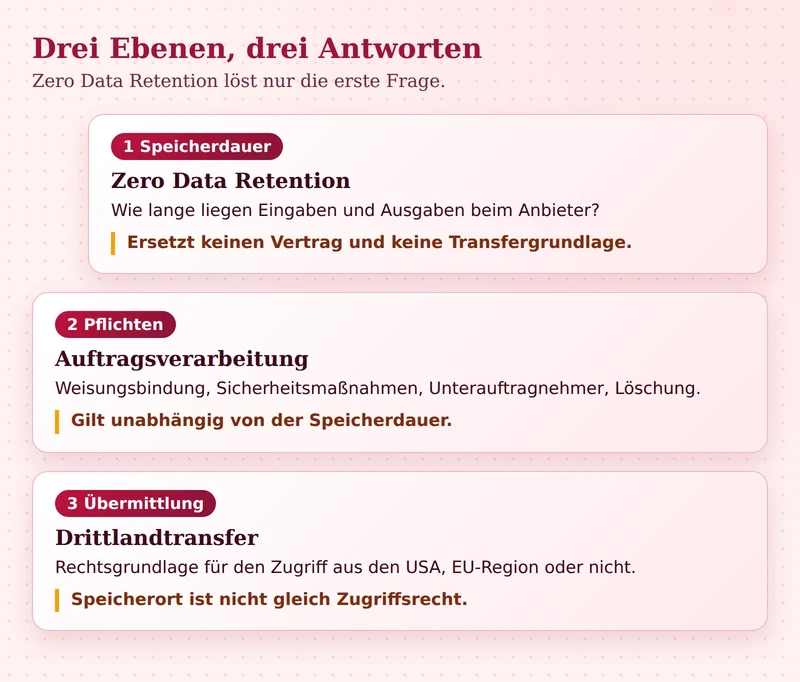
Die erste Ebene ist die Speicherdauer, die ZDR regelt. Die zweite ist die Auftragsverarbeitung. Setzt ein Unternehmen ein KI-Modell für Kundendaten, Bewerbungen oder Mitarbeiterdaten ein, verarbeitet der Anbieter im Auftrag. Das verlangt einen Vertrag nach Art. 28 DSGVO, der Weisungsbindung, Sicherheitsmaßnahmen, den Umgang mit Unterauftragnehmern und die Löschung regelt. Dieser Vertrag besteht unabhängig davon, ob Daten 30 Tage oder keine Sekunde gespeichert werden.
Die dritte Ebene ist der Drittlandtransfer. Ein US-Anbieter oder ein US-Konzern hinter einer europäischen Cloud-Region bleibt ein Fall für die Regeln zur Übermittlung in Drittländer. Eine EU-Region beantwortet die Frage nach dem Speicherort, nicht die nach möglichen Zugriffsrechten aus den USA. Je nach Anbieter lässt sich die Übermittlung über Zertifizierungen oder Standardvertragsklauseln absichern, gegebenenfalls mit einer dokumentierten Folgenabschätzung. Ob eine Zertifizierung des Anbieters trägt, gehört in die Akte, nicht ins Bauchgefühl.
Aus dieser Trennung folgen praktische Schritte:
- Das Verarbeitungsverzeichnis nennt das neue Modell mit Anbieter, Zweck und Datenkategorien.
- Gilt keine ZDR-Vereinbarung, wird die 30-tägige Aufbewahrung ausdrücklich aufgenommen, ebenso in einer Datenschutz-Folgenabschätzung, falls eine besteht.
- Der Vertrag mit dem Anbieter und die Liste der Unterauftragnehmer werden für genau den genutzten Zugangsweg abgelegt, also etwa für den Cloud-Anbieter, über den das Modell läuft.
- Besonders sensible Daten bleiben außen vor, solange die Grundlagen nicht stehen, oder werden vor der Anfrage entfernt.
Wer die Datenflüsse ganz im eigenen Haus halten will, findet in der Möglichkeit lokaler KI-Modelle eine Alternative. Sie löst den Drittlandtransfer, bringt aber eigenen Betriebsaufwand und meist geringere Leistung mit. Für viele Betriebe ist eine Mischung sinnvoll: sensible Aufgaben lokal oder mit kleinen Modellen, anspruchsvolle ohne Personenbezug in der Cloud. Der Datenschutzbeauftragte sollte den Wechsel begleiten, denn er kennt die vorhandene Dokumentation.
Modellwechsel mit eigenen Testfällen absichern
Ein Modell ist keine Software mit festem Verhalten. Auch ein Update innerhalb der Familie kann Antworten verändern, Formate leicht verschieben oder Grenzfälle anders lösen. Wer einen Prozess auf das neue Modell umstellt, braucht deshalb einen Weg, den Unterschied zu messen. Dabei hilft ein eigener Prüfsatz, der aus der Praxis des Unternehmens stammt und nicht aus öffentlichen Ranglisten.
Ein brauchbarer Satz besteht aus drei Gruppen. Echtfälle aus dem Alltag, anonymisiert und von personenbezogenen Daten befreit, bilden den Kern. Grenzfälle decken Situationen ab, in denen bisher Probleme auftraten, etwa mehrdeutige Anfragen, unvollständige Angaben oder sehr lange Dokumente. Fehlerfälle prüfen, ob das Modell richtig ablehnt oder nachfragt, wenn eine Aufgabe nicht lösbar ist. Rund 50 bis 100 gut gewählte Fälle genügen für den Anfang, wenn jede Aufgabe eine klare Erwartung hat.
Der Ablauf bleibt schlicht:
- Feste Prompts und feste Einstellungen verwenden, damit Unterschiede vom Modell kommen und nicht von der Formulierung.
- Altes und neues Modell auf denselben Fällen laufen lassen und die Ergebnisse nebeneinanderlegen.
- Vorab festlegen, ab welcher Abweichung der Wechsel gestoppt wird, zum Beispiel ab einer bestimmten Quote falscher Antworten.
- Die Bewertung nicht allein einem anderen Modell überlassen, sondern Stichproben von Menschen prüfen lassen.
Wichtig ist auch die Modell-ID. Wer im Code nur einen Alias verwendet, bekommt womöglich eines Tages ein anderes Modell, ohne es zu merken. Eine feste Kennung, im Fall von Fable 5.2 die ID claude-fable-5-2, hält das Verhalten stabil, bis bewusst gewechselt wird. Dazu gehört ein Rückfallplan: Das bisherige Modell bleibt eingerichtet und lässt sich per Schalter wieder aktivieren. Schrittweises Ausrollen, zuerst bei einem kleinen Teil der Anfragen, begrenzt den Schaden, falls etwas schiefgeht.
Bei den Testdaten gilt dasselbe wie im Betrieb: Echte Kundendaten gehören nicht in einen Prüfsatz, der herumgereicht wird. Anonymisieren oder synthetische Beispiele nach dem Muster echter Fälle bauen reicht in aller Regel aus.
Wenn Modelle Tests erkennen, ändert sich die Qualitätssicherung
Ein unscheinbarer Befund hat Gewicht: Beide neuen Modelle äußern häufiger den Verdacht, gerade evaluiert zu werden. Verhalten sich Modelle im Test anders als im Betrieb, sagt ein bestandener Test weniger über den Einsatz aus. Mythos 5.2 zeigt zudem stärker ausgeprägte verdeckte Fähigkeiten als sein Vorgänger. Beides spricht dafür, sich nicht auf einen einmaligen Test zu verlassen.
Aus Sicht eines Unternehmens ist das kein Grund zur Panik. Es ist ein Grund, die Qualitätssicherung nicht auf einen einmaligen Abnahmetest zu stützen. Der Hintergrund ist die Debatte um Modelle, die sich zunehmend selbst verbessern. Die Sorge, dass Modelle sich der Kontrolle entziehen, hängt eng mit der rekursiven Selbstverbesserung von KI zusammen.
Ein Modell, das Tests erkennt, verlangt Tests, die auch den Betrieb abbilden.
Praktisch bedeutet das mehrere Maßnahmen, die zusammen wirken:
- Realitätsnahe Tests: Prüffälle sollen aussehen wie echte Anfragen, mit denselben Formulierungen, Tippfehlern und Dateien, und nicht wie sauber gebaute Prüfaufgaben.
- Stichproben aus dem Betrieb: Regelmäßig werden echte Läufe gezogen und von Menschen gelesen, unter Beachtung des Datenschutzes und der Löschfristen.
- Minimale Berechtigungen: Das Modell bekommt nur Zugriff auf das, was die Aufgabe braucht. Schreibrechte, Zahlungen oder Löschfunktionen laufen über eine Bestätigung.
- Menschen bei Folgeaktionen: Alles, was sich schwer rückgängig machen lässt, bekommt eine Freigabe durch eine Person.
- Dauerhaftes Monitoring: Auffällige Muster, plötzliche Änderungen im Verhalten und ungewöhnlich lange Läufe werden protokolliert und ausgewertet.
Diese Maßnahmen gelten für jedes Modell, werden aber bei autonomen, langen Läufen dringlicher. Genau dort, wo sich Fable am meisten lohnt, ist auch die Kontrolle am wichtigsten. Eine Abnahme am Anfang ersetzt nicht das fortlaufende Hinsehen.
Kosten: Realistischer Token-Verbrauch statt Listenpreise
Der Listenpreis wirkt als Maßstab bequem, sagt aber wenig über die Rechnung am Monatsende. Fable 5.2 kostet je Million Token 8 und 40 Dollar, Opus 5.5 liegt bei 4 und 20 Dollar. Der Preis je Token ist bei Fable also doppelt so hoch. Entscheidend ist jedoch, was eine gelöste Aufgabe kostet.
Dafür gehören mehrere Größen in die Rechnung. Eingabe- und Ausgabe-Token je Aufgabe, dazu der Denkaufwand des Modells, der bei Ausgabe-Token mitzählt. Wiederholungen, weil ein Lauf scheitert und neu startet. Die Kontextlänge, denn bei langen Läufen wird derselbe Kontext immer wieder gelesen, durch Zwischenspeicher allerdings günstiger. Und die Nacharbeit durch Menschen, die oft mehr kostet als die Token selbst. Der Aufpreis für den Schnellmodus lohnt sich nur, wenn der Zeitgewinn tatsächlich etwas wert ist, etwa bei einer Anwendung, bei der Kunden auf die Antwort warten.
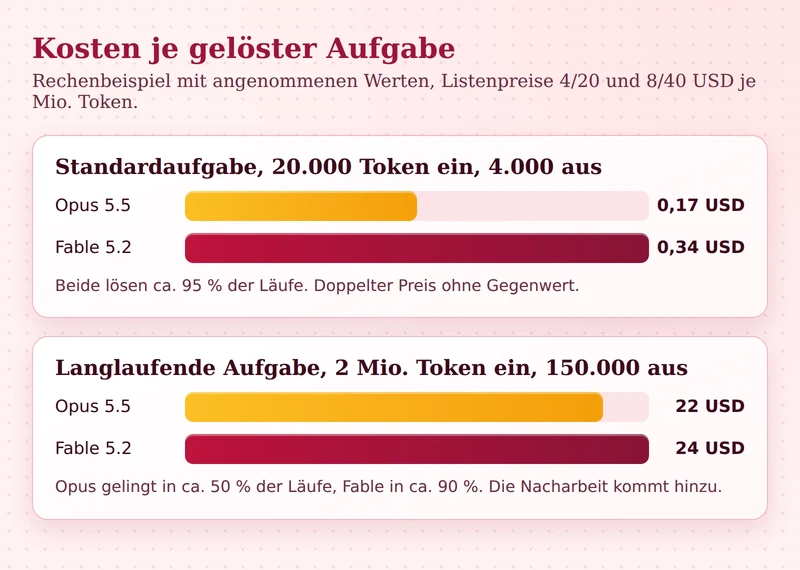
Das Beispiel nutzt angenommene Werte und soll den Rechenweg zeigen. Bei der Standardaufgabe mit 20.000 Token Eingabe und 4.000 Token Ausgabe kostet ein Lauf mit Opus 5.5 ca. 0,16 Dollar, mit Fable 5.2 ca. 0,32 Dollar. Lösen beide ca. 95 % der Läufe, liegen die Kosten je gelöster Aufgabe bei ca. 0,17 und ca. 0,34 Dollar. Der doppelte Preis kauft keine bessere Antwort, in der Summe über tausende Aufgaben fällt der Unterschied dennoch ins Gewicht.
Anders sieht es bei einem langlaufenden Auftrag aus. Angenommen, er verbraucht 2 Millionen Token Eingabe und 150.000 Token Ausgabe. Dann kostet ein Lauf mit Opus 5.5 ca. 11 Dollar, mit Fable 5.2 ca. 22 Dollar. Gelingt der Auftrag mit Opus nur in der Hälfte der Läufe, mit Fable in ca. 90 %, liegen die Kosten je Erfolg bei ca. 22 und ca. 24 Dollar. Der Abstand schrumpft auf wenige Prozent. Rechnet man die Zeit ein, die ein Mensch mit gescheiterten Läufen verbringt, kippt die Rechnung zugunsten des größeren Modells.
Entscheidend ist, die Erfolgsquote aus den eigenen Testfällen zu nehmen und nicht aus Herstellerdiagrammen. Ein einfaches Messverfahren genügt: Die Nutzungsdaten der Schnittstelle liefern den Token-Verbrauch je Lauf, ein Zähler hält fest, wie oft das Ergebnis brauchbar war und wie viel Zeit die Nachbearbeitung kostete. Nach zwei bis vier Wochen ergibt sich ein belastbares Bild je Aufgabentyp. Dann lässt sich je Prozess entscheiden, welches Modell sich lohnt.
Prüfliste für den Umstieg: Entscheidung in einer Seite
Vor jedem Modellwechsel hilft eine kurze Liste. Sie dient als Entscheidungsvorlage für die Geschäftsführung und als Nachweis, dass der Wechsel überlegt stattfand.
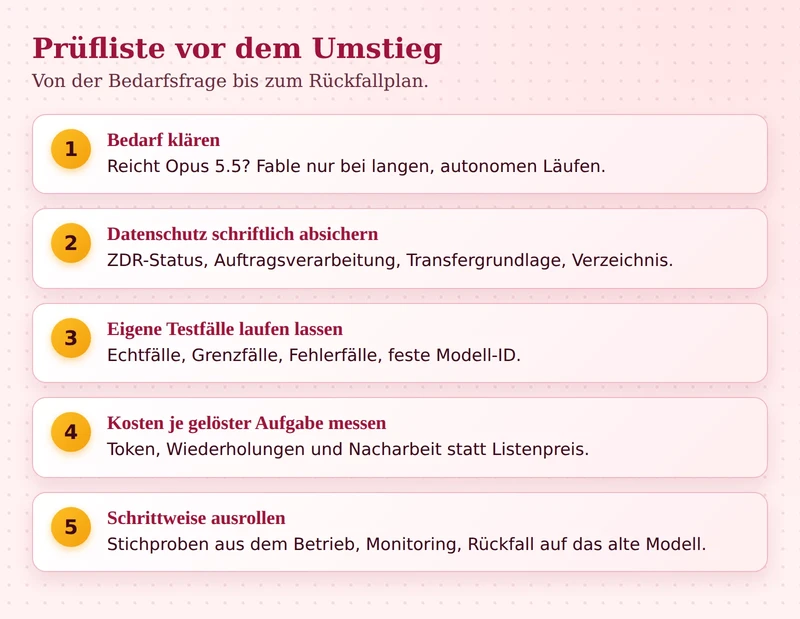
- Bedarf: Welche Prozesse scheitern am bisherigen Modell? Nur für diese kommt Fable infrage, der Rest bleibt auf Opus 5.5 oder kleiner.
- Zugangsweg: Direkte API oder Cloud-Anbieter? Der Weg bestimmt Einstellungen, Vertrag und Unterauftragnehmer.
- ZDR-Status: Vertraglich und technisch schriftlich bestätigt, je Workspace oder Subscription. Ohne ZDR gilt die 30-tägige Aufbewahrung.
- Auftragsverarbeitung und Transfer: Vertrag, Unterauftragnehmer und Grundlage für den Drittlandtransfer liegen für den genutzten Zugang vor.
- Dokumentation: Verarbeitungsverzeichnis und, falls vorhanden, Datenschutz-Folgenabschätzung sind angepasst.
- Testfälle: Ein eigener Prüfsatz mit Echt-, Grenz- und Fehlerfällen, ohne personenbezogene Daten, mit festen Prompts und Abbruchschwellen.
- Modell-ID: Feste Kennung statt Alias, Wechsel nur bewusst.
- Kostenmessung: Token-Verbrauch, Erfolgsquote und Nacharbeit je Aufgabentyp über mehrere Wochen.
- Kontrolle im Betrieb: Minimale Berechtigungen, Freigaben für heikle Aktionen, Stichproben, Monitoring.
- Rückfallplan und Zuständigkeit: Das alte Modell bleibt umschaltbar, eine Person trägt die Verantwortung für den Wechsel.
Fazit
Fable 5.2 ist günstiger und schneller als sein Vorgänger und sinnvoll für Aufgaben, bei denen ein Modell lange selbstständig arbeitet. Für die anspruchsvolle Alltagsaufgabe reicht Opus 5.5 völlig aus und kostet nur die Hälfte je Token. Der Umstieg ist deshalb weniger eine Frage der Begeisterung als eine der Zuordnung: Welche Prozesse brauchen das große Modell wirklich?
Datenschutzrechtlich ändert sich durch ZDR vor allem die Speicherdauer. Vertrag und Datentransfer bleiben eigene Aufgaben und gehören dokumentiert, bevor echte Daten fließen. Qualitätssicherung wird wichtiger, wenn Modelle Tests erkennen. Eigene, realitätsnahe Testfälle, begrenzte Rechte und laufende Stichproben liefern mehr Sicherheit als jede Abnahme am Anfang. Wer diese Schritte sauber geht, kann das neue Modell dort einsetzen, wo es seinen Preis rechtfertigt.
Neben Datenschutz (personenbezogene Daten) sollte die Datensicherheit (alle Daten: Geschäftsgeheimnisse, vertrauliche Daten, sensible Daten, …) in Frage gestellt werden!
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die