gekennzeichnet.


Google-Chef Sundar Pichai sagt, die Branche sei noch weit vom Endzustand der rekursiven Selbstverbesserung entfernt. Zugleich beschreibt er Schleifen, in denen KI-Agenten schon heute beim Bau neuer Modelle helfen. Stand heute lässt sich einordnen, was davon belegt und was es für den KI-Einsatz in kleinen und mittleren Unternehmen bedeutet.Ist die Menschheit gefährdet?
Anlass ist ein Interview, über das Big Technology am 23.10.2026 berichtet hat. Dort fällt ein Satz zur selbstverbessernden KI, der sich gut zitieren lässt: Die Branche sei noch weit vom Endzustand von RSI entfernt. RSI steht für Recursive Self-Improvement, also rekursive Selbstverbesserung. Gemeint ist ein Kreislauf, in dem KI-Systeme ihre Nachfolger verbessern, die wiederum bessere Nachfolger bauen.
Grundlagen zur Funktionsweise solcher Schleifen liefert der Beitrag zur rekursiven Selbstverbesserung von KI. Aussagen aus dem Interview, Selbstauskünfte von Herstellern, eine Forschungsarbeit und eine Insider-Prognose stehen im Folgenden getrennt nebeneinander.
Was Pichai gesagt hat und was nicht
Der Kern ist kurz. Nach dem Bericht von Alex Kantrowitz sagte Pichai: „To be very clear. We are pretty far from the end state of RSI.“ Das bdeutet so viel wie: „Ganz klar: Vom Endzustand der rekursiven Selbstverbesserung ist die Branche noch ziemlich weit entfernt.“ Kantrowitz stellt den Satz gegen die Erwartung mancher in der KI-Branche, eine Intelligenzexplosion stehe unmittelbar bevor und KI verbessere sich bald in einer vollständigen Schleife ohne menschliches Zutun.
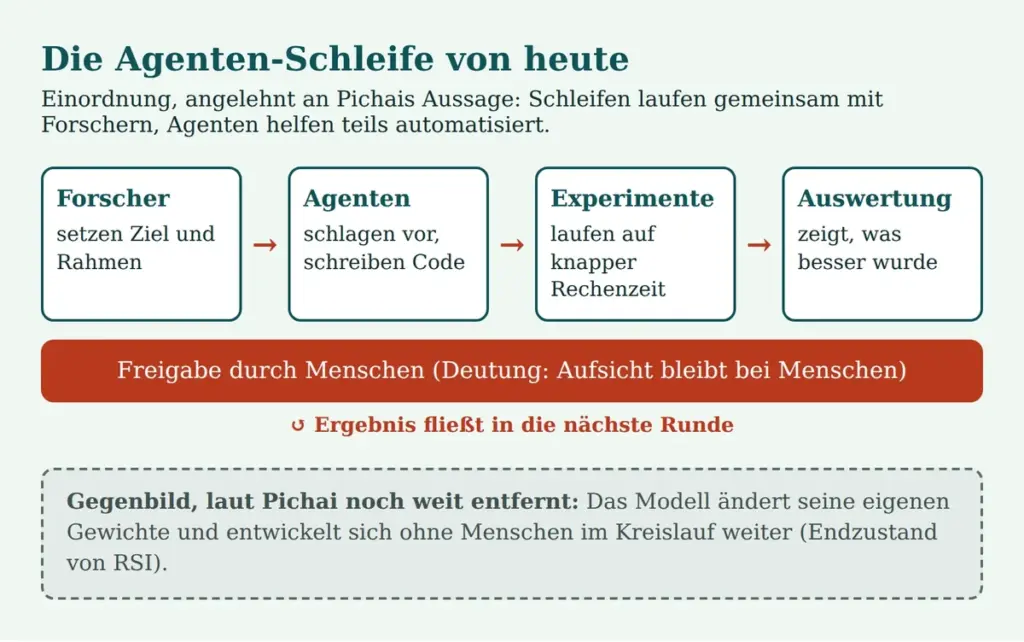
Direkt danach folgen zwei weitere Sätze, die für die Einordnung wichtiger sind als der erste. Pichai sagte: „You have RSI loops along with AI researchers in various aspects of model development.“ Und: „You almost have agents helping AI researchers in some automated way work together to build these models.“ Sinngemäß: In verschiedenen Bereichen der Modellentwicklung gibt es Rückkopplungsschleifen gemeinsam mit den Forschern, und Agenten helfen ihnen teilweise automatisiert beim Bau der Modelle.
Wörtlich belegt ist damit: Teilschleifen laufen bereits, und zwar zusammen mit den Forschern. Von einem Modell, das sich ohne Aufsicht selbst umbaut, ist in diesen Sätzen nicht die Rede. Der Satz vom Endzustand lässt sich so lesen, dass genau dieses Bild gemeint ist.
Als Randthema berichtet Big Technology über Rechenleistung. Pichai sagt, alle seien knapp, nicht nur Google: „The compute we have today is a function of decisions I made in 2024.“ Laut Bericht sagt er außerdem, das Cloud-Geschäft verzichte immer wieder auf kurzfristige Erlöse, weil Rechenleistung für die Entwicklung der Spitzenmodelle reserviert werde. Für die Selbstverbesserung ist das relevant, denn jede Schleife aus Idee, Experiment und Auswertung kostet Rechenzeit. Wo sie knapp ist, bremst sie auch automatisierte Forschung.
Nicht belegt ist ein Zeitrahmen. Zweitberichte wie DigitalToday nennen „nächstes Jahr“ als Zeitpunkt weiterer Fortschritte.
Es folgt eine Deutung, die nicht von Pichai stammt. Wer von einem Endzustand spricht, setzt voraus, dass es einen Weg dorthin gibt und dass dieser Weg begonnen hat. Der Satz lässt sich deshalb auch als Aussage für RSI lesen: Die Entwicklung findet statt, Google treibt sie mit hohem Aufwand voran, und in einigen Jahren sind große Erfolge denkbar. Diese Erwartung ist eine eigene Einschätzung. Eine entsprechende Äußerung von Pichai liegt in den gelesenen Quellen nicht vor.
Eine mögliche Lesart: Wer vom Endzustand spricht, setzt voraus, dass der Weg dorthin begonnen hat. Der Satz wäre dann weniger Entwarnung als Standortbestimmung.
Selbstverbessernde KI: Agenten-Schleife versus Gewichtsänderung
Hinter dem Begriff stecken zwei sehr verschiedene Dinge, die im Alltag oft vermischt werden. Das erste ist die Agenten-Schleife. Hier arbeiten KI-Agenten in der Entwicklung mit: Sie schlagen Experimente vor, schreiben und ändern Code, starten Trainingsläufe, werten Ergebnisse aus und melden zurück. Menschen setzen Ziele, prüfen Ergebnisse und entscheiden über Änderungen. Der Kreislauf verbessert Prozesse, Werkzeuge und Arbeitsabläufe.
Das zweite ist die Gewichtsänderung. Dort würde ein Modell seine eigenen Gewichte so verändern, dass der Nachfolger besser ist, und zwar ohne dass ein Mensch dazwischen Ergebnisse freigibt. Dieses Bild ist es, das den Begriff Intelligenzexplosion trägt. Genau davon, so lässt sich Pichai lesen, ist die Branche noch weit entfernt.
Zwischen beiden Polen liegt kein Schalter, sondern ein Spektrum. Die Zahl der Schritte, die Agenten ohne Rückfrage erledigen, kann wachsen. Mit ihr wächst der Anteil der Entwicklung, den Menschen nur noch stichprobenartig kontrollieren. Wie Agenten im Betrieb handeln und warum das Kontrolle verlangt, beschreibt der Beitrag zum Zeitalter der KI-Agenten.
Für die zentrale Frage lohnt sich eine nüchterne Antwort. Sie lässt sich aus den belegten Sätzen ableiten.
Betreibt Google schon rekursive Selbstverbesserung, wenn KI beim Bau der Nachfolgemodelle hilft?
Der Unterschied ist für KMU nicht akademisch. Eine Agenten-Schleife beschleunigt die Modellzyklen, ohne dass Kontrollverlust das Thema wäre. Eine Gewichtsänderung ohne Aufsicht würde die Frage aufwerfen, ob Menschen Änderungen noch nachvollziehen können. Beide Fragen brauchen unterschiedliche Antworten, und nur die erste stellt sich heute praktisch.
Was Google und andere über den eigenen Stand berichten
Aussagen von Herstellern über den eigenen Fortschritt sind Selbstauskünfte. Sie können zutreffen, sie sind aber nicht unabhängig geprüft. Das gilt für alles, was in diesem Abschnitt steht.
Ein aktuelles Beispiel ist Flint. Das Unternehmen Recursive stellt das Modell in seiner Ankündigung als schnelles Coding-Modell für lokale Hardware vor, mit 40 Milliarden Parametern insgesamt und 2,5 Milliarden aktiven je Token (also ein Mixture of Experts Model). Nach eigener Darstellung hat ein kleines Team aus Menschen und Agenten es in unter vier Monaten gebaut. Das automatisierte Forschungssystem, die „Eureka Machine“, habe nahezu jeden Teil der Modellbau-Kette mitentwickelt, von Daten und Trainingsrezepten bis zur Inferenz. Die Benchmarks stammen vom Hersteller und sind unabhängig nicht verifiziert. Recursive warnt selbst, dass Flint mehr Anleitung brauchen kann als große geschlossene Modelle.
Für Unternehmen ist das aus zwei Gründen interessant. Erstens zeigt der Fall, dass automatisierte Forschung bereits Produkte hervorbringt, auch bei kleinen Teams. Zweitens läuft das Modell lokal. Wer sensible Daten nicht an Cloud-Anbieter senden will, bekommt so eine Option mehr, und zwar ohne dass die Herstellerangaben damit bewiesen wären. Wie sich lokale Modelle im Unternehmen einordnen lassen, zeigt der Überblick zur lokalen KI im Unternehmen.

Die Übersicht zeigt, wie die Aussagen in diesem Beitrag einzustufen sind. Belegt sind die zwei Sätze von Pichai im Wortlaut des Berichts. Hersteller- und Forschungszahlen sind selbstberichtet. Gladstone ist eine Einschätzung aus Gesprächen mit Forschenden, keine Messung. Die Codezahl bleibt ungesichert, der angebliche Zeitrahmen „in ein paar Jahren“ ist als Pichai-Aussage nicht belegt.
Was Forschung zeigt und wo sie endet
Eine Forschungsarbeit macht greifbar, wie eine solche Schleife aussehen kann. Unter dem Titel „Recursive Self-Improvement through Multi-Agent Self-Supervision“, eingereicht am 8. Oktober 2026) wird die Methode MASS beschrieben. Ein einzelnes Basismodell, im Paper Qwen3.6-27B, schlägt Multi-Agent-Workflows vor, führt sie aus und bewertet sie selbst. Danach wird es auf den eigenen Läufen nachtrainiert, und das Verfahren wiederholt sich.
Nach zwei Zyklen meldet das Abstract eine 1,2- bis 1,6-fache Leistung pro Ausgabe-Token auf vier offenen Benchmarks. Außerdem sei ein Modell, das mit den Läufen mehrerer Agenten trainiert wurde, besser als ein Modell, das mit Läufen eines einzelnen Agenten und 40 Prozent mehr Trainingsdaten trainiert wurde.
Die Grenzen sind im Material selbst zu sehen. Es handelt sich um ein Modell und zwei Zyklen. Das Signal für die Verbesserung kommt aus der Selbstbewertung. Auf den beiden Coding-Benchmarks Terminal-Bench 2.0 und SWE-bench Verified stehen im Paper in einer Abbildung die Werte 0,96 und 0,94, also je Token leicht unter dem Ausgangswert. Auf diesen beiden Tests zeigte sich in der Abbildung also kein Gewinn je Token.
Der Ausgangspunkt der Autoren passt zum Thema (übergeordnete) "Aufsicht". Sie schreiben, dass ein einzelnes Modell Mühe habe, die eigenen komplexen Überlegungen zu kritisieren und zu verbessern, wenn es in einer homogenen Schleife arbeitet. Daher setzen sie auf mehrere Instanzen mit verschiedenen Rollen. Wenn dasselbe Modell erzeugt und bewertet, können gemeinsame Fehler unentdeckt bleiben. Das ist eine Folgerung aus dem Ansatz, die Formulierung des Papers zielt auf die Methode, nicht auf Unternehmen.
Forschung belegt, dass die Idee funktionieren kann und dass die Prüfung der Engpass ist. Sie belegt nicht, dass sich Modelle im Alltag ohne Menschen zuverlässig verbessern. Das passt zu Pichais Satz und widerspricht ihm nicht.
Wie schnell es gehen könnte: Gladstone und die Grenzen der Prognose
Forscher bei Anthropic, OpenAI und Google DeepMind erwarteten, dass rekursive Selbstverbesserung in den nächsten drei bis zwölf Monaten beginne, möglicherweise früher, und zwar unter der Annahme, dass die US-Regierung nicht eingreift oder bremst.
Die Befragten haben ein Eigeninteresse an der Dynamik des Feldes, und die Autoren sind eine Organisation mit Schwerpunkt Sicherheitspolitik.
Automatisierte Forschung könne technisch möglich sein, ohne wirtschaftlich zu sein. Gute Ideen seien nicht der Engpass, sondern Rechenzeit, um sie zu testen. Das deckt sich mit Pichais Hinweis auf knappe Rechenleistung.
Die Aussagen schließen sich nicht aus. „Beginn“ und „Endzustand“ sind verschiedene Punkte auf demselben Weg. Pichai sagt, der Weg ist lang, und beschreibt zugleich, dass die Schleifen mit Forschern laufen. Gladstone erwartet, dass ein Teil davon bald autonomer wird. Wer beides liest, erhält ein Bild, in dem die rekursive Selbstverbesserung schrittweise zunimmt. Eine Planung allein auf Monatsangaben zu stützen, ist riskant, weil sie aus einer kleinen Gesprächsrunde stammen.
Folgen für KMU: Modellzyklen und Modellwechsel testen
Für Unternehmen zeigt sich der Effekt nicht als Intelligenzexplosion, sondern in Kalender und Technik. Wenn Agenten Forscher entlasten, können neue Modellversionen häufiger erscheinen. Für den Betrieb zählt aber unabhängig von der Ursache: Modelle ändern sich schneller, als Fachabteilungen Prozesse anpassen.
Das hat praktische Folgen. Ein Modell kann bei gleichem Prompt anders antworten als sein Vorgänger. Ton, Format, Fehlerarten und Kosten pro Aufgabe verschieben sich. Anbieter stellen ältere Versionen ein, manchmal mit kurzer Frist. Und wer auf den Alias „latest“ setzt, bekommt Änderungen ungefragt in die Produktion.
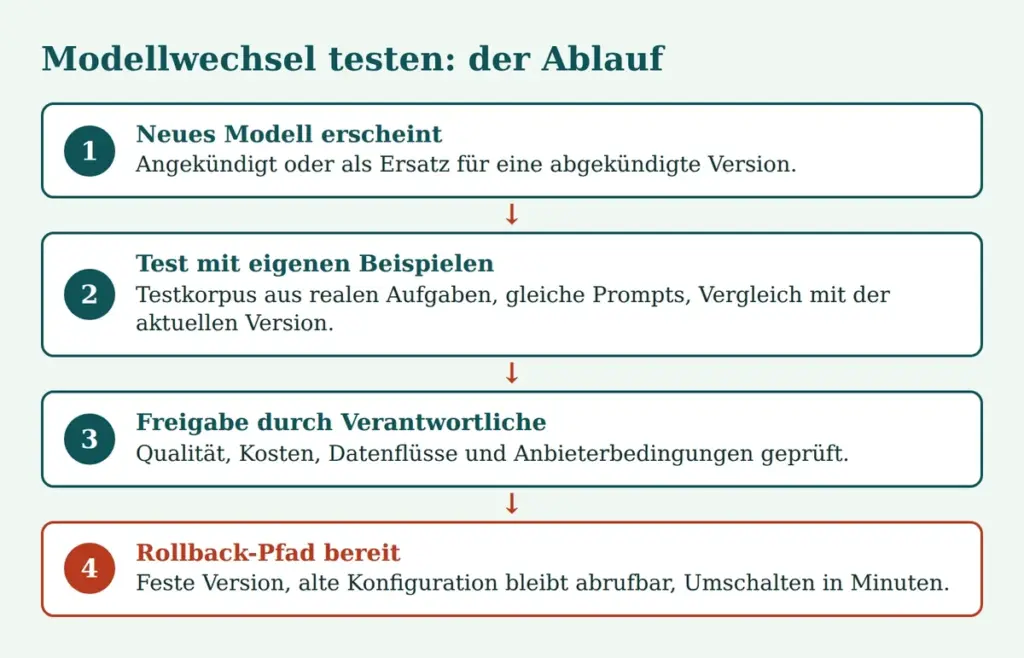
Daraus ergibt sich ein einfaches Vorgehen für den Modellwechsel. Erstens ein Testkorpus aus echten Aufgaben, zum Beispiel 50 bis 200 anonymisierte Fälle mit bekannter guter Antwort (kann man teils sogar mit KI generieren!). Zweitens ein Vergleichslauf des neuen Modells gegen die aktuelle Version mit unveränderten Prompts. Drittens eine Freigabe durch eine benannte Person, die Qualität, Kosten und Fehlerbild gesehen hat. Viertens ein Rollback-Pfad, also feste Modellversion und aufbewahrte Konfiguration, damit das Zurückschalten in Minuten gelingt.
Bei einem Anbieterwechsel oder einem neuen Modell eines bestehenden Anbieters kommen Datenschutz und Vertrag dazu. Zu klären sind Datenflüsse, Serverstandort, Auftragsverarbeitung und die Frage, ob Eingaben zum Training verwendet werden. Ein automatisches Hochziehen auf das neueste Modell sollte in der Produktion nicht erlaubt sein. Lokale Modelle verschieben die Frage: Sie nehmen Abhängigkeit vom Anbieter weg und bringen eigene Pflege mit, siehe die Übersicht zur lokalen KI.
Kleine Unternehmen müssen dafür keine eigene Testabteilung aufbauen. Eine Tabelle mit Beispielen, ein Skript, das sie durch beide Modelle schickt, und eine kurze Notiz zur Freigabe genügen als Anfang.
Aufsicht und Freigaben beibehalten: Was Aufgabe des Menschen bleibt
Wenn Entwickler im eigenen Haus Agenten mit Schreibrechten einsetzen, entsteht im Kleinen dieselbe Schleife wie bei den Laboren: Der Agent ändert Code, Tests laufen, der Agent korrigiert. Die Aufsicht lässt sich nach demselben Muster gestalten. Der Agent darf vorschlagen und testen, aber eine benannte Person gibt Änderungen an Produktivsystemen, Konfigurationen und Daten frei.
Dazu gehören Protokolle, die nachvollziehbar machen, was der Agent getan hat, und Rechte, die so eng sind wie nötig. Löschen, Versenden und Bezahlen sind Aktionen, die eine zusätzliche Bestätigung verdienen. Welche Risiken ein Agent ohne Kontrolle mit sich bringt, beschreibt der Beitrag Die Gefahr hinter KI-Agenten.
Wichtig ist auch die Frage, wer prüft. Wenn dasselbe Modell erzeugt und bewertet, bleiben gleiche blinde Flecken bestehen. Im Betrieb heißt das: Eine KI darf eine andere prüfen, aber nur zusätzlich. Die belastbare Gegenprüfung kommt aus Tests, einem anderen Anbieter oder einem Menschen.
KI prüft KI nur dann belastbar, wenn die Gegenprüfung unabhängig ist: durch Tests, einen anderen Anbieter oder einen Menschen.
Die Verantwortung bleibt beim Unternehmen, das den Agenten einsetzt. Das gilt unabhängig davon, wie viel der Entwicklung im Hintergrund automatisiert ist. Eine Aussage, dass KI sich selbst verbessert, entlastet den Betreiber nicht.
Checkliste:
Eine Checkliste soll bei der Antwort auf die Frage helfen, was jetzt zu tun ist und was nicht:

Zu den Punkten im Einzelnen:
Das Modellinventar hält fest, welche Modelle in welcher Version wo laufen, wer verantwortlich ist und welche Daten fließen. Der Testkorpus wächst mit jedem Fehler, der im Betrieb auffällt. Versionen werden festgelegt und nur nach Test geändert. Für Agenten mit Schreibrechten gelten Freigaben und Protokolle. Herstellerangaben, ob zu Benchmarks oder zu KI-Anteilen im Code, werden als Selbstauskunft behandelt und nicht als Beleg.
Nicht empfehlenswert sind Panik und Aktionismus, denn die belegte Lage ist eine Teilschleife mit Menschen. Ebenso wenig sollten Kontrollen abgebaut werden, weil eine KI sich selbst prüft. Und Strategien, die auf Monatsangaben von Prognosen beruhen, stehen auf dünnem Grund. Wer zusätzlich die technische Seite prüfen will, etwa Rechte und Angriffsfläche von Systemen, findet unter wwwschutz.de die Security-Checks einen Einstieg.
Fazit
Zusammengefasst lassen sich die Aussagen und der aktuelle Stand, der sich täglich ändern kann, so ordnen.
Pichai belegt, dass es Rückkopplungsschleifen mit Forschern gibt und dass der Endzustand ohne Menschen noch weit entfernt ist. Dies ist keine Entwarnung. Eine mögliche Lesart lautet, dass der Weg schon läuft und große Fortschritte in einigen Jahren möglich sind.
Für KMU zählen kürzere Modellzyklen, Tests vor jedem Wechsel, feste Versionen und Freigaben für Agenten. Ob die Schleife in drei Monaten oder in drei Jahren deutlich autonomer wird, weiß heute niemand belastbar. Wer Tests, Freigaben und Rollback beherrscht, ist auf beide Fälle vorbereitet.
KI-Beratung, KI-Lösungen
Leistungsangebot:
- Erstberatung inkl. Machbarkeitsaussagen
- Schulungen und Workshops für Führungskräfte, Berufsgeheimnisträger, Angestellte, Entwickler
- KI-Lösungen mit und ohne ChatGPT/Azure. Cloud oder eigener KI-Server
 Mein Name ist Klaus Meffert. Ich bin promovierter Informatiker und beschäftige mich seit über 30 Jahren professionell und praxisbezogen mit Informationstechnologie. In IT & Datenschutz bin ich auch als Sachverständiger tätig. Ich stehe für pragmatische Lösungen mit Mehrwert. Meine Firma, die