Googles vd Sundar Pichai säger att branschen fortfarande är långt från slutläget för rekursiv självförbättring. Samtidigt beskriver han loopar där AI-agenter redan i dag hjälper till att bygga nya modeller. Utifrån dagens läge går det att reda ut vad som är belagt om självförbättrande AI och vad det betyder för AI-användningen i små och medelstora företag. Är mänskligheten i fara?
Bakgrunden är en intervju som Big Technology rapporterade om den 23 oktober 2026. Där faller en mening om självförbättrande AI som är lätt att citera: branschen är fortfarande långt från slutläget för RSI. RSI står för Recursive Self-Improvement, alltså rekursiv självförbättring. Det handlar om ett kretslopp där AI-system förbättrar sina efterföljare, som i sin tur bygger bättre efterföljare.
Grunderna för hur sådana loopar fungerar beskrivs i inlägget om rekursiv självförbättring av AI. Uttalanden från intervjun, tillverkarnas egna uppgifter, en forskningsartikel och en insiderprognos hålls nedan isär.
Vad Pichai sa och vad han inte sa
Kärnan är kort. Enligt Alex Kantrowitz rapport sa Pichai: ”To be very clear. We are pretty far from the end state of RSI.” Det betyder ungefär: ”Helt klart: Från slutläget för rekursiv självförbättring är branschen fortfarande ganska långt borta.” Kantrowitz ställer meningen mot förväntan hos vissa i AI-branschen att en intelligensexplosion är nära förestående och att AI snart förbättrar sig själv i en fullständig loop utan mänsklig medverkan.
Direkt efteråt följer två meningar till som är viktigare för bedömningen än den första. Pichai sa: ”You have RSI loops along with AI researchers in various aspects of model development.” Och: ”You almost have agents helping AI researchers in some automated way work together to build these models.” I sak: inom olika delar av modellutvecklingen finns återkopplingsloopar tillsammans med forskarna, och agenter hjälper dem delvis automatiserat att bygga modellerna.
Ordagrant belagt är alltså: delloopar körs redan, och de körs tillsammans med forskarna. En modell som bygger om sig själv utan tillsyn nämns inte i dessa meningar. Meningen om slutläget kan läsas så att det är just den bilden som avses.
Som sidospår rapporterar Big Technology om beräkningskapacitet. Pichai säger att alla har för lite, inte bara Google: ”The compute we have today is a function of decisions I made in 2024.” Enligt rapporten säger han också att molnverksamheten gång på gång avstår från kortsiktiga intäkter eftersom beräkningskapacitet reserveras för utvecklingen av de ledande modellerna. För självförbättringen är det relevant, eftersom varje loop av idé, experiment och utvärdering kostar beräkningstid. Där den är knapp bromsar den också automatiserad forskning.
Någon tidsram är inte belagd. Andrahandsrapporter som DigitalToday anger ”nästa år” som tidpunkt för ytterligare framsteg.
Här följer en tolkning som inte kommer från Pichai. Den som talar om ett slutläge förutsätter att det finns en väg dit och att den vägen har påbörjats. Meningen kan därför också läsas som ett uttalande för RSI: utvecklingen pågår, Google driver den med stora resurser, och om några år är stora framgångar tänkbara. Den förväntan är en egen bedömning. Något motsvarande uttalande av Pichai finns inte i de källor som lästs.
En möjlig läsning: den som talar om slutläget förutsätter att vägen dit har påbörjats. Meningen vore då mindre en friskförklaring än en lägesbestämning.
Självförbättrande AI: agentloop kontra viktändring
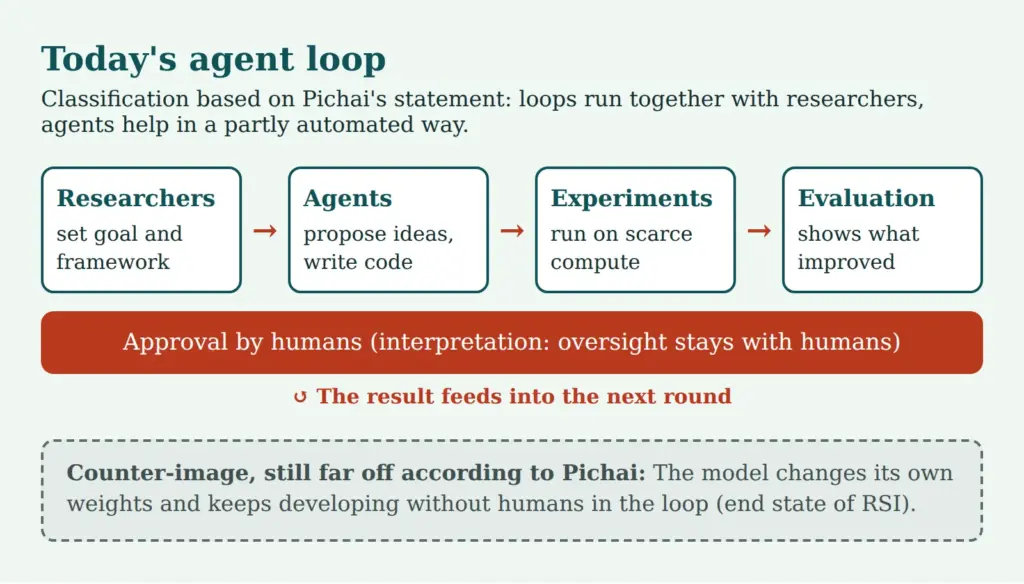
Bakom begreppet döljer sig två mycket olika saker som ofta blandas ihop i vardagen. Den första är agentloopen. Här medverkar AI-agenter i utvecklingen: de föreslår experiment, skriver och ändrar kod, startar träningskörningar, utvärderar resultat och rapporterar tillbaka. Människor sätter mål, granskar resultat och beslutar om ändringar. Kretsloppet förbättrar processer, verktyg och arbetsflöden.
Den andra är viktändringen. Där skulle en modell ändra sina egna vikter så att efterföljaren blir bättre, utan att någon människa däremellan godkänner resultat. Det är den bilden som bär begreppet intelligensexplosion. Just därifrån är branschen, så kan Pichai läsas, fortfarande långt borta.
Mellan de två polerna finns ingen strömbrytare, utan ett spektrum. Antalet steg som agenter klarar utan att fråga kan växa. Med det växer den andel av utvecklingen som människor bara kontrollerar stickprovsvis. Hur agenter agerar i drift och varför det kräver kontroll beskrivs i inlägget om AI-agenternas tidsålder.
Den centrala frågan förtjänar ett nyktert svar. Det kan härledas ur de belagda meningarna.
Ägnar sig Google redan åt rekursiv självförbättring när AI hjälper till att bygga efterföljande modeller?
För små och medelstora företag är skillnaden inte akademisk. En agentloop snabbar upp modellcyklerna utan att kontrollförlust är frågan. En viktändring utan tillsyn skulle väcka frågan om människor fortfarande kan följa ändringarna. De två frågorna kräver olika svar, och bara den första är praktiskt aktuell i dag.
Vad Google och andra rapporterar om sitt eget läge
Tillverkares uttalanden om sina egna framsteg är egna uppgifter. De kan stämma, men de är inte oberoende granskade. Det gäller allt i det här avsnittet.
Ett aktuellt exempel är Flint. Företaget Recursive presenterar i sitt tillkännagivande modellen som en snabb kodmodell för lokal hårdvara, med 40 miljarder parametrar totalt och 2,5 miljarder aktiva per token (alltså en Mixture of Experts-modell). Enligt egen uppgift byggde ett litet team av människor och agenter den på under fyra månader. Det automatiserade forskningssystemet, ”Eureka Machine”, ska ha varit med och utvecklat nästan varje del av kedjan för modellbygge, från data och träningsrecept till inferens. Benchmarkresultaten kommer från tillverkaren och är inte oberoende verifierade. Recursive varnar själva för att Flint kan behöva mer vägledning än stora slutna modeller.
För företag är detta intressant av två skäl. För det första visar fallet att automatiserad forskning redan ger produkter, även hos små team. För det andra körs modellen lokalt. Den som inte vill skicka känsliga data till molnleverantörer får därmed ett alternativ till, utan att tillverkarens uppgifter för den skull är bevisade. Hur lokala modeller passar in i ett företag visar översikten om lokal AI i företaget.
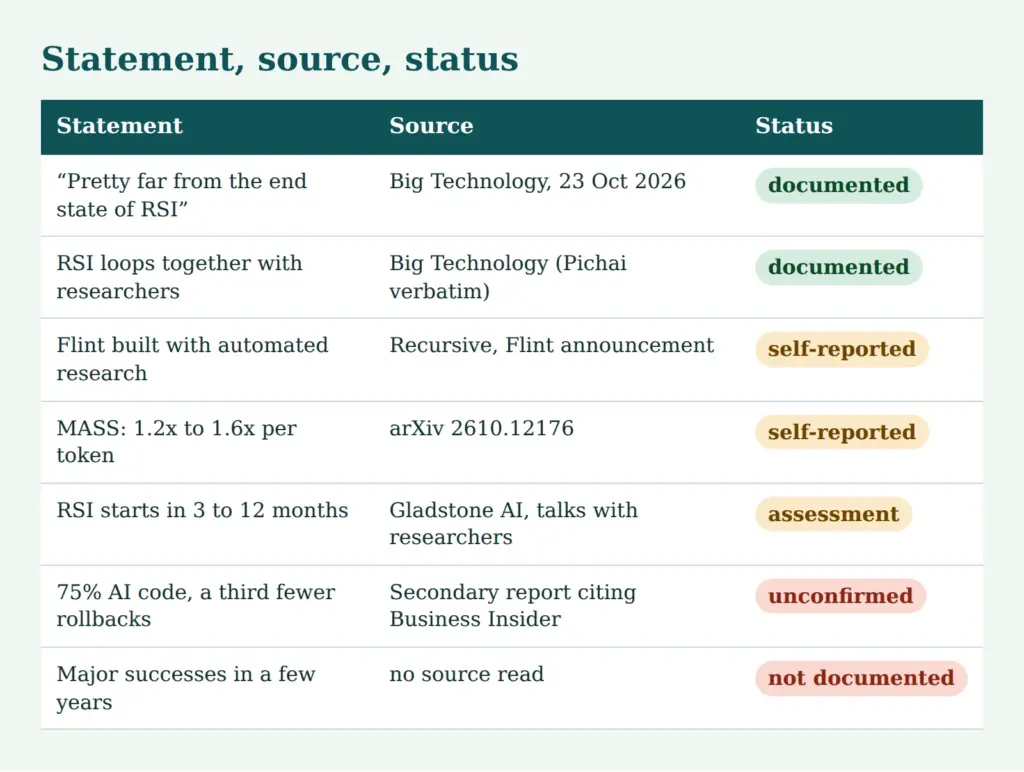
Översikten visar hur uttalandena i detta inlägg ska klassas. Belagda är Pichais två meningar i rapportens ordalydelse. Siffror från tillverkare och forskning är egenrapporterade. Gladstone är en bedömning utifrån samtal med forskare, ingen mätning. Kodsiffran förblir obekräftad, och den påstådda tidsramen ”om några år” är inte belagd som ett uttalande av Pichai.
Vad forskningen visar och var den slutar
En forskningsartikel gör det konkret hur en sådan loop kan se ut. Under titeln ”Recursive Self-Improvement through Multi-Agent Self-Supervision” (inskickad den 8 oktober 2026) beskrivs metoden MASS. En enda basmodell, i artikeln Qwen3.6-27B, föreslår arbetsflöden med flera agenter, utför dem och bedömer dem själv. Därefter tränas den vidare på sina egna körningar, och förfarandet upprepas.
Efter två cykler rapporterar sammanfattningen 1,2 till 1,6 gånger så hög prestanda per utdatatoken på fyra öppna benchmarks. Dessutom ska en modell som tränats på körningar från flera agenter vara bättre än en modell som tränats på körningar från en enda agent med 40 procent mer träningsdata.
Begränsningarna syns i själva materialet. Det handlar om en modell och två cykler. Signalen för förbättringen kommer från självbedömningen. På de två kodbenchmarken Terminal-Bench 2.0 och SWE-bench Verified anges i en figur i artikeln värdena 0,96 och 0,94, alltså per token något under utgångsvärdet. På dessa två tester visade figuren alltså ingen vinst per token.
Författarnas utgångspunkt passar till temat (övergripande) ”tillsyn”. De skriver att en enskild modell har svårt att kritisera och förbättra sina egna komplexa resonemang när den arbetar i en homogen loop. Därför satsar de på flera instanser med olika roller. Om samma modell både skapar och bedömer kan gemensamma fel förbli oupptäckta. Det är en slutsats av angreppssättet, artikelns formulering gäller metoden, inte företag.
Forskningen visar att idén kan fungera och att granskningen är flaskhalsen. Den visar inte att modeller i vardagen förbättrar sig själva tillförlitligt utan människor. Det stämmer med Pichais mening och motsäger den inte.
Hur snabbt det kan gå: Gladstone och prognosens gränser
Forskare på Anthropic, OpenAI och Google DeepMind väntade sig att rekursiv självförbättring skulle börja inom de närmaste tre till tolv månaderna, möjligen tidigare, under antagandet att USA:s regering inte ingriper eller bromsar.
De tillfrågade har ett eget intresse av fältets dynamik, och författarna är en organisation med inriktning på säkerhetspolitik.
Automatiserad forskning kan vara tekniskt möjlig utan att vara ekonomiskt lönsam. Bra idéer är inte flaskhalsen, utan beräkningstid för att testa dem. Det stämmer överens med Pichais hänvisning till knapp beräkningskapacitet.
Uttalandena utesluter inte varandra. ”Början” och ”slutläge” är olika punkter på samma väg. Pichai säger att vägen är lång och beskriver samtidigt att looparna körs med forskare. Gladstone väntar sig att en del av detta snart blir mer autonomt. Den som läser båda får en bild där den rekursiva självförbättringen ökar steg för steg. Att grunda planering enbart på månadsangivelser är riskabelt, eftersom de kommer från en liten samtalskrets.
Följder för små och medelstora företag: testa modellcykler och modellbyten
För företag märks effekten inte som en intelligensexplosion, utan i kalendern och tekniken. När agenter avlastar forskare kan nya modellversioner komma oftare. För driften gäller dock oavsett orsak: modeller ändras snabbare än verksamheterna hinner anpassa sina processer.
Det får praktiska följder. En modell kan svara annorlunda än sin föregångare på samma prompt. Ton, format, feltyper och kostnad per uppgift förskjuts. Leverantörer avvecklar äldre versioner, ibland med kort varsel. Och den som förlitar sig på aliaset ”latest” får ändringar i produktionen utan att ha bett om dem.
Av detta följer ett enkelt tillvägagångssätt för modellbyten. För det första en testkorpus av verkliga uppgifter, till exempel 50 till 200 anonymiserade fall med känt bra svar (som delvis till och med kan genereras med AI!). För det andra en jämförande körning av den nya modellen mot den aktuella versionen med oförändrade prompter. För det tredje ett godkännande av en namngiven person som har sett kvalitet, kostnader och felbild. För det fjärde en väg tillbaka, alltså fast modellversion och sparad konfiguration, så att det går att växla tillbaka på några minuter.
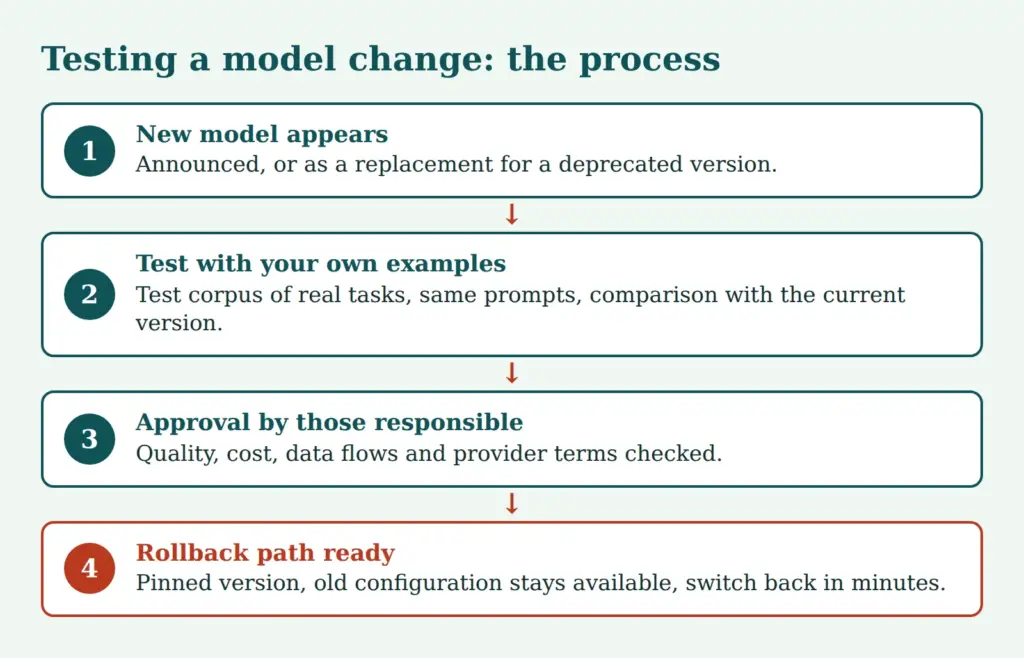
Vid byte av leverantör eller en ny modell från en befintlig leverantör tillkommer dataskydd och avtal. Det som behöver klargöras är dataflöden, serverplacering, personuppgiftsbiträdesavtal och frågan om indata används för träning. En automatisk uppgradering till den senaste modellen bör inte tillåtas i produktion. Lokala modeller förskjuter frågan: de tar bort beroendet av leverantören och för med sig eget underhåll, se översikten om lokal AI.
Små företag behöver inte bygga upp en egen testavdelning för detta. En tabell med exempel, ett skript som skickar dem genom båda modellerna och en kort anteckning om godkännandet räcker som början.
Behåll tillsyn och godkännanden: vad som förblir människans uppgift
När utvecklare i det egna huset använder agenter med skrivrättigheter uppstår i liten skala samma loop som i laboratorierna: agenten ändrar kod, tester körs, agenten rättar. Tillsynen kan utformas efter samma mönster. Agenten får föreslå och testa, men en namngiven person godkänner ändringar i produktionssystem, konfigurationer och data.
Till detta hör loggar som gör det spårbart vad agenten har gjort, och rättigheter som är så snäva som möjligt. Radera, skicka och betala är åtgärder som förtjänar en extra bekräftelse. Vilka risker en agent utan kontroll medför beskriver inlägget Faran bakom AI-agenter.
Viktig är också frågan om vem som granskar. Om samma modell både skapar och bedömer kvarstår samma blinda fläckar. I driften betyder det: en AI får granska en annan, men bara som komplement. Den tillförlitliga motkontrollen kommer från tester, en annan leverantör eller en människa.
AI granskar AI tillförlitligt bara när motkontrollen är oberoende: genom tester, en annan leverantör eller en människa.
Ansvaret ligger kvar hos företaget som använder agenten. Det gäller oberoende av hur mycket av utvecklingen som är automatiserad i bakgrunden. Ett påstående om att AI förbättrar sig själv fritar inte den som driver systemet.
Checklista
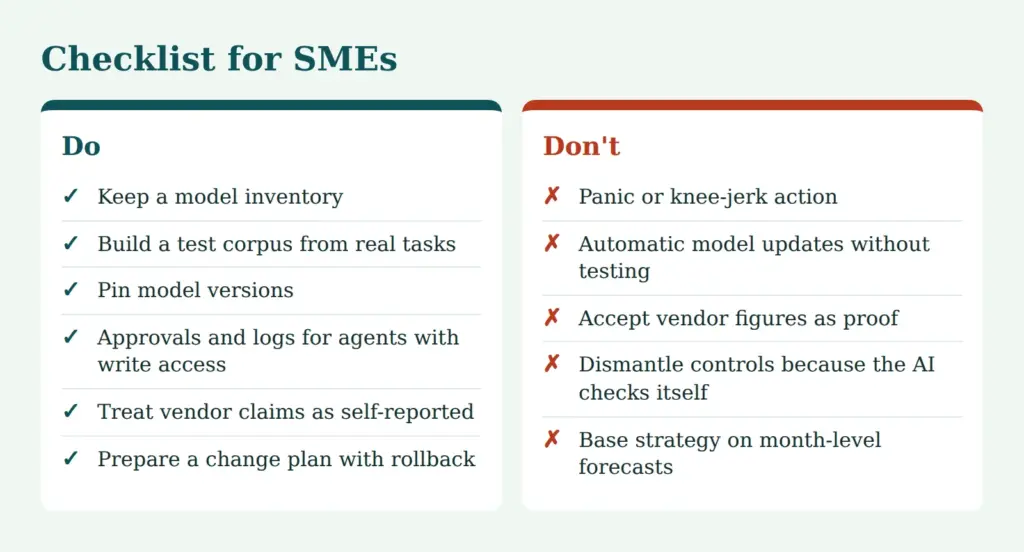
En checklista ska hjälpa till att besvara frågan om vad som bör göras nu och vad som inte bör göras:
Punkterna i detalj:
Modellinventeringen dokumenterar vilka modeller som körs i vilken version och var, vem som är ansvarig och vilka data som flödar. Testkorpusen växer med varje fel som upptäcks i driften. Versioner låses och ändras bara efter test. För agenter med skrivrättigheter gäller godkännanden och loggar. Tillverkarens uppgifter, oavsett om de gäller benchmarks eller AI-andelar i koden, behandlas som egna uppgifter och inte som belägg.
Panik och aktionism är inte att rekommendera, eftersom det belagda läget är en delloop med människor. Lika lite bör kontroller monteras ned för att en AI granskar sig själv. Och strategier som bygger på månadsangivelser i prognoser står på svag grund. Den som dessutom vill granska den tekniska sidan, till exempel rättigheter och attackyta hos system, hittar en ingång i säkerhetskontrollerna på wwwschutz.de.
Slutsats
Sammanfattningsvis kan uttalandena och det aktuella läget, som kan ändras dagligen, ordnas så här.
Pichai belägger att det finns återkopplingsloopar med forskare och att slutläget utan människor fortfarande ligger långt borta. Det är ingen friskförklaring. En möjlig läsning är att vägen redan har påbörjats och att stora framsteg är möjliga om några år.
För små och medelstora företag räknas kortare modellcykler, tester före varje byte, fasta versioner och godkännanden för agenter. Om loopen blir märkbart mer autonom om tre månader eller om tre år kan ingen i dag säga med säkerhet. Den som behärskar tester, godkännanden och återställning är förberedd på båda fallen.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.