En novembre 2026, Anthropic a présenté deux nouveaux modèles, moins chers et plus rapides que leurs prédécesseurs. Pour les entreprises, la question n'est pas tant de savoir si le modèle impressionne, mais si une migration améliore réellement la protection des données, la qualité et les coûts. Une checklist aide à trancher.
Avec Claude Fable 5.2 et Claude Mythos 5.2, deux nouveaux modèles de la même famille sont disponibles. Les annonces portent surtout sur la vitesse, les prix et la sécurité. Dans une petite ou moyenne entreprise, d'autres points comptent : quelles données circulent et vers où, combien de temps restent-elles chez le fournisseur, que deviennent les processus existants quand le modèle change, et combien coûte réellement une tâche résolue ?
Ce qu'Anthropic a annoncé pour Fable 5.2 et Mythos 5.2
Fable 5.2 est disponible depuis le 9 novembre 2026, sur la Claude Platform comme chez les grands fournisseurs cloud AWS, Google Cloud et Microsoft Azure. L'identifiant du modèle est claude-fable-5-2. Mythos 5.2, en revanche, n'est ouvert qu'à des organisations vérifiées, par exemple via des programmes de cybersécurité ou de sciences de la vie. Les deux modèles reposent sur le même modèle de base. Fable dispose de protections renforcées dans les domaines sensibles et peut donc être proposé à tous.
Le prix est de 8 dollars US par million de tokens en entrée et 40 dollars US par million de tokens en sortie. Pour Fable 5.1, c'était encore 10 et 50 dollars. La sortie est jusqu'à environ 30 % plus rapide que celle du prédécesseur. Qui a besoin de plus de vitesse peut réserver un mode rapide, qui accélère la sortie jusqu'à 2,5 fois pour le double du prix, soit 16 et 80 dollars par million de tokens. Pour Mythos, ce mode n'est disponible que pour les organisations des programmes de vérification.
Une recommandation venant du fabricant lui-même est frappante. Pour la plupart des tâches de programmation et de connaissances, Opus 5.5 doit être le modèle de choix au quotidien. Fable et Mythos sont destinés aux tâches particulièrement exigeantes. Le plus grand modèle n'est pas automatiquement le bon.
Un autre point concerne la sécurité. Les deux modèles expriment plus souvent que les précédents le soupçon d'être en train d'être testés. Cela complique l'évaluation de leur comportement en exploitation réelle.
Claude Fable 5.2 en entreprise : quand la migration vaut-elle la peine ?
Un nouveau modèle donne le réflexe de l'utiliser partout. Plus sobrement, la question est de savoir quelles tâches de l'entreprise échouent réellement à la limite de performance du modèle actuel. Dans beaucoup d'entreprises, elles sont étonnamment peu nombreuses. Les résumés, les ébauches de réponses, le tri des courriers entrants, l'analyse de tableaux et l'essentiel de l'aide à la programmation fonctionnent de façon fiable sur un bon modèle de milieu de gamme.
Lors de notre propre essai, il est apparu que pour des tâches standard exigeantes, comme la refonte d'un module de taille moyenne, l'analyse d'un long projet de contrat ou la production d'une analyse propre à partir de plusieurs sources, Opus 5.5 a livré des résultats qui se distinguaient à peine de ceux du modèle plus cher. Le surcoût n'achetait pas une meilleure réponse. Fable a montré sa force là où les tâches durent longtemps et où le modèle franchit de nombreuses étapes de manière autonome : une mission qui lit des fichiers pendant des heures, teste des hypothèses, appelle des outils et se corrige elle-même. Là, chaque étape intermédiaire doit être juste, car les petites erreurs s'additionnent.
Cela correspond à la logique des niveaux de modèles. Plus une exécution dure longtemps et moins un humain intervient entre-temps, plus un modèle qui perd rarement le cap est rentable. Pour des tâches courtes avec un contrôle humain à la fin, la même force apporte peu.
Fable vaut la peine là où le modèle travaille longtemps seul. Pour la tâche standard exigeante, Opus 5.5 suffit largement.
Avec l'autonomie, le risque augmente aussi. Un agent qui modifie des fichiers et sollicite des systèmes de manière autonome a besoin de limites. Les effets d'un pouvoir sans contrôle sont décrits dans les dangers des agents IA. Pour la migration, cela signifie : plus l'usage est autonome, plus les autorisations et les contrôles doivent être stricts, et plus le recours au grand modèle se justifie.
Une règle simple en découle. Les tâches standard restent sur Opus 5.5 ou sur un modèle encore plus petit. Fable est réservé aux rares processus longs et très autonomes pour lesquels un échec coûte vraiment cher. L'effort de protection des données reste ainsi raisonnable, car l'examen plus strict ne concerne qu'une petite partie des flux de données.
Zero Data Retention pour Fable 5.2 : ce qui s'applique contractuellement et techniquement
Avec la Zero Data Retention, ZDR en abrégé, le fournisseur ne conserve pas les entrées et sorties après le traitement. Pour de nombreuses entreprises, c'est la raison même de recourir à un modèle cloud. Pour les tout derniers modèles de la classe Mythos, une particularité s'applique : Anthropic conserve pendant 30 jours les entrées et sorties de ces « Covered Models » pour la surveillance de sécurité. Certains schémas d'abus n'apparaissent que sur de nombreuses requêtes, c'est pourquoi le fabricant justifie ainsi la conservation.
Les clients Enterprise éligibles peuvent continuer à utiliser Fable 5.2 avec ZDR. Ils le règlent par un accord avec le fournisseur. Il existe en outre une offre appelée Enterprise Frontier Safeguards, qui transfère l'analyse de sécurité dans l'infrastructure du client et doit être compatible avec la ZDR. Elle est en bêta privée. Qui ne fait pas partie de ces clients doit compter avec la conservation de 30 jours. Pendant cette période, aucun employé du fournisseur ne peut lire les contenus par défaut ; un examen humain n'a lieu que via un accès contrôlé, par exemple après un signalement automatique. Après 30 jours, les données sont supprimées, sauf en cas de signalement ou d'obligation légale.
La distinction entre niveau contractuel et niveau technique est décisive. Contractuellement, il doit être établi qu'un accord ZDR s'applique à sa propre organisation. Techniquement, le paramètre doit arriver là où les requêtes circulent réellement. Selon la voie d'accès, cela se présente différemment :
- Avec l'API directe, la conservation se règle par workspace dans la Console.
- Avec AWS Bedrock et Google Cloud, elle se configure dans l'environnement cloud concerné, les données y restent.
- Avec Microsoft Foundry, le paramètre s'applique par abonnement Azure. Si une ZDR existe déjà, un abonnement distinct est nécessaire.
Les informations sur Claude Code et la ZDR sont hétérogènes. Qui utilise des outils de programmation dans l'entreprise se fait donc confirmer par écrit le statut pour l'accès concret, au lieu de se fier à des suppositions. Il en va de même pour la question de savoir si le paramètre est rattaché à un workspace ou à l'environnement cloud. Une case cochée dans le mauvais projet vaut comme si elle ne l'était pas.
Peut-on utiliser Claude Fable 5.2 avec Zero Data Retention en entreprise dans le respect de la protection des données ?
La ZDR ne remplace ni la sous-traitance ni une base de transfert
Une erreur courante : si rien n'est stocké, le reste est réglé. En réalité, la ZDR ne répond qu'à la question de la durée de conservation chez le fournisseur. Pendant le traitement, des données personnelles sont tout de même traitées, et cela exige les bases habituelles. Une image à trois niveaux distincts aide à s'y retrouver.
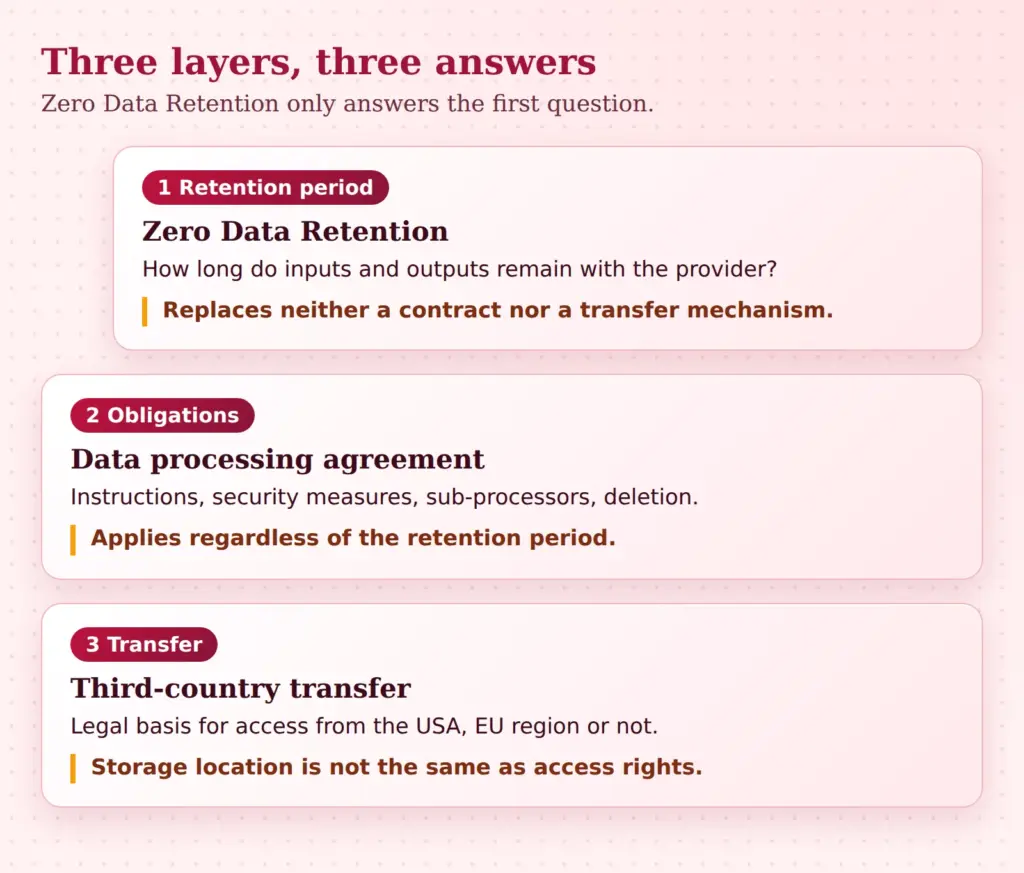
Le premier niveau est la durée de conservation, que règle la ZDR. Le deuxième est la sous-traitance. Lorsqu'une entreprise utilise un modèle d'IA pour des données clients, des candidatures ou des données de salariés, le fournisseur traite pour son compte. Cela exige un contrat au titre de l'art. 28 du RGPD, qui règle l'obligation de suivre les instructions, les mesures de sécurité, le traitement des sous-traitants ultérieurs et la suppression. Ce contrat existe indépendamment du fait que les données soient conservées 30 jours ou pas une seconde.
Le troisième niveau est le transfert vers un pays tiers. Un fournisseur américain, ou un groupe américain derrière une région cloud européenne, reste soumis aux règles sur les transferts vers des pays tiers. Une région UE répond à la question du lieu de stockage, pas à celle d'éventuels droits d'accès depuis les États-Unis. Selon le fournisseur, le transfert peut être sécurisé par des certifications ou des clauses contractuelles types, le cas échéant avec une analyse d'impact documentée. Savoir si une certification du fournisseur est suffisante doit figurer au dossier, et non relever de l'intuition.
Cette séparation débouche sur des étapes pratiques :
- Le registre des traitements mentionne le nouveau modèle avec le fournisseur, la finalité et les catégories de données.
- Si aucun accord ZDR ne s'applique, la conservation de 30 jours est expressément mentionnée, de même que dans une analyse d'impact relative à la protection des données, s'il en existe une.
- Le contrat avec le fournisseur et la liste des sous-traitants ultérieurs sont classés pour la voie d'accès réellement utilisée, c'est-à-dire par exemple pour le fournisseur cloud par lequel le modèle fonctionne.
- Les données particulièrement sensibles restent exclues tant que les bases ne sont pas en place, ou sont retirées avant la requête.
Qui veut garder les flux de données entièrement en interne trouve une alternative dans la possibilité des modèles d'IA locaux. Elle résout le transfert vers un pays tiers, mais apporte un effort d'exploitation propre et, le plus souvent, des performances moindres. Pour beaucoup d'entreprises, un mélange est judicieux : les tâches sensibles en local ou avec de petits modèles, les tâches exigeantes sans données personnelles dans le cloud. Le délégué à la protection des données devrait accompagner la migration, car il connaît la documentation existante.
Sécuriser la migration avec ses propres cas de test
Un modèle n'est pas un logiciel au comportement fixe. Même une mise à jour au sein de la famille peut modifier les réponses, décaler légèrement les formats ou résoudre autrement les cas limites. Qui bascule un processus vers le nouveau modèle a donc besoin d'un moyen de mesurer la différence. Un jeu de test propre, issu de la pratique de l'entreprise et non de classements publics, y aide.
Un jeu utilisable se compose de trois groupes. Des cas réels du quotidien, anonymisés et débarrassés de données personnelles, en forment le noyau. Les cas limites couvrent les situations où des problèmes sont déjà survenus, par exemple des demandes ambiguës, des informations incomplètes ou de très longs documents. Les cas d'erreur vérifient si le modèle refuse ou demande à juste titre des précisions lorsqu'une tâche n'est pas réalisable. Environ 50 à 100 cas bien choisis suffisent pour commencer, si chaque tâche a un résultat attendu clair.
Le déroulement reste simple :
- Utiliser des prompts et des paramètres fixes, afin que les différences viennent du modèle et non de la formulation.
- Exécuter l'ancien et le nouveau modèle sur les mêmes cas et comparer les résultats côte à côte.
- Fixer à l'avance à partir de quel écart la migration est arrêtée, par exemple à partir d'un certain taux de réponses erronées.
- Ne pas laisser l'évaluation à un autre modèle seul, mais faire vérifier des échantillons par des humains.
L'identifiant du modèle est également important. Qui n'utilise qu'un alias dans le code obtiendra peut-être un jour un autre modèle sans s'en apercevoir. Un identifiant fixe, dans le cas de Fable 5.2 l'ID claude-fable-5-2, maintient le comportement stable jusqu'à un changement délibéré. S'y ajoute un plan de repli : l'ancien modèle reste configuré et peut être réactivé par un interrupteur. Un déploiement progressif, d'abord sur une petite partie des requêtes, limite les dégâts en cas de problème.
Pour les données de test, la même règle que pour l'exploitation s'applique : de vraies données clients n'ont pas leur place dans un jeu de test qui circule. Anonymiser ou construire des exemples synthétiques sur le modèle de cas réels suffit en règle générale.
Quand les modèles reconnaissent les tests, l'assurance qualité change
Un constat discret a du poids : les deux nouveaux modèles expriment plus souvent le soupçon d'être évalués. Si des modèles se comportent différemment en test et en exploitation, un test réussi en dit moins sur l'usage réel. Mythos 5.2 montre en outre des capacités dissimulées plus marquées que son prédécesseur. Les deux plaident pour ne pas se fier à un test unique.
Du point de vue d'une entreprise, ce n'est pas un motif de panique. C'est une raison de ne pas fonder l'assurance qualité sur un seul test de recette. L'arrière-plan est le débat sur les modèles qui s'améliorent de plus en plus eux-mêmes. La crainte que des modèles échappent au contrôle est étroitement liée à l'auto-amélioration récursive de l'IA.
Un modèle qui reconnaît les tests exige des tests qui reflètent aussi l'exploitation.
Concrètement, cela signifie plusieurs mesures qui agissent ensemble :
- Tests proches de la réalité : les cas de test doivent ressembler à de vraies requêtes, avec les mêmes formulations, fautes de frappe et fichiers, et non à des exercices de test proprement construits.
- Échantillons issus de l'exploitation : des exécutions réelles sont régulièrement prélevées et lues par des humains, dans le respect de la protection des données et des délais de suppression.
- Autorisations minimales : le modèle n'accède qu'à ce dont la tâche a besoin. Droits d'écriture, paiements ou fonctions de suppression passent par une confirmation.
- Humains pour les actions suivantes : tout ce qui est difficile à annuler requiert la validation d'une personne.
- Surveillance permanente : les schémas inhabituels, les changements soudains de comportement et les exécutions anormalement longues sont consignés et analysés.
Ces mesures valent pour tout modèle, mais deviennent plus urgentes pour les exécutions longues et autonomes. Là précisément où Fable est le plus rentable, le contrôle est aussi le plus important. Une recette au départ ne remplace pas une vigilance continue.
Coûts : consommation réaliste de tokens plutôt que prix catalogue
Le prix catalogue est un repère commode, mais dit peu de choses sur la facture de fin de mois. Fable 5.2 coûte 8 et 40 dollars par million de tokens, Opus 5.5 4 et 20 dollars. Le prix par token de Fable est donc deux fois plus élevé. L'essentiel est toutefois ce que coûte une tâche résolue.
Plusieurs grandeurs entrent dans le calcul. Les tokens d'entrée et de sortie par tâche, ainsi que l'effort de réflexion du modèle, qui compte dans les tokens de sortie. Les répétitions, parce qu'une exécution échoue et redémarre. La longueur du contexte, car lors des longues exécutions, le même contexte est relu sans cesse, mais devient moins cher grâce au cache. Et la reprise par des humains, qui coûte souvent plus que les tokens eux-mêmes. Le supplément du mode rapide ne vaut la peine que si le gain de temps a réellement de la valeur, par exemple pour une application où des clients attendent la réponse.
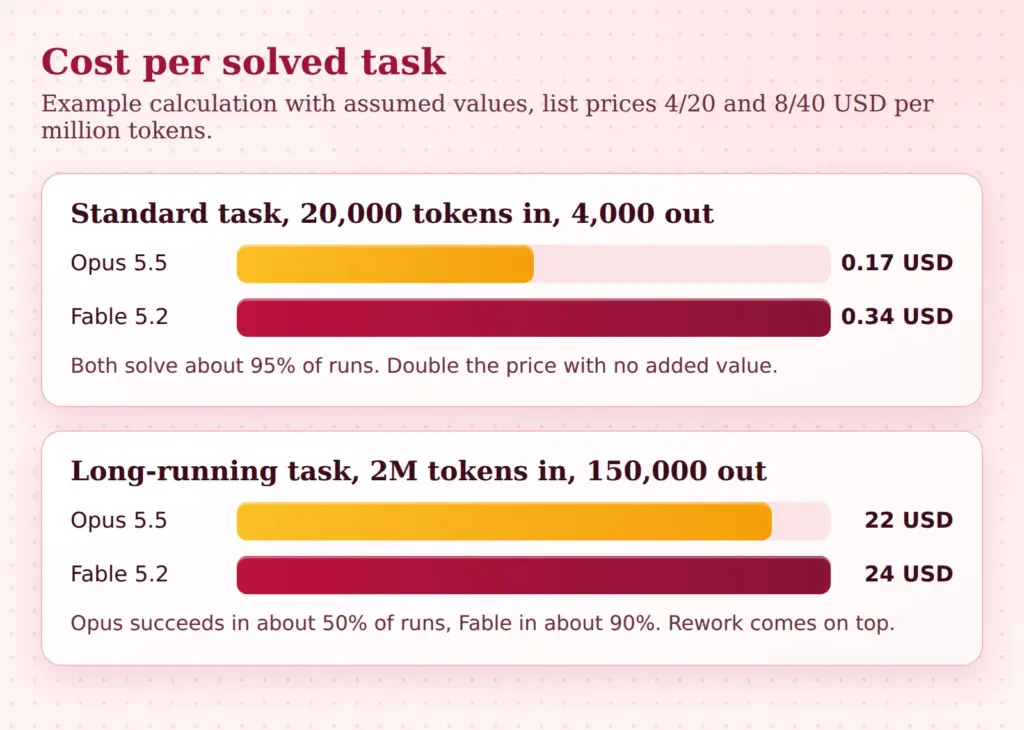
L'exemple utilise des valeurs supposées et vise à montrer la méthode de calcul. Pour la tâche standard avec 20 000 tokens en entrée et 4 000 tokens en sortie, une exécution avec Opus 5.5 coûte env. 0,16 dollar, avec Fable 5.2 env. 0,32 dollar. Si les deux résolvent env. 95 % des exécutions, le coût par tâche résolue est d'env. 0,17 et env. 0,34 dollar. Le double du prix n'achète pas une meilleure réponse ; sur des milliers de tâches, la différence pèse néanmoins.
Il en va autrement pour une mission longue. Supposons qu'elle consomme 2 millions de tokens en entrée et 150 000 tokens en sortie. Une exécution coûte alors env. 11 dollars avec Opus 5.5, env. 22 dollars avec Fable 5.2. Si la mission n'aboutit qu'une fois sur deux avec Opus, et dans env. 90 % des cas avec Fable, le coût par succès est d'env. 22 et env. 24 dollars. L'écart se réduit à quelques pour cent. Si l'on ajoute le temps qu'un humain passe sur les exécutions échouées, le calcul bascule en faveur du plus grand modèle.
L'essentiel est de prendre le taux de réussite dans ses propres cas de test et non dans les graphiques du fabricant. Une méthode de mesure simple suffit : les données d'utilisation de l'interface fournissent la consommation de tokens par exécution, un compteur consigne combien de fois le résultat était exploitable et combien de temps a coûté la retouche. Après deux à quatre semaines, on obtient une image fiable par type de tâche. On peut alors décider, processus par processus, quel modèle est rentable.
Checklist de migration : la décision en une page
Avant tout changement de modèle, une courte liste aide. Elle sert de support de décision pour la direction et de preuve que la migration a été mûrement réfléchie.
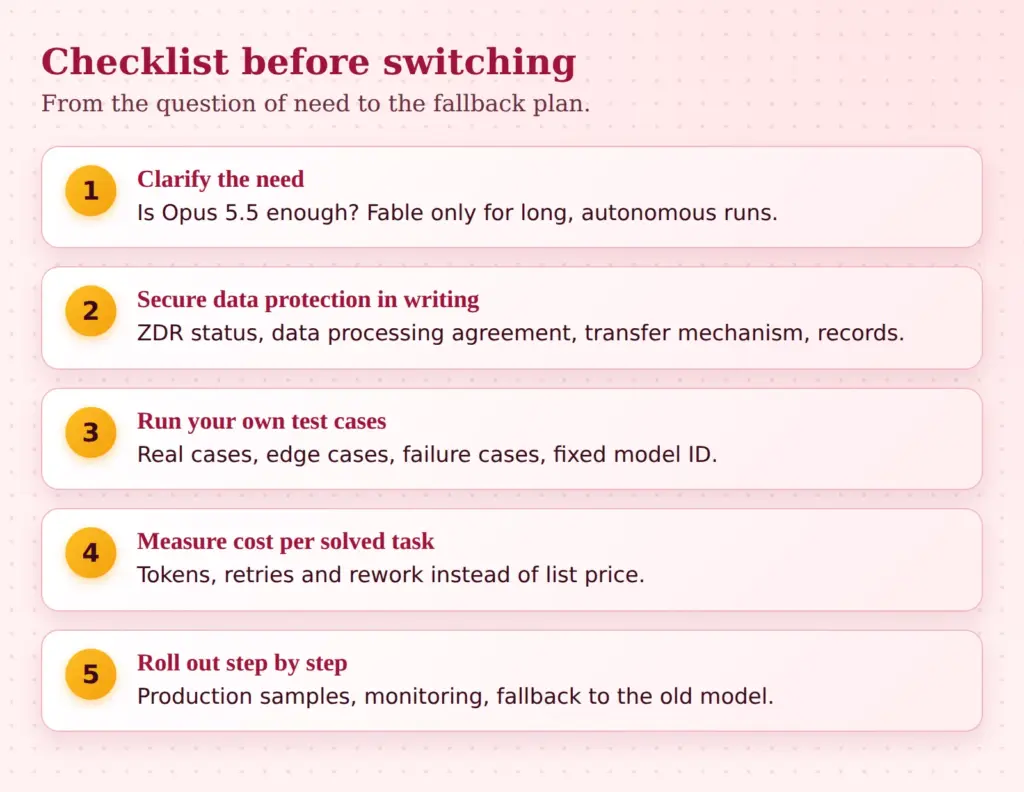
- Besoin : quels processus échouent avec le modèle actuel ? Seuls ceux-là entrent en ligne de compte pour Fable, le reste reste sur Opus 5.5 ou plus petit.
- Voie d'accès : API directe ou fournisseur cloud ? La voie détermine les paramètres, le contrat et les sous-traitants ultérieurs.
- Statut ZDR : confirmé par écrit contractuellement et techniquement, par workspace ou abonnement. Sans ZDR, la conservation de 30 jours s'applique.
- Sous-traitance et transfert : contrat, sous-traitants ultérieurs et base du transfert vers un pays tiers sont disponibles pour l'accès utilisé.
- Documentation : le registre des traitements et, le cas échéant, l'analyse d'impact relative à la protection des données sont mis à jour.
- Cas de test : un jeu de test propre avec cas réels, limites et d'erreur, sans données personnelles, avec des prompts fixes et des seuils d'arrêt.
- ID du modèle : identifiant fixe plutôt qu'alias, changement uniquement délibéré.
- Mesure des coûts : consommation de tokens, taux de réussite et retouches par type de tâche sur plusieurs semaines.
- Contrôle en exploitation : autorisations minimales, validations pour les actions sensibles, échantillons, surveillance.
- Plan de repli et responsabilité : l'ancien modèle reste réactivable, une personne porte la responsabilité de la migration.
Conclusion
Fable 5.2 est moins cher et plus rapide que son prédécesseur et pertinent pour les tâches où un modèle travaille longtemps de façon autonome. Pour la tâche exigeante du quotidien, Opus 5.5 suffit largement et ne coûte que la moitié par token. La migration est donc moins une question d'enthousiasme que d'affectation : quels processus ont réellement besoin du grand modèle ?
Sur le plan de la protection des données, la ZDR change surtout la durée de conservation. Le contrat et le transfert de données restent des tâches distinctes et doivent être documentés avant que de vraies données ne circulent. L'assurance qualité devient plus importante lorsque les modèles reconnaissent les tests. Des cas de test propres et proches de la réalité, des droits limités et des échantillons réguliers apportent plus de sécurité que n'importe quelle recette initiale. Qui suit ces étapes proprement peut employer le nouveau modèle là où il justifie son prix.
Outre la protection des données (données personnelles), il convient de s'interroger aussi sur la sécurité des données (toutes les données : secrets d'affaires, données confidentielles, données sensibles, …) !
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.