Le PDG de Google, Sundar Pichai, affirme que le secteur est encore loin de l'état final de l'auto-amélioration récursive. Dans le même temps, il décrit des boucles dans lesquelles des agents d'IA aident déjà aujourd'hui à construire de nouveaux modèles. En l'état actuel, on peut démêler ce qui est attesté sur l'IA auto-améliorante et ce que cela signifie pour l'usage de l'IA dans les petites et moyennes entreprises. L'humanité est-elle menacée ?
Le point de départ est une interview dont Big Technology a rendu compte le 23/10/2026. On y trouve une phrase sur l'IA auto-améliorante qui se prête bien à la citation : le secteur serait encore loin de l'état final de la RSI. RSI signifie Recursive Self-Improvement, c'est-à-dire auto-amélioration récursive. Il s'agit d'un cycle dans lequel des systèmes d'IA améliorent leurs successeurs, qui construisent à leur tour de meilleurs successeurs.
Les bases du fonctionnement de telles boucles sont présentées dans l'article sur l'auto-amélioration récursive de l'IA. Les déclarations tirées de l'interview, les informations communiquées par les fabricants eux-mêmes, un travail de recherche et une prévision d'initiés sont présentés ci-dessous séparément.
Ce que Pichai a dit et ce qu'il n'a pas dit
L'essentiel tient en peu de mots. Selon le compte rendu d'Alex Kantrowitz, Pichai a déclaré : « To be very clear. We are pretty far from the end state of RSI. » Ce qui signifie à peu près : « Soyons très clairs : le secteur est encore assez loin de l'état final de l'auto-amélioration récursive. » Kantrowitz oppose cette phrase à l'attente de certains acteurs du secteur de l'IA, pour qui une explosion d'intelligence serait imminente et l'IA s'améliorerait bientôt dans une boucle complète, sans intervention humaine.
Juste après suivent deux autres phrases, plus importantes pour l'analyse que la première. Pichai a déclaré : « You have RSI loops along with AI researchers in various aspects of model development. » Et : « You almost have agents helping AI researchers in some automated way work together to build these models. » En substance : dans différents domaines du développement des modèles, il existe des boucles de rétroaction avec les chercheurs, et des agents les aident en partie de manière automatisée à construire les modèles.
Ce qui est attesté mot pour mot, c'est donc ceci : des boucles partielles fonctionnent déjà, et ce en collaboration avec les chercheurs. Ces phrases ne parlent pas d'un modèle qui se transforme lui-même sans supervision. La phrase sur l'état final peut se lire comme visant précisément cette image.
En marge, Big Technology évoque la puissance de calcul. Selon Pichai, tout le monde en manque, pas seulement Google : « The compute we have today is a function of decisions I made in 2024. » D'après le compte rendu, il affirme en outre que l'activité cloud renonce régulièrement à des revenus à court terme parce que la puissance de calcul est réservée au développement des modèles de pointe. C'est pertinent pour l'auto-amélioration, car chaque boucle faite d'idée, d'expérience et d'évaluation consomme du temps de calcul. Là où il se fait rare, il freine aussi la recherche automatisée.
Aucun calendrier n'est attesté. Des reprises comme celle de DigitalToday évoquent « l'année prochaine » comme échéance pour de nouveaux progrès.
Suit une interprétation qui ne vient pas de Pichai. Parler d'un état final suppose qu'un chemin y mène et que ce chemin est déjà engagé. La phrase peut donc aussi se lire comme une déclaration en faveur de la RSI : l'évolution est en cours, Google la pousse avec des moyens considérables, et de grands succès sont envisageables d'ici quelques années. Cette attente est une appréciation propre. Aucune déclaration de Pichai en ce sens ne figure dans les sources consultées.
Une lecture possible : parler de l'état final suppose que le chemin vers celui-ci a commencé. La phrase serait alors moins un signal de fin d'alerte qu'un point de situation.
IA auto-améliorante : boucle d'agents contre modification des poids
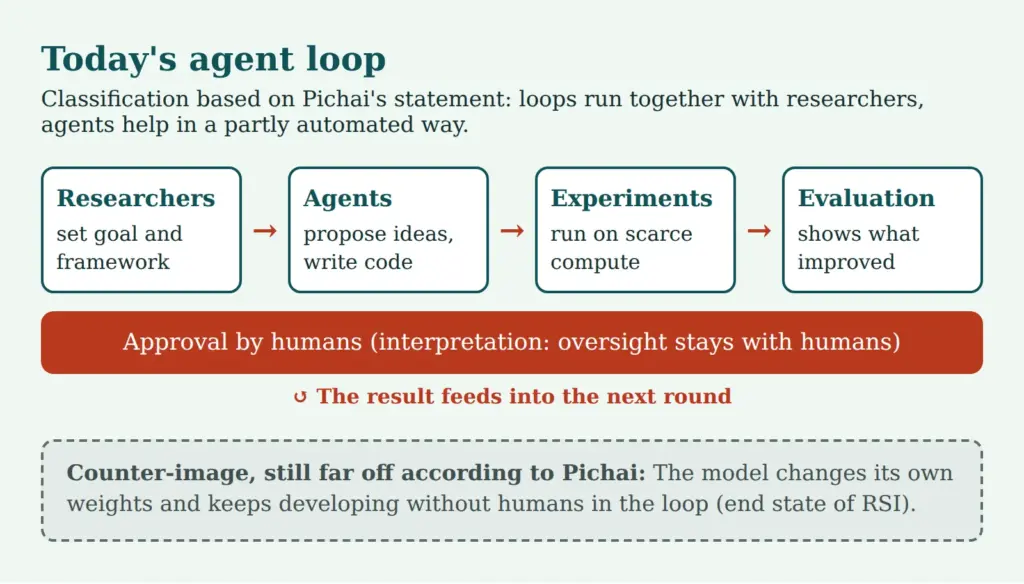
Derrière ce terme se cachent deux choses très différentes, souvent confondues au quotidien. La première est la boucle d'agents. Des agents d'IA participent au développement : ils proposent des expériences, écrivent et modifient du code, lancent des entraînements, évaluent les résultats et en rendent compte. Les humains fixent les objectifs, vérifient les résultats et décident des modifications. Le cycle améliore les processus, les outils et les méthodes de travail.
La seconde est la modification des poids. Un modèle modifierait alors ses propres poids de sorte que son successeur soit meilleur, sans qu'un humain valide les résultats entre-temps. C'est cette image qui porte la notion d'explosion d'intelligence. Et c'est précisément de cela, selon une lecture de Pichai, que le secteur est encore loin.
Entre ces deux pôles, il n'y a pas d'interrupteur, mais un continuum. Le nombre d'étapes que les agents accomplissent sans demander peut augmenter. Avec lui augmente la part du développement que les humains ne contrôlent plus que par sondage. La façon dont les agents agissent en exploitation et la raison pour laquelle cela exige un contrôle sont décrites dans l'article sur l'ère des agents d'IA.
La question centrale mérite une réponse sobre. Elle se déduit des phrases attestées.
Google pratique-t-il déjà l'auto-amélioration récursive lorsque l'IA aide à construire les modèles suivants ?
Pour les PME, la différence n'a rien d'académique. Une boucle d'agents accélère les cycles des modèles sans que la perte de contrôle soit en jeu. Une modification des poids sans supervision soulèverait la question de savoir si les humains peuvent encore suivre les changements. Les deux questions appellent des réponses différentes, et seule la première se pose concrètement aujourd'hui.
Ce que Google et d'autres rapportent sur leur propre avancement
Les déclarations des fabricants sur leurs propres progrès sont des auto-déclarations. Elles peuvent être exactes, mais elles ne sont pas vérifiées de manière indépendante. Cela vaut pour tout ce qui figure dans cette section.
Un exemple récent est Flint. Dans son annonce, l'entreprise Recursive présente le modèle comme un modèle de programmation rapide pour du matériel local, avec 40 milliards de paramètres au total et 2,5 milliards actifs par token (il s'agit donc d'un modèle Mixture of Experts). Selon ses propres dires, une petite équipe d'humains et d'agents l'a construit en moins de quatre mois. Le système de recherche automatisé, la « Eureka Machine », aurait co-développé presque chaque maillon de la chaîne de construction du modèle, des données et recettes d'entraînement jusqu'à l'inférence. Les benchmarks proviennent du fabricant et ne sont pas vérifiés de manière indépendante. Recursive prévient lui-même que Flint peut nécessiter davantage d'instructions que les grands modèles fermés.
Pour les entreprises, c'est intéressant pour deux raisons. D'abord, le cas montre que la recherche automatisée produit déjà des produits, y compris dans de petites équipes. Ensuite, le modèle fonctionne en local. Qui ne veut pas envoyer de données sensibles à des fournisseurs cloud dispose ainsi d'une option supplémentaire, sans que les affirmations du fabricant soient pour autant prouvées. La place des modèles locaux en entreprise est présentée dans l'aperçu sur l'IA locale en entreprise.
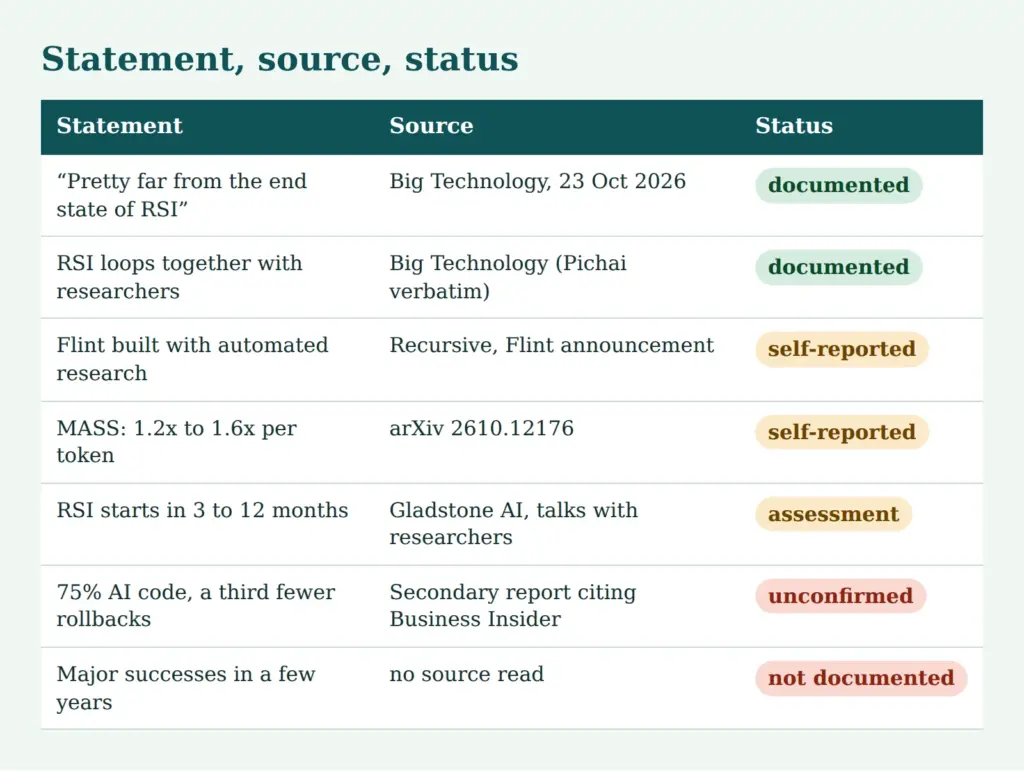
Le tableau montre comment classer les déclarations de cet article. Les deux phrases de Pichai sont attestées dans la formulation du compte rendu. Les chiffres des fabricants et de la recherche sont auto-déclarés. Gladstone est une appréciation tirée d'entretiens avec des chercheurs, pas une mesure. Le chiffre sur le code reste non confirmé, et le prétendu horizon « dans quelques années » n'est pas attesté comme déclaration de Pichai.
Ce que montre la recherche et où elle s'arrête
Un travail de recherche rend concret ce à quoi une telle boucle peut ressembler. Sous le titre « Recursive Self-Improvement through Multi-Agent Self-Supervision » (soumis le 8 octobre 2026) est décrite la méthode MASS. Un unique modèle de base, Qwen3.6-27B dans l'article, propose des workflows multi-agents, les exécute et les évalue lui-même. Il est ensuite réentraîné sur ses propres exécutions, et le procédé se répète.
Après deux cycles, le résumé fait état d'une performance par token de sortie multipliée par 1,2 à 1,6 sur quatre benchmarks ouverts. En outre, un modèle entraîné sur les exécutions de plusieurs agents serait meilleur qu'un modèle entraîné sur les exécutions d'un seul agent avec 40 % de données d'entraînement en plus.
Les limites se voient dans le matériau lui-même. Il s'agit d'un seul modèle et de deux cycles. Le signal d'amélioration provient de l'auto-évaluation. Sur les deux benchmarks de programmation Terminal-Bench 2.0 et SWE-bench Verified, une figure de l'article indique les valeurs 0,96 et 0,94, soit par token légèrement en dessous de la valeur de départ. Sur ces deux tests, la figure ne montre donc aucun gain par token.
Le point de départ des auteurs rejoint le thème de la « supervision » (de niveau supérieur). Ils écrivent qu'un modèle unique a du mal à critiquer et à améliorer ses propres raisonnements complexes lorsqu'il travaille dans une boucle homogène. C'est pourquoi ils misent sur plusieurs instances aux rôles différents. Si le même modèle produit et évalue, des erreurs communes peuvent passer inaperçues. C'est une conclusion tirée de l'approche, la formulation de l'article vise la méthode, pas les entreprises.
La recherche montre que l'idée peut fonctionner et que la vérification est le goulot d'étranglement. Elle ne montre pas que les modèles s'améliorent de façon fiable au quotidien sans humains. Cela concorde avec la phrase de Pichai et ne la contredit pas.
À quelle vitesse cela pourrait aller : Gladstone et les limites de la prévision
Des chercheurs d'Anthropic, d'OpenAI et de Google DeepMind s'attendraient à ce que l'auto-amélioration récursive commence dans les trois à douze prochains mois, peut-être plus tôt, en supposant que le gouvernement américain n'intervienne pas ni ne freine.
Les personnes interrogées ont un intérêt propre à la dynamique du domaine, et les auteurs sont une organisation axée sur la politique de sécurité.
La recherche automatisée pourrait être techniquement possible sans être rentable. Les bonnes idées ne seraient pas le goulot d'étranglement, mais le temps de calcul nécessaire pour les tester. Cela rejoint la remarque de Pichai sur la rareté de la puissance de calcul.
Ces déclarations ne s'excluent pas. « Début » et « état final » sont des points différents sur le même chemin. Pichai dit que le chemin est long et décrit en même temps des boucles qui tournent avec les chercheurs. Gladstone s'attend à ce qu'une partie de cela devienne bientôt plus autonome. Qui lit les deux obtient une image dans laquelle l'auto-amélioration récursive progresse pas à pas. Fonder une planification uniquement sur des indications en mois est risqué, car elles proviennent d'un petit cercle d'entretiens.
Conséquences pour les PME : tester les cycles et les changements de modèle
Pour les entreprises, l'effet ne se manifeste pas sous la forme d'une explosion d'intelligence, mais dans le calendrier et la technique. Si des agents soulagent les chercheurs, de nouvelles versions de modèles peuvent paraître plus souvent. Pour l'exploitation, une chose compte cependant, quelle qu'en soit la cause : les modèles changent plus vite que les services métiers n'adaptent leurs processus.
Cela a des conséquences pratiques. Un modèle peut répondre différemment de son prédécesseur au même prompt. Le ton, le format, les types d'erreurs et le coût par tâche évoluent. Les fournisseurs arrêtent d'anciennes versions, parfois à bref délai. Et qui mise sur l'alias « latest » reçoit des modifications en production sans les avoir demandées.
Il en découle une démarche simple pour le changement de modèle. Premièrement, un corpus de test composé de tâches réelles, par exemple 50 à 200 cas anonymisés dont la bonne réponse est connue (on peut même en partie les générer avec l'IA !). Deuxièmement, une exécution comparative du nouveau modèle face à la version actuelle avec des prompts inchangés. Troisièmement, une validation par une personne désignée qui a examiné la qualité, les coûts et le profil d'erreurs. Quatrièmement, un chemin de retour arrière (rollback), c'est-à-dire une version de modèle figée et une configuration conservée, pour que le retour en arrière se fasse en quelques minutes.
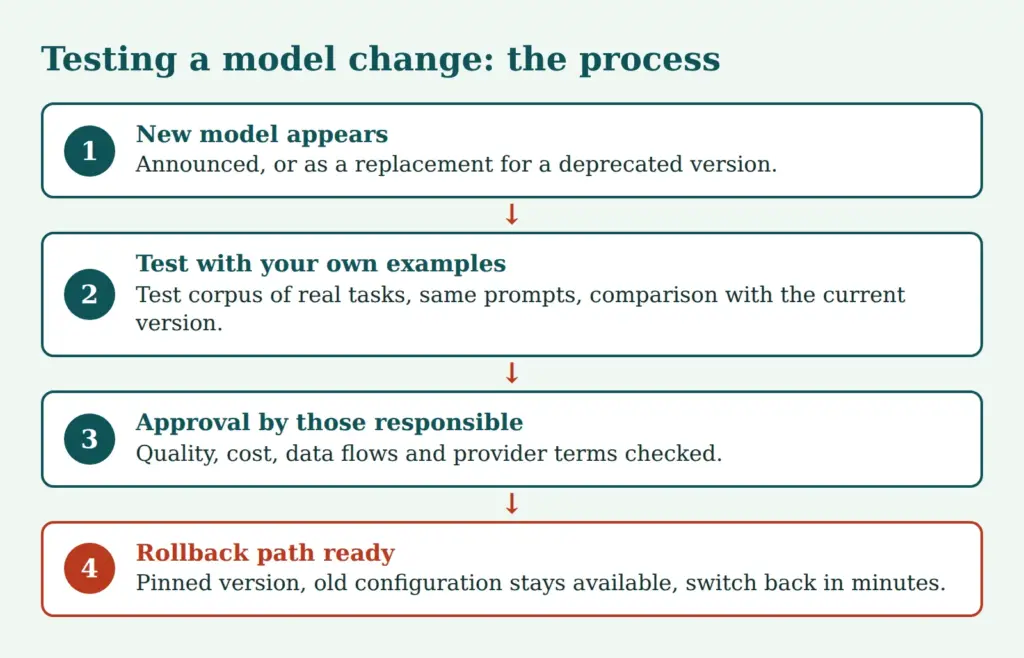
En cas de changement de fournisseur ou de nouveau modèle d'un fournisseur existant, la protection des données et le contrat entrent en jeu. Il faut clarifier les flux de données, la localisation des serveurs, la sous-traitance des données et la question de savoir si les saisies sont utilisées pour l'entraînement. Une mise à niveau automatique vers le modèle le plus récent ne devrait pas être autorisée en production. Les modèles locaux déplacent la question : ils suppriment la dépendance vis-à-vis du fournisseur et apportent leur propre maintenance, voir l'aperçu sur l'IA locale.
Les petites entreprises n'ont pas besoin de créer pour cela leur propre service de test. Un tableau d'exemples, un script qui les envoie aux deux modèles et une courte note de validation suffisent pour commencer.
Maintenir la supervision et les validations : ce qui reste la tâche de l'humain
Lorsque des développeurs internes utilisent des agents disposant de droits d'écriture, la même boucle que dans les laboratoires apparaît à petite échelle : l'agent modifie le code, les tests s'exécutent, l'agent corrige. La supervision peut suivre le même schéma. L'agent peut proposer et tester, mais une personne désignée valide les modifications des systèmes de production, des configurations et des données.
Cela inclut des journaux qui permettent de retracer ce que l'agent a fait, et des droits aussi restreints que nécessaire. Supprimer, envoyer et payer sont des actions qui méritent une confirmation supplémentaire. Les risques d'un agent sans contrôle sont décrits dans l'article Le danger derrière les agents d'IA.
La question de savoir qui vérifie est également importante. Si le même modèle produit et évalue, les mêmes angles morts subsistent. En exploitation, cela signifie : une IA peut en vérifier une autre, mais seulement en complément. La contre-vérification fiable vient de tests, d'un autre fournisseur ou d'un humain.
L'IA ne vérifie l'IA de manière fiable que si la contre-vérification est indépendante : par des tests, un autre fournisseur ou un humain.
La responsabilité reste à l'entreprise qui déploie l'agent. Cela vaut quelle que soit la part du développement automatisée en arrière-plan. Affirmer que l'IA s'améliore elle-même ne décharge pas l'exploitant.
Liste de contrôle : ce qu'il faut faire maintenant et ce qu'il faut éviter
Une liste de contrôle doit aider à répondre à la question de ce qu'il faut faire maintenant et de ce qu'il ne faut pas faire :
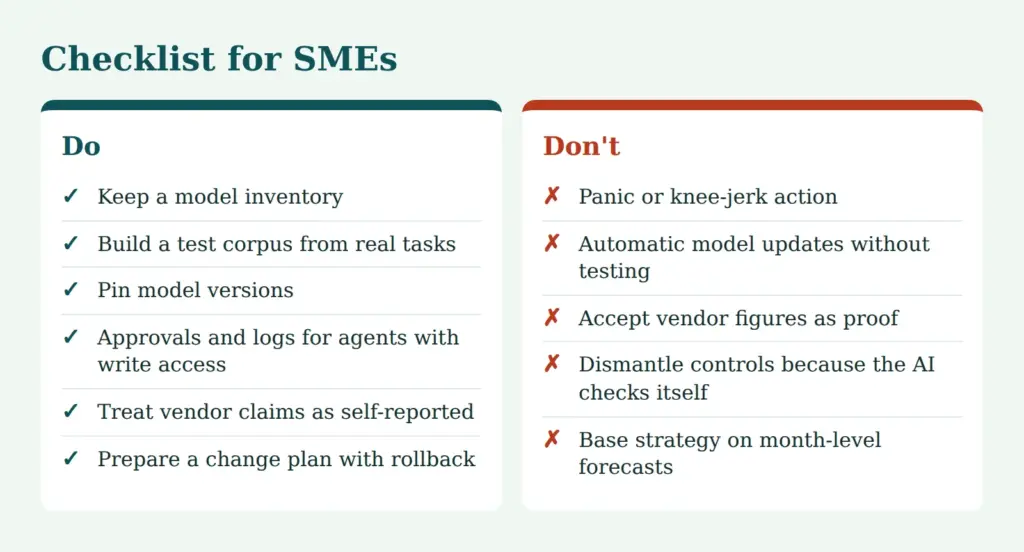
Les points en détail :
L'inventaire des modèles consigne quels modèles tournent où et dans quelle version, qui en est responsable et quelles données circulent. Le corpus de test s'enrichit à chaque erreur constatée en exploitation. Les versions sont figées et ne sont modifiées qu'après test. Les agents disposant de droits d'écriture sont soumis à des validations et à une journalisation. Les affirmations des fabricants, qu'elles portent sur des benchmarks ou sur la part de l'IA dans le code, sont traitées comme des auto-déclarations et non comme des preuves.
La panique et l'activisme ne sont pas recommandés, car la situation attestée est une boucle partielle avec des humains. Il ne faut pas non plus démanteler les contrôles sous prétexte qu'une IA se vérifie elle-même. Et les stratégies fondées sur des indications en mois tirées de prévisions reposent sur un terrain fragile. Pour vérifier en plus l'aspect technique, par exemple les droits et la surface d'attaque des systèmes, les contrôles de sécurité de wwwschutz.de offrent un point d'entrée.
Conclusion
En résumé, les déclarations et l'état actuel, qui peut changer chaque jour, se classent ainsi.
Pichai atteste qu'il existe des boucles de rétroaction avec les chercheurs et que l'état final sans humains est encore lointain. Ce n'est pas une fin d'alerte. Une lecture possible est que le chemin est déjà engagé et que de grands progrès sont possibles d'ici quelques années.
Pour les PME, ce qui compte, ce sont des cycles de modèles plus courts, des tests avant chaque changement, des versions figées et des validations pour les agents. Personne ne sait aujourd'hui de manière fiable si la boucle deviendra nettement plus autonome dans trois mois ou dans trois ans. Qui maîtrise les tests, les validations et le retour arrière est préparé aux deux cas.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.