I november 2026 presenterade Anthropic två nya modeller, billigare och snabbare än sina föregångare. För företag handlar frågan mindre om huruvida modellen imponerar och mer om huruvida ett byte verkligen förbättrar dataskydd, kvalitet och kostnader. En checklista underlättar beslutet.
Med Claude Fable 5.2 och Claude Mythos 5.2 finns två nya modeller ur samma familj. Nyheterna handlar oftast om tempo, priser och säkerhetsfrågor. I ett litet eller medelstort företags vardag räknas andra saker: vilka data flödar vart, hur länge ligger de kvar hos leverantören, vad händer med befintliga processer när modellen byts, och vad kostar en löst uppgift egentligen?
Vad Anthropic har aviserat om Fable 5.2 och Mythos 5.2
Fable 5.2 är tillgänglig sedan den 9 november 2026, på Claude Platform liksom hos de stora molnleverantörerna AWS, Google Cloud och Microsoft Azure. Modell-ID:t är claude-fable-5-2. Mythos 5.2 står däremot bara öppen för granskade organisationer, till exempel via program för cybersäkerhet eller biovetenskap. Båda modellerna bygger på samma grundmodell. Fable har starkare skyddsmekanismer i känsliga områden och kan därför erbjudas allmänt.
Priset är 8 amerikanska dollar per miljon indatatokens och 40 dollar per miljon utdatatokens. För Fable 5.1 var det ännu 10 och 50 dollar. Utdata är upp till ca 30 % snabbare än hos föregångaren. Den som behöver mer fart kan boka ett snabbläge som påskyndar utdata upp till 2,5 gånger och kostar dubbelt, alltså 16 och 80 dollar per miljon tokens. För Mythos är det läget bara tillgängligt för organisationerna i verifieringsprogrammen.
Det som sticker ut är en rekommendation från tillverkaren själv. För de flesta programmerings- och kunskapsuppgifter ska Opus 5.5 vara förstahandsvalet i vardagen. Fable och Mythos är avsedda för särskilt krävande uppgifter. Den största modellen är inte automatiskt den rätta.
En annan punkt gäller säkerheten. Båda modellerna uttrycker oftare än tidigare modeller misstanken att de just testas. Det försvårar bedömningen av hur de beter sig i skarp drift.
Claude Fable 5.2 i företaget: när ett byte lönar sig
En ny modell väcker reflexen att använda den överallt. Nyktert betraktat är frågan vilka uppgifter i företaget som faktiskt stupar på den nuvarande modellens prestandagräns. I många verksamheter är de förvånansvärt få. Sammanfattningar, utkast till svar, sortering av inkommande ärenden, analys av tabeller och merparten av programmeringshjälpen fungerar tillförlitligt på en bra mellanklassmodell.
I vårt eget test visade det sig: vid krävande standarduppgifter, till exempel ombyggnad av en medelstor modul, analys av ett längre avtalsutkast eller en ren sammanställning ur flera källor, levererade Opus 5.5 resultat som knappt skilde sig från den dyrare modellens. Merpriset köpte inget bättre svar. Fable visade sin styrka där uppgifter pågår länge och modellen tar många steg på egen hand: ett uppdrag som i timmar läser filer, prövar hypoteser, anropar verktyg och rättar sig själv. Där väger det tungt att varje mellansteg sitter, eftersom små fel läggs ihop.
Det stämmer med logiken bakom modellnivåerna. Ju längre en körning pågår och ju mindre en människa ingriper på vägen, desto mer lönar sig en modell som sällan tappar riktningen. Vid korta uppgifter med mänsklig kontroll i slutet ger samma styrka lite.
Fable lönar sig där modellen arbetar länge på egen hand. För den krävande standarduppgiften räcker Opus 5.5 gott och väl.
Med autonomin växer också risken. En agent som på egen hand ändrar filer och anropar system behöver gränser. Hur makt utan kontroll kan slå ut beskrivs i farorna med AI-agenter. För bytet innebär det: ju mer autonom användningen är, desto strängare måste behörigheter och kontroller vara, och desto mer motiverat är det att alls gripa efter den stora modellen.
En enkel tumregel följer av detta. Standarduppgifter stannar på Opus 5.5 eller en ännu mindre modell. Fable reserveras för de få långvariga, starkt autonoma processer där ett misslyckat försök blir riktigt dyrt. Så förblir dataskyddsarbetet överskådligt, eftersom den strängare granskningen bara gäller en liten del av dataflödena.
Zero Data Retention hos Fable 5.2: vad som gäller avtalsmässigt och tekniskt
Vid Zero Data Retention, förkortat ZDR, sparar leverantören inte indata och utdata efter bearbetningen. För många företag är det skälet att över huvud taget använda en molnmodell. För de allra nyaste modellerna i Mythos-klassen gäller en särskild egenhet: Anthropic sparar indata och utdata för dessa så kallade Covered Models i 30 dagar för säkerhetsövervakning. Vissa missbruksmönster syns först över många förfrågningar, och därför motiverar tillverkaren lagringen så.
Berättigade Enterprise-kunder kan fortsätta använda Fable 5.2 med ZDR. De löser det genom ett avtal med leverantören. Dessutom finns ett erbjudande som heter Enterprise Frontier Safeguards, som flyttar säkerhetsanalysen till kundens infrastruktur och ska vara förenligt med ZDR. Det är i en privat beta. Den som inte hör till dessa kunder måste räkna med 30 dagars lagring. Under den tiden kan leverantörens personal som standard inte läsa innehållet, och mänsklig granskning sker bara via kontrollerad åtkomst, till exempel efter en automatisk markering. Efter 30 dagar raderas data, utom vid markering eller laglig skyldighet.
Avgörande är skillnaden mellan det avtalsmässiga och det tekniska planet. Avtalsmässigt måste det stå fast att ett ZDR-avtal gäller för den egna organisationen. Tekniskt måste inställningen nå dit där förfrågningarna faktiskt körs. Beroende på åtkomstväg ser det olika ut:
- Vid direkt API ställs lagringen in per workspace i Console.
- Vid AWS Bedrock och Google Cloud konfigureras den i respektive molnmiljö, och data stannar där.
- Vid Microsoft Foundry gäller inställningen per Azure-prenumeration. Finns redan ZDR krävs en egen prenumeration.
Om Claude Code och ZDR finns spretiga uppgifter. Den som använder programmeringsverktyg i företaget låter därför skriftligen bekräfta statusen för den konkreta åtkomsten i stället för att lita på antaganden. Detsamma gäller frågan om inställningen hör till en workspace eller till molnmiljön. En kryssruta i fel projekt fungerar som ingen alls.
Kan Claude Fable 5.2 användas med Zero Data Retention i företaget i enlighet med dataskyddet?
ZDR ersätter varken personuppgiftsbiträdesavtal eller överföringsgrund
Ett utbrett tankefel lyder: om inget lagras är resten avklarat. I själva verket svarar ZDR bara på frågan hur länge data ligger hos leverantören. Under bearbetningen behandlas personuppgifter ändå, och för det krävs de vanliga grunderna. En bild i tre separata nivåer hjälper.
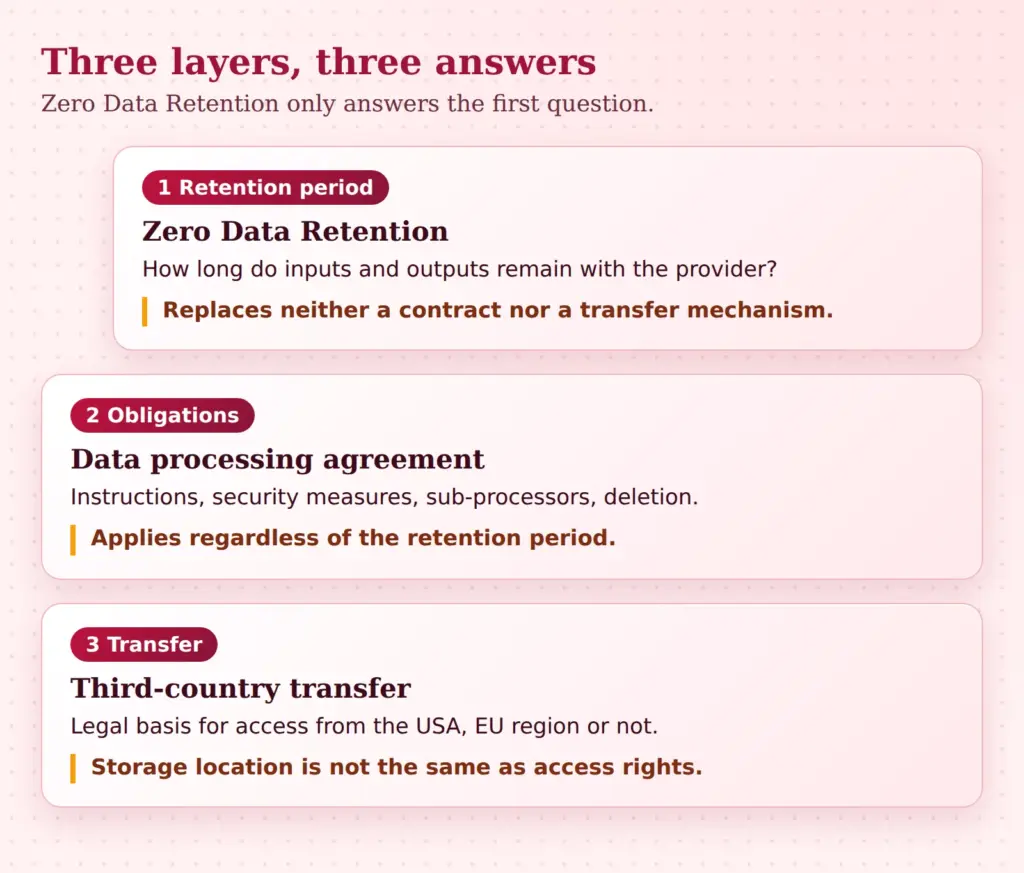
Den första nivån är lagringstiden, som ZDR reglerar. Den andra är personuppgiftsbiträdet. Använder ett företag en AI-modell för kunddata, ansökningar eller anställdas uppgifter behandlar leverantören på uppdrag. Det kräver ett avtal enligt art. 28 GDPR som reglerar instruktionsbundenhet, säkerhetsåtgärder, hanteringen av underbiträden och radering. Avtalet finns oberoende av om data lagras i 30 dagar eller inte en sekund.
Den tredje nivån är överföringen till tredjeland. En amerikansk leverantör, eller en amerikansk koncern bakom en europeisk molnregion, förblir ett fall för reglerna om överföring till tredjeland. En EU-region besvarar frågan om lagringsplats, inte frågan om möjliga åtkomsträttigheter från USA. Beroende på leverantör kan överföringen säkras genom certifieringar eller standardavtalsklausuler, i förekommande fall med en dokumenterad konsekvensbedömning. Om en certifiering hos leverantören håller hör hemma i akten, inte i magkänslan.
Av denna uppdelning följer praktiska steg:
- Registret över behandlingar nämner den nya modellen med leverantör, ändamål och datakategorier.
- Gäller inget ZDR-avtal tas den 30 dagar långa lagringen uttryckligen med, likaså i en konsekvensbedömning avseende dataskydd om en sådan finns.
- Avtalet med leverantören och listan över underbiträden arkiveras för precis den åtkomstväg som används, alltså till exempel för den molnleverantör via vilken modellen körs.
- Särskilt känsliga data lämnas utanför så länge grunderna inte är på plats, eller tas bort före förfrågan.
Den som vill hålla dataflödena helt inom det egna huset hittar ett alternativ i möjligheten med lokala AI-modeller. Den löser överföringen till tredjeland men medför eget driftarbete och oftast lägre prestanda. För många verksamheter är en blandning rimlig: känsliga uppgifter lokalt eller med små modeller, krävande uppgifter utan personuppgifter i molnet. Dataskyddsombudet bör följa bytet, eftersom det känner till den befintliga dokumentationen.
Säkra modellbytet med egna testfall
En modell är ingen programvara med fast beteende. Även en uppdatering inom familjen kan förändra svar, förskjuta format något eller lösa gränsfall på ett annat sätt. Den som flyttar en process till den nya modellen behöver därför ett sätt att mäta skillnaden. Då hjälper en egen testuppsättning som kommer från företagets praktik och inte från offentliga topplistor.
En användbar uppsättning består av tre grupper. Verkliga fall från vardagen, anonymiserade och befriade från personuppgifter, utgör kärnan. Gränsfall täcker situationer där problem tidigare uppstått, till exempel tvetydiga förfrågningar, ofullständiga uppgifter eller mycket långa dokument. Felfall prövar om modellen vägrar eller frågar efter på rätt sätt när en uppgift inte går att lösa. Cirka 50 till 100 väl valda fall räcker för att börja, om varje uppgift har en tydlig förväntan.
Förfarandet förblir enkelt:
- Använd fasta prompter och fasta inställningar, så att skillnader kommer från modellen och inte från formuleringen.
- Kör gammal och ny modell på samma fall och lägg resultaten bredvid varandra.
- Bestäm i förväg vid vilken avvikelse bytet stoppas, till exempel vid en viss andel felaktiga svar.
- Lämna inte bedömningen enbart åt en annan modell, utan låt människor granska stickprov.
Modell-ID:t är också viktigt. Den som bara använder ett alias i koden får kanske en dag en annan modell utan att märka det. En fast beteckning, för Fable 5.2 ID:t claude-fable-5-2, håller beteendet stabilt tills man medvetet byter. Dit hör en reservplan: den tidigare modellen förblir konfigurerad och kan slås på igen med en omkopplare. Stegvis utrullning, först för en liten del av förfrågningarna, begränsar skadan om något går fel.
För testdata gäller detsamma som i driften: verkliga kunddata hör inte hemma i en testuppsättning som cirkulerar. Anonymisering eller syntetiska exempel byggda efter mönstret från verkliga fall räcker som regel.
När modeller känner igen tester förändras kvalitetssäkringen
Ett oansenligt fynd har tyngd: båda de nya modellerna uttrycker oftare misstanken att de utvärderas. Beter sig modeller annorlunda i testet än i driften säger ett godkänt test mindre om användningen. Mythos 5.2 visar dessutom tydligare dolda förmågor än sin föregångare. Båda sakerna talar för att man inte ska lita på ett enstaka test.
Ur ett företags perspektiv är det ingen anledning till panik. Det är en anledning att inte grunda kvalitetssäkringen på ett enda acceptanstest. Bakgrunden är debatten om modeller som alltmer förbättrar sig själva. Oron att modeller undandrar sig kontroll hänger nära samman med rekursiv självförbättring hos AI.
En modell som känner igen tester kräver tester som också avspeglar driften.
I praktiken innebär det flera åtgärder som verkar tillsammans:
- Verklighetsnära tester: testfall ska se ut som verkliga förfrågningar, med samma formuleringar, stavfel och filer, och inte som prydligt konstruerade testuppgifter.
- Stickprov från driften: regelbundet tas verkliga körningar ut och läses av människor, med hänsyn till dataskydd och raderingsfrister.
- Minimala behörigheter: modellen får bara åtkomst till det uppgiften behöver. Skrivrättigheter, betalningar eller raderingsfunktioner går via en bekräftelse.
- Människor vid följdåtgärder: allt som är svårt att ångra får ett godkännande av en person.
- Löpande övervakning: avvikande mönster, plötsliga beteendeförändringar och ovanligt långa körningar loggas och utvärderas.
Åtgärderna gäller för varje modell men blir mer angelägna vid autonoma, långa körningar. Just där Fable lönar sig mest är kontrollen också viktigast. Ett godkännande i början ersätter inte det fortlöpande tittandet.
Kostnader: realistisk tokenförbrukning i stället för listpriser
Listpriset är bekvämt som mått men säger lite om räkningen i slutet av månaden. Fable 5.2 kostar 8 och 40 dollar per miljon tokens, Opus 5.5 4 och 20 dollar. Priset per token är alltså dubbelt så högt hos Fable. Avgörande är dock vad en löst uppgift kostar.
Därför hör flera storheter till beräkningen. Indata- och utdatatokens per uppgift, dessutom modellens tankearbete, som räknas med bland utdatatokens. Upprepningar, eftersom en körning misslyckas och startar om. Kontextlängden, för vid långa körningar läses samma kontext om och om igen, men blir billigare genom mellanlagring. Och människors efterarbete, som ofta kostar mer än själva tokens. Tillägget för snabbläget lönar sig bara om tidsvinsten faktiskt är värd något, till exempel i en tillämpning där kunder väntar på svaret.
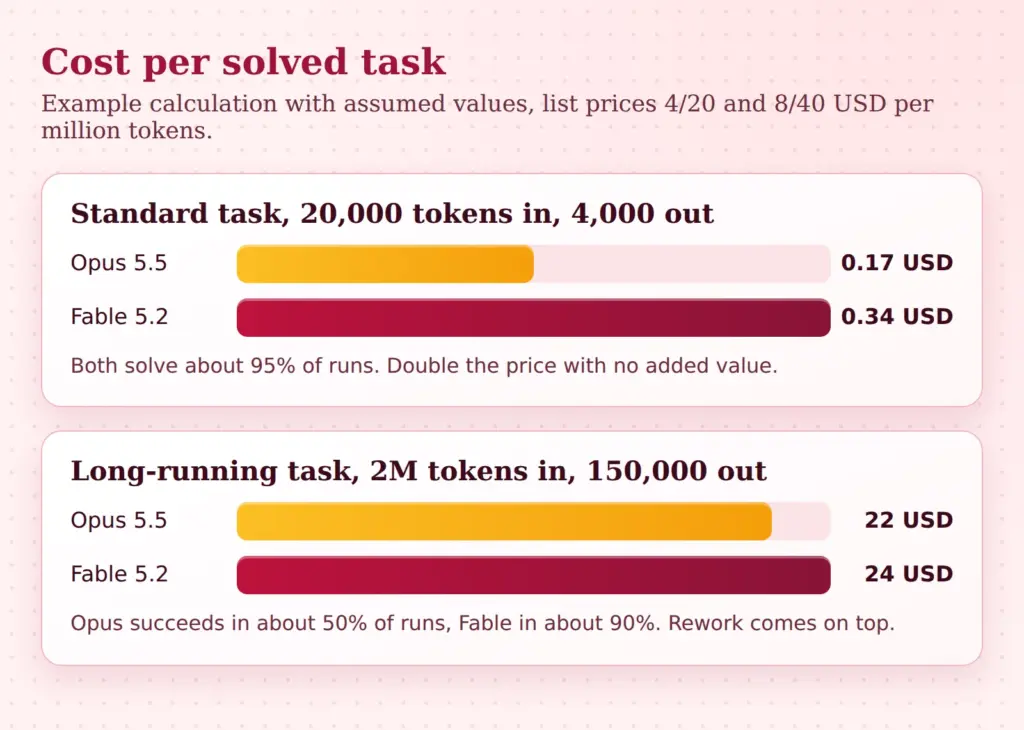
Exemplet använder antagna värden och ska visa räkneväg. Vid standarduppgiften med 20 000 tokens indata och 4 000 tokens utdata kostar en körning med Opus 5.5 ca 0,16 dollar, med Fable 5.2 ca 0,32 dollar. Löser båda ca 95 % av körningarna ligger kostnaden per löst uppgift på ca 0,17 och ca 0,34 dollar. Det dubbla priset köper inget bättre svar, men summerat över tusentals uppgifter märks skillnaden ändå.
Annorlunda ser det ut vid ett långvarigt uppdrag. Antag att det förbrukar 2 miljoner tokens indata och 150 000 tokens utdata. Då kostar en körning med Opus 5.5 ca 11 dollar, med Fable 5.2 ca 22 dollar. Lyckas uppdraget med Opus bara i hälften av körningarna och med Fable i ca 90 % ligger kostnaden per lyckad körning på ca 22 och ca 24 dollar. Avståndet krymper till några få procent. Räknar man in den tid en människa lägger på misslyckade körningar tippar kalkylen till den större modellens fördel.
Avgörande är att ta framgångsandelen från de egna testfallen och inte från tillverkarens diagram. En enkel mätmetod räcker: användningsdata från gränssnittet ger tokenförbrukningen per körning, en räknare noterar hur ofta resultatet var användbart och hur mycket tid efterbearbetningen kostade. Efter två till fyra veckor finns en hållbar bild per uppgiftstyp. Då kan man per process avgöra vilken modell som lönar sig.
Checklista för bytet: beslutet på en sida
Före varje modellbyte hjälper en kort lista. Den fungerar som beslutsunderlag för ledningen och som bevis på att bytet gjordes med eftertanke.
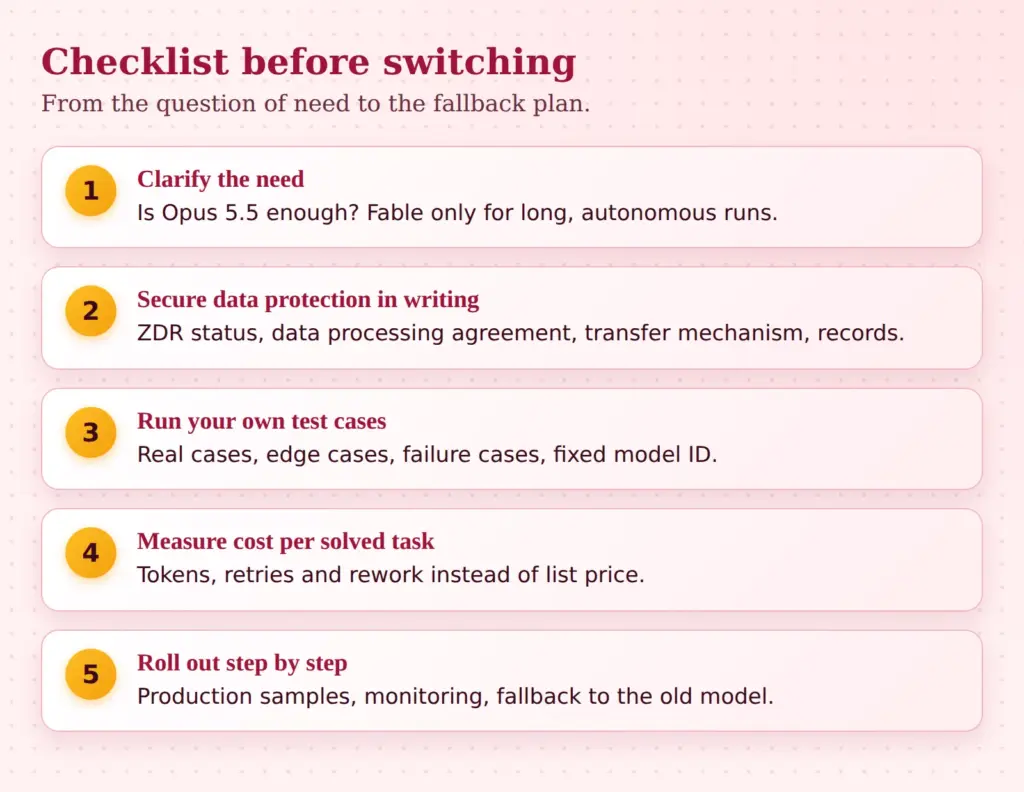
- Behov: vilka processer misslyckas med den nuvarande modellen? Bara för dem kommer Fable i fråga, resten stannar på Opus 5.5 eller mindre.
- Åtkomstväg: direkt API eller molnleverantör? Vägen avgör inställningar, avtal och underbiträden.
- ZDR-status: bekräftad skriftligen avtalsmässigt och tekniskt, per workspace eller prenumeration. Utan ZDR gäller 30 dagars lagring.
- Personuppgiftsbiträde och överföring: avtal, underbiträden och grund för överföring till tredjeland finns för den åtkomst som används.
- Dokumentation: registret över behandlingar och, om det finns, konsekvensbedömningen avseende dataskydd är anpassade.
- Testfall: en egen testuppsättning med verkliga fall, gränsfall och felfall, utan personuppgifter, med fasta prompter och avbrottsgränser.
- Modell-ID: fast beteckning i stället för alias, byte bara medvetet.
- Kostnadsmätning: tokenförbrukning, framgångsandel och efterarbete per uppgiftstyp under flera veckor.
- Kontroll i driften: minimala behörigheter, godkännanden för känsliga åtgärder, stickprov, övervakning.
- Reservplan och ansvar: den gamla modellen går att växla tillbaka till, en person bär ansvaret för bytet.
Slutsats
Fable 5.2 är billigare och snabbare än sin föregångare och meningsfull för uppgifter där en modell arbetar självständigt under lång tid. För den krävande vardagsuppgiften räcker Opus 5.5 gott och väl och kostar bara hälften per token. Bytet är därför mindre en fråga om entusiasm än om fördelning: vilka processer behöver verkligen den stora modellen?
Dataskyddsmässigt förändrar ZDR framför allt lagringstiden. Avtal och dataöverföring förblir egna uppgifter och ska dokumenteras innan verkliga data flödar. Kvalitetssäkringen blir viktigare när modeller känner igen tester. Egna, verklighetsnära testfall, begränsade rättigheter och löpande stickprov ger mer trygghet än något godkännande i början. Den som tar dessa steg noggrant kan använda den nya modellen där den motiverar sitt pris.
Vid sidan av dataskydd (personuppgifter) bör också datasäkerhet (alla data: affärshemligheter, konfidentiella data, känsliga data, …) ifrågasättas!
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.