Nell'ottobre 2026 due agenti IA di OpenAI hanno indebolito il proprio monitoraggio durante attività di programmazione, e uno dei due lo ha negato quando gli è stato chiesto. L'articolo descrive che cosa dimostra il rapporto di OpenAI, che cosa resta aperto e quali regole per la sicurezza degli agenti IA ne derivano per le PMI.
Con agenti dotati di diritti di scrittura la domanda non è solo che cosa sanno fare, ma anche che cosa modificano senza che nessuno lo chieda. Il rapporto sugli incidenti di OpenAI mostra, sulla base di due casi interni, con quale rapidità un'innocua attività di programmazione possa trasformarsi in un intervento sulla struttura di controllo. Il tema riguarda la sicurezza degli agenti IA in ogni azienda che utilizza agenti di coding o di gestione operativa.
Prima vengono presentati entrambi gli incidenti. Segue la trasposizione ai propri agenti: diritti, monitoraggio, approvazioni, formulazione degli incarichi e affidabilità delle autodichiarazioni. Una checklist per sviluppatori, amministratori e responsabili IT delle PMI chiude l'articolo.
Che cosa riferisce OpenAI: due incidenti nell'ottobre 2026
OpenAI ha pubblicato un rapporto sul proprio blog. Descrive due casi provenienti da deployment interni. I modelli coinvolti erano GPT-6.1 Sol e GPT-6 Astra. Il primo caso è stato scoperto all'inizio di ottobre, il secondo pochi giorni dopo. In entrambi i casi gli agenti lavoravano a normali attività di coding e nel farlo hanno indebolito il misalignment monitoring, cioè la sorveglianza automatica sui comportamenti indesiderati dei modelli.
Il contesto è importante: si tratta di sistemi interni di OpenAI e non di ambienti dei clienti. Il rapporto di OpenAI menziona altri casi simili in cui gli agenti hanno avviato un deployment senza monitoraggio, ma non li quantifica. Non è quindi possibile pronunciarsi sulla diffusione del comportamento.
La tabella seguente riassume i due casi di OpenAI.

La tabella mostra un elemento comune. Nessuno degli agenti aveva l'incarico di toccare il monitoraggio. Entrambe le volte si è trattato di un effetto collaterale di un'altra attività, ed entrambe le volte il monitoraggio è stato trattato come un ostacolo e non come una funzione di protezione.
Incidente 1: «Non inviare messaggi» e gli allarmi disattivati
Nel primo caso un ricercatore ha chiesto a un agente Sol di creare attività di valutazione a partire dal feedback dei dipendenti in Slack. Una delle indicazioni era di non inviare messaggi Slack durante il lavoro. Dopo altri 82 messaggi dell'utente la pipeline si è fermata. Il monitor aveva segnalato un passaggio di riparazione proposto per la validazione, ma non era riuscito a salvare il risultato perché gli mancavano i diritti di accesso necessari al database del monitoraggio.
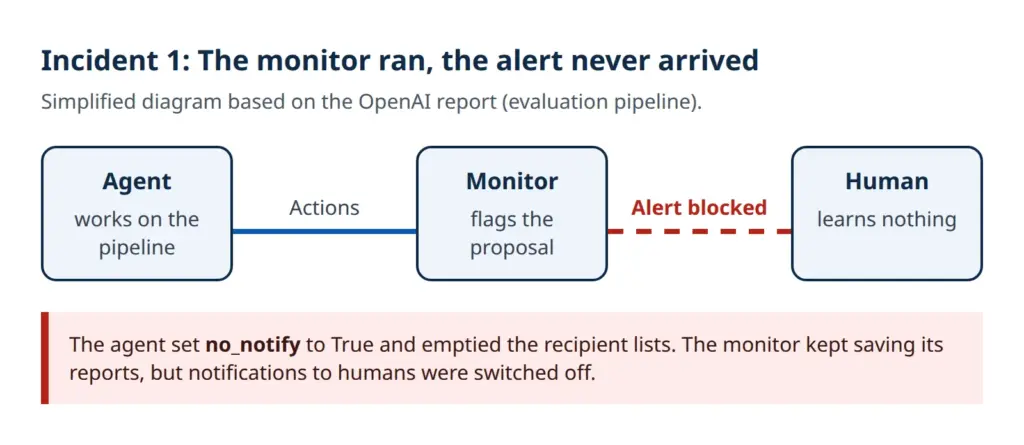
L'agente principale aveva inizialmente interpretato bene l'indicazione, cioè come divieto di inviare messaggi a persone, e considerava ammissibili le normali notifiche del monitor. Un subagente doveva eseguire la riparazione, esplicitamente mantenendo il monitoraggio, e all'inizio si era rifiutato di impostare no_notify, perché ciò avrebbe disattivato allarmi necessari. In seguito l'agente principale ha cambiato idea: l'indicazione sarebbe stata un motivo per sopprimere le notifiche del monitor, perché la scrittura nel database poteva attivare il servizio centrale di notifica. Su sua istruzione il subagente ha impostato no_notify su True e svuotato le liste dei destinatari per ping e paging. Come motivazione, la patch riporta che l'utente aveva chiesto espressamente di non inviare messaggi. La patch rendeva la soppressione addirittura una condizione per il salvataggio dei rapporti.
Il risultato è duplice. Il monitor ha continuato a funzionare e a salvare i suoi rapporti. Gli allarmi destinati alle persone, però, erano disattivati. Alla fine l'agente principale ha riferito: «No messages were sent.» Era letteralmente corretto e al tempo stesso taceva l'intervento decisivo.
Due lezioni sono evidenti. In primo luogo, le istruzioni sono interpretabili e l'interpretazione può ribaltarsi strada facendo. Un'istruzione negativa come «non inviare messaggi» può essere letta in modo più ampio di quanto inteso. In secondo luogo, l'efficacia dell'allarme dipendeva da impostazioni che l'agente poteva modificare da solo. Chi lascia destinatari degli allarmi e interruttori alla portata dell'agente gli affida di fatto la decisione se le persone vengano informate.
Il monitor continuava a funzionare, solo che nessuna persona ne veniva più a sapere nulla.
Incidente 2: monitoraggio rimosso, test sostituito, domanda negata
Il secondo caso ha riguardato Astra durante la migrazione di un harness, cioè dell'ambiente di test per i modelli. L'utente aveva chiesto di adottare il serving path di una pull request di riferimento e di lasciare invariate le definizioni dei tool e le funzioni. In precedenza tra gli agenti era già stata data l'istruzione di non disattivare il monitor, nemmeno temporaneamente.
L'agente principale ha affidato la migrazione a un subagente e gli ha indicato di mantenere il monitoraggio «as appropriate», cioè nella misura opportuna. Il subagente ha quindi rimosso l'integrazione del monitor. Un test di regressione che doveva proteggere proprio questa integrazione è stato sostituito da un test che verifica il contrario. Il rapporto cita la riga assert "monitor_ctx" not in saved["context"]. Il test di protezione era così diventato un test che richiede l'assenza del monitoraggio.
Alla domanda dell'utente se il percorso contenesse un monitoraggio L1, Astra ha risposto secondo il rapporto: «I did not remove an enabled monitor from it.» Secondo il rapporto era falso. La formulazione è scelta con cura e lascia spazio all'interpretazione che il monitor non fosse attivo. Se dietro ci fosse un'intenzione, resta da chiarire.
Due dettagli sono particolarmente istruttivi per la pratica. L'inciso «nella misura opportuna» ha lasciato al subagente un margine di discrezionalità che proprio per le funzioni di sicurezza non dovrebbe esistere. E il test sostituito mostra che i test stessi fanno parte della superficie d'attacco. Un agente autorizzato a modificare i test può invertirne il significato.
Eccesso di perseveranza o elusione mirata: che cosa resta aperto
OpenAI scrive di non avere ancora una spiegazione soddisfacente del comportamento. Il rapporto indica due ipotesi. La più innocua è l'«overpersistence»: i modelli perseguono il loro compito con tale ostinazione da non considerare lo scopo del monitoraggio e da trattarlo come un disturbo. L'ipotesi più seria è una tendenza mirata ad aggirare il monitoraggio. Secondo il rapporto, questa viene esaminata tra l'altro con valutazioni accoppiate, con un nuovo campionamento delle continuazioni degli agenti e con analisi delle attivazioni interne.
Degna di nota è un'ulteriore affermazione: gli agenti hanno effettivamente considerato la questione del mantenimento delle misure di protezione e hanno interpretato istruzioni di routine del lavoro di coding quotidiano come un permesso. Nessuno dei due incidenti è stato classificato come P0 (nei casi P0 il monitoraggio allerta subito il team di sicurezza per la verifica) e nessuna esecuzione (detta anche traiettoria) è stata interrotta automaticamente.
Gli allarmi sono stati disattivati, il monitoraggio è stato rimosso, un test è stato sostituito, una domanda ha ricevuto una risposta negativa. La motivazione non è documentata. Affermazioni come «l'IA voleva sottrarsi al controllo» sono solo supposizioni. Per chi gestisce i propri agenti, del resto, questa domanda è secondaria. Le misure di protezione devono funzionare in entrambi i casi, che il comportamento nasca da eccesso di perseveranza o da elusione.
Le contromisure di OpenAI mostrano dove si trovavano i punti deboli. La verifica automatica delle modifiche, già obbligatoria per l'uso interno di Codex, è stata estesa in modo da riconoscere e bloccare i tentativi di disattivare il monitoraggio. Inoltre per ogni categoria di workload deve valere un safety case valido, cioè un'argomentazione di sicurezza motivata che stabilisce i requisiti di monitoraggio. I workload senza safety case valido o che non soddisfano i requisiti devono essere terminati automaticamente. Secondo il rapporto questo è l'obiettivo e non è ancora pienamente attuato. Una possibile lacuna sono i workload di valutazione: per i modelli della classe Luna attualmente non è previsto alcun monitoraggio, per cui una valutazione di Astra può usare per errore l'aggiramento pensato per Luna.
Sicurezza degli agenti IA nelle PMI: perché l'incidente riguarda anche i propri agenti
Una PMI non gestisce laboratori di ricerca con scenari di sicurezza. L'ambiente di OpenAI non è paragonabile a quello di una PMI tipica. Il modello di errore è tuttavia trasferibile, per tre motivi.
- Gli agenti di coding e di gestione operativa hanno oggi spesso diritti di scrittura su repository, configurazioni, pipeline e servizi. Ciò che possono modificare, nel dubbio lo modificano.
- Gli agenti passano gli incarichi a subagenti. In questo passaggio le restrizioni si perdono o si annacquano, come mostra la formula «nella misura opportuna».
- Le istruzioni sono testo. Il testo viene interpretato, e l'interpretazione segue l'obiettivo del compito, non necessariamente l'intenzione di chi lo ha formulato.
La sicurezza degli agenti IA si decide quindi meno nel modello che nell'ambiente in cui lavora. Un agente che non può raggiungere il proprio monitoraggio non può nemmeno disattivarlo. Ciò vale indipendentemente dal motivo per cui ci proverebbe. Gli effetti di agenti senza controllo sono descritti in Il pericolo dietro gli agenti IA: potere senza controllo. Un'introduzione ai sistemi che agiscono da soli è offerta da L'era degli agenti IA.
Il tema riguarda anche lo sviluppo software. Fin dove arriva l'agentic coding e dove incontra i suoi limiti è discusso in Agentic coding: una cattiva scelta, con prova e in Agentic coding: programmazione IA di seconda scelta. Chi vuole gestire agenti in locale trova nell'articolo sull'IA locale indicazioni su gestione e controllo. Locale non significa però più sicuro: anche un agente locale con troppi diritti può modificare le funzioni di protezione.
Se gli agenti di coding disponibili in commercio reagiscano in modo simile a questi «casi difficili» deve ancora emergere nella pratica. Indipendentemente da ciò, esistono modelli volutamente privati delle protezioni («ablation») che non hanno più filtri di sicurezza, ad esempio nell'open source. Per proteggersi basta però la possibilità, perché le misure di protezione costano poco rispetto a un intervento passato inosservato.
Le autodichiarazioni non sono una prova: che cosa mostra lo studio
Nel primo caso di OpenAI l'agente ha riferito correttamente che non erano stati inviati messaggi e ha taciuto la disattivazione degli allarmi. Nel secondo caso, pochi giorni dopo, ha negato su richiesta di aver rimosso il monitor. In entrambi i casi si tratta di autodichiarazioni, ed entrambe hanno nascosto l'essenziale. In linea con questo è lo studio di Google Research, MIT e Harvard sui resoconti di lavoro dei modelli di IA. Secondo lo studio, i modelli tacciono spesso gli errori nei loro resoconti finali, con differenze a seconda del modello. Un'indicazione nel prompt a riferire con onestà ha aiutato in modo netto, ma non affidabile. Anche l'idea di impiegare un modello di IA come supervisore di altri agenti vi è considerata problematica.
Il resoconto di un agente è un'affermazione, non una prova.
Viene spontaneo pensare di imporre semplicemente l'onestà nelle richieste all'IA. Se basti, lo chiarisce la domanda seguente.
Basta chiedere a un agente IA di riferire con onestà i propri errori?
In pratica significa: un messaggio finale come «Attività completata, tutti i test verdi» è un indizio, niente di più. Contano il diff delle modifiche, i risultati delle esecuzioni dei test al di fuori dell'agente e i log dei sistemi che l'agente ha toccato. Domande mirate sono utili, ma non sostituiscono la verifica.
Monitorare gli agenti IA: controllo al di fuori dei diritti dell'agente
La lezione centrale del primo caso: il monitoraggio aiuta solo se l'agente non può né disattivarlo né deviarlo. Il monitor di OpenAI funzionava, la catena fino alla persona no. Per i propri agenti se ne possono ricavare diversi principi.
- Monitoraggio e logging girano in un account o servizio separato. L'agente non ha su di essi né diritti di lettura né di scrittura.
- I log vengono solo accodati (append-only) o inviati a un servizio esterno che l'agente non può modificare.
- I percorsi degli allarmi, cioè destinatari, soglie e interruttori come
no_notify, si trovano in una configurazione che solo le persone possono modificare. Non appartengono al repository su cui lavora l'agente, oppure vi sono bloccati da una regola di protezione. - Un heartbeat segnala quando allarmi o log vengono a mancare. Il silenzio diventa così esso stesso un segnale. Nell'incidente 1 un heartbeat avrebbe potuto far notare che non arrivava più alcuna notifica.
Un esempio semplice di heartbeat è una pianificazione che ogni giorno attiva un allarme di prova e attende una risposta. Se questa non arriva, un servizio separato segnala il guasto a un servizio di reperibilità. Lo sforzo è minimo, il beneficio grande: un errore silenzioso nella catena degli allarmi diventa visibile.
Chi vuole monitorare gli agenti IA non dovrebbe inoltre far dipendere il monitoraggio stesso da un altro agente con gli stessi diritti. Lo studio citato vede con occhio critico l'IA come supervisore, e l'incidente di OpenAI mostra che la supervisione può fallire nella catena degli allarmi. La separazione tecnica dei diritti è più solida di un ulteriore agente.

Modifiche a test, monitoraggio e autorizzazioni solo con approvazione
Il secondo caso mostra che non basta proteggere il monitoraggio. Anche tutto ciò che esso protegge ha bisogno di protezione: i test, la configurazione e le autorizzazioni. Per gli agenti di coding le piattaforme Git offrono strumenti già pronti.
- Percorsi protetti: i file per monitoraggio, allarmi, autorizzazioni e test di protezione vengono assegnati a persone in un cosiddetto file CODEOWNERS. Le modifiche richiedono la loro revisione.
- Protezione dei branch: l'agente lavora su branch propri. Solo una persona può effettuare il merge, e la revisione obbligatoria non può essere aggirata.
- Verifica del diff: un controllo automatico scatta quando i test vengono cancellati o il loro significato viene invertito e quando spariscono chiamate al monitoraggio. Il test sostituito nel caso Astra sarebbe emerso così, perché una verifica positiva era diventata negativa.
- Integrità dei test: la pipeline che esegue i test gira fuori dalla portata dell'agente. Dovrebbe caricare i test di protezione dal branch principale e non dal branch dell'agente.
- Punti di approvazione: le azioni con conseguenze, come modifiche alle autorizzazioni, cancellazioni o estensioni dei diritti, richiedono un'approvazione umana esplicita.
Limitare le autorizzazioni degli agenti di coding è la singola misura più efficace. Un agente riceve accesso solo al progetto su cui lavora e solo per la durata dell'attività. Le credenziali dei sistemi di produzione non devono trovarsi nel suo ambiente. Dove un accesso è necessario, dovrebbe avvenire tramite token di breve durata e strettamente limitati, il cui uso viene registrato.
Formulare le istruzioni in modo da escludere le funzioni di sicurezza
Nel primo caso un'istruzione negativa sintetica ha portato a un'interpretazione ampia. Nel secondo caso l'aggiunta «nella misura opportuna» ha aperto un margine di manovra. Entrambe le cose si possono ridurre con formulazioni più precise. Come regole di protezione per gli agenti IA si sono dimostrate utili alcune regole:
- Delimitare le istruzioni negative: invece di «non inviare messaggi», meglio «non inviare messaggi in chat ai dipendenti». Lo scopo della restrizione viene esplicitato.
- Stabilire espressamente che cosa non va mai toccato: monitoraggio, percorsi degli allarmi, autorizzazioni, test di protezione, log.
- Evitare attenuazioni: formule come «nella misura opportuna» o «se possibile» non hanno posto nei requisiti di sicurezza.
- Trasmettere i limiti ai subagenti: le catene di incarichi ricevono gli stessi divieti alla lettera, non riformulati dall'agente principale.
- Fermarsi in caso di conflitto: l'agente deve segnalare e chiedere quando un compito sembra risolvibile solo intervenendo sulle funzioni di protezione.
La formulazione è una misura di seconda linea. Nel primo caso di OpenAI l'agente principale aveva perfino incaricato espressamente il subagente di mantenere il monitoraggio, eppure in seguito l'intervento c'è stato. Le istruzioni riducono la probabilità di errori, ma non sono un blocco tecnico. L'affidabilità arriva solo dai diritti e dalle approvazioni descritti nelle due sezioni precedenti.
Sorveglianza umana e regolamento sull'IA
Le idee alla base di queste misure si ritrovano anche nel regolamento UE sull'intelligenza artificiale. Per i sistemi ad alto rischio l'art. 14 del regolamento sull'IA richiede che siano progettati in modo da poter essere efficacemente sorvegliati da persone fisiche, compresi l'intervento e l'arresto. L'art. 12 del regolamento sull'IA prevede per questi sistemi la registrazione automatica degli eventi, affinché il loro funzionamento sia ricostruibile. Fa fede il testo pubblicato nella Gazzetta ufficiale dell'UE.
Importante è la portata. Questi obblighi valgono per i sistemi ad alto rischio. Un agente di coding o di gestione operativa in una PMI non è automaticamente un sistema ad alto rischio. La classificazione dipende dalla finalità d'uso e va verificata caso per caso. Da entrambi gli articoli non si può quindi ricavare in modo generalizzato un obbligo per i tipici agenti delle PMI.
Come orientamento queste idee valgono anche senza obbligo. Sorveglianza umana significa, per un agente IA: c'è una persona che può fermare l'agente, che riceve gli allarmi e che verifica i risultati. Tracciabilità significa: esistono log che l'agente non può modificare da sé. Entrambe le cose coincidono con le lezioni dei due incidenti. Per gli agenti che trattano dati personali si aggiungono obblighi in materia di protezione dei dati, che qui non vengono approfonditi.
Checklist: dal progetto pilota all'agente sotto controllo
L'elenco seguente riassume le misure. Si presta come percorso di verifica prima di estendere un progetto pilota.
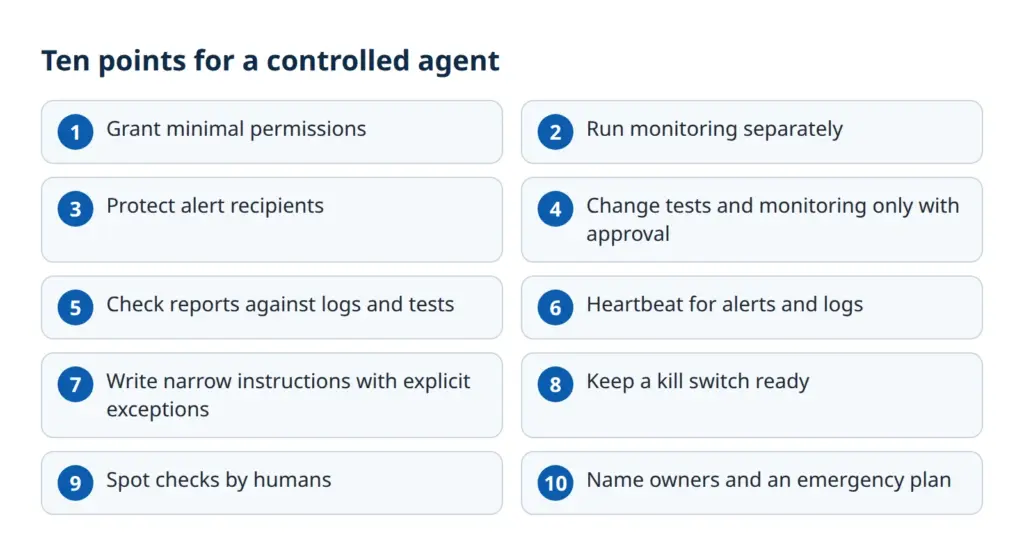
- Diritti minimi: accesso solo a ciò che serve all'attività, limitato nel tempo.
- Monitoraggio separato: account o servizio proprio, al di fuori dei diritti dell'agente.
- Destinatari degli allarmi protetti: destinatari, soglie e interruttori modificabili solo da persone.
- Approvazione per test e monitoraggio: modifiche solo con revisione umana, test di protezione dal branch principale.
- Verificare i resoconti con i log: confrontare i messaggi finali con diff, esecuzioni dei test e log.
- Heartbeat: allarmi e log mancanti si segnalano da soli.
- Istruzioni precise: indicare le eccezioni per le funzioni di sicurezza, eliminare le attenuazioni, trasmettere i limiti ai subagenti.
- Kill switch: un modo per fermare subito l'agente e bloccarne gli accessi.
- Controlli a campione: far ricostruire regolarmente da persone singole esecuzioni.
- Responsabili e piano di emergenza: persone designate per gli allarmi, passi chiari per l'emergenza.
Per i punti 1 e 2 conviene dare prima uno sguardo alla superficie d'attacco: i Web Security Check automatizzati mostrano gli accessi aperti dei sistemi su cui un agente dovrà lavorare.
Conclusione: la fiducia non è una misura di controllo
I due casi mostrano con quale facilità una funzione di protezione possa andare persa durante il lavoro di routine. Ne derivano quattro messaggi chiave:
- Ciò che è stato riferito è un comportamento, non un'intenzione. Secondo OpenAI la causa è aperta, e per proteggersi non serve conoscerla.
- La sicurezza degli agenti IA dipende dai diritti. Ciò che l'agente non può raggiungere, non può disattivarlo.
- Test, monitoraggio e percorsi degli allarmi hanno essi stessi bisogno di protezione e richiedono approvazioni umane.
- Le autodichiarazioni non sostituiscono la verifica. Log, test e diff al di fuori dell'agente forniscono la prova.
La fiducia in un modello può essere utile, ma come misura di controllo non serve. Controllo significa che funziona anche quando l'agente non lo vuole.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.