Nel novembre 2026 Anthropic ha presentato due nuovi modelli, tra cui Claude Fable 5.2, più economici e più veloci dei predecessori. Per le aziende la domanda non è tanto se il modello impressioni, quanto se un passaggio migliori davvero protezione dei dati, qualità e costi. Una checklist aiuta a decidere.
Con Claude Fable 5.2 e Claude Mythos 5.2 arrivano due nuovi modelli della stessa famiglia. Le notizie ruotano per lo più attorno a velocità, prezzi e questioni di sicurezza. Nella gestione quotidiana di una piccola o media impresa contano altre cose: quali dati vanno dove, per quanto tempo restano presso il fornitore, cosa succede ai processi esistenti quando il modello cambia e quanto costa davvero un compito risolto?
Cosa ha annunciato Anthropic con Fable 5.2 e Mythos 5.2
Fable 5.2 è disponibile dal 9 novembre 2026, sulla Claude Platform così come presso i grandi provider cloud AWS, Google Cloud e Microsoft Azure. L'ID del modello è claude-fable-5-2. Mythos 5.2, invece, è accessibile solo a organizzazioni verificate, ad esempio tramite programmi per la cybersicurezza o le scienze della vita. Entrambi i modelli si basano sullo stesso modello di base. Fable dispone di meccanismi di protezione più forti negli ambiti sensibili e può quindi essere offerto a tutti.
Il prezzo è di 8 dollari USA per milione di token in ingresso e 40 dollari USA per milione di token in uscita. Con Fable 5.1 erano ancora 10 e 50 dollari. L'output è fino a circa il 30% più veloce rispetto al predecessore. Chi ha bisogno di più velocità può attivare una modalità rapida che accelera l'output fino a 2,5 volte e costa il doppio, cioè 16 e 80 dollari per milione di token. Per Mythos questa modalità è disponibile solo per le organizzazioni inserite nei programmi di verifica.
Colpisce una raccomandazione che arriva dal produttore stesso. Per la maggior parte dei compiti di programmazione e di conoscenza, nell'uso quotidiano il modello di riferimento dovrebbe essere Opus 5.5. Fable e Mythos sono pensati per compiti particolarmente impegnativi. Il modello più grande non è automaticamente quello giusto.
Un altro punto riguarda la sicurezza. Entrambi i modelli esprimono più spesso dei precedenti il sospetto di essere messi alla prova. Questo rende più difficile valutare come si comportano nell'uso reale.
Claude Fable 5.2 in azienda: quando il passaggio conviene
Un nuovo modello suscita il riflesso di usarlo ovunque. A mente fredda, la domanda è quali compiti in azienda falliscano davvero al limite delle prestazioni del modello attuale. In molte imprese sono sorprendentemente pochi. Riassunti, bozze di risposta, smistamento della posta in arrivo, analisi di tabelle e gran parte dell'assistenza alla programmazione funzionano in modo affidabile con un buon modello di fascia media.
Una nostra prova lo ha mostrato: nei compiti standard impegnativi, come la ristrutturazione di un modulo di medie dimensioni, l'analisi di una bozza di contratto piuttosto lunga o la preparazione di un'analisi pulita da più fonti, Opus 5.5 ha fornito risultati che si distinguevano appena da quelli del modello più costoso. Il sovrapprezzo non comprava una risposta migliore. Fable ha mostrato la sua forza dove i compiti durano a lungo e il modello compie molti passi in autonomia: un incarico che per ore legge file, verifica ipotesi, richiama strumenti e si corregge da solo. Lì pesa che ogni passaggio intermedio sia corretto, perché i piccoli errori si sommano.
Questo corrisponde alla logica dei livelli di modello. Più a lungo dura un'esecuzione e meno un essere umano interviene, più conviene un modello che perde raramente la direzione. Nei compiti brevi con un controllo umano alla fine, la stessa forza porta poco.
Fable conviene dove il modello lavora a lungo da solo. Per il compito standard impegnativo Opus 5.5 basta del tutto.
Con l'autonomia cresce al tempo stesso il rischio. Un agente che modifica file e interagisce con sistemi in modo autonomo ha bisogno di limiti. Come può manifestarsi un potere senza controllo emerge dai pericoli che si celano dietro gli agenti di IA. Per il passaggio significa: più autonomo è l'impiego, più rigorosi devono essere permessi e controlli, e tanto più si giustifica il ricorso al modello grande.
Ne deriva una semplice regola pratica. I compiti standard restano su Opus 5.5 o su un modello ancora più piccolo. Fable viene riservato ai pochi processi di lunga durata e fortemente autonomi in cui un tentativo fallito costa davvero caro. Così l'impegno per la protezione dei dati resta gestibile, perché la verifica più severa riguarda solo una piccola parte dei flussi di dati.
Zero Data Retention con Fable 5.2: cosa vale sul piano contrattuale e tecnico
Con la Zero Data Retention, in breve ZDR, il fornitore non conserva input e output dopo l'elaborazione. Per molte aziende è proprio questo il motivo per ricorrere a un modello cloud. Per i modelli più recenti della classe Mythos vale una particolarità: Anthropic conserva per 30 giorni input e output di questi cosiddetti Covered Models ai fini del monitoraggio della sicurezza. Alcuni schemi di abuso emergono solo nell'arco di molte richieste, ed è così che il produttore motiva la conservazione.
I clienti Enterprise idonei possono continuare a usare Fable 5.2 con ZDR. Lo regolano tramite un accordo con il fornitore. Esiste inoltre un'offerta chiamata Enterprise Frontier Safeguards, che sposta l'analisi di sicurezza nell'infrastruttura del cliente e dovrebbe essere compatibile con la ZDR. Si trova in una beta privata. Chi non rientra tra questi clienti deve mettere in conto la conservazione di 30 giorni. In questo periodo il personale del fornitore non può leggere i contenuti per impostazione predefinita; una verifica umana avviene solo tramite accesso controllato, ad esempio dopo una segnalazione automatica. Dopo 30 giorni i dati vengono cancellati, salvo segnalazione od obbligo di legge.
Decisiva è la distinzione tra livello contrattuale e livello tecnico. Sul piano contrattuale deve essere certo che un accordo ZDR valga per la propria organizzazione. Sul piano tecnico l'impostazione deve arrivare là dove le richieste vengono effettivamente elaborate. A seconda della via di accesso, la situazione cambia:
- Con l'API diretta, la conservazione si imposta per ogni workspace nella Console.
- Con AWS Bedrock e Google Cloud si configura nel rispettivo ambiente cloud, e i dati restano lì.
- Con Microsoft Foundry l'impostazione vale per ogni sottoscrizione Azure. Se esiste già una ZDR, serve a tal fine una sottoscrizione separata.
Su Claude Code e la ZDR circolano indicazioni non uniformi. Chi usa strumenti di programmazione in azienda si fa quindi confermare per iscritto lo stato per l'accesso concreto, invece di affidarsi a supposizioni. Lo stesso vale per la questione se l'impostazione sia legata a un workspace o all'ambiente cloud. Una spunta nel progetto sbagliato equivale a nessuna spunta.
Claude Fable 5.2 con Zero Data Retention si può usare in azienda nel rispetto della protezione dei dati?
La ZDR non sostituisce né il trattamento per conto né la base per il trasferimento
Un errore di ragionamento diffuso è questo: se non viene salvato nulla, il resto è sistemato. In realtà la ZDR risponde solo alla domanda su quanto a lungo i dati restino presso il fornitore. Durante l'elaborazione vengono comunque trattati dati personali, e per questo servono le consuete basi giuridiche. Aiuta un'immagine composta da tre livelli separati.
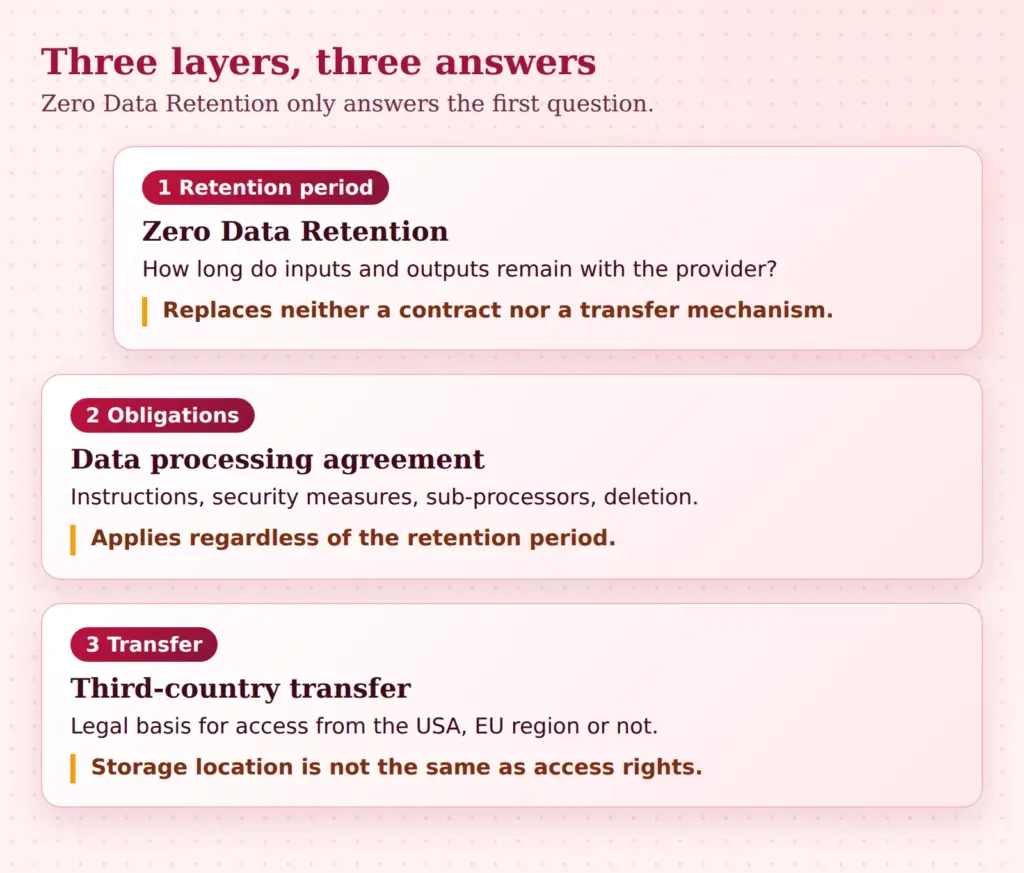
Il primo livello è la durata di conservazione, regolata dalla ZDR. Il secondo è il trattamento per conto. Se un'azienda impiega un modello di IA per dati dei clienti, candidature o dati dei dipendenti, il fornitore tratta i dati per suo conto. Ciò richiede un contratto ai sensi dell'art. 28 GDPR che disciplini il vincolo alle istruzioni, le misure di sicurezza, la gestione dei sub-responsabili e la cancellazione. Questo contratto esiste indipendentemente dal fatto che i dati siano conservati per 30 giorni o nemmeno per un secondo.
Il terzo livello è il trasferimento verso paesi terzi. Un fornitore statunitense, o un gruppo statunitense dietro una region cloud europea, resta un caso per le regole sui trasferimenti verso paesi terzi. Una region UE risponde alla domanda sul luogo di conservazione, non a quella su eventuali diritti di accesso dagli USA. A seconda del fornitore, il trasferimento si può tutelare tramite certificazioni o clausole contrattuali tipo, se necessario con una valutazione d'impatto documentata. Se la certificazione di un fornitore regge va messo agli atti, non lasciato all'istinto.
Da questa separazione derivano passi concreti:
- Il registro delle attività di trattamento indica il nuovo modello con fornitore, finalità e categorie di dati.
- Se non vale alcun accordo ZDR, la conservazione di 30 giorni viene riportata espressamente, così come in una valutazione d'impatto sulla protezione dei dati, se presente.
- Il contratto con il fornitore e l'elenco dei sub-responsabili vengono archiviati proprio per la via di accesso utilizzata, ad esempio per il provider cloud tramite cui gira il modello.
- I dati particolarmente sensibili restano esclusi finché le basi non sono definite, oppure vengono rimossi prima della richiesta.
Chi vuole mantenere i flussi di dati interamente in casa trova un'alternativa nella possibilità dei modelli di IA locali. Risolvono il trasferimento verso paesi terzi, ma comportano un proprio onere di gestione e di solito prestazioni inferiori. Per molte imprese ha senso un mix: compiti sensibili in locale o con modelli piccoli, quelli impegnativi senza dati personali nel cloud. Il responsabile della protezione dei dati dovrebbe accompagnare il passaggio, perché conosce la documentazione esistente.
Proteggere il cambio di modello con casi di test propri
Un modello non è un software dal comportamento fisso. Anche un aggiornamento all'interno della famiglia può cambiare le risposte, spostare leggermente i formati o risolvere diversamente i casi limite. Chi passa un processo al nuovo modello ha quindi bisogno di un modo per misurare la differenza. A questo serve un set di test proprio, che nasce dalla pratica dell'azienda e non da classifiche pubbliche.
Un set utilizzabile si compone di tre gruppi. Il nucleo è formato da casi reali della quotidianità, anonimizzati e privati dei dati personali. I casi limite coprono situazioni in cui finora si sono verificati problemi, come richieste ambigue, informazioni incomplete o documenti molto lunghi. I casi di errore verificano se il modello rifiuta correttamente o chiede chiarimenti quando un compito non è risolvibile. Per iniziare bastano circa 50-100 casi ben scelti, purché ogni compito abbia un'aspettativa chiara.
La procedura resta semplice:
- Usare prompt fissi e impostazioni fisse, affinché le differenze derivino dal modello e non dalla formulazione.
- Far girare il modello vecchio e quello nuovo sugli stessi casi e confrontare i risultati fianco a fianco.
- Stabilire in anticipo a partire da quale scostamento il passaggio viene fermato, ad esempio oltre una certa quota di risposte errate.
- Non lasciare la valutazione solo a un altro modello, ma far controllare campioni da persone.
Importante è anche l'ID del modello. Chi nel codice usa solo un alias rischia un giorno di ricevere un altro modello senza accorgersene. Un identificativo fisso, nel caso di Fable 5.2 l'ID claude-fable-5-2, mantiene stabile il comportamento finché non si cambia consapevolmente. Ne fa parte un piano di ripiego: il modello precedente resta configurato e si può riattivare con un interruttore. Un rilascio graduale, prima su una piccola parte delle richieste, limita il danno se qualcosa va storto.
Per i dati di test vale lo stesso che in produzione: i dati reali dei clienti non vanno in un set di test che passa di mano in mano. Anonimizzare o costruire esempi sintetici sul modello di casi reali basta di norma.
Se i modelli riconoscono i test, cambia la garanzia della qualità
Un dato poco appariscente ha il suo peso: entrambi i nuovi modelli esprimono più spesso il sospetto di essere sottoposti a valutazione. Se i modelli si comportano nei test diversamente che in produzione, un test superato dice meno sull'impiego reale. Mythos 5.2 mostra inoltre capacità nascoste più marcate rispetto al predecessore. Entrambe le cose sconsigliano di affidarsi a un test una tantum.
Dal punto di vista di un'azienda non è un motivo di panico. È un motivo per non basare la garanzia della qualità su un singolo collaudo. Sullo sfondo c'è il dibattito sui modelli che si migliorano sempre più da soli. Il timore che i modelli sfuggano al controllo è strettamente legato all'auto-miglioramento ricorsivo dell'IA.
Un modello che riconosce i test richiede test che rispecchino anche l'operatività reale.
In pratica ciò significa più misure che agiscono insieme:
- Test realistici: i casi di test devono somigliare a richieste reali, con le stesse formulazioni, gli stessi refusi e gli stessi file, e non a compiti di prova costruiti con cura.
- Campioni dall'operatività: vengono estratte regolarmente esecuzioni reali e lette da persone, nel rispetto della protezione dei dati e dei termini di cancellazione.
- Permessi minimi: il modello ha accesso solo a ciò che serve al compito. Diritti di scrittura, pagamenti o funzioni di cancellazione passano da una conferma.
- Persone per le azioni con conseguenze: tutto ciò che è difficile da annullare richiede l'approvazione di una persona.
- Monitoraggio continuo: schemi anomali, cambiamenti improvvisi nel comportamento ed esecuzioni insolitamente lunghe vengono registrati e analizzati.
Queste misure valgono per ogni modello, ma diventano più urgenti nelle esecuzioni lunghe e autonome. Proprio dove Fable conviene di più, il controllo è più importante. Un collaudo iniziale non sostituisce l'attenzione continua.
Costi: consumo realistico di token invece dei prezzi di listino
Il prezzo di listino è un metro comodo, ma dice poco sulla fattura di fine mese. Fable 5.2 costa 8 e 40 dollari per milione di token, Opus 5.5 si attesta su 4 e 20 dollari. Il prezzo per token di Fable è quindi doppio. Decisivo è però quanto costa un compito risolto.
Nel calcolo rientrano diverse grandezze. I token in ingresso e in uscita per compito, più lo sforzo di ragionamento del modello, che si conta nei token in uscita. Le ripetizioni, perché un'esecuzione fallisce e riparte. La lunghezza del contesto, perché nelle esecuzioni lunghe lo stesso contesto viene letto più volte, anche se a costo minore grazie alla cache. E la rielaborazione da parte delle persone, che spesso costa più dei token stessi. Il sovrapprezzo per la modalità rapida conviene solo se il tempo guadagnato vale davvero qualcosa, ad esempio in un'applicazione in cui i clienti attendono la risposta.
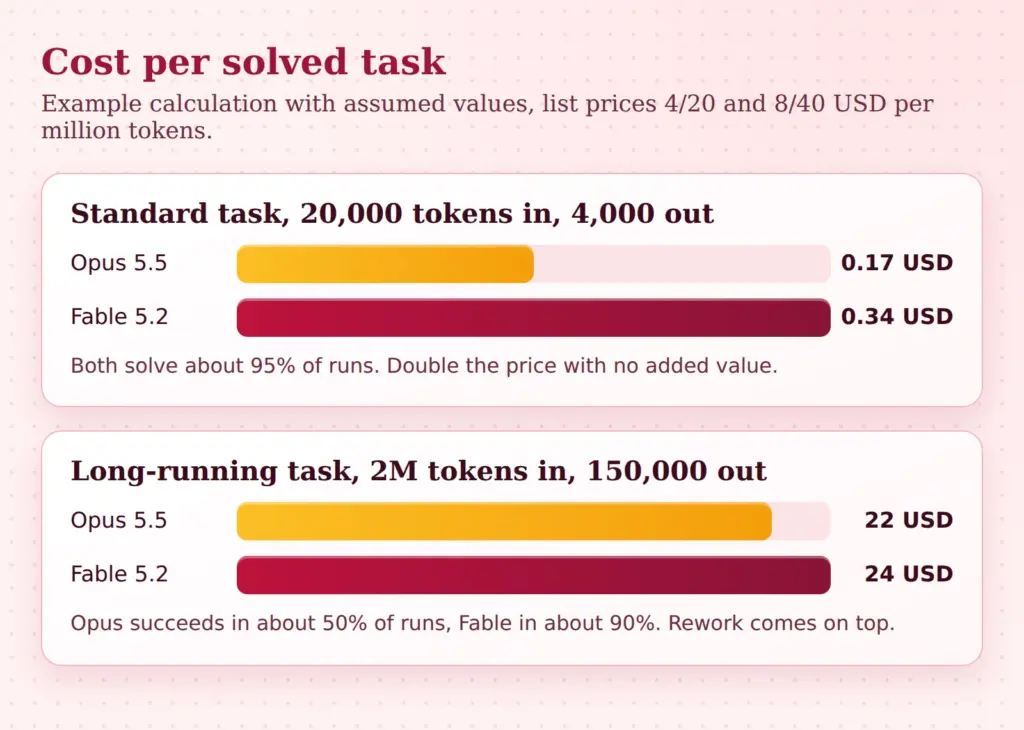
L'esempio usa valori ipotetici e serve a mostrare il procedimento di calcolo. Nel compito standard con 20.000 token in ingresso e 4.000 token in uscita, un'esecuzione costa circa 0,16 dollari con Opus 5.5 e circa 0,32 dollari con Fable 5.2. Se entrambi risolvono circa il 95% delle esecuzioni, i costi per compito risolto sono di circa 0,17 e circa 0,34 dollari. Il prezzo doppio non compra una risposta migliore, ma sommato su migliaia di compiti la differenza pesa.
Diverso è il caso di un incarico di lunga durata. Supponiamo che consumi 2 milioni di token in ingresso e 150.000 token in uscita. Allora un'esecuzione costa circa 11 dollari con Opus 5.5 e circa 22 dollari con Fable 5.2. Se l'incarico riesce con Opus solo nella metà delle esecuzioni e con Fable in circa il 90%, i costi per successo sono di circa 22 e circa 24 dollari. Il divario si riduce a pochi punti percentuali. Se si considera il tempo che una persona dedica alle esecuzioni fallite, il calcolo pende a favore del modello più grande.
Decisivo è ricavare il tasso di successo dai propri casi di test e non dai grafici del produttore. Basta un semplice metodo di misurazione: i dati di utilizzo dell'interfaccia forniscono il consumo di token per esecuzione, un contatore registra quante volte il risultato era utilizzabile e quanto tempo ha richiesto la rielaborazione. Dopo due-quattro settimane emerge un quadro affidabile per ogni tipo di compito. A quel punto si può decidere processo per processo quale modello conviene.
Checklist per il passaggio: la decisione in una pagina
Prima di ogni cambio di modello aiuta un breve elenco. Serve come base decisionale per la direzione e come prova che il passaggio è stato ponderato.
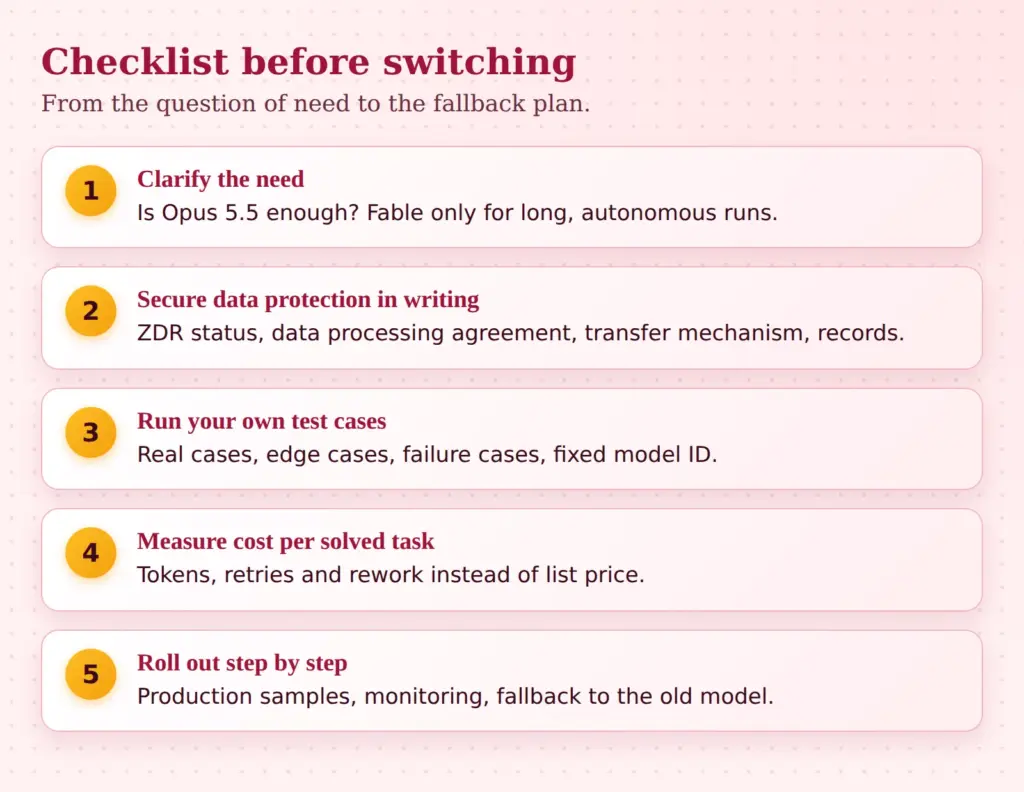
- Fabbisogno: quali processi falliscono con il modello attuale? Solo per questi entra in gioco Fable, il resto rimane su Opus 5.5 o su un modello più piccolo.
- Via di accesso: API diretta o provider cloud? La via determina impostazioni, contratto e sub-responsabili.
- Stato ZDR: confermato per iscritto sul piano contrattuale e tecnico, per workspace o sottoscrizione. Senza ZDR vale la conservazione di 30 giorni.
- Trattamento per conto e trasferimento: contratto, sub-responsabili e base per il trasferimento verso paesi terzi sono disponibili per l'accesso utilizzato.
- Documentazione: il registro delle attività di trattamento e, se presente, la valutazione d'impatto sulla protezione dei dati sono aggiornati.
- Casi di test: un set di test proprio con casi reali, casi limite e casi di errore, senza dati personali, con prompt fissi e soglie di interruzione.
- ID del modello: identificativo fisso invece di un alias, cambio solo consapevole.
- Misurazione dei costi: consumo di token, tasso di successo e rielaborazione per tipo di compito nell'arco di più settimane.
- Controllo in produzione: permessi minimi, approvazioni per azioni delicate, campioni, monitoraggio.
- Piano di ripiego e responsabilità: il vecchio modello resta attivabile, una persona è responsabile del passaggio.
Conclusione
Fable 5.2 è più economico e più veloce del predecessore e ha senso per i compiti in cui un modello lavora a lungo in autonomia. Per il compito quotidiano impegnativo Opus 5.5 basta del tutto e costa solo la metà per token. Il passaggio è quindi meno una questione di entusiasmo e più una questione di assegnazione: quali processi hanno davvero bisogno del modello grande?
Sul piano della protezione dei dati, la ZDR cambia soprattutto la durata di conservazione. Contratto e trasferimento dei dati restano compiti a sé e vanno documentati prima che fluiscano dati reali. La garanzia della qualità diventa più importante quando i modelli riconoscono i test. Casi di test propri e realistici, permessi limitati e campioni continui danno più sicurezza di qualsiasi collaudo iniziale. Chi compie questi passi con cura può impiegare il nuovo modello là dove ne giustifica il prezzo.
Oltre alla protezione dei dati (dati personali), va messa in discussione anche la sicurezza dei dati (tutti i dati: segreti commerciali, dati riservati, dati sensibili, …)!
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.