Il CEO di Google Sundar Pichai afferma che il settore è ancora lontano dallo stato finale dell'auto-miglioramento ricorsivo. Allo stesso tempo descrive cicli in cui agenti di IA aiutano già oggi a costruire nuovi modelli. Allo stato attuale si può valutare che cosa sia documentato dell'IA auto-migliorante e che cosa significhi per l'uso dell'IA nelle piccole e medie imprese. L'umanità è in pericolo?
L'occasione è un'intervista di cui ha riferito Big Technology il 23 ottobre 2026. Lì compare una frase sull'IA che si auto-migliora che si presta bene a essere citata: il settore sarebbe ancora lontano dallo stato finale della RSI. RSI sta per Recursive Self-Improvement, cioè auto-miglioramento ricorsivo. Si intende un ciclo in cui i sistemi di IA migliorano i loro successori, che a loro volta costruiscono successori migliori.
Le basi del funzionamento di questi cicli sono illustrate nell'articolo sull'auto-miglioramento ricorsivo dell'IA. Di seguito, le affermazioni tratte dall'intervista, le dichiarazioni dei produttori, un lavoro di ricerca e una previsione di addetti ai lavori sono presentate separatamente.
Che cosa ha detto Pichai e che cosa no
Il nocciolo è breve. Secondo il resoconto di Alex Kantrowitz, Pichai ha detto: “To be very clear. We are pretty far from the end state of RSI.” Il senso è: “Sia chiaro: dallo stato finale dell'auto-miglioramento ricorsivo il settore è ancora piuttosto lontano.” Kantrowitz contrappone questa frase all'aspettativa di alcuni nel settore dell'IA, secondo cui un'esplosione di intelligenza sarebbe imminente e l'IA si migliorerebbe presto in un ciclo completo senza intervento umano.
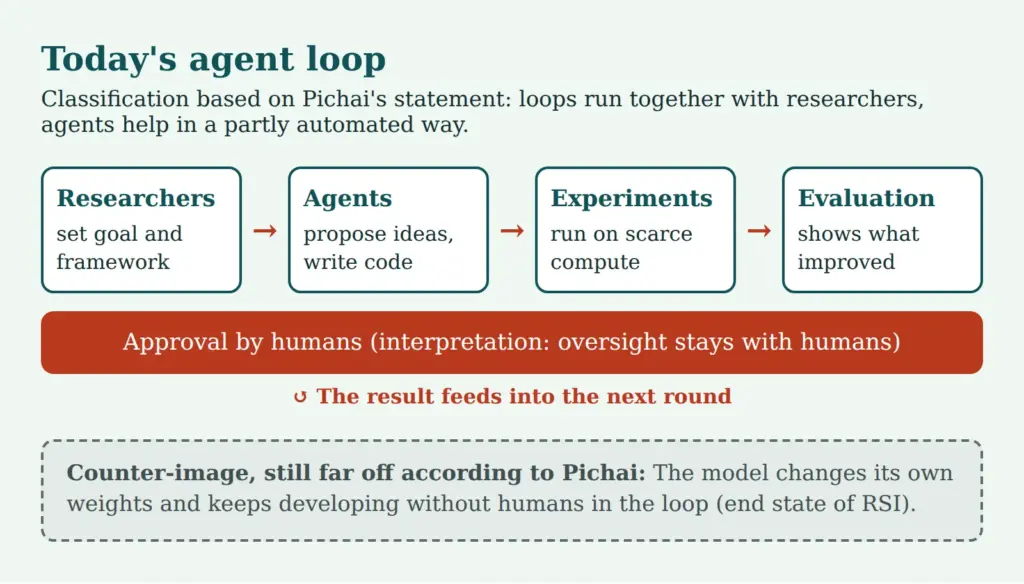
Subito dopo seguono altre due frasi, più importanti della prima per la valutazione. Pichai ha detto: “You have RSI loops along with AI researchers in various aspects of model development.” E: “You almost have agents helping AI researchers in some automated way work together to build these models.” In sostanza: in diversi ambiti dello sviluppo dei modelli esistono cicli di retroazione insieme ai ricercatori, e gli agenti li aiutano in parte in modo automatizzato a costruire i modelli.
Documentato alla lettera è quindi questo: cicli parziali sono già in corso, e lo sono insieme ai ricercatori. In queste frasi non si parla di un modello che si ristruttura da solo senza supervisione. La frase sullo stato finale si può leggere come riferita proprio a questa immagine.
Come tema secondario, Big Technology riferisce della capacità di calcolo. Pichai dice che tutti ne sono a corto, non solo Google: “The compute we have today is a function of decisions I made in 2024.” Secondo il resoconto, afferma inoltre che il business cloud rinuncia più volte a ricavi a breve termine perché la capacità di calcolo viene riservata allo sviluppo dei modelli di punta. Per l'auto-miglioramento questo è rilevante, perché ogni ciclo di idea, esperimento e valutazione costa tempo di calcolo. Dove scarseggia, frena anche la ricerca automatizzata.
Non è documentato un orizzonte temporale. Resoconti secondari come DigitalToday indicano “l'anno prossimo” come momento di ulteriori progressi.
Segue un'interpretazione che non proviene da Pichai. Chi parla di uno stato finale presuppone che esista una strada per arrivarci e che questa strada sia già iniziata. La frase si può quindi leggere anche come un'affermazione a favore della RSI: lo sviluppo è in corso, Google lo porta avanti con grande impegno e tra qualche anno sono pensabili grandi successi. Questa aspettativa è una valutazione nostra. Una dichiarazione di Pichai in tal senso non compare nelle fonti consultate.
Una possibile lettura: chi parla di stato finale presuppone che la strada per arrivarci sia già iniziata. La frase sarebbe allora meno un cessato allarme che una determinazione della posizione.
IA auto-migliorante: ciclo di agenti contro modifica dei pesi
Dietro il termine si nascondono due cose molto diverse, che nell'uso quotidiano vengono spesso confuse. La prima è il ciclo di agenti. Qui gli agenti di IA collaborano allo sviluppo: propongono esperimenti, scrivono e modificano codice, avviano addestramenti, valutano i risultati e riferiscono. Le persone fissano gli obiettivi, verificano i risultati e decidono sulle modifiche. Il ciclo migliora processi, strumenti e flussi di lavoro.
La seconda è la modifica dei pesi. In questo caso un modello cambierebbe i propri pesi in modo che il successore sia migliore, e lo farebbe senza che una persona approvi i risultati nel mezzo. È questa l'immagine che sostiene il concetto di esplosione di intelligenza. Ed è proprio da questo, secondo una lettura di Pichai, che il settore è ancora lontano.
Tra i due poli non c'è un interruttore, ma uno spettro. Il numero di passi che gli agenti svolgono senza chiedere conferma può crescere. Con esso cresce la quota dello sviluppo che le persone controllano solo a campione. Come agiscono gli agenti in produzione e perché ciò richiede controllo è descritto nell'articolo sull'era degli agenti di IA.
La domanda centrale merita una risposta sobria. La si può ricavare dalle frasi documentate.
Google pratica già l'auto-miglioramento ricorsivo, se l'IA aiuta a costruire i modelli successori?
Per le PMI la differenza non è accademica. Un ciclo di agenti accelera i cicli dei modelli senza che la perdita di controllo sia il tema. Una modifica dei pesi senza supervisione solleverebbe la questione se le persone siano ancora in grado di comprendere le modifiche. Le due domande richiedono risposte diverse, e oggi in pratica si pone solo la prima.
Che cosa riferiscono Google e altri sui propri progressi
Le affermazioni dei produttori sui propri progressi sono autodichiarazioni. Possono essere corrette, ma non sono verificate in modo indipendente. Questo vale per tutto ciò che si trova in questa sezione.
Un esempio attuale è Flint. Nel suo annuncio, l'azienda Recursive presenta il modello come modello di programmazione veloce per hardware locale, con 40 miliardi di parametri in totale e 2,5 miliardi attivi per token (quindi un modello Mixture of Experts). Secondo quanto dichiarato, un piccolo team di persone e agenti lo ha costruito in meno di quattro mesi. Il sistema di ricerca automatizzato, la “Eureka Machine”, avrebbe co-sviluppato quasi ogni parte della catena di costruzione del modello, dai dati e dalle ricette di addestramento fino all'inferenza. I benchmark provengono dal produttore e non sono verificati in modo indipendente. Recursive stessa avverte che Flint può richiedere più indicazioni rispetto ai grandi modelli chiusi.
Per le aziende la cosa è interessante per due motivi. Primo, il caso mostra che la ricerca automatizzata produce già prodotti, anche con team piccoli. Secondo, il modello gira in locale. Chi non vuole inviare dati sensibili ai fornitori cloud ha così un'opzione in più, senza che le dichiarazioni del produttore siano con ciò dimostrate. Come inquadrare i modelli locali in azienda lo mostra la panoramica sull'IA locale in azienda.
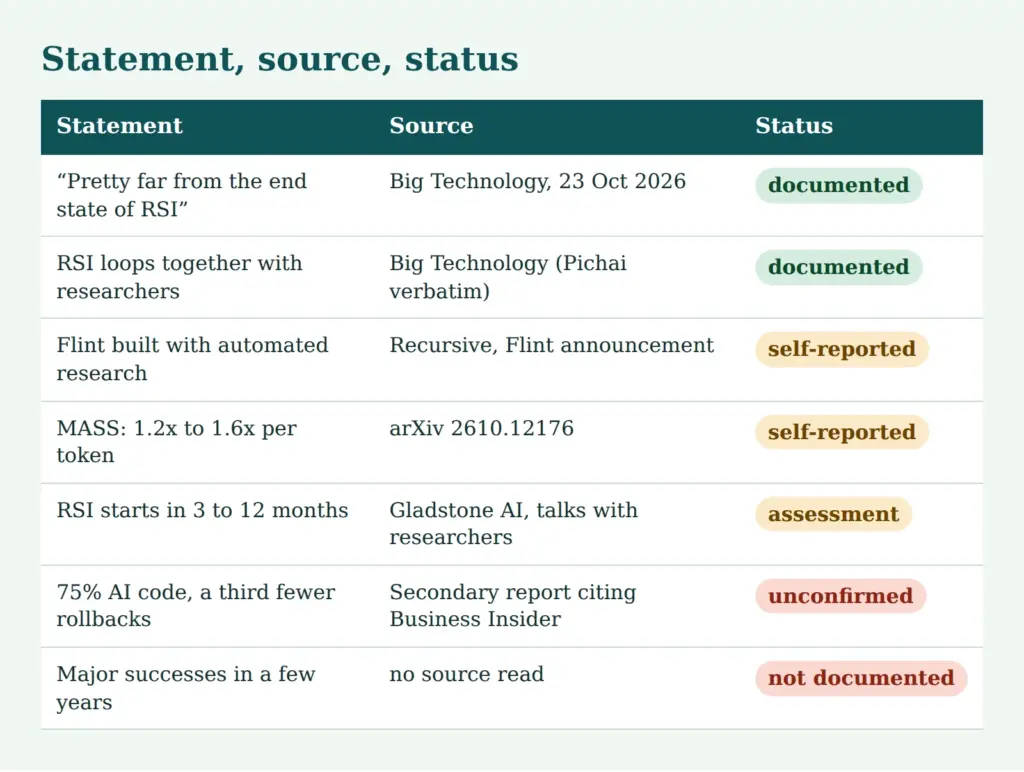
La panoramica mostra come classificare le affermazioni di questo articolo. Documentate sono le due frasi di Pichai nella formulazione del resoconto. I dati dei produttori e della ricerca sono autodichiarati. Gladstone è una valutazione basata su colloqui con ricercatori, non una misurazione. Il dato sul codice resta non confermato, il presunto orizzonte temporale “tra qualche anno” non è documentato come affermazione di Pichai.
Che cosa mostra la ricerca e dove si ferma
Un lavoro di ricerca rende tangibile come può apparire un ciclo di questo tipo. Con il titolo “Recursive Self-Improvement through Multi-Agent Self-Supervision” (presentato l'8 ottobre 2026) viene descritto il metodo MASS. Un unico modello di base, nel paper Qwen3.6-27B, propone workflow multi-agente, li esegue e li valuta da sé. Poi viene riaddestrato sulle proprie esecuzioni, e il procedimento si ripete.
Dopo due cicli l'abstract riporta una prestazione da 1,2 a 1,6 volte superiore per token di output su quattro benchmark aperti. Inoltre, un modello addestrato con le esecuzioni di più agenti sarebbe migliore di un modello addestrato con le esecuzioni di un singolo agente e il 40 per cento di dati di addestramento in più.
I limiti si vedono nel materiale stesso. Si tratta di un modello e di due cicli. Il segnale per il miglioramento viene dall'autovalutazione. Sui due benchmark di programmazione Terminal-Bench 2.0 e SWE-bench Verified, in una figura del paper compaiono i valori 0,96 e 0,94, quindi per token leggermente sotto il valore di partenza. Su questi due test la figura non mostra dunque alcun guadagno per token.
Il punto di partenza degli autori si collega al tema della supervisione (di livello superiore). Scrivono che un singolo modello fatica a criticare e migliorare i propri ragionamenti complessi quando lavora in un ciclo omogeneo. Per questo puntano su più istanze con ruoli diversi. Se lo stesso modello genera e valuta, errori comuni possono passare inosservati. Questa è una conclusione tratta dall'approccio: la formulazione del paper riguarda il metodo, non le aziende.
La ricerca dimostra che l'idea può funzionare e che la verifica è il collo di bottiglia. Non dimostra che i modelli si migliorino in modo affidabile nella pratica quotidiana senza persone. Questo è coerente con la frase di Pichai e non la contraddice.
Quanto in fretta potrebbe andare: Gladstone e i limiti della previsione
Ricercatori di Anthropic, OpenAI e Google DeepMind si aspettavano che l'auto-miglioramento ricorsivo iniziasse nei prossimi tre-dodici mesi, forse anche prima, nell'ipotesi che il governo degli Stati Uniti non intervenga né freni.
Gli intervistati hanno un interesse proprio nella dinamica del settore, e gli autori sono un'organizzazione con focus sulla politica di sicurezza.
La ricerca automatizzata potrebbe essere tecnicamente possibile senza essere economica. Il collo di bottiglia non sarebbero le buone idee, ma il tempo di calcolo per testarle. Questo coincide con l'osservazione di Pichai sulla scarsità di capacità di calcolo.
Le affermazioni non si escludono a vicenda. “Inizio” e “stato finale” sono punti diversi sulla stessa strada. Pichai dice che la strada è lunga e descrive al tempo stesso che i cicli sono in corso con i ricercatori. Gladstone si aspetta che una parte di essi diventi presto più autonoma. Chi legge entrambe le cose ottiene un quadro in cui l'auto-miglioramento ricorsivo aumenta passo dopo passo. Basare una pianificazione soltanto su indicazioni in mesi è rischioso, perché provengono da una piccola cerchia di colloqui.
Conseguenze per le PMI: testare i cicli dei modelli e i cambi di modello
Per le aziende l'effetto non si manifesta come esplosione di intelligenza, ma nel calendario e nella tecnica. Se gli agenti alleggeriscono il lavoro dei ricercatori, nuove versioni dei modelli possono uscire più spesso. Per l'operatività conta però, indipendentemente dalla causa: i modelli cambiano più in fretta di quanto i reparti adattino i processi.
Questo ha conseguenze pratiche. Un modello può rispondere allo stesso prompt in modo diverso dal predecessore. Tono, formato, tipi di errore e costi per attività si spostano. I fornitori dismettono le versioni più vecchie, a volte con breve preavviso. E chi si affida all'alias “latest” riceve modifiche in produzione senza averle chieste.
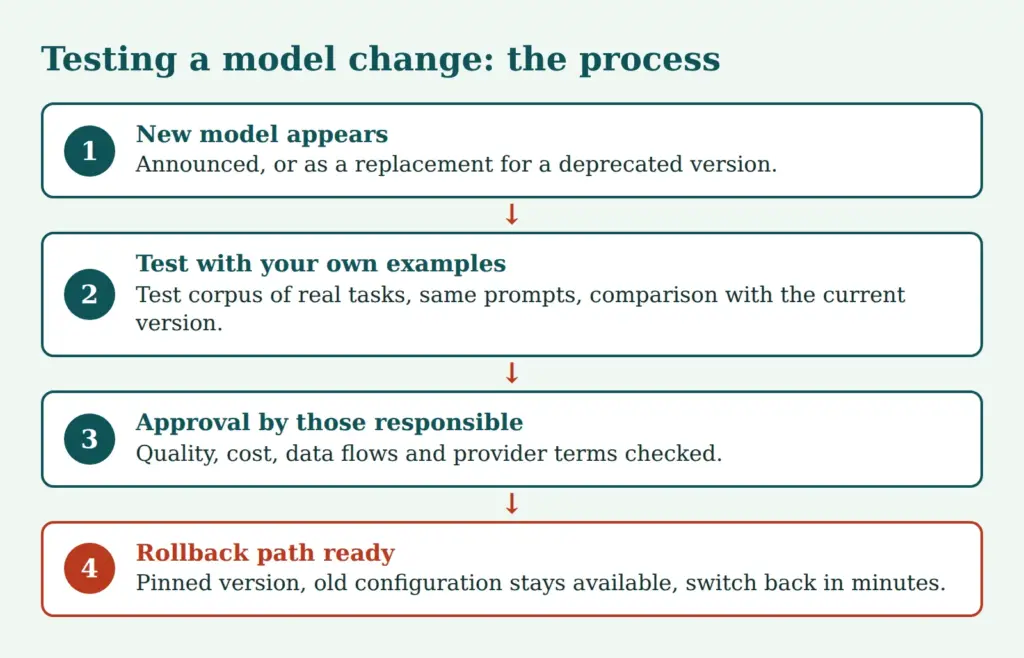
Ne deriva una procedura semplice per il cambio di modello. Primo, un corpus di test composto da attività reali, per esempio da 50 a 200 casi anonimizzati con una risposta buona nota (in parte si possono persino generare con l'IA!). Secondo, un'esecuzione di confronto del nuovo modello con la versione attuale, a prompt invariati. Terzo, un'approvazione da parte di una persona designata che ha visto qualità, costi e tipologia di errori. Quarto, un percorso di rollback, cioè versione del modello fissata e configurazione conservata, così che il ritorno indietro riesca in pochi minuti.
In caso di cambio di fornitore o di un nuovo modello di un fornitore esistente entrano in gioco protezione dei dati e contratto. Vanno chiariti flussi di dati, ubicazione dei server, trattamento per conto terzi e la questione se gli input vengano usati per l'addestramento. Un aggiornamento automatico all'ultimo modello non dovrebbe essere consentito in produzione. I modelli locali spostano la questione: eliminano la dipendenza dal fornitore e portano con sé una manutenzione propria, si veda la panoramica sull'IA locale.
Le piccole imprese non devono creare per questo un proprio reparto di test. Una tabella con esempi, uno script che li invia a entrambi i modelli e una breve nota di approvazione bastano come inizio.
Mantenere supervisione e approvazioni: che cosa resta compito delle persone
Quando gli sviluppatori interni impiegano agenti con permessi di scrittura, nasce in piccolo lo stesso ciclo dei laboratori: l'agente modifica il codice, i test girano, l'agente corregge. La supervisione si può impostare secondo lo stesso schema. L'agente può proporre e testare, ma una persona designata approva le modifiche a sistemi di produzione, configurazioni e dati.
Ne fanno parte registri che rendono ricostruibile ciò che l'agente ha fatto, e permessi stretti quanto necessario. Cancellare, inviare e pagare sono azioni che meritano una conferma aggiuntiva. Quali rischi comporta un agente senza controllo lo descrive l'articolo Il pericolo dietro gli agenti di IA.
Importante è anche la domanda su chi verifica. Se lo stesso modello genera e valuta, restano gli stessi punti ciechi. In produzione questo significa: un'IA può verificarne un'altra, ma solo in aggiunta. La verifica incrociata affidabile viene da test, da un altro fornitore o da una persona.
L'IA verifica l'IA in modo affidabile solo se la verifica incrociata è indipendente: tramite test, un altro fornitore o una persona.
La responsabilità resta all'azienda che impiega l'agente. Questo vale indipendentemente da quanta parte dello sviluppo sia automatizzata dietro le quinte. L'affermazione che l'IA si migliora da sola non esonera chi la gestisce.
Checklist
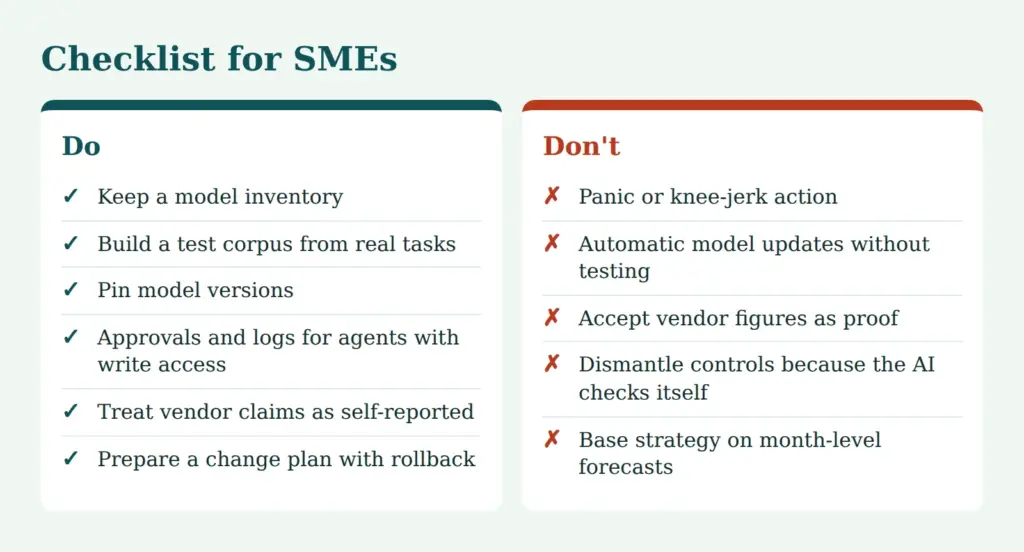
Una checklist aiuta a rispondere alla domanda su che cosa fare adesso e che cosa no:
I punti nel dettaglio:
L'inventario dei modelli registra quali modelli girano in quale versione e dove, chi ne è responsabile e quali dati fluiscono. Il corpus di test cresce con ogni errore che emerge in produzione. Le versioni vengono fissate e cambiate solo dopo un test. Per gli agenti con permessi di scrittura valgono approvazioni e registri. Le dichiarazioni dei produttori, sui benchmark come sulle quote di IA nel codice, vengono trattate come autodichiarazioni e non come prova.
Non sono consigliabili panico e azionismo, perché la situazione documentata è un ciclo parziale con le persone. Né si dovrebbero smantellare i controlli perché un'IA si verifica da sola. E le strategie basate sulle indicazioni in mesi delle previsioni poggiano su basi fragili. Chi vuole verificare anche il lato tecnico, per esempio permessi e superficie di attacco dei sistemi, trova un punto di partenza nei security check su wwwschutz.de.
Conclusione
In sintesi, le affermazioni e lo stato attuale, che può cambiare ogni giorno, si possono ordinare così.
Pichai documenta che esistono cicli di retroazione con i ricercatori e che lo stato finale senza persone è ancora lontano. Questo non è un cessato allarme. Una possibile lettura è che la strada sia già in corso e che grandi progressi siano possibili tra qualche anno.
Per le PMI contano cicli dei modelli più brevi, test prima di ogni cambio, versioni fissate e approvazioni per gli agenti. Se il ciclo diventerà sensibilmente più autonomo tra tre mesi o tra tre anni, oggi nessuno lo sa con certezza. Chi padroneggia test, approvazioni e rollback è preparato a entrambi i casi.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.