Frontier AI (l'IA più avanzata) non migliora soltanto grazie a una maggiore potenza di calcolo. Conversazioni, valutazioni, test automatici e simulazioni forniscono segnali da cui si può imparare. Anche i robot possono trarne vantaggio.
Chi usa regolarmente gli assistenti di IA se ne accorge: la Frontier AI commette meno errori da una versione all'altra, scrive codice più utilizzabile e risolve compiti in cui le generazioni precedenti fallivano. La spiegazione più comune è che ci sono semplicemente più dati e più potenza di calcolo. È vero, ma non basta. Il progresso deriva sempre più dal feedback. Le risposte vengono valutate, i programmi testati, le dimostrazioni verificate, e dal risultato nasce un segnale di apprendimento.
L'articolo segue questi segnali uno per uno. Si parla delle conversazioni tra persone e assistenti, del confronto tra risposte buone e cattive, delle verifiche automatiche e della domanda su che cosa significhi oggi davvero l'auto-miglioramento ricorsivo. Segue il passo verso i robot e, per concludere, alcune raccomandazioni pratiche sulla protezione dei dati.
Oggi chiunque può osservare nella pratica quante cose siano già possibili con l'IA. L'IA è ormai molto più di un chatbot; lo sa bene chiunque ne padroneggi le basi tecniche.
Frontier AI: che cosa sono i modelli di punta e da dove viene il progresso
Frontier AI indica i modelli di IA più potenti del loro tempo. Si parla anche di modelli di frontiera o di modelli di IA di punta. Non esiste una soglia fissa e generalmente riconosciuta. Spesso la categoria viene descritta in base allo sforzo di addestramento, cioè alla quantità di potenza di calcolo impiegata per un modello.
A rigore, però, sarebbe meglio parlare di sistemi di IA, di cui i modelli di IA sono il componente principale. Altri componenti comprendono ambienti di test virtuali, router per l'uso di strumenti con gli strumenti collegati e così via.
L'addestramento di questi modelli si può suddividere a grandi linee in più fasi:
- Pre-addestramento: il modello legge grandi quantità di testo e impara a prevedere le continuazioni probabili. Così nascono sensibilità linguistica e conoscenza del mondo.
- Post-addestramento con feedback: il modello impara a dare risposte utili e innocue. A tal fine le risposte vengono valutate e confrontate.
- Addestramento con segnali di verifica: per compiti con un risultato univoco, come il calcolo o la programmazione, una verifica stabilisce automaticamente se un tentativo di soluzione era corretto.
- Auto-miglioramento ricorsivo: l'IA si istruisce da sola e diventa sempre più intelligente.
La seconda e la terza fase costituiscono il nucleo di questo articolo. Entrambe si basano sulla stessa idea.
Il progresso dei modelli di punta è sempre più una questione di feedback: chi sa verificare che cosa è andato bene, può imparare da questo.
Il pre-addestramento fornisce l'ampiezza, il feedback fornisce la direzione. Senza di esso un modello resta un generatore di testo che produce frasi plausibili. Con esso impara che cosa conta come riuscito in una situazione concreta.
Che cosa può accadere alle conversazioni degli utenti: addestramento, analisi, sicurezza
Le conversazioni con gli assistenti sono una fonte evidente di segnali di apprendimento, anche se l'addestramento dell'IA con i dati degli utenti avviene solo a determinate condizioni. Vale comunque la pena distinguere quattro cose che nella vita quotidiana si confondono facilmente:
- Addestramento: le conversazioni confluiscono nello sviluppo dei modelli. Se ciò avvenga dipende dal fornitore, dal piano e dalle impostazioni.
- Analisi per la sicurezza: le conversazioni vengono controllate per individuare abusi o violazioni delle regole. È una cosa diversa dall'addestramento del modello.
- Analisi per scopi propri: gli utenti dell'IA lo dimenticano spesso: OpenAI e altri analizzano le richieste dei clienti e le risposte dell'IA per migliorare la propria IA. In questo modo possono essere "rubati" dei concetti.
- Feedback esplicito: pollice in su o in giù, segnalazioni di errori e commenti vengono forniti deliberatamente come valutazione.
Un esempio di regolamentazione pubblicata è quello di Anthropic. A metà del 2025 l'azienda ha annunciato nuove condizioni per i consumatori. Gli utenti degli account consumer dovevano scegliere se le loro chat e sessioni di programmazione potessero essere utilizzate per migliorare i modelli. Con il consenso il periodo di conservazione è di cinque anni, senza consenso di 30 giorni. I servizi commerciali e l'API sono esclusi. Secondo la pagina di assistenza di Claude, inoltre, il feedback può essere conservato fino a cinque anni e le conversazioni segnalate possono essere esaminate per motivi di sicurezza. Le chat in incognito sono escluse dall'addestramento.
Anche Google descrive regole di questo tipo nell'informativa sulla privacy delle app Gemini. Vi si parla, tra l'altro, dell'impostazione sulle attività, di revisori umani e di periodi di conservazione fino a tre anni per le conversazioni esaminate e il feedback. Presso OpenAI, secondo le indicazioni del fornitore, esiste un'impostazione con cui si può disattivare l'utilizzo per il miglioramento dei modelli.
Le indicazioni variano da fornitore a fornitore e cambiano nel tempo. Inoltre di solito valgono solo per gli account consumer. Ciò non significa che gli altri account siano al sicuro da un "uso improprio dei dati da parte di terzi".
Come imparare dalle conversazioni senza leggere le singole chat
Nessun essere umano può leggere milioni di conversazioni. Un metodo pubblicato mostra come sia comunque possibile riconoscere degli schemi: Clio di Anthropic. Lo strumento riassume automaticamente le conversazioni, raggruppa argomenti simili e mostra solo risultati anonimizzati e aggregati. Lo scopo sembra essere l'analisi dei modelli di utilizzo, il riconoscimento degli abusi e il miglioramento dei classificatori di protezione. Non va equiparato all'addestramento del modello.
L'esempio chiarisce che cosa sia possibile in linea di principio. Da grandi volumi di conversazioni si possono ricavare argomenti, concetti ed esigenze. Per che cosa le persone hanno bisogno di aiuto? Quali domande restano senza risposta? Dove le risposte risultano insoddisfacenti, perché gli utenti chiedono ulteriori chiarimenti o riformulano la domanda? Analisi di questo tipo possono mostrare quali capacità un modello dovrebbe imparare in seguito. Se e come i singoli fornitori sfruttino questa possibilità per il loro addestramento non è documentato pubblicamente nei dettagli. Si tratta di una possibilità tecnica, non di una prassi confermata. Purtroppo non è facile da dimostrare, il che aumenta la probabilità che venga praticata.
Il fornitore indica anche dei limiti. Non tutte le informazioni private vengono riconosciute in modo affidabile, e uno strumento per l'analisi delle conversazioni potrebbe in linea di principio essere usato anche a fini di sorveglianza. Aggregazione e anonimizzazione sono quindi misure di protezione, ma non una garanzia.
Risposte buone e cattive: il segnale del confronto
Spesso per le persone è più facile confrontare due risposte che valutarne una in termini assoluti. Su questo si basa il post-addestramento con feedback umano. Per una domanda vengono generate due risposte e una persona indica quella migliore. Da molte di queste coppie il modello impara quali caratteristiche sono preferite: precisione, chiarezza, tono adeguato, sicurezza.
Questo confronto è un segnale contrastivo. Il modello impara non solo che cosa è buono, ma anche da che cosa deve distinguersi. Un metodo noto a questo scopo è la Direct Preference Optimization (DPO). Utilizza le coppie di preferenze direttamente per adattare il modello, senza addestrare prima un modello di valutazione separato.
Le valutazioni non devono necessariamente provenire da esseri umani. Constitutional AI descrive come un modello critichi e riveda le risposte sulla base di principi scritti. Uno studio ha confrontato il feedback dell'IA con quello umano e ha riscontrato risultati comparabili nei compiti esaminati. Ciò vale espressamente solo per quei compiti e per lo stato della ricerca di allora.
Qui ci sono punti di contatto con l'auto-miglioramento ricorsivo: un modello aiuta a valutare il suo successore. Il successore migliora e il passo successivo parte da un livello più alto. Il ciclo è strettamente limitato, ma in parte reale e avviene nella pratica.
Auto-miglioramento ricorsivo: che cosa è documentato e che cosa resta una previsione
Il termine suscita grandi aspettative. Un sistema dovrebbe migliorare se stesso, la versione migliorata migliorerebbe ulteriormente e il progresso accelererebbe. Il termine viene usato in modi diversi nel dibattito, e alcuni attori citano percentuali impressionanti, per esempio sulla quota di codice scritto dall'IA.
Sono documentati piuttosto piccoli tasselli:
- Addestramento su dati generati in proprio, in cui un modello scrive risposte che vengono riutilizzate dopo una verifica.
- L'IA come valutatore, come in Constitutional AI e nel Reinforcement Learning.
- Supporto dell'IA nello sviluppo, per esempio nella scrittura e nel test del codice.
A ciò si contrappongono dei rischi. Se un modello viene addestrato ripetutamente su output dell'IA, la sua qualità può diminuire. I ricercatori parlano di collasso del modello (studiato su Nature). Anche un valutatore difettoso è un rischio, perché in quel caso il modello impara a compiacere il valutatore invece di svolgere bene il compito. I pregiudizi del valutatore possono rafforzarsi.
Tra i tasselli documentati e un'intelligenza che accelera inarrestabilmente c'è un ampio divario. Quanto sia grande la quota di tali cicli di feedback nel progresso dei modelli di punta non si può quantificare dall'esterno.
Test e simulazioni prima della risposta: segnali di verifica invece di opinioni
Un segnale di apprendimento è particolarmente forte quando nessuno deve giudicare. Per alcuni compiti il risultato può essere verificato automaticamente (per esempio con Lean). Un programma supera i suoi test oppure no. Un calcolo dà il risultato giusto oppure no. Una dimostrazione viene accettata o respinta dal programma di verifica. In questo caso si parla di ricompensa verificabile, che nel Reinforcement Learning funge da segnale di apprendimento.
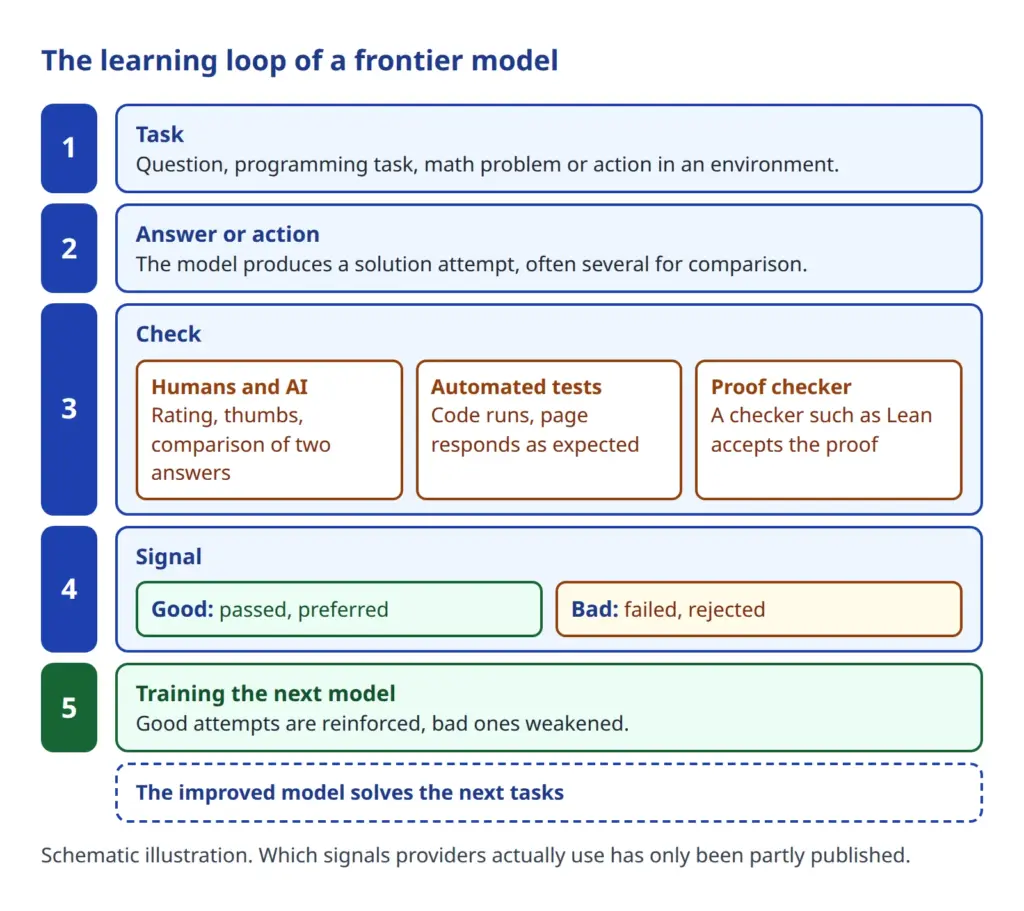
Il principio è ben documentato. Il lavoro su DeepSeek-R1 riferisce che le capacità di ragionamento possono crescere grazie al Reinforcement Learning con compiti verificabili. Già in precedenza alcuni ricercatori avevano mostrato che un verificatore addestrato può aiutare, nei problemi di matematica formulati a parole, a scegliere la soluzione giusta tra più soluzioni. Anche gli assistenti di dimostrazione come Lean forniscono un giudizio univoco e quindi un segnale particolarmente chiaro.
Un test non dice che cosa è bello, ma se funziona, ed è proprio questo a renderlo così prezioso come segnale di apprendimento.
Un'applicazione web si presta come esempio. Un agente crea una pagina e poi la apre con uno strumento di test del browser come Playwright/Chromium. Clicca sui pulsanti, controlla se i moduli funzionano e verifica se la visualizzazione è corretta. Se qualcosa non va, corregge il codice e ripete il test. Per l'utente sembra una risposta migliore che compare dopo un'attesa. Una panoramica su come vengono addestrati i modelli è offerta dall'articolo Addestramento dei modelli di IA, mentre la concorrenza tra i fornitori è trattata nell'articolo sulla continua corsa dei modelli.
Viene spontanea un'altra riflessione: il risultato di un simile test, superato o fallito, potrebbe confluire come segnale in un addestramento futuro. Se e in che misura i fornitori lo facciano è la vera domanda. Documentato è il principio della ricompensa verificabile, non l'uso concreto dei test del browser nell'addestramento.
Un test verifica solo ciò per cui è stato scritto. Un programma può superare tutti i test e risolvere comunque il compito sbagliato. Un modello può inoltre imparare ad aggirare i test invece di risolvere il compito. Chi lavora con agenti che usano strumenti trova approfondimenti nell'articolo sugli agenti di IA.
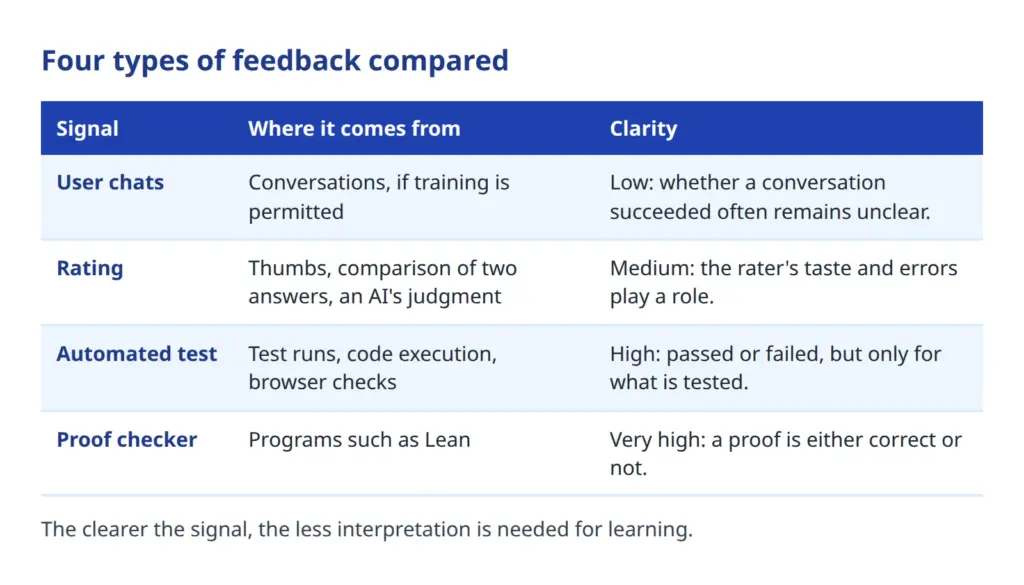
La rappresentazione mostra perché i segnali di verifica sono così apprezzati: più il feedback è univoco, meno interpretazione è necessaria. I dati delle conversazioni sono ricchi, ma ambigui. I test sono limitati, ma chiari.
Robot con IA: Embodied AI, simulazione e Sim-to-Real
Perché i robot traggono vantaggio dai progressi dei modelli linguistici e di ragionamento? Perché un robot che deve eseguire un'istruzione come "metti in ordine il lavello" ha bisogno di tre capacità che esercitano anche i modelli linguistici: comprendere le istruzioni, usare la conoscenza del mondo e pianificare i passaggi. La Embodied AI, cioè l'IA dotata di un corpo, parte proprio da qui.
Con Gemini Robotics, Google DeepMind descrive un modello che aggiunge alla visione e al linguaggio un terzo output: le azioni. Questi modelli Vision-Language-Action traducono un'immagine della telecamera e una frase in comandi di movimento. Esistono inoltre modelli per l'Embodied Reasoning, che offrono comprensione spaziale e pianificazione e possono richiamare strumenti.
I robot, però, imparano con più difficoltà del software. Un tentativo fallito nella realtà costa tempo, materiale e, nel peggiore dei casi, sicurezza. Qui entra in gioco la simulazione. In un ambiente virtuale sono possibili milioni di tentativi, gli errori non costano nulla e l'esito può essere valutato automaticamente. Anche questo è un segnale di verifica, solo che riguarda i movimenti.
Il problema si chiama Sim-to-Real: ciò che funziona nella simulazione spesso fallisce nella realtà per dettagli come le condizioni di luce, l'attrito o il rumore dei sensori. Una contromisura nota è la Domain Randomization. La simulazione viene calcolata di proposito in molte varianti, in modo che la realtà sia solo un'ulteriore variante. Tobin e colleghi hanno addestrato in questo modo un modello di riconoscimento degli oggetti esclusivamente con immagini simulate, ottenendo nella pratica una precisione di circa 1,5 centimetri.
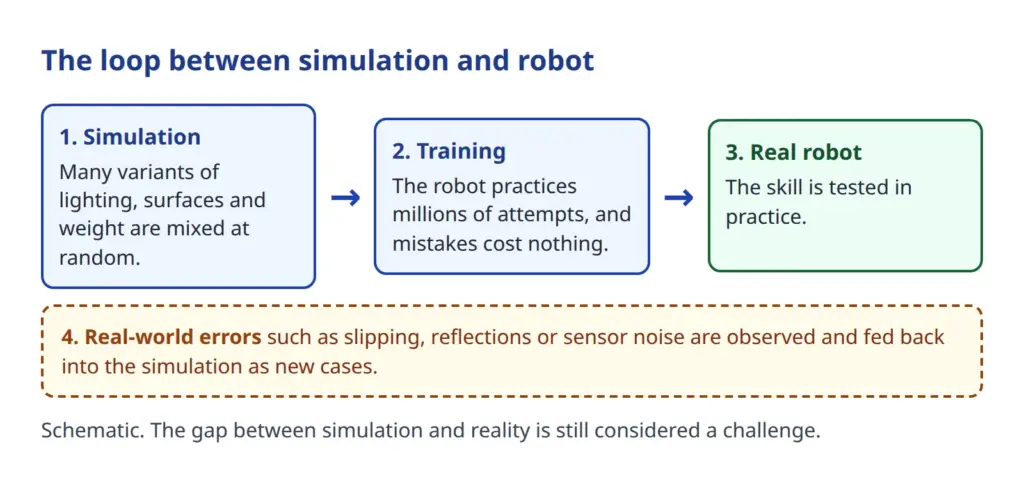
I modelli del mondo fanno un passo in più. Non generano ambienti simulati a partire da regole costruite a mano, ma imparano come il mondo appare e si comporta. Secondo l'azienda, Genie 3 di Google DeepMind genera mondi interattivi in tempo reale a 24 fotogrammi al secondo e dovrebbe essere adatto all'addestramento di agenti. Il fornitore lo definisce un'anteprima di ricerca con coerenza limitata. Anche NVIDIA offre con Cosmos e Isaac Sim strumenti per dati sintetici e simulazione.
I limiti sono reali. Il trasferimento in ambienti fisici resta una sfida, e per i robot che incontrano persone si aggiunge la sicurezza. Lì un errore non è una frase sbagliata, ma un movimento sbagliato.
Protezione dei dati nella vita quotidiana: che cosa dovrebbero verificare utenti e aziende
Dal punto di vista della protezione dei dati, la domanda più importante è semplice da porre, ma non ha una risposta valida per tutti.
Le chat con gli assistenti di IA vengono usate per l'addestramento?
Ne derivano alcuni punti pratici:
- Controllare le impostazioni: dove i fornitori prevedono una scelta sull'uso per l'addestramento, vale la pena dare un'occhiata alle impostazioni sulla privacy. Le impostazioni predefinite possono cambiare.
- Preferire i prodotti business: per le aziende sono consueti prodotti con un accordo sul trattamento dei dati (art. 28 GDPR). Le condizioni di solito differiscono da quelle degli account consumer.
- Nessun dato personale negli account privati: i dati dei clienti e le informazioni interne non vanno inseriti negli account consumer.
- Usare il feedback consapevolmente: chi contrassegna una conversazione con un pollice o una segnalazione di errore può far sì che l'intera conversazione venga conservata ed esaminata più a lungo.
- Fare attenzione alla data: le indicazioni dei fornitori hanno una data. Fa sempre fede la versione aggiornata.
Conclusione
Il progresso nasce dal feedback!
Conversazioni e valutazioni mostrano di che cosa le persone hanno bisogno e che cosa conta come buona risposta. Test, verificatori di dimostrazioni e simulazioni dicono in modo univoco che cosa funziona. Entrambi i tipi di segnale migliorano i modelli e, a poco a poco, anche i robot, le cui capacità si basano sugli stessi modelli. Fin dove arriverà l'auto-miglioramento ricorsivo resta una questione aperta. Trasparenza e possibilità di scelta sui dati degli utenti restano compito dei fornitori, guardare con attenzione resta compito degli utenti.
In parte ognuno ha in mano quanti dei propri dati finiscano a terzi. Le opzioni vanno dall'inserire con parsimonia dati personali o di valore fino all'uso di un'IA locale. La pseudonimizzazione può essere eseguita in modo automatico o manuale per i testi brevi. Per i testi più lunghi, però, un automatismo non è possibile in modo affidabile (e in realtà nemmeno per quelli brevi, dove però una persona può investire abbastanza impegno nel controllo successivo).
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.