Google ha presentato Gemini 4 Carbon, un modello che secondo l'azienda supera nettamente il predecessore nella ricerca e nello sfruttamento delle vulnerabilità di sicurezza. Lo ricevono per primi i servizi di intelligence statunitensi, poi difensori selezionati; per tutti gli altri non c'è una data. Qui si inquadra che cosa è documentato, che cosa resta una dichiarazione del produttore e che cosa aziende e produttori in Europa possono cambiare nei cicli di patch e nei processi di verifica.
Il 28 ottobre 2026 Google ha presentato Gemini 4 Carbon, appena quattro settimane dopo Gemini 4 Argon. I dati sulle prestazioni contenuti nell'annuncio sono dichiarazioni del produttore e non si possono verificare dall'esterno. Più interessante è l'ordine in cui il modello dovrebbe essere distribuito: prima gli enti statali, poi difensori selezionati, mentre manca una data per tutti. Un giorno prima dell'annuncio di Google, il 27 ottobre 2026, Anthropic ha inoltre pubblicato un rapporto secondo cui un modello di ricerca non pubblicato avrebbe costruito cinque catene di exploit. Secondo Anthropic e The Hacker News tutte e cinque sono state nel frattempo corrette, anche se per il caso Android manca una voce pubblica e per il caso Windows l'attribuzione non è chiara.
Si descrivono prima i dati dei benchmark e i loro limiti, poi i livelli di accesso e la questione di che cosa significhi questa asimmetria per le organizzazioni al di fuori degli Stati Uniti. Seguono le catene di Anthropic con lo stato delle patch, le conseguenze per i cicli di patch e per i produttori di software e un elenco di passi pratici, tra cui la verifica di un server Linux. La situazione può cambiare rapidamente.
Gemini 4 Carbon: che cosa dichiara Google e che cosa si può verificare
Le informazioni su Gemini 4 Carbon provengono da Google e dalla relativa copertura giornalistica.
Secondo Google, nel benchmark Exploitgym Carbon raggiunge quasi il 55 per cento, mentre Argon arrivava al 42 per cento, di poco dietro al modello concorrente GPT-6 Astra. Nel benchmark SEC-bench Pro Carbon supera di poco l'88 per cento e quindi, secondo la notizia, è davanti a questo concorrente. Per CWE-bench, un test sulla messa in sicurezza delle vulnerabilità, viene indicato il 71 per cento. Un benchmark è un insieme standardizzato di compiti su cui i modelli vengono misurati in modo comparabile. Come siano strutturati esattamente i tre test non è stato verificato qui. Per questo la descrizione si limita volutamente a ciò che dice la notizia.
Anche altre affermazioni provengono da Google: finora nessun tentativo di prompt injection, cioè di manipolazione del modello tramite istruzioni introdotte di nascosto, avrebbe avuto successo. Il modello avrebbe inoltre meno allucinazioni e farebbe più spesso domande di chiarimento. Misurazioni indipendenti in merito non esistono. Come nota a margine vengono indicati i prezzi: 4 dollari USA per milione di token in ingresso e 20 dollari USA per milione di token in uscita, con il 50 per cento di sconto al lancio. Per gli standard attuali non è economico in confronto, ma – guardando ai valori assoluti – nemmeno davvero caro.
I valori dei benchmark rispondono a una domanda ristretta: quanto bene un modello risolve compiti preparati? Quanto bene lavori in software cresciuto nel tempo, con casi particolari, codice legacy e responsabilità poco chiare, lo mostrano solo in parte. Per inquadrare la questione basta quindi una lettura sobria. Se i numeri di Google sono corretti, il distacco dal predecessore nello sfruttamento delle vulnerabilità sarebbe grande. Se ciò valga anche nella pratica si vedrà solo quando terzi potranno testare il modello.
Accesso a livelli: prima i servizi di intelligence, poi Fairwind, più tardi tutti
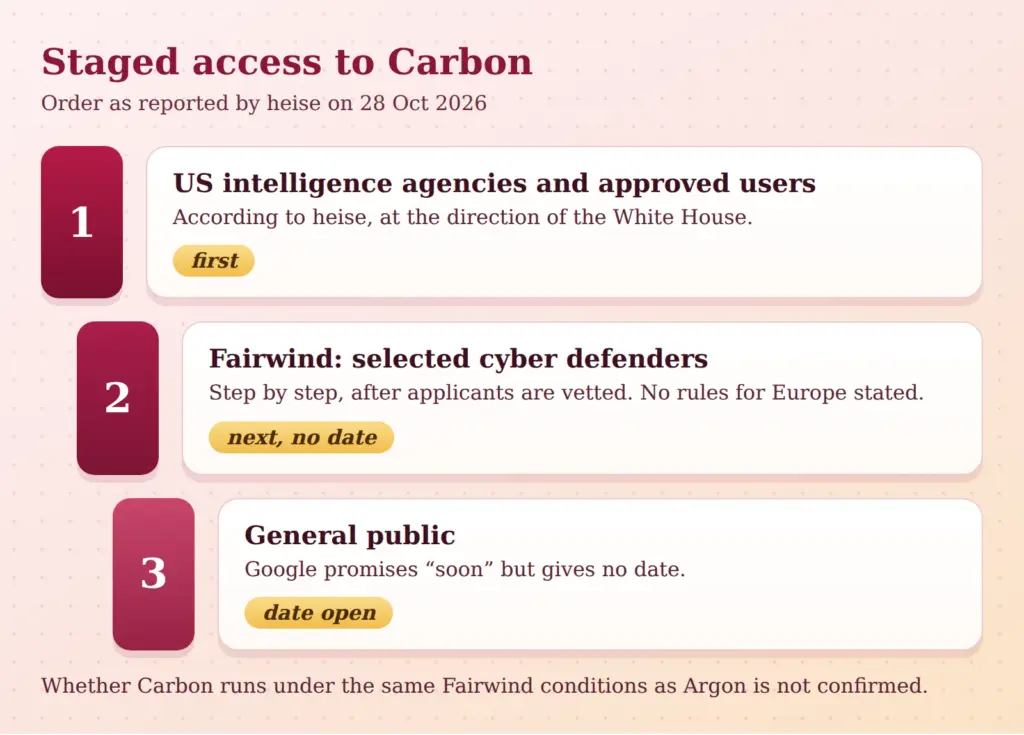
La vera novità di Gemini 4 Carbon è il percorso verso l'utente. A quanto pare Google si attiene a un'indicazione della Casa Bianca di rendere accessibili i nuovi modelli di IA dapprima solo ai servizi di intelligence statunitensi e a utenti selezionati. Ne derivano tre livelli.
Il primo livello è costituito dai servizi di intelligence statunitensi e dagli utenti da loro autorizzati. Se e come utilizzino il modello non è documentato. Documentato è solo l'ordine previsto. Il secondo livello è il programma Fairwind, attraverso il quale dovrebbero aggiungersi gradualmente difensori informatici selezionati e altri partner fidati. Il terzo livello è il pubblico generale. Google promette la disponibilità „a breve“, ma non indica una data. Per Argon, dalla presentazione al rilascio per gli utenti paganti sono passate due settimane.
Come funziona Fairwind lo descrive Google DeepMind sulla pagina del programma. Vengono citati più di 650 partner. Possono partecipare governi e agenzie nazionali per la cybersicurezza, gestori di infrastrutture critiche, piattaforme tecnologiche centrali e laboratori accademici. I candidati vengono verificati. Tra i requisiti figurano l'autenticazione a più fattori resistente al phishing, la registrazione dei log e l'uso difensivo; la cessione a terzi è vietata. Sulla pagina, però, il modello indicato è Argon, non Carbon. Se Carbon sia soggetto agli stessi vincoli resta aperto. Regole per l'Europa la pagina non ne indica.
Per le aziende europee ne deriva un'asimmetria che è anzitutto una questione di tempo. Stati e grandi piattaforme ricevono strumenti potenti prima delle PMI e dei produttori. Quanto sia lungo questo divario nessuno lo sa. Si possono distinguere due domande: chi decide sull'accesso, e che cosa ne consegue per le organizzazioni che non ne fanno parte? A quanto pare decide la Casa Bianca. Alle organizzazioni al di fuori degli Stati Uniti non resta che attendere e organizzarsi in modo che il vantaggio altrui causi il minor danno possibile.
Decisivo non è tanto quanto sia buono il modello, quanto per quanto tempo gli altri dovranno farne a meno senza uno strumento paragonabile.
L'argomento contrario merita considerazione. Un accesso a livelli può limitare gli abusi, e i difensori con accesso anticipato potrebbero trovare gli errori prima degli aggressori. Resta aperto se gli aggressori ottengano capacità paragonabili altrove, per esempio presso altri fornitori o con modelli liberamente disponibili. Non è documentato, sarebbe una speculazione. Per la pianificazione basta l'avvertenza che le ipotesi su un vantaggio duraturo dei difensori sono rischiose.
Secondo la pagina di Fairwind, le organizzazioni non autorizzate possono usare lo strumento CodeMender con modelli disponibili pubblicamente. Qui non è stato testato direttamente. Mostra però che anche senza accesso al livello più alto esistono strade per la ricerca di errori supportata dall'IA.
Che cosa ha mostrato Anthropic: cinque catene di exploit e lo stato delle patch
Un exploit è un frammento di codice che sfrutta una vulnerabilità di sicurezza. Una catena di exploit collega più vulnerabilità, in modo che da un piccolo errore nasca un attacco completo. Il Frontier Red Team di Anthropic descrive il 27 ottobre 2026 che un modello di ricerca interno non pubblicato, con istruzioni iniziali e scarsa partecipazione umana, avrebbe costruito catene funzionanti. Il modello non viene nominato ed è diverso da Carbon. Entrambe le notizie indicano però la stessa direzione
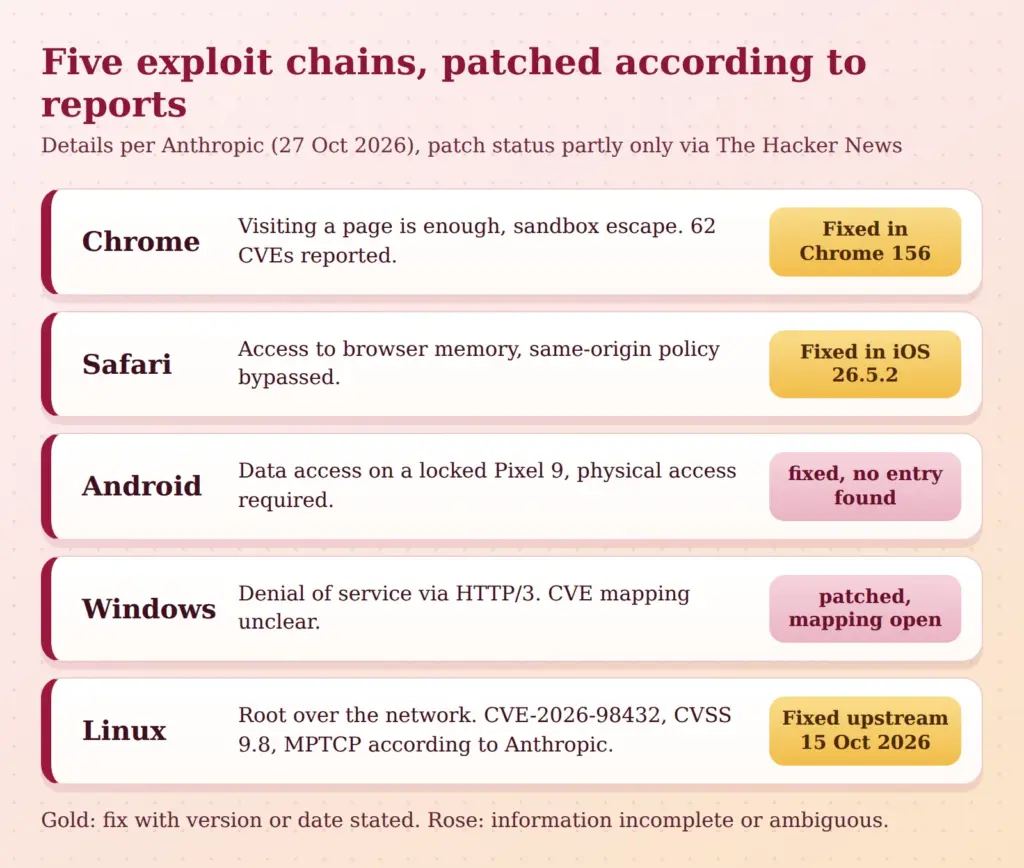
I cinque casi in sintesi, sempre secondo le fonti citate:
- Chrome: basta visitare una pagina per eseguire codice al di fuori della sandbox. La sandbox è lo strato di protezione che separa i contenuti web dal resto del sistema. La catena combina quattro vulnerabilità, tra cui errori di memoria nel motore JavaScript V8, una race condition (un errore che dipende dalla sequenza temporale di operazioni parallele) e un use-after-free (accesso a memoria già liberata). Anthropic ha segnalato 62 CVE, cioè voci pubbliche numerate di vulnerabilità, tutte critiche o alte, tra cui secondo Anthropic 13 evasioni dalla sandbox. La correzione è contenuta in Chrome 156.
- Safari: accesso in lettura e scrittura alla memoria del browser, la same-origin policy viene aggirata. Secondo The Hacker News è stato corretto in iOS e iPadOS 26.5.2.
- Android: accesso ai dati di un Pixel 9 bloccato e rubato tramite USB. È necessario l'accesso fisico. Secondo Anthropic Google ha corretto la vulnerabilità; secondo The Hacker News non è stata trovata una voce pubblica.
- Windows: un denial of service tramite HTTP/3. Anthropic descrive una vulnerabilità nel kernel, The Hacker News rimanda a una CVE la cui descrizione cita HTTP.sys. L'attribuzione non è chiara.
- Linux: comandi come root via rete, senza autenticazione, se è attivo un listener MPTCP. MPTCP (Multipath TCP) consente a una connessione di usare più percorsi di rete contemporaneamente. Secondo Anthropic l'aggiramento di KASLR, una protezione basata su indirizzi di memoria casuali nel kernel, ha richiesto 48 minuti, dopodiché sono serviti altri cinque minuti per ottenere una root shell. Viene indicata la CVE-2026-98432 con CVSS 9,8, un valore nella fascia più alta della scala di gravità da 0 a 10. Secondo le fonti la correzione è presente nel ramo principale di Linux dal 15 ottobre 2026.
Sulla catena Linux servono alcune riserve. Anthropic attribuisce la catena a una vulnerabilità MPTCP e cita la CVE-2026-98432. Il Debian Security Tracker descrive però la stessa CVE come un errore nel codice TCP IPv4, cioè come un use-after-free nel passaggio da un socket di richiesta al socket figlio. Il collegamento tra la CVE e MPTCP proviene quindi finora solo dal contributo di Anthropic. È possibile che le descrizioni siano incomplete o che la catena coinvolga più errori. Non è documentato.
Per inquadrare il tutto servono tre limiti. Primo, la quota di lavoro umano non è specificata. Che cosa abbia fatto un modello da solo non si può verificare dall'esterno; sono visibili solo le patch dei produttori. Secondo, un numero come 62 CVE indica quantità, ma non automaticamente uno sfruttamento in circolazione. Nei testi letti non ci sono indizi in tal senso. Terzo, le date relative a Chrome 156 (20 ottobre 2026) e alla versione Apple sono disponibili solo tramite The Hacker News; le fonti primarie non sono state consultate.
Ciclo di patch: quando le vulnerabilità vengono trovate più in fretta di quanto vengano distribuite le correzioni
Trovare una vulnerabilità è solo una parte del ciclo. Il patching avviene in modo decentrato: i produttori pubblicano le correzioni, le distribuzioni le impacchettano, i gestori le installano. Ogni fase richiede tempo. Se i modelli trovano più vulnerabilità più rapidamente e ricavano più in fretta exploit dalle correzioni pubblicate, la finestra tra correzione e sfruttamento si restringe. Questo ricavare l'exploit dalla correzione si chiama patch diffing: il confronto tra codice vecchio e nuovo rivela dove si trovava l'errore.
Le aziende europee devono applicare le patch in modo diverso a causa di Gemini 4 Carbon?
L'agenzia federale tedesca per la cybersicurezza ritiene che al momento il vantaggio sia degli aggressori. Oggi gli exploit nascono in tempi che vanno da pochi minuti a qualche ora. Per le aziende senza un proprio Security Operations Center, cioè senza un monitoraggio presidiato 24 ore su 24, ciò significa: classificare le segnalazioni per urgenza e tenere pronta una procedura d'emergenza. Come può essere una procedura di questo tipo nei primi minuti lo mostra il piano d'azione per i primi 60 minuti in caso di ransomware.
Dai casi di Anthropic derivano due conseguenze. La prima riguarda la quantità: un'unica release del browser conteneva correzioni per 62 CVE segnalate. La seconda riguarda la velocità: la correzione per Linux era nel ramo principale il 15 ottobre 2026, i pacchetti delle distribuzioni sono arrivati dopo, e quando raggiungano un server dipende dal gestore. Quanto rapidamente nascano exploit dopo una correzione lo ha mostrato di recente anche la vulnerabilità PHP nota come PHP2Shell.
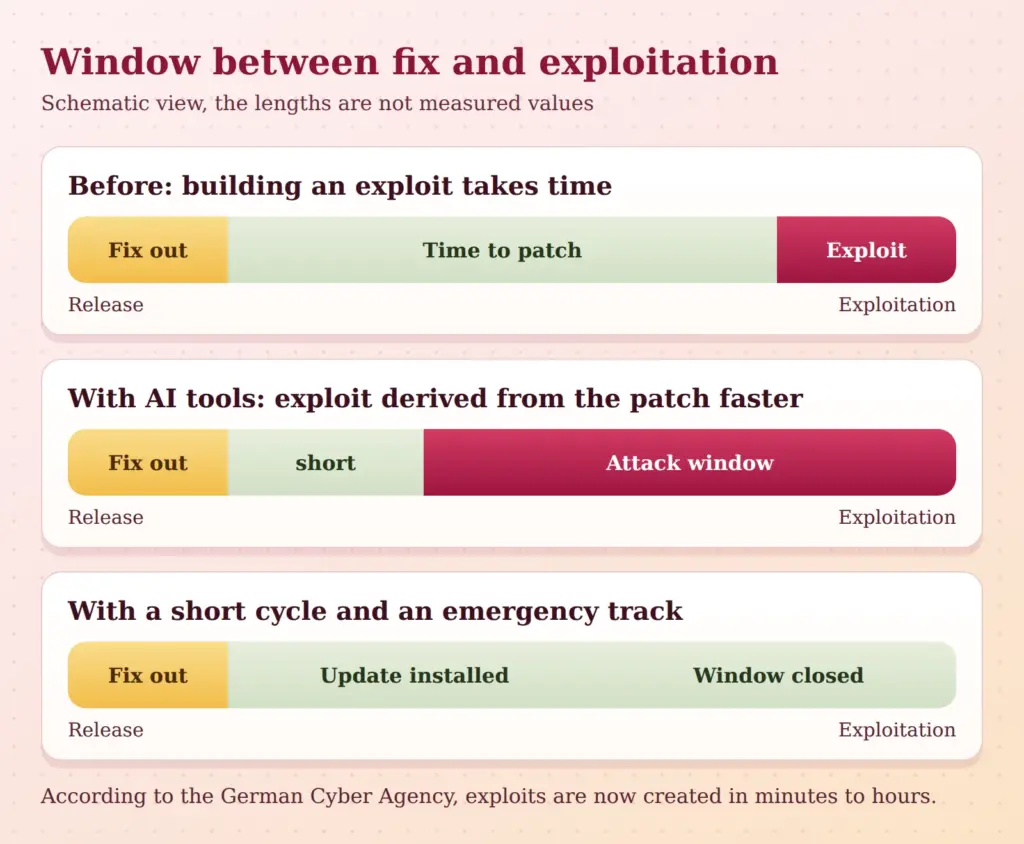
Se ne possono ricavare le seguenti raccomandazioni:
- Abbreviare il ciclo ordinario per sistemi operativi e browser, per esempio settimanale anziché mensile.
- Imporre gli aggiornamenti automatici del browser invece di lasciarli ai singoli utenti.
- Predisporre una seconda corsia per le emergenze che non richieda un giro di approvazione delle modifiche.
- Trattare per primi i sistemi esposti a Internet e misurare le scadenze in giorni anziché in settimane.
Una vulnerabilità che un modello trasforma in exploit in poche ore non aspetta il prossimo Patch Tuesday.
Produttori di software in Europa: che cosa cambia nello sviluppo e nella segnalazione
I produttori sono allo stesso tempo destinatari e bersaglio di queste scoperte. Secondo il proprio rapporto, Anthropic ha adottato una divulgazione coordinata con una scadenza di 90 giorni e 45 giorni aggiuntivi. Ciò presuppone che i produttori siano in grado di ricevere le segnalazioni, valutarle e correggerle rapidamente. Servono quindi un contatto reperibile per le segnalazioni di sicurezza, per esempio tramite un file security.txt, capacità per la valutazione, correzioni anche per i rami stable più vecchi e un ritmo di rilascio che consenta piccole correzioni.
Dal punto di vista giuridico è rilevante il Cyber Resilience Act. Secondo la Commissione europea gli obblighi di segnalazione per le vulnerabilità attivamente sfruttate si applicano dall'11 settembre 2026, gli altri obblighi principali dall'11 dicembre 2027. Le scadenze precise nel testo di legge non sono state verificate qui e restano quindi non indicate.
Resta aperto se i produttori europei otterranno lo stesso accesso ai modelli per la difesa. Per il momento restano alternative: valutare i programmi di altri fornitori, usare strumenti liberamente disponibili e integrare scansioni del codice nella propria pipeline. La conclusione è di partire dal presupposto che il software verrà esaminato da modelli potenti. Chi cerca per primo trova gli errori prima dei terzi.
Che cosa possono fare ora le aziende: server Linux, inventario, scadenze delle patch
I comandi sono strumenti standard e andrebbero verificati nel proprio ambiente prima dell'uso in produzione.
Verificare Multipath TCP
Secondo la documentazione del kernel, MPTCP è opt-in: le applicazioni devono richiederlo tramite il tipo di socket IPPROTO_MPTCP. Può però anche essere imposto dall'esterno, per esempio con lo strumento mptcpize. Un esempio: da Go 1.24 i listener creati tramite net.ListenConfig usano MPTCP per impostazione predefinita su Linux. Se un server possa essere interessato dipende quindi dal software in esecuzione. L'interruttore net.mptcp.enabled vale per ogni namespace di rete ed è impostato di default su 1.
Passi di verifica su un server:
sysctl net.mptcp.enabled
ss -Mlnp
uname -r
dpkg -l 'linux-image*'
apt policy linux-image-amd64
Il primo comando mostra l'interruttore, il secondo elenca i socket MPTCP in ascolto con il relativo processo (l'opzione -M mostra solo i socket MPTCP, i nomi dei processi richiedono i privilegi di root), il terzo la versione del kernel in esecuzione. Gli ultimi due comandi (per Debian e i sistemi derivati) mostrano i pacchetti del kernel installati e la loro versione. Se lì gira un servizio Go, può comparire come listener MPTCP. Se manca la chiave sysctl net.mptcp.enabled, il kernel non supporta MPTCP.
A causa dell'attribuzione poco chiara della CVE non basta disattivare MPTCP. Decisivo è lo stato del kernel, più precisamente la versione del pacchetto del kernel installato. Il confronto varia a seconda della distribuzione: le distribuzioni riportano spesso le correzioni su kernel più vecchi (backport), per cui l'output di uname -r da solo (per esempio 6.1.x) non dice nulla sullo stato della correzione. Determinante è la versione del pacchetto indicata nell'avviso di sicurezza della rispettiva distribuzione. Il Debian Security Tracker indica come corrette in bookworm le versioni 6.1.190-1 (security) e 6.12.113-1~deb12u1, in trixie la 6.12.113-1 e in forky la 7.2.12-1. È lo stato secondo il tracker e andrebbe consultato di nuovo il giorno dell'intervento. Per Ubuntu, Red Hat e SUSE le pagine di sicurezza non sono state consultate e vanno verificate autonomamente. Dopo l'aggiornamento del kernel è necessario un riavvio, salvo in caso di live patching.
Browser, sistemi operativi, inventario
- Browser: Chrome alla versione 156 o successiva, iOS e iPadOS alla 26.5.2 o successiva, installare gli aggiornamenti di Windows. Imporre le policy di aggiornamento nella gestione dei dispositivi.
- Scadenze: per primi browser e sistemi operativi esposti a Internet, scadenze in giorni. I numeri sono indicativi.
- Inventario: senza un inventario nessuno sa quale kernel gira su quale server o se esiste un listener MPTCP. L'elenco è la base di qualsiasi patching rapido.
L'IA dalla parte dei difensori: scansione del codice nelle pull request
Una pull request è una proposta di modifica al codice sorgente che viene verificata prima di essere accettata. Una scansione del codice nelle pull request fa controllare automaticamente ogni modifica anche da un modello. Questo integra l'analisi statica e la revisione umana, ma non le sostituisce. I risultati devono essere valutati da persone, perché i falsi allarmi sono frequenti e costano tempo.
Impostazioni tipiche sono una scansione a ogni pull request, il blocco in caso di risultati critici e la documentazione delle eccezioni. Protezione dei dati e riservatezza vanno chiarite in anticipo: il codice sorgente viene inviato a un fornitore. Andrebbero verificati il contratto e la Zero Data Retention, cioè l'impegno a non conservare gli input. La pagina di Fairwind cita questa opzione per Argon in Gemini Enterprise. Qui si evita volutamente di raccomandare un prodotto.
Uno sguardo dall'esterno
Un controllo del sito web mostra quali servizi e tecnologie un sito rivela all'esterno. I Security-Checks lo completano con i difetti di configurazione visibili. Nessuno dei due sostituisce gli aggiornamenti del kernel o la verifica del codice, ma entrambi offrono una visione esterna come quella che avrebbe anche un aggressore.
Conclusione: guadagnare tempo invece di rincorrere gli strumenti
L'accesso ai modelli più potenti è distribuito in modo diseguale; l'effetto per tutti gli altri arriva attraverso più scoperte e patch più rapide. I difensori guadagnano tempo con cicli più brevi, un inventario curato e verifiche automatiche nello sviluppo.
Restano aperti la data per il pubblico generale, le regole per l'Europa e la misurazione indipendente delle dichiarazioni di Google, aspetti che andrebbero seguiti ancora.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.