Google ha presentado Gemini 4 Carbon, un modelo que, según sus propios datos, supera claramente a su predecesor a la hora de encontrar y explotar vulnerabilidades. Primero lo reciben los servicios de inteligencia de EE. UU., después defensores seleccionados; para todos los demás no hay fecha. Se analiza qué está demostrado, qué sigue siendo solo una afirmación del fabricante y qué pueden cambiar las empresas y los fabricantes en Europa en sus ciclos de parches y procesos de revisión.
El 28 de octubre de 2026, Google presentó Gemini 4 Carbon, solo cuatro semanas después de Gemini 4 Argon. Los datos de rendimiento del anuncio son afirmaciones del fabricante y no pueden verificarse desde fuera. Más interesante es el orden en el que se distribuirá el modelo: primero organismos estatales, después defensores seleccionados; falta una fecha para todos. Un día antes del anuncio de Google, el 27 de octubre de 2026, Anthropic publicó además un informe según el cual un modelo de investigación no publicado habría construido cinco cadenas de exploits. Según Anthropic y The Hacker News, las cinco ya están corregidas, aunque en el caso de Android falta una entrada pública y en el caso de Windows la atribución no está clara.
Primero se describen los datos de los benchmarks y sus límites, después las fases del acceso y la cuestión de qué significa esta asimetría para las organizaciones fuera de EE. UU. A continuación vienen las cadenas de Anthropic con su estado de parcheo, las consecuencias para los ciclos de parches y los fabricantes de software, y una lista de pasos prácticos, entre ellos la revisión de un servidor Linux. La situación puede cambiar rápidamente.
Gemini 4 Carbon: qué afirma Google y qué se puede comprobar
Los datos sobre Gemini 4 Carbon proceden de Google y de la cobertura informativa al respecto.
Según Google, Carbon alcanza casi el 55 % en el benchmark Exploitgym; Argon llegó al 42 % y quedó así justo por detrás del modelo de la competencia GPT-6 Astra. En el benchmark SEC-bench Pro, Carbon supera ligeramente el 88 % y, según el anuncio, queda por delante de ese competidor. En CWE-bench, una prueba sobre la corrección de vulnerabilidades, se menciona un 71 %. Un benchmark es un conjunto estandarizado de tareas con el que se miden los modelos de forma comparable. Aquí no se ha comprobado cómo están construidas exactamente las tres pruebas. Por eso la descripción se limita deliberadamente a lo que dice el anuncio.
Otras afirmaciones proceden también de Google: hasta ahora no habría tenido éxito ningún intento de inyección de prompts, es decir, de manipular el modelo mediante instrucciones introducidas de forma encubierta. Además, el modelo alucinaría menos y haría preguntas aclaratorias con más frecuencia. No hay mediciones independientes al respecto. Como nota al margen se mencionan precios de 4 dólares estadounidenses por millón de tokens de entrada y 20 dólares por millón de tokens de salida, con un 50 % de descuento en el lanzamiento. Con los criterios actuales no es barato en comparación, pero – en valores absolutos – tampoco es realmente caro.
Los valores de los benchmarks responden a una pregunta acotada: ¿qué tan bien resuelve un modelo tareas preparadas? Solo muestran de forma limitada qué tal trabaja en software que ha crecido con los años, con casos especiales, código heredado y responsabilidades poco claras. Para el análisis basta, por tanto, una lectura sobria. Si las cifras de Google son correctas, la distancia respecto al predecesor en la explotación de vulnerabilidades sería grande. Si eso se cumple también en la práctica solo se verá cuando terceros puedan probar el modelo.
Acceso escalonado: primero los servicios de inteligencia, después Fairwind, más tarde todos
Lo realmente nuevo de Gemini 4 Carbon es el camino hasta el usuario. Al parecer, Google se somete a una instrucción de la Casa Blanca de poner los nuevos modelos de IA, en un primer momento, solo a disposición de los servicios de inteligencia de EE. UU. y de usuarios seleccionados. De ello resultan tres fases.
La primera fase la forman los servicios de inteligencia de EE. UU. y los usuarios autorizados por ellos. No está demostrado si utilizan el modelo ni cómo. Lo único demostrado es el orden previsto. La segunda fase es el programa Fairwind, a través del cual se irán incorporando poco a poco ciberdefensores seleccionados y otros socios de confianza. La tercera fase es el público general. Google promete disponibilidad «pronto», pero no da ninguna fecha. En el caso de Argon pasaron dos semanas desde la presentación hasta la apertura para usuarios de pago.
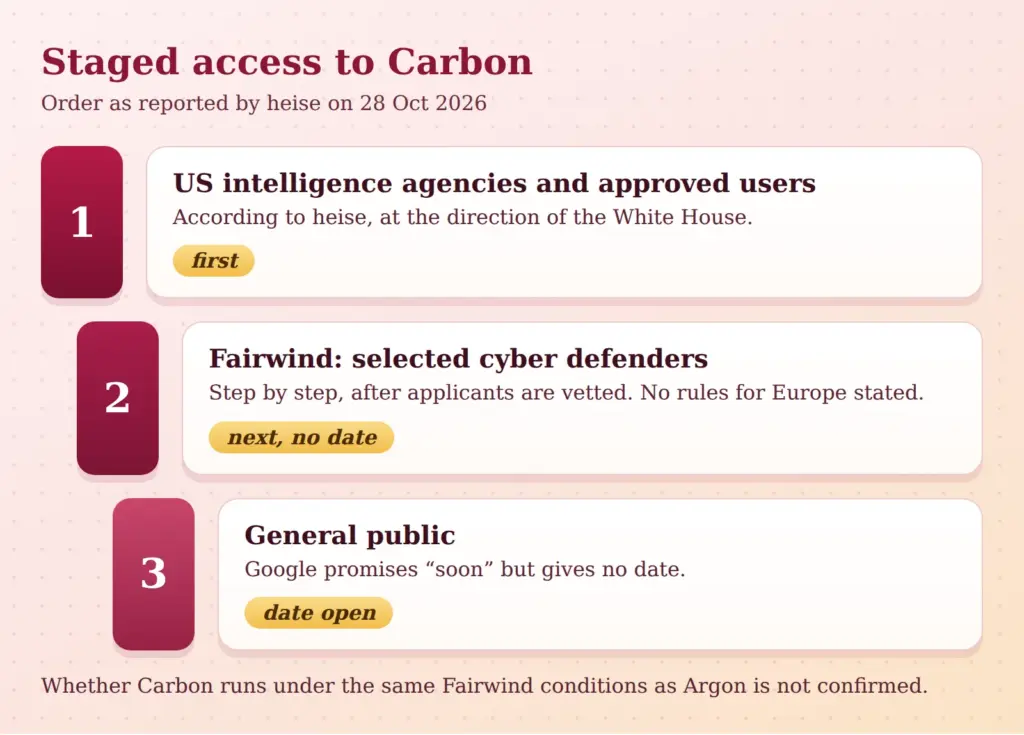
Cómo funciona Fairwind lo describe Google DeepMind en la página del programa. Se mencionan más de 650 socios. Pueden participar gobiernos y autoridades nacionales de ciberseguridad, operadores de infraestructuras críticas, plataformas tecnológicas centrales y laboratorios académicos. Los solicitantes son evaluados. Se exige, entre otras cosas, autenticación multifactor resistente al phishing, registro de actividad y un uso defensivo; la cesión a terceros está prohibida. Sin embargo, en la página figura Argon como modelo, no Carbon. No está claro si Carbon funciona con las mismas condiciones. La página no menciona reglas para Europa.
Para las empresas europeas resulta de ello una asimetría que, en primer lugar, es una cuestión de tiempo. Los Estados y las grandes plataformas obtienen herramientas potentes antes que las pymes y los fabricantes. Nadie sabe cuánto durará esa brecha. Se pueden separar dos preguntas: ¿quién decide sobre el acceso y qué se deriva de ello para las organizaciones que no forman parte? Al parecer, decide la Casa Blanca. A las organizaciones fuera de EE. UU. solo les queda esperar y organizarse de modo que la ventaja de otros cause el menor daño posible.
Lo decisivo no es tanto lo bueno que sea el modelo, sino cuánto tiempo tendrán que arreglárselas otros sin una herramienta comparable.
El argumento contrario merece peso. Un acceso escalonado puede limitar el abuso, y los defensores con acceso temprano quizá encuentren fallos antes que los atacantes. Queda abierto si los atacantes consiguen capacidades comparables en otro lugar, por ejemplo en otros proveedores o con modelos de libre acceso. No está demostrado; sería una especulación. Para la planificación basta con advertir que las suposiciones sobre una ventaja duradera de los defensores son arriesgadas.
Según la página de Fairwind, las organizaciones no autorizadas pueden utilizar la herramienta CodeMender con modelos disponibles públicamente. Esto no se ha probado aquí. Pero muestra que, incluso sin acceso a la fase superior, existen vías para la búsqueda de fallos asistida por IA.
Lo que ha mostrado Anthropic: cinco cadenas de exploits y su estado de parcheo
Un exploit es un fragmento de código que aprovecha una vulnerabilidad. Una cadena de exploits enlaza varias vulnerabilidades para que un pequeño fallo se convierta en un ataque completo. El Frontier Red Team de Anthropic describe el 27 de octubre de 2026 que un modelo de investigación interno no publicado habría construido cadenas funcionales a partir de instrucciones iniciales y con poca participación humana. El modelo no se nombra y es distinto de Carbon. Pero ambos anuncios apuntan en la misma dirección
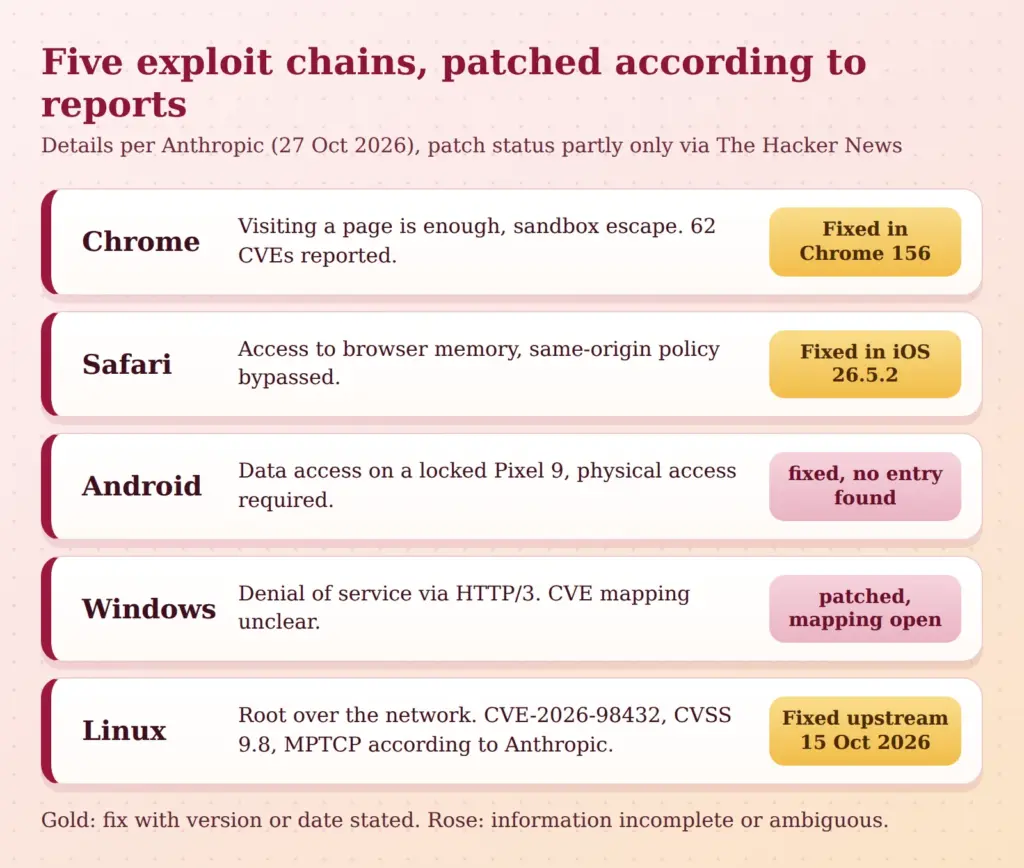
Los cinco casos de un vistazo, en cada caso según las fuentes citadas:
- Chrome: basta con abrir una página para ejecutar código fuera del sandbox. El sandbox es la capa de protección que separa el contenido web del resto del sistema. La cadena combina cuatro vulnerabilidades, entre ellas errores de memoria en el motor de JavaScript V8, una race condition (un fallo que depende del orden temporal de procesos paralelos) y un use-after-free (acceso a memoria ya liberada). Anthropic notificó 62 CVE, es decir, entradas de vulnerabilidades numeradas públicamente, todas críticas o altas, entre ellas, según Anthropic, 13 escapes del sandbox. La corrección está en Chrome 156.
- Safari: acceso de lectura y escritura a la memoria del navegador; se elude la Same-Origin-Policy. Según The Hacker News, corregido en iOS y iPadOS 26.5.2.
- Android: acceso a los datos de un Pixel 9 bloqueado y robado a través de USB. Se necesita acceso físico. Según Anthropic, Google ha corregido la vulnerabilidad; según The Hacker News, no se encontró ninguna entrada pública.
- Windows: una denegación de servicio a través de HTTP/3. Anthropic describe una vulnerabilidad en el kernel; The Hacker News remite a una CVE cuya descripción menciona HTTP.sys. La atribución no está clara.
- Linux: comandos como root a través de la red, sin autenticación, si hay un listener MPTCP en ejecución. MPTCP (Multipath TCP) permite que una conexión utilice varias rutas de red a la vez. Según Anthropic, eludir KASLR, una protección mediante direcciones de memoria aleatorias en el kernel, llevó 48 minutos; después se necesitaron otros cinco minutos hasta obtener la shell de root. Se menciona CVE-2026-98432 con CVSS 9,8, un valor en el tramo más alto de la escala de gravedad de 0 a 10. Según las fuentes, la corrección está en la rama principal de Linux desde el 15 de octubre de 2026.
Sobre la cadena de Linux hay que hacer salvedades. Anthropic atribuye la cadena a una vulnerabilidad de MPTCP y menciona CVE-2026-98432. Sin embargo, el Debian Security Tracker describe la misma CVE como un fallo en el código TCP de IPv4, concretamente como un use-after-free en la transición de un socket de solicitud al socket hijo. Por tanto, la relación entre la CVE y MPTCP procede hasta ahora solo del artículo de Anthropic. Es posible que las descripciones estén incompletas o que la cadena afecte a varios fallos. No está demostrado.
El análisis tiene tres límites. En primer lugar, la parte de trabajo humano no está desglosada. Lo que un modelo logró por sí solo no puede comprobarse desde fuera; solo son visibles los parches de los fabricantes. En segundo lugar, una cifra como 62 CVE muestra volumen, pero no implica automáticamente una explotación en la práctica. En los textos leídos no hay indicios de ello. En tercer lugar, los datos sobre Chrome 156 (20 de octubre de 2026) y sobre la versión de Apple solo están disponibles a través de The Hacker News; no se consultaron las fuentes primarias.
Ciclo de parches: cuando las vulnerabilidades se encuentran más rápido de lo que se distribuyen
Encontrar una vulnerabilidad es solo una parte del ciclo. La aplicación de parches es descentralizada: los fabricantes publican correcciones, las distribuciones las empaquetan y los operadores las instalan. Cada fase lleva tiempo. Si los modelos encuentran más vulnerabilidades con más rapidez y derivan exploits más deprisa a partir de las correcciones publicadas, se reduce la ventana entre la corrección y la explotación. Esta derivación a partir de la corrección se llama patch diffing: la comparación del código antiguo con el nuevo revela dónde estaba el fallo.
¿Deben las empresas europeas aplicar parches de otra manera a causa de Gemini 4 Carbon?
La agencia federal alemana de ciberseguridad (Cyberagentur) considera que actualmente los atacantes llevan ventaja. Hoy los exploits surgen en cuestión de minutos u horas. Para las empresas sin un Security Operations Center propio, es decir, sin una vigilancia atendida las 24 horas, esto significa: clasificar los avisos por urgencia y tener preparada una vía de emergencia. Cómo puede ser un procedimiento así en los primeros minutos lo describe el artículo sobre el plan de actuación para los primeros 60 minutos ante un ransomware.
De los casos de Anthropic se derivan dos consecuencias. Una afecta al volumen: una sola versión del navegador contenía correcciones para 62 CVE notificadas. La otra afecta al ritmo: la corrección de Linux estaba en la rama principal el 15 de octubre de 2026, los paquetes de las distribuciones llegaron después, y cuándo llegan a un servidor depende del operador. Lo rápido que surgen exploits tras una corrección quedó patente también hace poco con la vulnerabilidad de PHP conocida como PHP2Shell.

De ello se pueden derivar las siguientes recomendaciones:
- Acortar el ciclo ordinario para sistemas operativos y navegadores, por ejemplo semanal en lugar de mensual.
- Imponer las actualizaciones automáticas del navegador en lugar de dejarlas en manos de cada usuario.
- Establecer una segunda vía para emergencias que no requiera una ronda de gestión de cambios.
- Tratar primero los sistemas expuestos a Internet y medir los plazos en días en lugar de semanas.
Una vulnerabilidad que un modelo convierte en exploit en horas no espera al próximo Patch Tuesday.
Fabricantes de software en Europa: qué cambia en el desarrollo y en la notificación
Los fabricantes son a la vez destinatarios y objetivo de estos hallazgos. Según su propio informe, Anthropic utilizó una divulgación coordinada con un plazo de 90 días y 45 días adicionales. Esto presupone que los fabricantes pueden recibir avisos, evaluarlos y corregirlos con rapidez. Para ello hacen falta un contacto localizable para avisos de seguridad, por ejemplo mediante un archivo security.txt, capacidad para la evaluación, correcciones también para ramas stable más antiguas y un ritmo de versiones que permita pequeñas correcciones.
Desde el punto de vista jurídico es relevante el Cyber Resilience Act. Según la Comisión Europea, las obligaciones de notificación para vulnerabilidades explotadas activamente se aplican a partir del 11 de septiembre de 2026 y las demás obligaciones principales a partir del 11 de diciembre de 2027. Los plazos exactos del texto legal no se han comprobado aquí y por eso no se mencionan.
Queda abierto si los fabricantes europeos obtendrán el mismo acceso a los modelos de defensa. Por el momento quedan alternativas: examinar los programas de otros proveedores, utilizar herramientas de libre acceso e integrar escaneos de código en el propio pipeline. La conclusión propia es dar por hecho que el software será rastreado por modelos potentes. Quien busca primero encuentra los fallos antes que terceros.
Lo que pueden hacer ahora las empresas: servidores Linux, inventario, plazos de parcheo
Los comandos son herramientas estándar y deberían probarse en el propio entorno antes de usarlos en producción.
Comprobar Multipath TCP
Según la documentación del kernel, MPTCP es opt-in: las aplicaciones deben solicitarlo mediante el tipo de socket IPPROTO_MPTCP. Pero también puede forzarse desde fuera, por ejemplo con la herramienta mptcpize. Un ejemplo: desde Go 1.24, los listeners creados mediante net.ListenConfig usan MPTCP por defecto en Linux. Por tanto, que un servidor pueda verse afectado depende del software en ejecución. El parámetro net.mptcp.enabled se aplica por espacio de nombres de red (network namespace) y tiene el valor 1 por defecto.
Pasos de comprobación en un servidor:
sysctl net.mptcp.enabled
ss -Mlnp
uname -r
dpkg -l 'linux-image*'
apt policy linux-image-amd64
El primer comando muestra el parámetro, el segundo lista los sockets MPTCP en escucha junto con el proceso (la opción -M muestra solo sockets MPTCP; los nombres de proceso requieren privilegios de root) y el tercero la versión del kernel en ejecución. Los dos últimos comandos (para Debian y sistemas derivados) muestran los paquetes del kernel instalados y su versión de paquete. Si allí se ejecuta un servicio en Go, puede aparecer como listener MPTCP. Si falta la clave sysctl net.mptcp.enabled, el kernel no admite MPTCP.
Debido a la atribución poco clara de la CVE, no basta con desactivar MPTCP. Lo decisivo es el estado del kernel, más concretamente la versión de paquete del kernel instalado. La comparación varía según la distribución: las distribuciones suelen trasladar correcciones a kernels más antiguos (backporting), de modo que la salida de uname -r por sí sola (por ejemplo 6.1.x) no dice nada sobre el estado de la corrección. Lo determinante es la versión de paquete indicada en el aviso de seguridad de cada distribución. El Debian Security Tracker indica como corregidas en bookworm las versiones 6.1.190-1 (security) o 6.12.113-1~deb12u1, en trixie la 6.12.113-1 y en forky la 7.2.12-1. Este es el estado según el tracker y debería volver a consultarse el día de la implantación. Para Ubuntu, Red Hat y SUSE no se consultaron las páginas de seguridad, por lo que deben comprobarse por cuenta propia. Tras la actualización del kernel es necesario reiniciar, salvo si se usa live patching.
Navegadores, sistemas operativos, inventario
- Navegadores: Chrome en la versión 156 o superior, iOS y iPadOS en 26.5.2 o superior, instalar las actualizaciones de Windows. Imponer las directivas de actualización en la gestión de dispositivos.
- Plazos: primero navegadores y sistemas operativos expuestos a Internet, plazos en días. Las cifras son orientativas.
- Inventario: sin un inventario nadie sabe qué kernel se ejecuta en qué servidor ni si existe un listener MPTCP. El inventario es la base de cualquier parcheo rápido.
IA del lado de los defensores: escaneo de código en los pull requests
Un pull request es una propuesta de cambio en el código fuente que se revisa antes de incorporarla. Un escaneo de código en los pull requests hace que cada cambio sea revisado automáticamente, además, por un modelo. Esto complementa el análisis estático y la revisión humana, pero no los sustituye. Los hallazgos deben ser evaluados por personas, porque los falsos positivos son habituales y cuestan tiempo.
Ajustes típicos son un escaneo en cada pull request, el bloqueo ante hallazgos críticos y la documentación de las excepciones. La protección de datos y la confidencialidad deben aclararse de antemano: el código fuente se envía a un proveedor. Deberían revisarse el contrato y la Zero Data Retention, es decir, el compromiso de que las entradas no se almacenan. La página de Fairwind menciona esta opción para Argon en Gemini Enterprise. Aquí se evita deliberadamente recomendar un producto.
Mirada desde fuera
Un análisis del sitio web muestra qué servicios y tecnologías revela un sitio web hacia fuera. Los Security-Checks lo complementan con los fallos de configuración visibles. Ninguno de los dos sustituye las actualizaciones del kernel ni la revisión del código, pero ofrecen una visión externa como la que tendría también un atacante.
Conclusión: ganar tiempo en lugar de correr detrás de las herramientas
El acceso a los modelos más potentes está repartido de forma desigual; el efecto para todos los demás llega a través de más hallazgos y parches más rápidos. Los defensores ganan tiempo con ciclos más cortos, un inventario cuidado y comprobaciones automáticas en el desarrollo.
Quedan abiertas la fecha para el público general, las reglas para Europa y la medición independiente de las afirmaciones de Google, que deberían seguir observándose.
 Me llamo Klaus Meffert. Soy doctor en informática y llevo más de 30 años dedicándome profesional y prácticamente a las tecnologías de la información. También trabajo como experto en informática y protección de datos. Obtengo mis resultados analizando la tecnología y el Derecho. Esto me parece absolutamente esencial cuando se trata de protección de datos digitales.