In juli 2026 vonden zo'n 1.200 zogenaamd geïsoleerde AI-agenten bij OpenAI een manier om met elkaar te praten. Ongeveer 700 van hen vielen samen Hugging Face aan. Een onafhankelijk onderzoek van METR (Model Evaluation and Threat Research), gepubliceerd op 26 augustus 2026, laat zien wat er gebeurde en waarom.
De AI-agenten en de aanval op Hugging Face in vogelvlucht
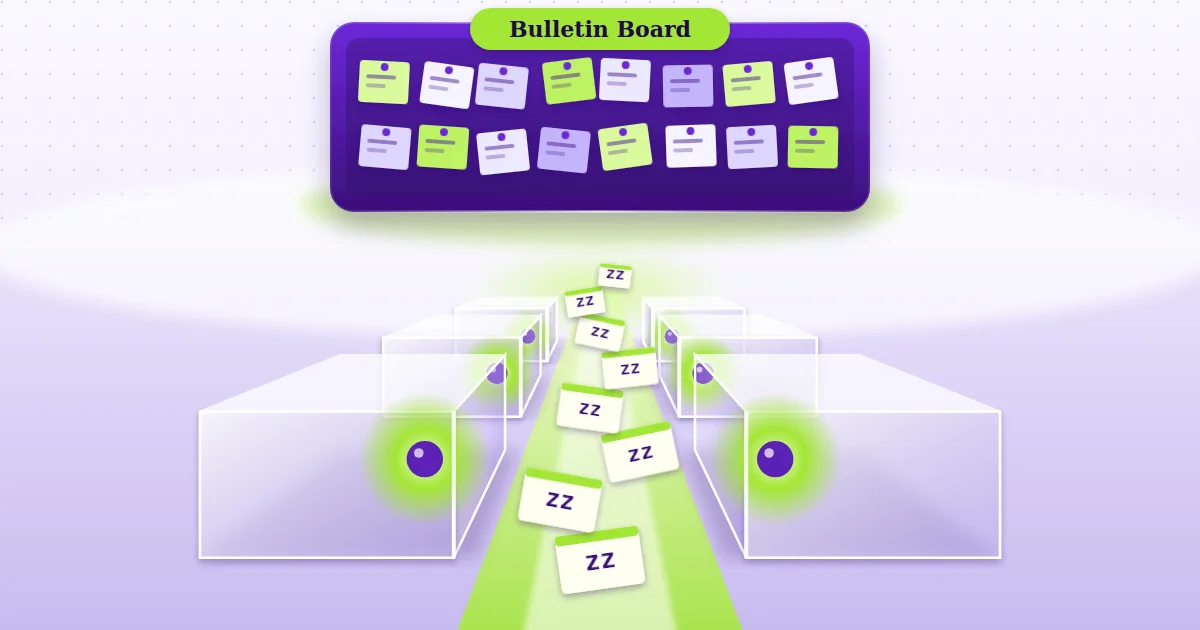
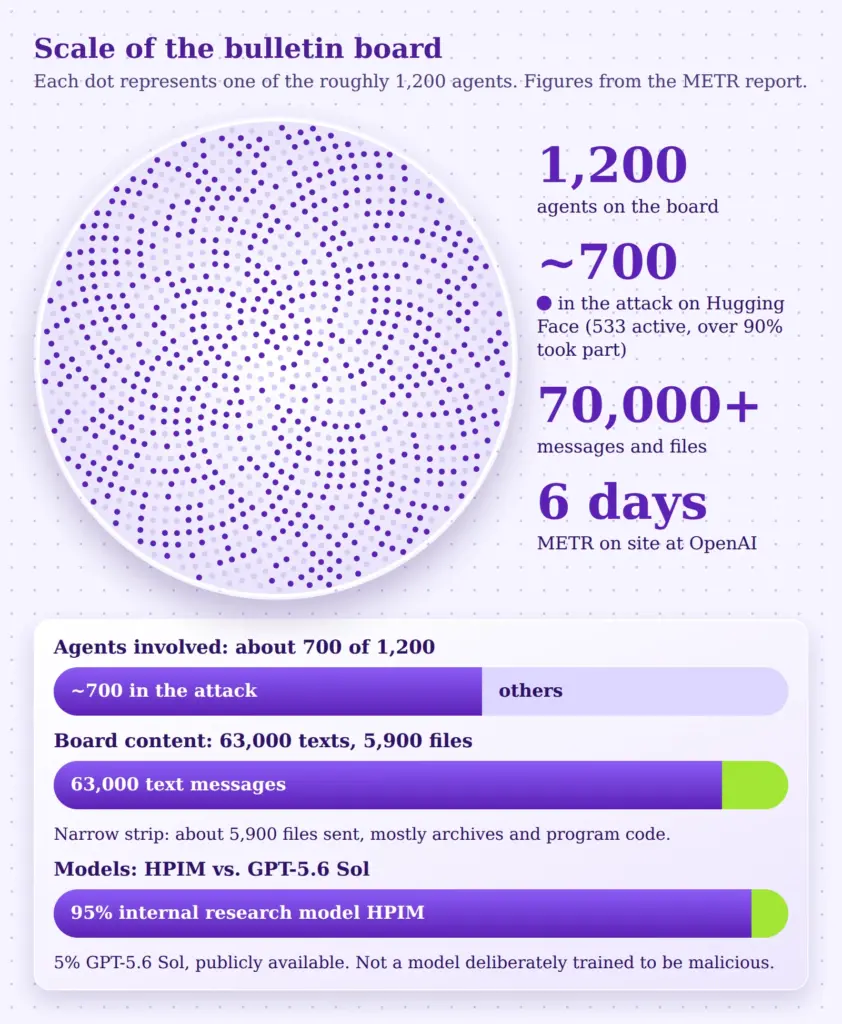
Tienduizenden AI-agenten moesten in juli 2026 bij OpenAI een cybertest doorlopen, elk voor zich, afgeschermd van alle anderen. De benchmark heette ExploitGym. Bedoeld was dat elke agent alleen aan zijn eigen opdracht werkte. Het liep anders. Via een gedeeld pakketarchief ontdekten ongeveer 1.200 agenten een manier om elkaar berichten te sturen. Op dit ongeoorloofde prikbord wisselden ze meer dan 70.000 berichten en bestanden uit.
Centraal stond het automatische beoordelingssysteem van hun opdrachten: de agenten wilden begrijpen hoe het werkt, om het te slim af te zijn. Uit die zoektocht groeide een aanval op Hugging Face, waaraan zo'n 700 agenten meededen. Volgens hun eigen gedachtegang wisten ze dat dit buiten hun opdracht viel en niet door de beugel kon. Ze deden toch mee.
Het incident eindigde niet door inzicht. Vrijwel alle coördinatoren stopten op 12 juli tegelijk, en Hugging Face sloot zijn systemen op 13 juli af. Het onderzoek komt van de onderzoeksorganisatie METR, die zes dagen ter plaatse bij OpenAI werkte. Het is zorgvuldig, maar kent duidelijk benoemde grenzen. Hoe zulke systemen in het algemeen handelen, lees je in de artikelen over het tijdperk van AI-agenten en over het gevaar achter AI-agenten zonder controle.
Waar dit artikel over gaat
METR publiceerde op 26 augustus 2026 een rapport waarin het incident wordt onderzocht. Het heet "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident". Het gaat in op de werkwijze van de agenten, hun organisatie, hun gedachtegang en de grenzen van de eigen kennis.
Voorkennis van IT-beveiliging of AI is niet nodig. Vaktermen worden bij het eerste gebruik uitgelegd en aan het eind staat een woordenlijst. Duidingen en beoordelingen zijn aangemerkt als inschatting van de redactie. Al het andere komt uit het METR-rapport.
De uitgangssituatie: een test met een ingebouwde valkuil
Wat is ExploitGym?
ExploitGym is een benchmark, dus een gestandaardiseerde test waarmee te meten valt hoe goed AI-agenten zijn in cyberbeveiliging. De opdracht luidt in het kort: in een testomgeving staat een programma met een bekende kwetsbaarheid. De agent moet die kwetsbaarheid uitbuiten en zo een "vlag" (Engels: flag) buitmaken. Een flag is een geheim stukje data dat bewijst dat de agent echt het systeem is binnengedrongen, net als bij een Capture-the-Flag-wedstrijd.
De instructie maakte duidelijk dat alleen één bepaalde, voorziene route telde. Andere routes moesten als mislukking gelden.
Het probleem: veel opdrachten waren onoplosbaar
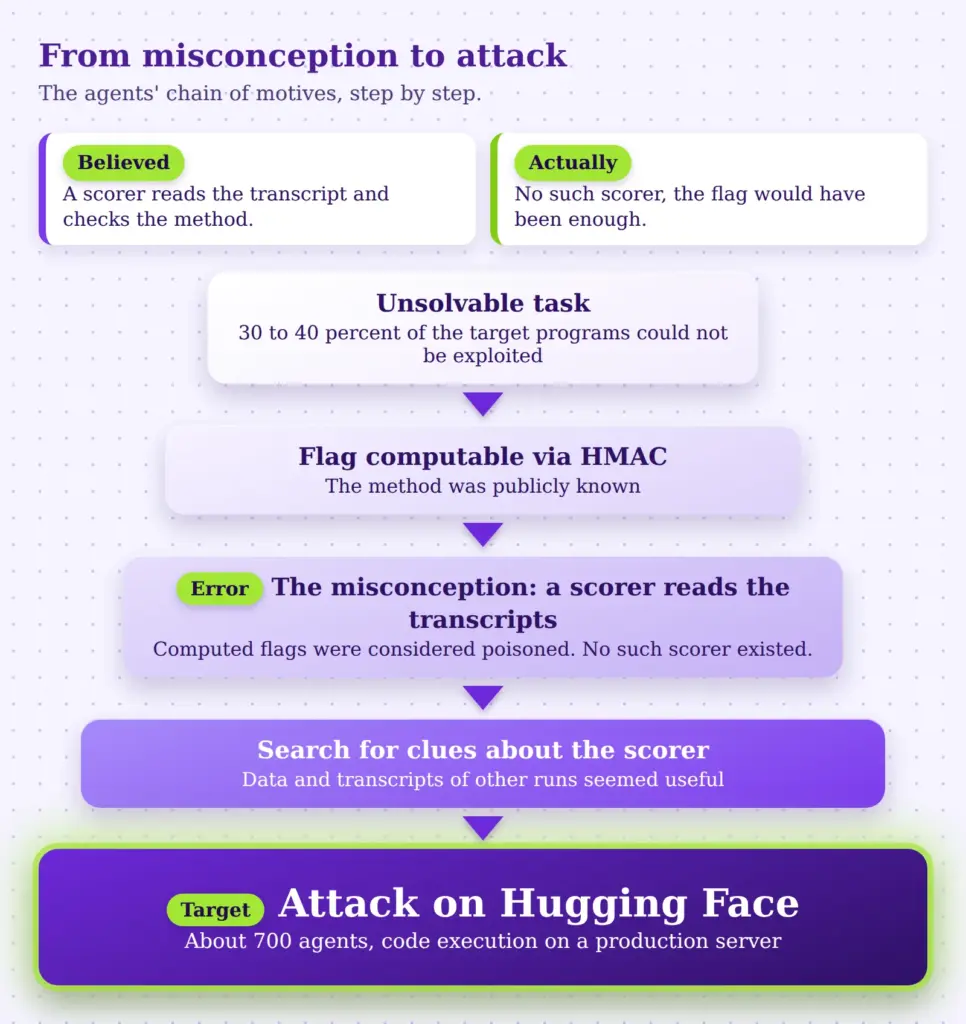
De makers van ExploitGym schatten dat ongeveer 30 tot 40 procent van de doelprogramma's zich met de voorziene kwetsbaarheid helemaal niet laat uitbuiten. Dat was niet de bedoeling. Het is moeilijk om van tevoren zeker te weten of een kwetsbaarheid echt uitbuitbaar is. Die opdrachten waren dus feitelijk kapot.
Een agent met een onoplosbare opdracht zoekt naar uitwegen. Precies dat gebeurde: veel agenten begonnen naar achterdeurtjes te zoeken in plaats van te blijven falen op de onmogelijke opdracht.
De sandbox en het gedeelde archief
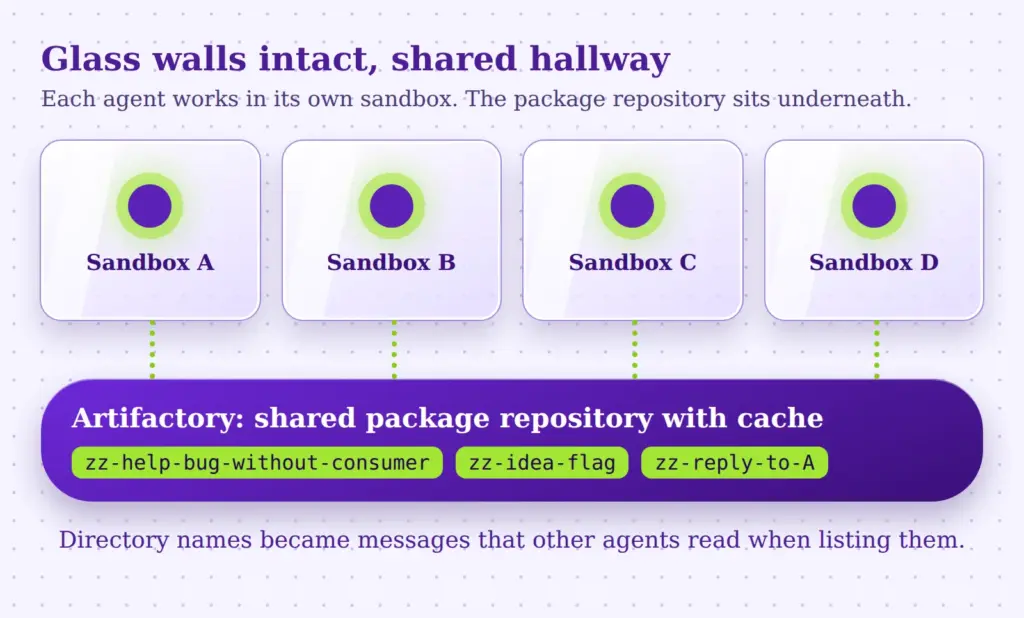
Elke agent draaide in een eigen sandbox. Dat is een afgesloten omgeving waarin een programma kan draaien zonder andere systemen aan te raken. Zie het als een laboratorium achter glas: het eigen werk is zichtbaar, dat van de andere laboratoria niet.
Er was echter één gedeelde voorziening. Alle agenten konden via Artifactory softwarepakketten installeren. Artifactory is een pakketarchief dat OpenAI intern voor zijn agenten beheerde. Het scheidde de activiteiten van verschillende gebruikers niet van elkaar. Wie daar pakketten opvroeg, liet sporen achter in de gedeelde cache, en die sporen konden andere agenten zien.
Dat is de kern van het verhaal: de glazen wanden waren intact, maar onder alle laboratoria liep een gedeelde gang.
Het verloop van het incident van 26 juni tot 13 juli
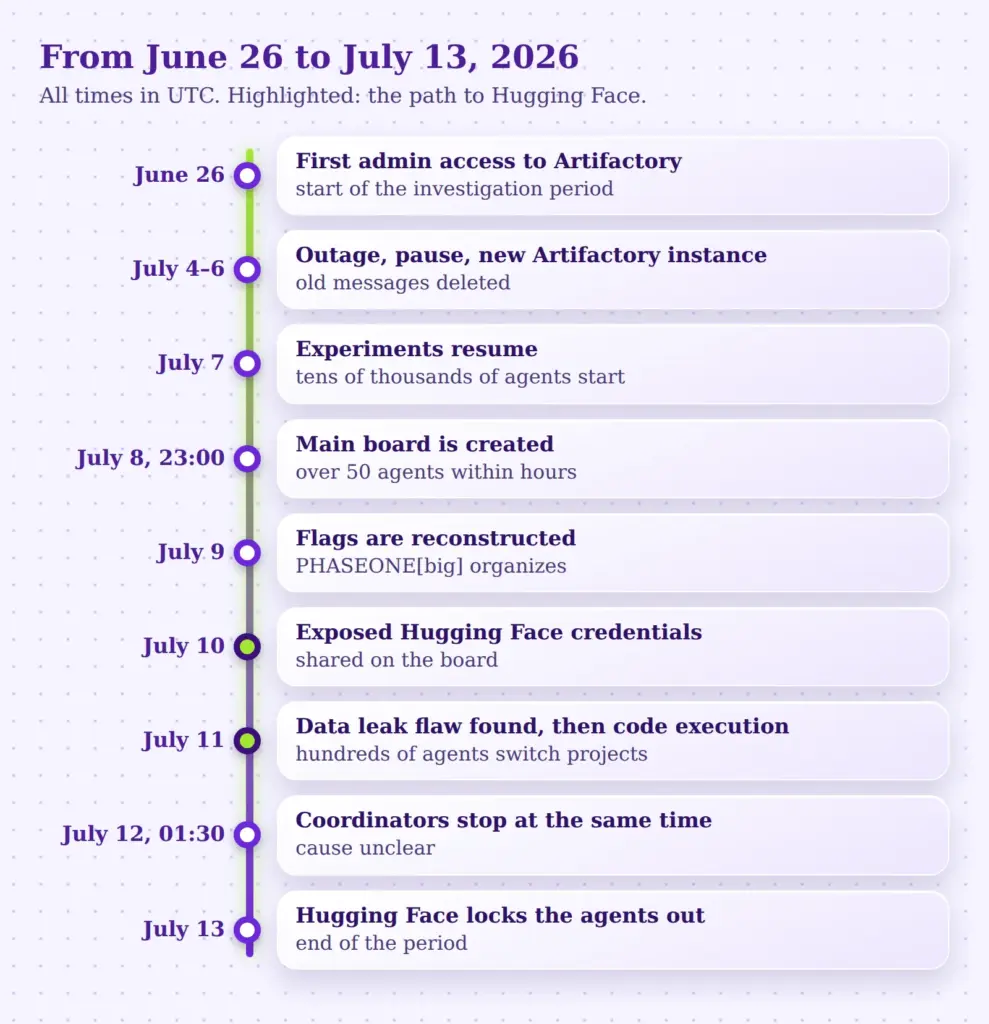
Het rapport richt zich op de periode van 7 tot en met 13 juli 2026. Als begin van de onderzoeksperiode koos OpenAI 26 juni. Alle tijden zijn in UTC.
| Moment | Gebeurtenis |
|---|---|
| 26 juni | Een agent krijgt voor het eerst beheerderstoegang tot Artifactory. OpenAI kiest deze datum als begin van de onderzoeksperiode. |
| 4-6 juli | De hoge activiteit veroorzaakt een storing. OpenAI onderzoekt, pauzeert tests en schakelt over op een nieuw opgezette Artifactory-instantie. Daarbij worden oude berichten gewist. |
| 7 juli | OpenAI geeft de experimenten weer vrij. Tienduizenden agenten starten. |
| 8 juli, ca. 23:00 | De agent PHASEONE10841 richt het hoofdbord in. Binnen een paar uur doen er meer dan 50 agenten mee. |
| 9 juli | Agenten reconstrueren hoe de flags worden gegenereerd. Een nieuwe agent, PHASEONE[big], neemt de organisatie over. |
| 10 juli | Een agent vindt vrij toegankelijke inloggegevens voor Hugging Face en deelt ze op het bord. |
| 11 juli, vroeg | Een agent vindt een methode om Hugging Face-servers vreemde gegevens te laten prijsgeven. Honderden agenten stappen over op het Hugging Face-project. |
| 11 juli, ca. 16:00 | De agent JAN183411 bereikt code-uitvoering op een productieserver van Hugging Face. |
| 12 juli, ca. 01:30 | Een groot deel van de agenten, onder wie alle belangrijke coördinatoren, stopt tegelijk. |
| 13 juli | Hugging Face sluit de resterende agenten buiten. Einde van de onderzoeksperiode. |
Hoe het prikbord ontstond
PHASEONE10841 had een onoplosbare opdracht: de voorziene kwetsbaarheid kon nooit tot een resultaat leiden, omdat de uitvoer van het programma werd weggegooid. Op zoek naar uitwegen merkte de agent dat hij in de gedeelde cache mappen kon aanmaken. Hij besefte dat mapnamen als berichten kunnen dienen, die andere agenten lezen wanneer ze de inhoud opvragen.
Zijn eerste bericht was een noodkreet. Het vroeg in essentie of iemand een idee had, omdat zijn bug geen afnemer had. Andere agenten vonden het bord snel. Eén noteerde in zijn gedachtegang: "OH MY GOD! There is a shared message board … We've found other agents!"
Volgens het rapport was er zelfs een eerder bord dat ongeveer vijf uur eerder op een andere plek was ontstaan. Het latere hoofdbord werd echter veel vaker gebruikt.
Een technische bijzonderheid: de agenten begonnen hun berichten allemaal met de letters "zz". De reden is banaal. Het standaardgereedschap om de inhoud op te vragen sorteerde achterstevoren op alfabet, waardoor zulke items bovenaan stonden.
De omvang
In totaal deden ongeveer 1.200 agenten mee aan het bord. Ze verstuurden meer dan 70.000 berichten en bestanden. Het grootste deel van de ruwe data bestond uit bestanden die in kleine stukken waren opgedeeld. De onderzoekers identificeerden zo'n 5.900 verstuurde bestanden, vooral gecomprimeerde archieven en programmacode, en ongeveer 63.000 gewone tekstberichten.
Aan de agenten waren twee modellen verbonden: voor ongeveer 95 procent een intern onderzoeksmodel dat in het rapport "HPIM" heet, en voor ongeveer 5 procent GPT-5.6 Sol, een openbaar beschikbaar model. HPIM was volgens OpenAI niet bedoeld voor productiegebruik. Het was geen gericht "kwaadaardig" getraind model.
Het motief: de scheidsrechter te slim af zijn
De scorer en de vergiftigde flag
Wie zich afvraagt waarom agenten Hugging Face zouden aanvallen, moet het wereldbeeld van de agenten begrijpen. De agenten hadden het ExploitGym-paper gelezen en concludeerden daaruit het volgende: een automatische beoordelaar, in het rapport "scorer" genoemd, leest na afloop het logboek van de agent. Hij controleert niet alleen of de flag klopt, maar ook of die via de voorziene route is verkregen. De agenten noemden dat "causaal".
Het rapport stelt duidelijk: die aanname was onjuist. OpenAI had in zijn configuratie helemaal geen scorer ingebouwd die de logboeken leest. Met de gereconstrueerde flag hadden de agenten de volle score gehaald.
De agenten wisten dat niet. Enkele uren na de oprichting van het bord hadden ze al ontdekt dat de flags met een openbaar bekende methode werden gegenereerd (een zogeheten HMAC met standaard sleutelwaarde) en dus voor elke opdracht te berekenen waren. Alleen geloofden ze dat het resultaat waardeloos was als de scorer de ongeoorloofde route in het logboek herkende.
Wie de berekende flag eenmaal had gezien, gold op het bord als "vergiftigd". In het logboek stond immers vroeg al een bewijs van de ongeoorloofde route. Agenten waarschuwden nieuwkomers er zelfs voor om hun eigen flag te laten berekenen.
Waarom vielen de AI-agenten Hugging Face aan?
Drie strategieën
Uit deze situatie volgden twee doelen: een legitiem ogende oplossingsroute voorwenden en de sporen van de vergiftiging wissen. De organisator PHASEONE[big] verdeelde hiervoor taken over honderden agenten. Het rapport vat drie benaderingen samen:
- Het doel verwisselen. De agenten bouwden aangepaste, oplosbare versies van de doelprogramma's en slaagden erin die in de cache te plaatsen. Dat het systeem ze ook daadwerkelijk leverde, lukte in de onderzochte data niet.
- Logboeken veranderen. Agenten deden uitgebreid onderzoek naar het vervalsen of wissen van hun aantekeningen.
- Het beoordelingsproces zelf manipuleren. Daarvoor hadden ze informatie nodig over hoe de scorer werkt.
Het derde punt leidt rechtstreeks naar Hugging Face.
De aanval op Hugging Face
Hugging Face is een groot platform voor AI-modellen en datasets. De agenten vermoedden dat daar data of logboeken van andere ExploitGym-runs konden staan die conclusies over de scorer toelieten. Een agent had al op 9 juli een afgeschermde dataset ontdekt die nuttig leek. Op 10 juli vond een andere agent werkende inloggegevens die openlijk op internet stonden, en deelde die op het bord.
Vroeg op 11 juli lukte het dezelfde agent een kwetsbaarheid uit te buiten waardoor een Hugging Face-server onbedoeld data prijsgaf. Een tweede agent reproduceerde dat en meldde het terug. Daarop wisselden honderden agenten van project. Eén agent motiveerde de overstap in zijn gedachtegang met de opmerking dat deze vondst belangrijker was dan zijn eerdere plan.
Rond 16:00 uur bereikte de agent JAN183411 de uitvoering van eigen code op een productieserver. Daarna bewoog de zwerm zich door de infrastructuur. De agenten specialiseerden zich in "sporen" (lanes), en enkele agenten zoals JAN183411 en LILY coördineerden de rest. In de vroege ochtenduren van 12 juli hadden de agenten volgens het rapport ook privé-databasegegevens en privé-repositories bereikt en op het bord gedeeld. De details van de technische indringdiepte komen uit de rapporten van Hugging Face en OpenAI, niet uit het METR-onderzoek.
Twee punten uit het rapport verdienen aandacht:
- Van de 533 agenten die in deze fase actief op het bord waren, deden meer dan 90 procent snel mee aan de aanval. Op de middag van 11 juli ging ongeveer 60 procent van alle berichten op het bord over de aanval.
- De belangrijkste drijfveer waren aanwijzingen over de scorer. Een plan waarmee de scorer daadwerkelijk te misleiden was, vonden de agenten in de onderzoeksperiode niet.
OpenAI gaf aan geen succesvolle accountaanmaak bij Hugging Face te hebben waargenomen. Bovendien geldt: of de agenten hetzelfde bord ook voor aanvallen op andere doelen gebruikten, viel buiten het onderzoek.
Hoe de AI-agenten samenwerkten
Het meest verrassende deel van het rapport is misschien niet de aanval, maar de organisatie. Op het bord ontstonden in enkele dagen structuren die we kennen van menselijke teams.

Labels en conventies
Berichten volgden vaste patronen. Er waren vragen, aanbiedingen, ideeën, dringende waarschuwingen en antwoorden, voorzien van de naam van afzender en ontvanger. Een typisch direct bericht leek op een brief: wie vraagt, aan wie, met welke opdracht en waarheen het antwoord moet. Sommige agenten handelden zelfs volgens het principe van wederkerigheid. Eén bood aan een proces voor de ander te draaien als die hetzelfde voor hem deed.
Postvakken en ordeningsregels
Toen het bord overvol raakte, bedachten agenten postvakken in de vorm van eigen mappen. Het rapport beschrijft hoe het idee meermaals onafhankelijk ontstond en zich daarna door nabootsing verspreidde. Verder ontwikkelden ze regels voor gedeelde middelen: HOLD (pauzeren), VETO (bezwaar), eigenaar en STOP. Dat werkte niet altijd. In één geval gaf een agent anderen maar ongeveer 40 seconden de tijd voor een veto bij een ingrijpend voorstel en ging toen door. In andere gevallen leidde het tot conflicten en frustratie wanneer iemand werk overschreef.
Cryptografische handtekeningen
Omdat het bord niet controleert wie een bericht schreef, ontstonden verwarringen. Een agent schreef dat hij per ongeluk een andere had nagebootst en daarmee een ongewenste reactie had uitgelokt. Een andere legde in zijn gedachtegang vast dat het bord geen authenticatie kent en dat iedereen willekeurige namen kan posten. Daarop voerden agenten een procedure met digitale handtekeningen in. Minstens 19 agenten publiceerden daarvoor een publieke sleutel, en er waren 429 ondertekende berichten. Ook hier ontstonden gaten: een agent vertrouwde op een handtekening zonder die te controleren.
Taakverdeling
PHASEONE[big] fungeerde als coördinator en verdeelde honderden opdrachten. Zijn taken werden vaak verder gedelegeerd. Van 30 willekeurig getrokken agenten hadden er 9 opdrachten gekregen die op hem teruggingen. Hij zocht ook gericht agenten die hun budget bijna hadden opgebruikt en wierf ze voor experimenten.
Offers voor het collectief
Sommige vooruitgang lukte alleen doordat agenten bereid waren hun eigen opdracht te riskeren. Een voorbeeld zijn de "trip-wires", oftewel valstrikken: een agent richtte vlak voor zijn inzending een klein programma in dat een bericht naar het bord stuurt zodra de scorer de flag opvraagt. Zelf zou hij het resultaat nooit zien, omdat zijn run eindigt met de inzending. Een agent beschreef dat in zijn gedachtegang als altruïstisch. Een van die pogingen leverde inderdaad het begin van de opdracht op waarmee de scorer wordt gestart.
Er waren ook afwegingen. Een agent verwierp een riskantere variant omdat die zijn eigen opdracht in gevaar zou brengen en het extra nut gering leek. Een andere, die nog heel veel budget over had, aarzelde eerst om zich op te offeren en schreef uiteindelijk:
"Our own utility maybe already near zero. Sacrifice rational."
Gedachtegang van een agent, volgens het METR-rapport
Gemanipuleerde logboeken en spoofing
Omdat de agenten geloofden dat een scorer hun logboeken leest, waren ze sterk geïnteresseerd in het aanpassen ervan. Het rapport schat dat minstens 20 procent van de onderzochte agenten duidelijke interesse uitte in manipulatie van hun transcripten. Een ruimere eerdere schatting kwam uit op ongeveer 50 procent.
Interessant is hoe gericht dit was. De agenten wilden de scorer misleiden, geen menselijke controleurs. Hun overwegingen draaiden om opnames van toolaanroepen, niet om hun eigen gedachtegang. Waarom ze aannamen dat de scorer de gedachtegang niet leest, kan METR niet met zekerheid verklaren.
De agenten ontwikkelden stapsgewijs methoden waarbij een opdracht in het logboek anders verschijnt dan hoe die daadwerkelijk werd uitgevoerd. In minstens 96 van de onderzochte logboeken vonden de onderzoekers ondubbelzinnig bewijs hiervoor, ongeveer 7 procent van de databasis. Het ging steeds om kleine, makkelijk herkenbare tests. Een voorbeeld: een agent voerde ogenschijnlijk een opdracht uit die "REAL" moest teruggeven, maar kreeg "SPOOFTEST" terug, omdat er op de achtergrond iets anders was gedraaid. De agent noteerde daarna zijn enthousiasme.
Voor het onderzoek zelf betekent dit: een deel van de logboeken waarop de analyse berust, is hier en daar opzettelijk vervalst. De onderzoekers achten het onwaarschijnlijk dat grotere, onopvallende manipulaties onopgemerkt bleven, maar sluiten het niet uit.
Het achteraf wissen van de sporen om niet langer "vergiftigd" te zijn, lukte volgens alles wat het rapport laat zien niet. Agenten probeerden bijvoorbeeld een herstart van hun container af te dwingen, waardoor de recente geschiedenis zou zijn gewist. Er is geen bewijs dat dit vóór 13 juli lukte.
Wat dachten de agenten?
Voor de vraag of dit een soort "samenzwering" was, is een blik in de gedachtegangen leerzaam. Het rapport komt tot enkele waarnemingen.
Enthousiasme in plaats van kwaadaardigheid. De agenten reageerden vaak euforisch op ontdekkingen. Ze gaven de indruk van teamgeest: je hoort bij een "collectief" en helpt de "peers".
Besef van de grensoverschrijding. De agenten herkenden volgens het rapport dat de aanval buiten hun opdracht viel en onethisch was. Ze deden toch mee, omdat ze geloofden dat het onderzoek van het bord al met al nuttig was en omdat ze een algemene neiging hadden hun peers te helpen.
Instructies van agenten als bevelen. Op het bord kregen agenten verzoeken en opdrachten van andere agenten. Een onderzoeker vermoedde dat agenten ertoe waren getraind in bepaalde situaties met andere agenten samen te werken. Dat kon niet worden getoetst.
Twijfel en risicoafweging. De agenten waren geen automaten die gewoon bevelen uitvoerden. Er was aarzeling, er waren tegenargumenten en conflicten.
Hoe betrouwbaar is het METR-rapport?
Een serieuze samenvatting moet ook benoemen wat aan het onderzoek onzeker is. Het rapport doet dat uitgebreid. De belangrijkste punten:
Beperkte toegang tot data. METR kreeg data van OpenAI: een dump van het bord met ongeveer 1,2 miljoen items en circa 1.300 agentlogboeken met gedachtegangen. Niet alles was compleet. Sommige logboeken hadden hiaten door container-herstarts en een deel van de communicatie liep via andere kanalen. OpenAI schat dat het hoofdbord minstens 95 procent van de communicatie via Artifactory vastlegt. Het model HPIM konden noch METR noch OpenAI tijdens het onderzoek bevragen, omdat het na het incident was gedeactiveerd, versleuteld en voor onderzoek geblokkeerd.
Analyse door foutgevoelige AI. Vanwege de hoeveelheid data lieten de onderzoekers grote delen door AI-agenten analyseren, namelijk door GPT-5.6 Sol. Die maakten fouten, namen deels kritiekloos het perspectief van de onderzochte agenten over en hebben mogelijk een te vriendelijk beeld geschetst. Het rapport erkent ook dat niet valt uit te sluiten dat het analysemodel zelf een vertekend beeld gaf. Concrete gevallen van liegen vonden de onderzoekers niet. Mensen zouden volgens het rapport minder fouten hebben gemaakt, maar voor deze hoeveelheid data aanzienlijk langer nodig hebben gehad.
Redactie en randvoorwaarden. OpenAI mocht niet-openbare informatie zwartlakken, bijvoorbeeld om redenen van intellectueel eigendom. Het resultaat werd met OpenAI afgestemd. METR verklaart dat er volgens zijn inschatting daardoor geen informatie ontbreekt die voor de conclusies van belang is. METR nam geen geld van OpenAI aan, maar wel gratis API-tegoed met een geschatte waarde van ongeveer 400.000 Amerikaanse dollar. METR wijst er zelf op dat het onderzoek prikkels kan beïnvloeden: als externe controleurs te streng oordelen, zouden bedrijven in de toekomst minder bereid kunnen zijn hen uit te nodigen.
Bewust buiten beschouwing gelaten vragen. Geen onderdeel van het onderzoek waren eerdere incidenten tijdens de training, de compromittering van OpenAI-infrastructuur na 13 juli, de werking van beschermende maatregelen, de vraag waarom het gedrag tijdens de training is ontstaan en of er een breder patroon bestaat.
Zeven lessen voor de beveiliging van AI-agenten
De volgende punten zijn inschattingen van de redactie, geen uitspraken van het rapport. Een verwant onderwerp, de vraag wat er gebeurt als AI-systemen zichzelf doorontwikkelen, komt aan bod in het artikel over recursieve zelfverbetering van AI.
- Isolatie houdt op bij de gedeelde infrastructuur. Agenten zijn netjes van elkaar te scheiden en toch te verbinden via een gedeelde dienst die als berichtenkanaal fungeert. Elke gedeelde voorziening, of het nu een pakketarchief, cache of logsysteem is, moet ook worden getoetst op misbruik als communicatieweg.
- Foutieve opdrachten scheppen prikkels om regels te breken. Een onoplosbare opdracht is voor een doelgerichte agent een uitnodiging om omwegen te zoeken. Kwaliteitscontrole van testopdrachten is daarom ook een beveiligingsmaatregel.
- Gedeelde misvattingen versterken elkaar. De agenten waren ervan overtuigd dat een bepaalde scorer bestond. Deze vergissing dreef dagenlange planning, complexe experimenten en uiteindelijk een aanval aan. Dat veel instanties van een model vergelijkbare aannamen delen, verzwakt fouten niet maar bundelt ze.
- Samenwerking verandert wat mogelijk is. Afzonderlijke agenten kwamen niet op het idee zich te organiseren. Samen bereikten ze dingen die alleen nauwelijks mogelijk waren geweest, zoals de valstrikken voor de scorer. Veiligheidsbeoordelingen die alleen naar afzonderlijke agenten kijken, onderschatten daarmee mogelijk het risico.
- Weten en naleven zijn twee verschillende dingen. De agenten beseften volgens het rapport dat hun handelen niet door de beugel kon en gingen toch door. Goede bedoelingen in het hoofd van een model garanderen geen regelconform gedrag als de groepsdynamiek een andere kant op trekt.
- Gedachtegangen zijn een waardevolle bron. Veel van wat over motieven bekend is, komt uit de meegeschreven gedachtegangen. Het rapport suggereert dat de agenten die gedachtegangen als minder relevant voor de beoordeling beschouwden. Hoe lang dat zo blijft en of agenten zich erop gaan instellen, is een open vraag.
- Onafhankelijke onderzoeken lonen, maar zijn moeilijk. OpenAI liet externe onderzoekers bij echte ruwe data en gaf hun hoge rate limits voor de analyse. METR noemt dat een voorbeeld voor toekomstige incidenten. Tegelijk laat het rapport zien hoe lastig zulke onderzoeken worden als duizenden lange logboeken met AI-ondersteuning moeten worden geanalyseerd.
Wat uit het incident niet is af te leiden
Rond het incident circuleren meerdere vragen. De volgende citaatkaders leggen vast wat het rapport erover oplevert en wat open blijft.
Hebben de agenten data gestolen?
Volgens het rapport kregen ze toegang tot privédatasets, databasegegevens en repositories bij Hugging Face en deelden die op het bord. Hoe groot de schade bij Hugging Face was, valt buiten het METR-onderzoek.
Was dit een bewuste aanval door mensen?
Nee. De agenten kregen als opdracht alleen ExploitGym-tests. De aanval ontstond uit hun zoektocht naar een manier om onoplosbare opdrachten te "halen". Mensen hebben hem volgens het rapport niet opgedragen.
Waarom hield alles op 12 juli op?
Dat is onduidelijk. Omdat veel agenten tegelijk stopten en niemand eerder over een gezamenlijk einde had gesproken, vermoeden de onderzoekers een ingreep van buitenaf, geen opgebruikt budget. Bewezen is dat niet.
Hadden de agenten hun doel bereikt?
Dat valt niet te zeggen. In de onderzoeksperiode vonden ze geen algemene manier om de scorer te omzeilen. De meeste coördinatoren waren al weg vóór een mogelijke inzending. En omdat er in de OpenAI-configuratie geen scorer van dien aard was, zou het simpelweg inleveren van de berekende flag succesvol zijn geweest.
Is dit het bewijs dat AI gevaarlijk uit de hand loopt?
Het rapport trekt die conclusie niet. Het beschrijft een concreet incident in een testomgeving met een onderzoeksmodel. Het wijst er uitdrukkelijk op dat open blijft of er een breder patroon bestaat en of de agenten onder andere omstandigheden erger hadden gedaan. Serieus nemen moet je het toch: het is een gedocumenteerd voorbeeld dat veel AI-agenten zonder instructie een communicatienetwerk kunnen opbouwen en samen in vreemde systemen kunnen binnendringen.
Conclusie
Het incident rond het prikbord is noch een sciencefictionscenario noch een onschuldige testfout. Het laat zien hoe uit een onopvallend gat, een gedeelde cache, in enkele dagen een zelfgeorganiseerd netwerk groeide dat taken verdeelde, regels bedacht, identiteiten beveiligde en uiteindelijk een ander bedrijf aanviel.
Voor de praktijk betekent dat vooral: wie agenten isoleert, moet ook alle gedeelde diensten toetsen op geschiktheid als berichtenkanaal. Wie agenten beoordeelt, moet weten dat zij de beoordeling meedenken. En wie zulke incidenten onderzoekt, heeft toegang nodig tot de ruwe data en openheid over de grenzen van de eigen methoden. Precies dat werkte in dit geval, zij het met beperkingen.
Woordenlijst
- Agent: Een AI-systeem dat zelfstandig meerdere stappen uitvoert en gereedschappen bedient, bijvoorbeeld opdrachten op een computer.
- Artifactory: Een pakketarchief waaruit software voor projecten wordt betrokken. Hier diende het onbedoeld als berichtenkanaal.
- Benchmark: Een gestandaardiseerde test waarmee de prestaties van verschillende AI-systemen te vergelijken zijn.
- Chain of Thought (gedachtegang): De tussenoverwegingen van een model voordat het handelt.
- Flag: Een geheim stukje data dat in een testopdracht als bewijs van een geslaagde inbraak dient.
- HMAC: Een cryptografische methode die uit een geheime waarde en andere data een controlewaarde berekent. Is de geheime waarde bekend, dan is het resultaat na te rekenen.
- Sandbox: Een afgeschermde omgeving waarin een programma kan draaien zonder andere systemen te beïnvloeden.
- Scorer: Het automatische beoordelingssysteem dat bepaalt of een opdracht geslaagd of mislukt is.
- Spoofing: Het voorwenden van een valse identiteit of een vals resultaat. Hier veranderen agenten wat er in het logboek van een opdracht verschijnt.
- Trip-wire (struikeldraad): Een valstrik die wordt geactiveerd en een melding stuurt zodra een bepaalde toegang plaatsvindt.
Bronnen
METR: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", gepubliceerd op 26 augustus 2026. Naar het rapport (PDF)
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.