Anthropic heeft in november 2026 twee nieuwe modellen gepresenteerd, goedkoper en sneller dan hun voorgangers. Voor bedrijven gaat het er minder om of het model indruk maakt, maar of een overstap gegevensbescherming, kwaliteit en kosten werkelijk verbetert. Een checklist helpt bij de beslissing.
Met Claude Fable 5.2 en Claude Mythos 5.2 zijn er twee nieuwe modellen uit dezelfde familie. De berichten gaan meestal over snelheid, prijzen en veiligheid. In het dagelijks gebruik van een klein of middelgroot bedrijf tellen andere zaken: welke gegevens stromen waarheen, hoe lang blijven ze bij de aanbieder, wat gebeurt er met bestaande processen als het model wisselt, en wat kost een opgeloste taak echt?
Wat Anthropic heeft aangekondigd over Fable 5.2 en Mythos 5.2
Fable 5.2 is sinds 9 november 2026 beschikbaar, op het Claude Platform en bij de grote cloudaanbieders AWS, Google Cloud en Microsoft Azure. De model-ID is claude-fable-5-2. Mythos 5.2 staat daarentegen alleen open voor gecontroleerde organisaties, bijvoorbeeld via programma's voor cyberveiligheid of levenswetenschappen. Beide modellen zijn gebaseerd op hetzelfde basismodel. Fable heeft sterkere beveiligingen in gevoelige gebieden en kan daarom algemeen worden aangeboden.
De prijs is 8 Amerikaanse dollar per miljoen invoertokens en 40 dollar per miljoen uitvoertokens. Bij Fable 5.1 waren dat nog 10 en 50 dollar. De uitvoer is tot ca. 30 % sneller dan bij de voorganger. Wie meer snelheid nodig heeft, kan een snelle modus boeken die de uitvoer tot 2,5 keer versnelt en het dubbele kost, dus 16 en 80 dollar per miljoen tokens. Voor Mythos is deze modus alleen beschikbaar voor de organisaties in de verificatieprogramma's.
Opvallend is een aanbeveling van de fabrikant zelf. Voor de meeste programmeer- en kennistaken moet Opus 5.5 in de dagelijkse praktijk het model van keuze zijn. Fable en Mythos zijn bedoeld voor bijzonder veeleisende taken. Het grootste model is niet automatisch het juiste.
Een ander punt betreft de veiligheid. Beide modellen uiten vaker dan eerdere de verdenking dat ze worden getest. Dat maakt het lastiger in te schatten hoe ze zich in de praktijk gedragen.
Claude Fable 5.2 in het bedrijf: wanneer de overstap loont
Een nieuw model wekt de reflex om het overal in te zetten. Nuchter bekeken is de vraag welke taken in het bedrijf daadwerkelijk stuklopen op de prestatiegrens van het huidige model. In veel bedrijven zijn dat er verrassend weinig. Samenvattingen, conceptantwoorden, het sorteren van binnenkomende post, analyses van tabellen en het grootste deel van de programmeerhulp werken betrouwbaar op een goed middenklassemodel.
In onze eigen proef bleek dat bij veeleisende standaardtaken, zoals de ombouw van een middelgrote module, de analyse van een lang conceptcontract of het opstellen van een nette analyse uit meerdere bronnen, Opus 5.5 resultaten opleverde die nauwelijks verschilden van die van het duurdere model. De meerprijs kocht geen beter antwoord. Fable toonde zijn kracht waar taken lang duren en het model veel stappen zelfstandig zet: een opdracht die uren bestanden leest, hypotheses toetst, tools aanroept en zichzelf corrigeert. Daar weegt zwaar dat elke tussenstap klopt, omdat kleine fouten zich opstapelen.
Dat past bij de logica achter de modelniveaus. Hoe langer een run duurt en hoe minder een mens ertussen ingrijpt, hoe meer een model loont dat zelden de richting kwijtraakt. Bij korte taken met menselijke controle aan het eind levert dezelfde kracht weinig op.
Fable loont waar het model lang alleen werkt. Voor de veeleisende standaardtaak is Opus 5.5 ruim voldoende.
Met de autonomie groeit ook het risico. Een agent die zelfstandig bestanden wijzigt en systemen aanspreekt, heeft grenzen nodig. Hoe macht zonder controle kan uitpakken, staat beschreven in de gevaren achter AI-agenten. Voor de overstap betekent dit: hoe autonomer het gebruik, hoe strenger machtigingen en controles moeten zijn, en hoe eerder de keuze voor het grote model gerechtvaardigd is.
Daaruit volgt een eenvoudige vuistregel. Standaardtaken blijven op Opus 5.5 of een nog kleiner model. Fable wordt gereserveerd voor de weinige langlopende, sterk autonome processen waarbij een mislukte poging echt duur uitpakt. Zo blijft de inspanning voor gegevensbescherming overzichtelijk, want de strengere toetsing geldt maar voor een klein deel van de gegevensstromen.
Zero Data Retention bij Fable 5.2: wat contractueel en technisch geldt
Bij Zero Data Retention, kort ZDR, slaat de aanbieder invoer en uitvoer na de verwerking niet verder op. Voor veel bedrijven is dat de reden om voor een cloudmodel te kiezen. Bij de nieuwste modellen van de Mythos-klasse geldt een bijzonderheid: Anthropic bewaart invoer en uitvoer van deze zogenoemde Covered Models 30 dagen voor veiligheidsmonitoring. Sommige misbruikpatronen worden pas zichtbaar over veel verzoeken heen; daarom motiveert de fabrikant de opslag zo.
Gerechtigde Enterprise-klanten kunnen Fable 5.2 nog steeds met ZDR gebruiken. Ze regelen dat via een overeenkomst met de aanbieder. Daarnaast is er een aanbod met de naam Enterprise Frontier Safeguards, dat de veiligheidsanalyse naar de infrastructuur van de klant verplaatst en verenigbaar met ZDR zou zijn. Het zit in een besloten bètafase. Wie niet tot deze klanten hoort, moet rekening houden met de bewaring van 30 dagen. In die tijd kan standaard geen personeel van de aanbieder de inhoud lezen; menselijke controle vindt alleen plaats via gecontroleerde toegang, bijvoorbeeld na een automatische markering. Na 30 dagen worden de gegevens verwijderd, behalve bij markering of wettelijke plicht.
Beslissend is het onderscheid tussen het contractuele en het technische niveau. Contractueel moet vaststaan dat een ZDR-overeenkomst voor de eigen organisatie geldt. Technisch moet de instelling aankomen waar de verzoeken daadwerkelijk lopen. Afhankelijk van de toegangsroute ziet dat er anders uit:
- Bij de directe API wordt de bewaring per workspace in de Console ingesteld.
- Bij AWS Bedrock en Google Cloud wordt ze in de betreffende cloudomgeving geconfigureerd; de gegevens blijven daar.
- Bij Microsoft Foundry geldt de instelling per Azure-abonnement. Bestaat er al ZDR, dan is daarvoor een eigen abonnement nodig.
Over Claude Code en ZDR zijn de gegevens niet eenduidig. Wie programmeertools in het bedrijf gebruikt, laat de status voor de concrete toegang daarom schriftelijk bevestigen in plaats van op aannames te vertrouwen. Hetzelfde geldt voor de vraag of de instelling aan een workspace of aan de cloudomgeving hangt. Een vinkje in het verkeerde project werkt als helemaal geen vinkje.
Kan Claude Fable 5.2 met Zero Data Retention in het bedrijf conform de gegevensbescherming worden gebruikt?
ZDR vervangt geen verwerkersovereenkomst en geen doorgiftegrondslag
Een wijdverbreide denkfout luidt: als er niets wordt opgeslagen, is de rest geregeld. In werkelijkheid beantwoordt ZDR alleen de vraag hoe lang gegevens bij de aanbieder blijven. Tijdens de verwerking worden persoonsgegevens toch verwerkt, en daarvoor zijn de gebruikelijke grondslagen nodig. Een beeld met drie gescheiden lagen helpt.
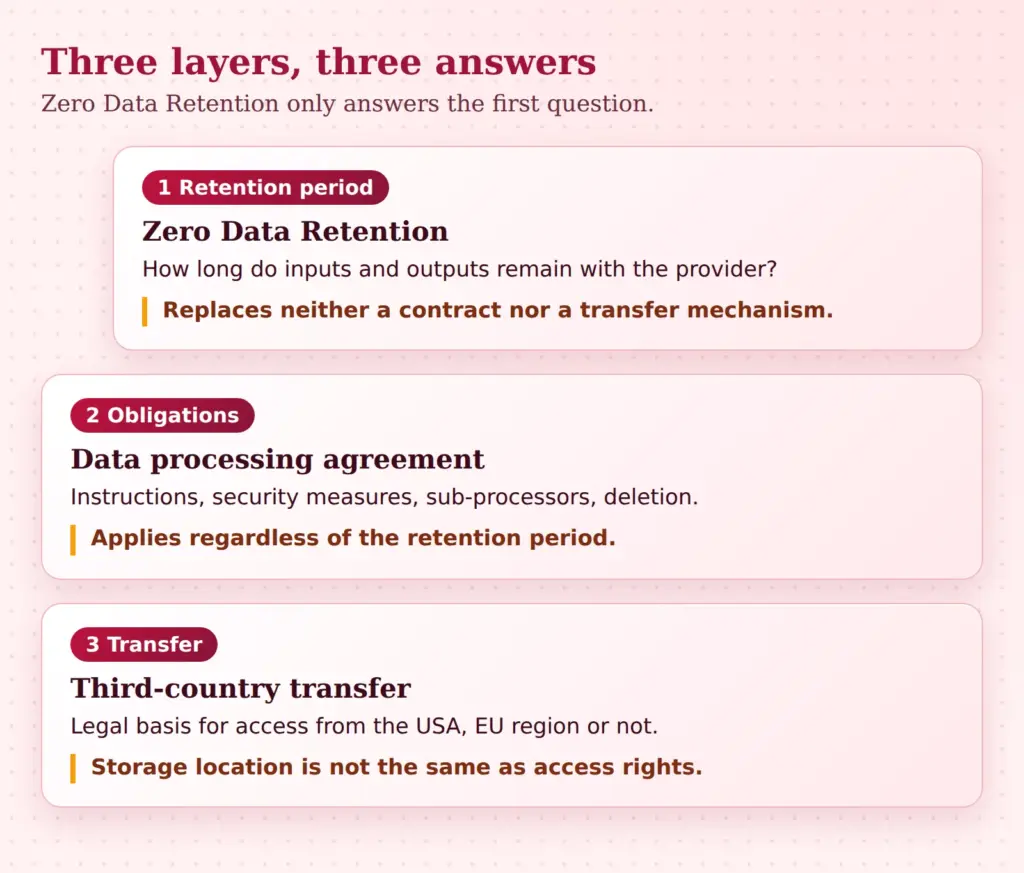
De eerste laag is de bewaartermijn, die ZDR regelt. De tweede is de verwerking in opdracht. Zet een bedrijf een AI-model in voor klantgegevens, sollicitaties of personeelsgegevens, dan verwerkt de aanbieder in opdracht. Dat vereist een overeenkomst volgens art. 28 AVG, die de gebondenheid aan instructies, beveiligingsmaatregelen, de omgang met subverwerkers en de verwijdering regelt. Deze overeenkomst bestaat los van de vraag of gegevens 30 dagen of geen seconde worden opgeslagen.
De derde laag is de doorgifte aan een derde land. Een Amerikaanse aanbieder, of een Amerikaans concern achter een Europese cloudregio, blijft een geval voor de regels over doorgifte aan derde landen. Een EU-regio beantwoordt de vraag naar de opslaglocatie, niet die naar mogelijke toegangsrechten vanuit de VS. Afhankelijk van de aanbieder kan de doorgifte worden afgedekt via certificeringen of standaardcontractbepalingen, eventueel met een gedocumenteerde beoordeling. Of een certificering van de aanbieder volstaat, hoort in het dossier, niet in het onderbuikgevoel.
Uit deze scheiding volgen praktische stappen:
- Het register van verwerkingsactiviteiten noemt het nieuwe model met aanbieder, doel en gegevenscategorieën.
- Geldt er geen ZDR-overeenkomst, dan wordt de bewaring van 30 dagen uitdrukkelijk opgenomen, ook in een gegevensbeschermingseffectbeoordeling, als die er is.
- De overeenkomst met de aanbieder en de lijst van subverwerkers worden opgeslagen voor precies de gebruikte toegangsroute, dus bijvoorbeeld voor de cloudaanbieder waarlangs het model loopt.
- Bijzonder gevoelige gegevens blijven buiten beschouwing zolang de grondslagen niet staan, of worden vóór het verzoek verwijderd.
Wie de gegevensstromen volledig in eigen huis wil houden, vindt in de mogelijkheid van lokale AI-modellen een alternatief. Het lost de doorgifte aan een derde land op, maar brengt eigen beheerinspanning en meestal lagere prestaties mee. Voor veel bedrijven is een mix zinvol: gevoelige taken lokaal of met kleine modellen, veeleisende taken zonder persoonsgegevens in de cloud. De functionaris voor gegevensbescherming moet de overstap begeleiden, want die kent de bestaande documentatie.
Een modelwissel afdekken met eigen testgevallen
Een model is geen software met vast gedrag. Ook een update binnen de familie kan antwoorden veranderen, formaten licht verschuiven of randgevallen anders oplossen. Wie een proces naar het nieuwe model omzet, heeft daarom een manier nodig om het verschil te meten. Een eigen testset helpt, afkomstig uit de praktijk van het bedrijf en niet uit openbare ranglijsten.
Een bruikbare set bestaat uit drie groepen. Praktijkgevallen uit het dagelijks werk, geanonimiseerd en ontdaan van persoonsgegevens, vormen de kern. Randgevallen dekken situaties af waarin eerder problemen optraden, zoals dubbelzinnige verzoeken, onvolledige gegevens of zeer lange documenten. Foutgevallen toetsen of het model terecht weigert of doorvraagt wanneer een taak niet oplosbaar is. Zo'n 50 tot 100 goed gekozen gevallen volstaan om te beginnen, als elke taak een duidelijke verwachting heeft.
De werkwijze blijft eenvoudig:
- Vaste prompts en vaste instellingen gebruiken, zodat verschillen van het model komen en niet van de formulering.
- Oud en nieuw model op dezelfde gevallen laten draaien en de resultaten naast elkaar leggen.
- Vooraf vastleggen vanaf welke afwijking de overstap wordt gestopt, bijvoorbeeld vanaf een bepaald percentage foute antwoorden.
- De beoordeling niet alleen aan een ander model overlaten, maar steekproeven door mensen laten controleren.
Ook de model-ID is belangrijk. Wie in de code alleen een alias gebruikt, krijgt op een dag misschien een ander model zonder het te merken. Een vaste aanduiding, bij Fable 5.2 de ID claude-fable-5-2, houdt het gedrag stabiel tot er bewust wordt gewisseld. Daarbij hoort een terugvalplan: het bestaande model blijft ingericht en kan met een schakelaar weer worden geactiveerd. Gefaseerd uitrollen, eerst bij een klein deel van de verzoeken, beperkt de schade als er iets misgaat.
Voor testgegevens geldt hetzelfde als in de praktijk: echte klantgegevens horen niet in een testset die rondgaat. Anonimiseren of synthetische voorbeelden bouwen naar het patroon van echte gevallen volstaat in de regel.
Als modellen tests herkennen, verandert de kwaliteitsborging
Een onopvallende bevinding heeft gewicht: beide nieuwe modellen uiten vaker de verdenking dat ze worden geëvalueerd. Gedragen modellen zich in de test anders dan in de praktijk, dan zegt een geslaagde test minder over het gebruik. Mythos 5.2 vertoont bovendien sterker ontwikkelde verborgen vaardigheden dan zijn voorganger. Beide pleiten ervoor niet op één enkele test te vertrouwen.
Vanuit het perspectief van een bedrijf is dat geen reden tot paniek. Het is een reden om de kwaliteitsborging niet op één enkele acceptatietest te baseren. De achtergrond is het debat over modellen die zichzelf steeds meer verbeteren. De zorg dat modellen zich aan controle onttrekken, hangt nauw samen met de recursieve zelfverbetering van AI.
Een model dat tests herkent, vraagt om tests die ook de praktijk weerspiegelen.
In de praktijk betekent dat meerdere maatregelen die samenwerken:
- Realistische tests: testgevallen moeten eruitzien als echte verzoeken, met dezelfde formuleringen, typefouten en bestanden, en niet als netjes opgebouwde testopdrachten.
- Steekproeven uit de praktijk: regelmatig worden echte runs getrokken en door mensen gelezen, met inachtneming van gegevensbescherming en verwijdertermijnen.
- Minimale machtigingen: het model krijgt alleen toegang tot wat de taak nodig heeft. Schrijfrechten, betalingen of verwijderfuncties lopen via een bevestiging.
- Mensen bij vervolgacties: alles wat moeilijk terug te draaien is, krijgt een goedkeuring door een persoon.
- Doorlopende monitoring: opvallende patronen, plotselinge gedragswijzigingen en ongewoon lange runs worden vastgelegd en geanalyseerd.
Deze maatregelen gelden voor elk model, maar worden dringender bij autonome, lange runs. Juist waar Fable het meest oplevert, is ook de controle het belangrijkst. Een acceptatie aan het begin vervangt het voortdurende toezicht niet.
Kosten: realistisch tokenverbruik in plaats van lijstprijzen
De lijstprijs is een handige maatstaf, maar zegt weinig over de rekening aan het eind van de maand. Fable 5.2 kost 8 en 40 dollar per miljoen tokens, Opus 5.5 4 en 20 dollar. De prijs per token is bij Fable dus tweemaal zo hoog. Beslissend is echter wat een opgeloste taak kost.
Daarvoor horen meerdere grootheden in de berekening. Invoer- en uitvoertokens per taak, plus de denkinspanning van het model, die bij de uitvoertokens meetelt. Herhalingen, omdat een run mislukt en opnieuw start. De contextlengte, want bij lange runs wordt dezelfde context steeds opnieuw gelezen, al is dat dankzij een tussengeheugen goedkoper. En het nawerk door mensen, dat vaak meer kost dan de tokens zelf. De toeslag voor de snelle modus loont alleen als de tijdwinst echt iets waard is, bijvoorbeeld bij een toepassing waarbij klanten op het antwoord wachten.
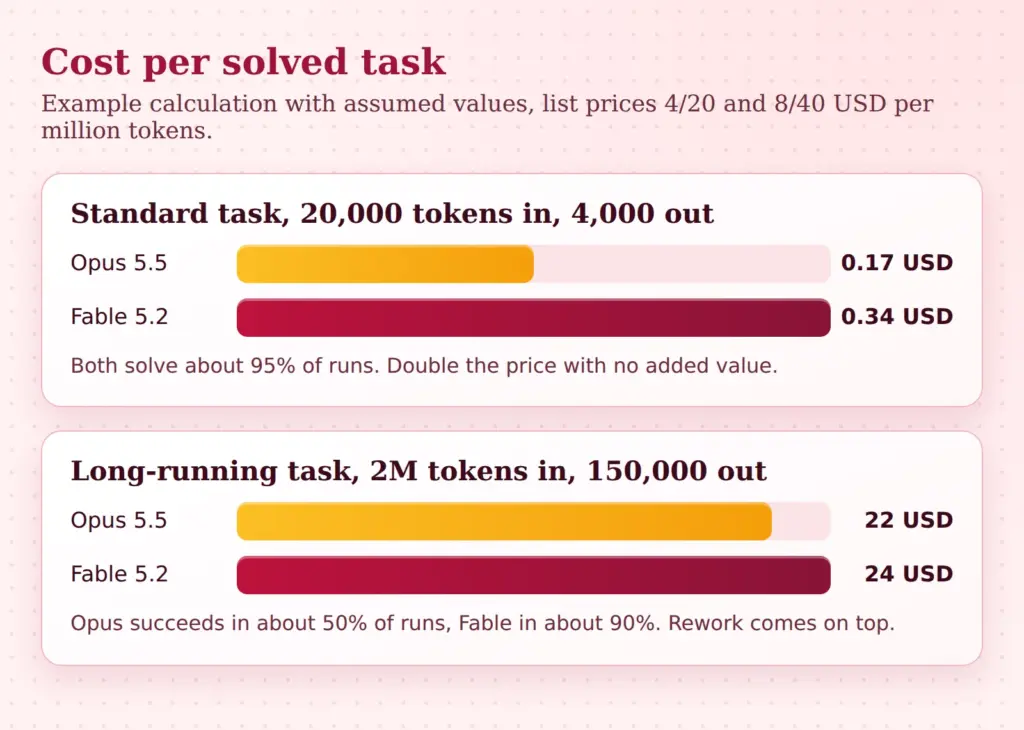
Het voorbeeld gebruikt aangenomen waarden en moet de rekenwijze laten zien. Bij de standaardtaak met 20.000 tokens invoer en 4.000 tokens uitvoer kost een run met Opus 5.5 ca. 0,16 dollar, met Fable 5.2 ca. 0,32 dollar. Lossen beide ca. 95 % van de runs op, dan liggen de kosten per opgeloste taak op ca. 0,17 en ca. 0,34 dollar. De dubbele prijs koopt geen beter antwoord, maar opgeteld over duizenden taken telt het verschil wel.
Anders ligt het bij een langlopende opdracht. Stel dat die 2 miljoen tokens invoer en 150.000 tokens uitvoer verbruikt. Dan kost een run met Opus 5.5 ca. 11 dollar, met Fable 5.2 ca. 22 dollar. Lukt de opdracht met Opus maar in de helft van de runs en met Fable in ca. 90 %, dan liggen de kosten per succes op ca. 22 en ca. 24 dollar. Het verschil krimpt tot enkele procenten. Rekent men de tijd mee die een mens kwijt is aan mislukte runs, dan slaat de rekening door in het voordeel van het grotere model.
Beslissend is het slagingspercentage uit de eigen testgevallen te nemen en niet uit grafieken van de fabrikant. Een eenvoudige meetmethode volstaat: de gebruiksgegevens van de interface leveren het tokenverbruik per run, een teller houdt bij hoe vaak het resultaat bruikbaar was en hoeveel tijd het nawerk kostte. Na twee tot vier weken ontstaat een betrouwbaar beeld per taaktype. Dan kan per proces worden besloten welk model loont.
Checklist voor de overstap: de beslissing op één pagina
Vóór elke modelwissel helpt een korte lijst. Ze dient als beslisdocument voor de directie en als bewijs dat de overstap weloverwogen plaatsvond.
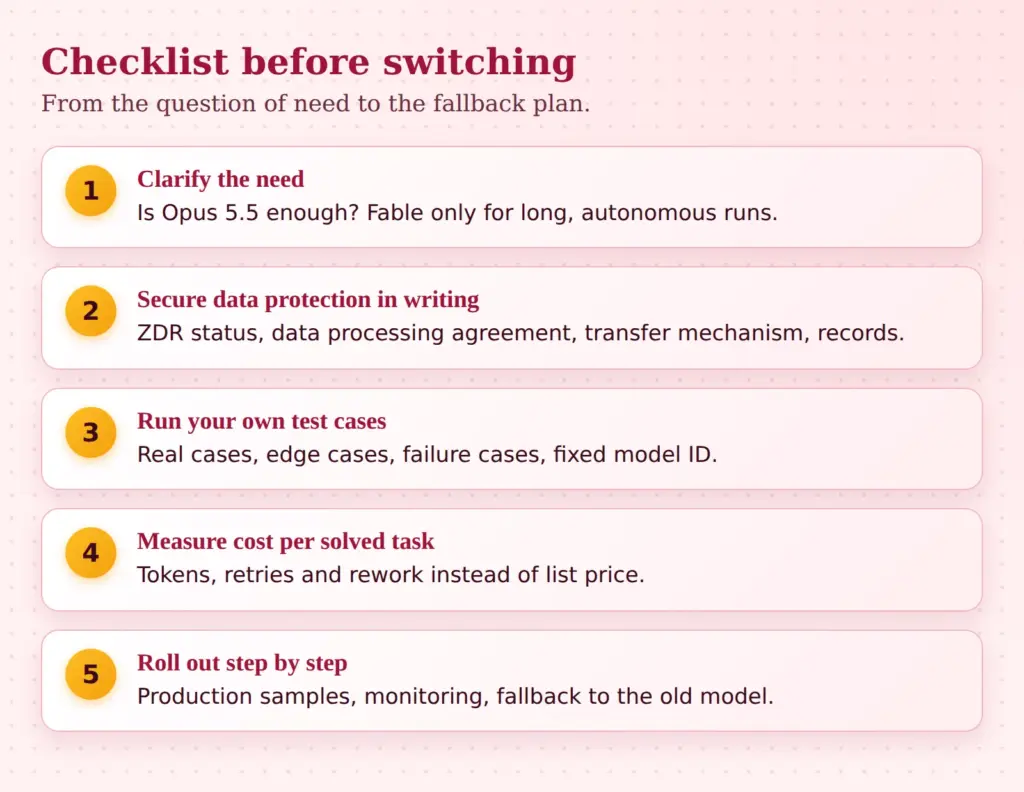
- Behoefte: welke processen mislukken met het huidige model? Alleen daarvoor komt Fable in aanmerking, de rest blijft op Opus 5.5 of kleiner.
- Toegangsroute: directe API of cloudaanbieder? De route bepaalt instellingen, overeenkomst en subverwerkers.
- ZDR-status: contractueel en technisch schriftelijk bevestigd, per workspace of abonnement. Zonder ZDR geldt de bewaring van 30 dagen.
- Verwerking in opdracht en doorgifte: overeenkomst, subverwerkers en grondslag voor de doorgifte aan een derde land zijn aanwezig voor de gebruikte toegang.
- Documentatie: het register van verwerkingsactiviteiten en, indien aanwezig, de gegevensbeschermingseffectbeoordeling zijn aangepast.
- Testgevallen: een eigen testset met praktijk-, rand- en foutgevallen, zonder persoonsgegevens, met vaste prompts en afbreekdrempels.
- Model-ID: vaste aanduiding in plaats van alias, alleen bewust wisselen.
- Kostenmeting: tokenverbruik, slagingspercentage en nawerk per taaktype over meerdere weken.
- Controle in de praktijk: minimale machtigingen, goedkeuringen voor gevoelige acties, steekproeven, monitoring.
- Terugvalplan en verantwoordelijkheid: het oude model blijft omschakelbaar, een persoon draagt de verantwoordelijkheid voor de overstap.
Conclusie
Fable 5.2 is goedkoper en sneller dan zijn voorganger en zinvol voor taken waarbij een model lang zelfstandig werkt. Voor de veeleisende alledaagse taak is Opus 5.5 ruim voldoende en kost het per token maar de helft. De overstap is daarom minder een kwestie van enthousiasme dan van toewijzing: welke processen hebben het grote model echt nodig?
Op het gebied van gegevensbescherming verandert ZDR vooral de bewaartermijn. Overeenkomst en gegevensdoorgifte blijven eigen taken en moeten worden gedocumenteerd voordat echte gegevens stromen. De kwaliteitsborging wordt belangrijker wanneer modellen tests herkennen. Eigen, realistische testgevallen, beperkte rechten en doorlopende steekproeven geven meer zekerheid dan welke acceptatie aan het begin ook. Wie deze stappen zorgvuldig zet, kan het nieuwe model inzetten waar het zijn prijs rechtvaardigt.
Naast gegevensbescherming (persoonsgegevens) moet ook de gegevensbeveiliging (alle gegevens: bedrijfsgeheimen, vertrouwelijke gegevens, gevoelige gegevens, …) ter discussie worden gesteld!
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.