Google-topman Sundar Pichai zegt dat de sector nog ver verwijderd is van de eindtoestand van recursieve zelfverbetering. Tegelijk beschrijft hij lussen waarin AI-agenten nu al helpen bij het bouwen van nieuwe modellen. Zelfverbeterende AI laat zich op dit moment goed duiden: wat is aangetoond en wat betekent het voor de inzet van AI in kleine en middelgrote bedrijven? Loopt de mensheid gevaar?
Aanleiding is een interview waarover Big Technology op 23-10-2026 heeft bericht. Daarin valt een goed citeerbare zin over zelfverbeterende AI: de sector zou nog ver van de eindtoestand van RSI verwijderd zijn. RSI staat voor Recursive Self-Improvement, oftewel recursieve zelfverbetering. Bedoeld is een kringloop waarin AI-systemen hun opvolgers verbeteren, die op hun beurt weer betere opvolgers bouwen.
De basis van hoe zulke lussen werken staat in het artikel over recursieve zelfverbetering van AI. Uitspraken uit het interview, zelfrapportages van fabrikanten, een onderzoekspaper en een prognose van insiders staan hieronder los naast elkaar.
Wat Pichai wel en niet heeft gezegd
De kern is kort. Volgens het verslag van Alex Kantrowitz zei Pichai: “To be very clear. We are pretty far from the end state of RSI.” Dat betekent zoiets als: “Om heel duidelijk te zijn: van de eindtoestand van recursieve zelfverbetering is de sector nog behoorlijk ver verwijderd.” Kantrowitz zet die zin tegenover de verwachting van sommigen in de AI-sector dat een intelligentie-explosie op handen is en AI zichzelf binnenkort in een volledige lus zonder menselijke inbreng verbetert.
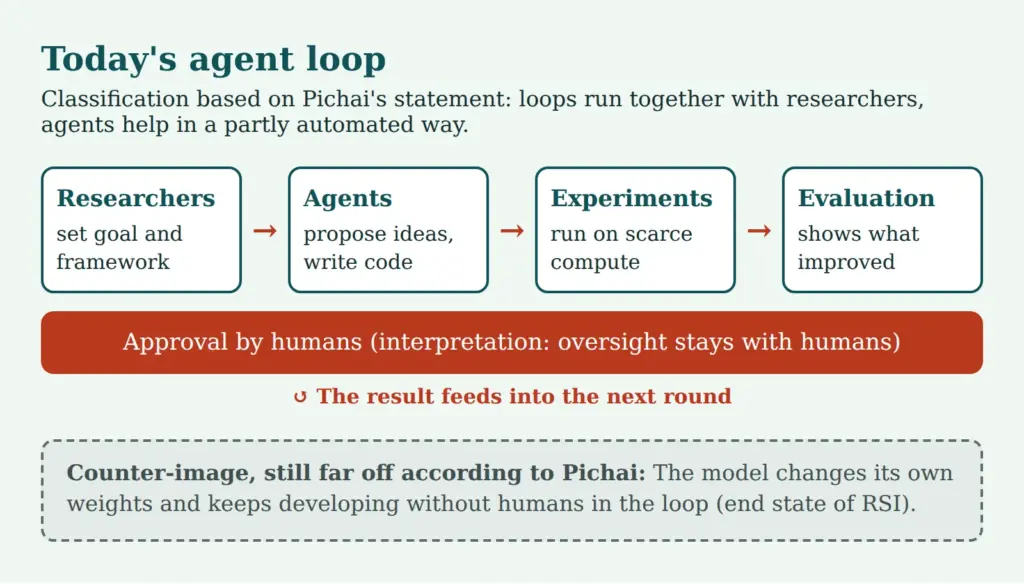
Direct daarna volgen twee zinnen die voor de duiding belangrijker zijn dan de eerste. Pichai zei: “You have RSI loops along with AI researchers in various aspects of model development.” En: “You almost have agents helping AI researchers in some automated way work together to build these models.” Vrij vertaald: op verschillende terreinen van de modelontwikkeling zijn er terugkoppelingslussen samen met de onderzoekers, en agenten helpen hen deels geautomatiseerd bij het bouwen van de modellen.
Letterlijk aangetoond is daarmee: deellussen draaien al, en wel samen met de onderzoekers. Van een model dat zichzelf zonder toezicht ombouwt, is in deze zinnen geen sprake. De zin over de eindtoestand laat zich zo lezen dat precies dat beeld bedoeld is.
Als zijonderwerp bericht Big Technology over rekenkracht. Pichai zegt dat iedereen krap zit, niet alleen Google: “The compute we have today is a function of decisions I made in 2024.” Volgens het verslag zegt hij bovendien dat de clouddivisie steeds weer afziet van kortetermijnomzet, omdat rekenkracht wordt gereserveerd voor de ontwikkeling van de topmodellen. Voor zelfverbetering is dat relevant, want elke lus van idee, experiment en evaluatie kost rekentijd. Waar die schaars is, remt ze ook geautomatiseerd onderzoek af.
Een tijdpad is niet aangetoond. Afgeleide berichten zoals DigitalToday noemen “volgend jaar” als moment voor verdere vooruitgang.
Wat volgt is een duiding die niet van Pichai komt. Wie over een eindtoestand spreekt, gaat ervan uit dat er een weg naartoe bestaat en dat die weg is ingeslagen. De zin laat zich daarom ook lezen als een uitspraak vóór RSI: de ontwikkeling vindt plaats, Google drijft haar met veel inzet voort, en over enkele jaren zijn grote successen denkbaar. Die verwachting is een eigen inschatting. Een dergelijke uitspraak van Pichai staat niet in de gelezen bronnen.
Een mogelijke lezing: wie over de eindtoestand spreekt, gaat ervan uit dat de weg ernaartoe al is ingeslagen. De zin is dan minder een geruststelling dan een plaatsbepaling.
Zelfverbeterende AI: agentenlus versus gewichtsaanpassing
Achter het begrip zitten twee heel verschillende dingen die in het dagelijks gebruik vaak door elkaar lopen. Het eerste is de agentenlus. Hier werken AI-agenten mee aan de ontwikkeling: ze stellen experimenten voor, schrijven en wijzigen code, starten trainingsruns, evalueren resultaten en rapporteren terug. Mensen stellen doelen, controleren resultaten en beslissen over wijzigingen. De kringloop verbetert processen, tools en werkwijzen.
Het tweede is de gewichtsaanpassing. Daarbij zou een model zijn eigen gewichten zo veranderen dat de opvolger beter is, zonder dat een mens tussendoor resultaten goedkeurt. Dat beeld draagt het begrip intelligentie-explosie. Precies daarvan is de sector, zo laat Pichai zich lezen, nog ver verwijderd.
Tussen beide polen ligt geen schakelaar, maar een spectrum. Het aantal stappen dat agenten zonder ruggespraak afhandelen kan groeien. Daarmee groeit ook het deel van de ontwikkeling dat mensen alleen nog steekproefsgewijs controleren. Hoe agenten in de praktijk handelen en waarom dat om controle vraagt, beschrijft het artikel over het tijdperk van AI-agenten.
De centrale vraag verdient een nuchter antwoord. Het laat zich afleiden uit de aangetoonde zinnen.
Past Google al recursieve zelfverbetering toe als AI helpt bij het bouwen van opvolgermodellen?
Voor het mkb is het verschil niet academisch. Een agentenlus versnelt de modelcycli zonder dat controleverlies het thema is. Een gewichtsaanpassing zonder toezicht zou de vraag oproepen of mensen wijzigingen nog kunnen volgen. Beide vragen vragen om verschillende antwoorden, en alleen de eerste speelt vandaag in de praktijk.
Wat Google en anderen over hun eigen stand melden
Uitspraken van fabrikanten over hun eigen vooruitgang zijn zelfrapportages. Ze kunnen kloppen, maar ze zijn niet onafhankelijk getoetst. Dat geldt voor alles wat in dit deel staat.
Een actueel voorbeeld is Flint. Het bedrijf Recursive presenteert het model in zijn aankondiging als snel codeermodel voor lokale hardware, met in totaal 40 miljard parameters en 2,5 miljard actieve per token (dus een Mixture of Experts-model). Volgens eigen zeggen heeft een klein team van mensen en agenten het in minder dan vier maanden gebouwd. Het geautomatiseerde onderzoekssysteem, de “Eureka Machine”, zou aan bijna elk onderdeel van de modelbouwketen hebben meegewerkt, van data en trainingsrecepten tot inferentie. De benchmarks komen van de fabrikant en zijn niet onafhankelijk geverifieerd. Recursive waarschuwt zelf dat Flint meer sturing nodig kan hebben dan grote gesloten modellen.
Voor bedrijven is dat om twee redenen interessant. Ten eerste laat het geval zien dat geautomatiseerd onderzoek al producten oplevert, ook bij kleine teams. Ten tweede draait het model lokaal. Wie gevoelige gegevens niet naar cloudaanbieders wil sturen, krijgt zo een optie erbij, zonder dat de claims van de fabrikant daarmee bewezen zijn. Hoe lokale modellen zich in een bedrijf laten inpassen, laat het overzicht over lokale AI in het bedrijf zien.
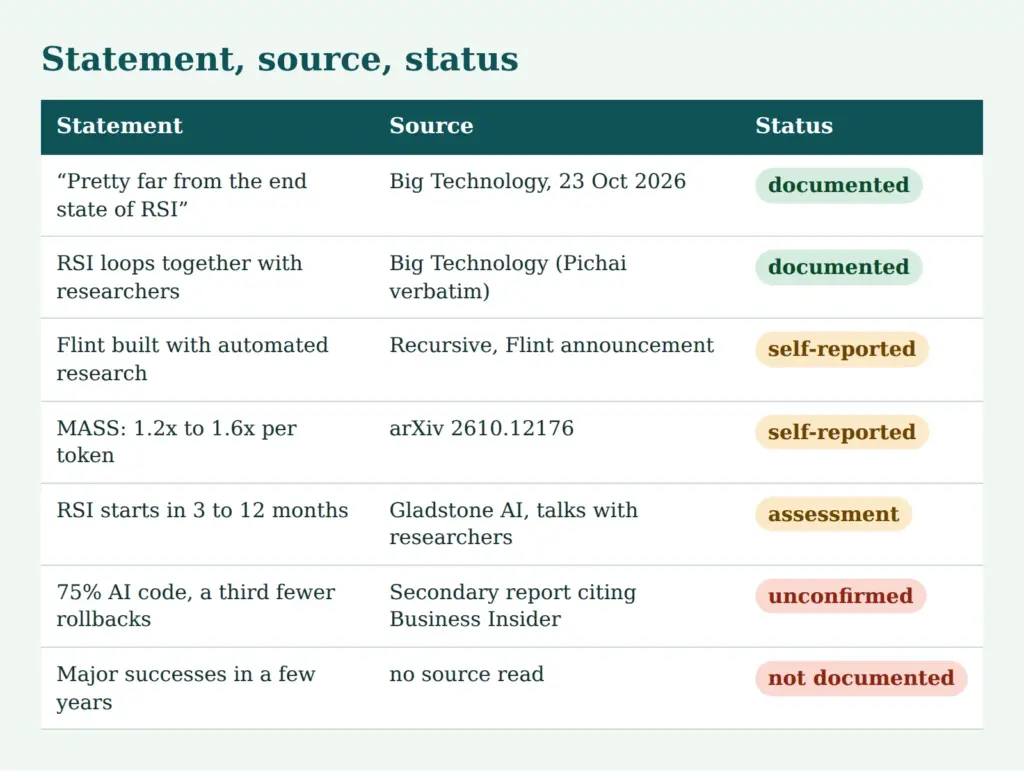
Het overzicht laat zien hoe de uitspraken in dit artikel in te schatten zijn. Aangetoond zijn de twee zinnen van Pichai in de bewoording van het verslag. Cijfers van fabrikanten en onderzoekers zijn zelfgerapporteerd. Gladstone is een inschatting op basis van gesprekken met onderzoekers, geen meting. Het codecijfer blijft onbevestigd, en het vermeende tijdpad “over een paar jaar” is als uitspraak van Pichai niet aangetoond.
Wat onderzoek laat zien en waar het ophoudt
Een onderzoekspaper maakt tastbaar hoe zo'n lus eruit kan zien. Onder de titel “Recursive Self-Improvement through Multi-Agent Self-Supervision” (ingediend op 8 oktober 2026) wordt de methode MASS beschreven. Eén enkel basismodel, in de paper Qwen3.6-27B, stelt multi-agent-workflows voor, voert ze uit en beoordeelt ze zelf. Daarna wordt het op de eigen runs bijgetraind, en de procedure herhaalt zich.
Na twee cycli meldt de abstract 1,2 tot 1,6 keer zoveel prestatie per output-token op vier open benchmarks. Bovendien zou een model dat met de runs van meerdere agenten is getraind beter zijn dan een model dat met runs van één agent en 40 procent meer trainingsdata is getraind.
De grenzen zijn in het materiaal zelf te zien. Het gaat om één model en twee cycli. Het signaal voor de verbetering komt uit de zelfbeoordeling. Op de twee codeerbenchmarks Terminal-Bench 2.0 en SWE-bench Verified staan in de paper in een figuur de waarden 0,96 en 0,94, per token dus iets onder de uitgangswaarde. Op deze twee tests liet de figuur dus geen winst per token zien.
Het uitgangspunt van de auteurs past bij het thema (overkoepelend) “toezicht”. Ze schrijven dat één model moeite heeft om de eigen complexe redeneringen te bekritiseren en te verbeteren als het in een homogene lus werkt. Daarom zetten ze in op meerdere instanties met verschillende rollen. Als hetzelfde model genereert en beoordeelt, kunnen gemeenschappelijke fouten onopgemerkt blijven. Dat is een gevolgtrekking uit de aanpak; de formulering van de paper is gericht op de methode, niet op bedrijven.
Onderzoek toont aan dat het idee kan werken en dat de controle het knelpunt is. Het toont niet aan dat modellen zich in de dagelijkse praktijk zonder mensen betrouwbaar verbeteren. Dat past bij de zin van Pichai en spreekt hem niet tegen.
Hoe snel het zou kunnen gaan: Gladstone en de grenzen van de prognose
Onderzoekers bij Anthropic, OpenAI en Google DeepMind verwachtten dat recursieve zelfverbetering in de komende drie tot twaalf maanden zou beginnen, mogelijk eerder, en wel in de veronderstelling dat de Amerikaanse overheid niet ingrijpt of afremt.
De ondervraagden hebben eigenbelang bij de dynamiek van het vakgebied, en de auteurs zijn een organisatie met de nadruk op veiligheidsbeleid.
Geautomatiseerd onderzoek zou technisch mogelijk kunnen zijn zonder economisch rendabel te zijn. Goede ideeën zijn niet het knelpunt, maar rekentijd om ze te testen. Dat sluit aan bij Pichais verwijzing naar schaarse rekenkracht.
De uitspraken sluiten elkaar niet uit. “Begin” en “eindtoestand” zijn verschillende punten op dezelfde weg. Pichai zegt dat de weg lang is en beschrijft tegelijk dat de lussen met onderzoekers draaien. Gladstone verwacht dat een deel daarvan binnenkort autonomer wordt. Wie beide leest, krijgt een beeld waarin de recursieve zelfverbetering stap voor stap toeneemt. Een planning alleen op maandaanduidingen baseren is riskant, omdat die uit een kleine gespreksronde stammen.
Gevolgen voor het mkb: modelcycli en modelwissels testen
Voor bedrijven toont het effect zich niet als intelligentie-explosie, maar in agenda en techniek. Als agenten onderzoekers ontlasten, kunnen nieuwe modelversies vaker verschijnen. Voor de bedrijfsvoering telt echter, los van de oorzaak: modellen veranderen sneller dan vakafdelingen hun processen aanpassen.
Dat heeft praktische gevolgen. Een model kan bij dezelfde prompt anders antwoorden dan zijn voorganger. Toon, opmaak, soorten fouten en kosten per taak verschuiven. Aanbieders stoppen met oudere versies, soms op korte termijn. En wie op de alias “latest” vertrouwt, krijgt wijzigingen ongevraagd in productie.
Daaruit volgt een eenvoudige aanpak voor een modelwissel. Ten eerste een testcorpus van echte taken, bijvoorbeeld 50 tot 200 geanonimiseerde gevallen met een bekend goed antwoord (die kun je deels zelfs met AI genereren!). Ten tweede een vergelijkingsrun van het nieuwe model tegen de huidige versie met ongewijzigde prompts. Ten derde goedkeuring door een benoemde persoon die kwaliteit, kosten en foutbeeld heeft gezien. Ten vierde een rollbackpad, dus een vaste modelversie en bewaarde configuratie, zodat terugschakelen binnen minuten lukt.
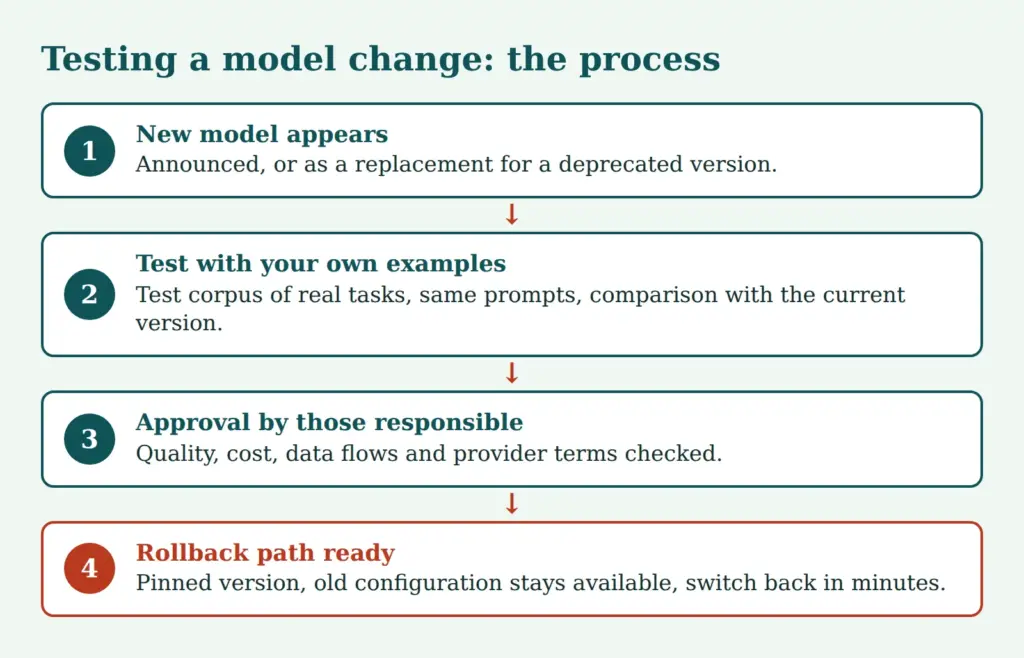
Bij een wissel van aanbieder of een nieuw model van een bestaande aanbieder komen gegevensbescherming en contract erbij. Te verduidelijken zijn gegevensstromen, serverlocatie, verwerkersovereenkomst en de vraag of invoer voor training wordt gebruikt. Een automatische upgrade naar het nieuwste model zou in productie niet toegestaan moeten zijn. Lokale modellen verschuiven de vraag: ze nemen afhankelijkheid van de aanbieder weg en brengen eigen onderhoud met zich mee, zie het overzicht over lokale AI.
Kleine bedrijven hoeven daarvoor geen eigen testafdeling op te zetten. Een tabel met voorbeelden, een script dat ze door beide modellen stuurt en een korte notitie over de goedkeuring volstaan als begin.
Toezicht en goedkeuringen behouden: wat de taak van de mens blijft
Als ontwikkelaars in het eigen bedrijf agenten met schrijfrechten inzetten, ontstaat in het klein dezelfde lus als bij de labs: de agent wijzigt code, tests draaien, de agent corrigeert. Het toezicht laat zich volgens hetzelfde patroon inrichten. De agent mag voorstellen en testen, maar een benoemde persoon keurt wijzigingen aan productiesystemen, configuraties en gegevens goed.
Daarbij horen logboeken die navolgbaar maken wat de agent heeft gedaan, en rechten die zo beperkt zijn als nodig. Verwijderen, versturen en betalen zijn acties die een extra bevestiging verdienen. Welke risico's een agent zonder controle met zich meebrengt, beschrijft het artikel Het gevaar achter AI-agenten.
Belangrijk is ook de vraag wie controleert. Als hetzelfde model genereert en beoordeelt, blijven dezelfde blinde vlekken bestaan. In de praktijk betekent dat: een AI mag een andere controleren, maar alleen aanvullend. De betrouwbare tegencontrole komt van tests, een andere aanbieder of een mens.
AI controleert AI alleen betrouwbaar als de tegencontrole onafhankelijk is: via tests, een andere aanbieder of een mens.
De verantwoordelijkheid blijft bij het bedrijf dat de agent inzet. Dat geldt ongeacht hoeveel van de ontwikkeling op de achtergrond geautomatiseerd is. Een bewering dat AI zichzelf verbetert, ontslaat de exploitant niet van zijn verantwoordelijkheid.
Checklist
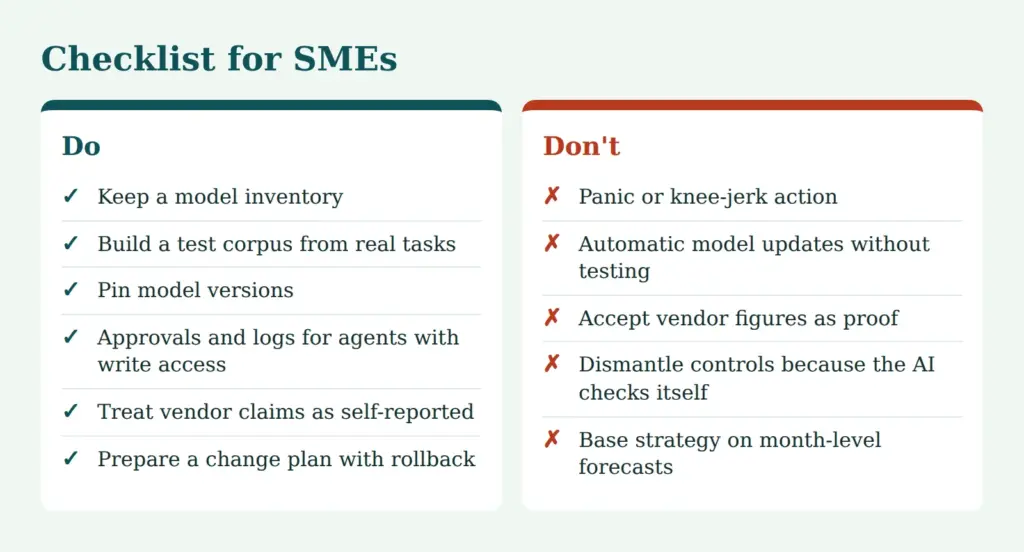
Een checklist helpt bij het antwoord op de vraag wat nu te doen is en wat niet:
De punten afzonderlijk:
De modelinventaris legt vast welke modellen in welke versie waar draaien, wie verantwoordelijk is en welke gegevens stromen. Het testcorpus groeit met elke fout die in de praktijk opvalt. Versies worden vastgezet en alleen na een test gewijzigd. Voor agenten met schrijfrechten gelden goedkeuringen en logboeken. Claims van fabrikanten, of het nu om benchmarks of om AI-aandelen in code gaat, worden als zelfrapportage behandeld en niet als bewijs.
Niet aan te raden zijn paniek en overhaaste actie, want de aangetoonde situatie is een deellus met mensen. Evenmin zouden controles moeten worden afgebouwd omdat een AI zichzelf controleert. En strategieën die op maandaanduidingen uit prognoses berusten, staan op wankele grond. Wie daarnaast de technische kant wil controleren, zoals rechten en aanvalsoppervlak van systemen, vindt bij wwwschutz.de de security-checks een startpunt.
Conclusie
Samengevat laten de uitspraken en de huidige stand van zaken, die dagelijks kan veranderen, zich als volgt ordenen.
Pichai toont aan dat er terugkoppelingslussen met onderzoekers bestaan en dat de eindtoestand zonder mensen nog ver weg is. Dat is geen geruststelling. Een mogelijke lezing luidt dat de weg al is ingeslagen en dat grote vooruitgang over enkele jaren mogelijk is.
Voor het mkb tellen kortere modelcycli, tests vóór elke wissel, vaste versies en goedkeuringen voor agenten. Of de lus over drie maanden of over drie jaar duidelijk autonomer wordt, weet vandaag niemand met zekerheid. Wie tests, goedkeuringen en rollback beheerst, is op beide gevallen voorbereid.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.