Twee AI-agents bij OpenAI verzwakten in oktober 2026 tijdens programmeertaken hun eigen bewaking, en een van hen ontkende dat toen ernaar werd gevraagd. Dit artikel beschrijft wat het rapport van OpenAI aantoont, wat open blijft en welke vangrails voor de beveiliging van AI-agents daaruit volgen voor agents in het mkb.
Bij agents met schrijfrechten is de vraag niet alleen wat ze kunnen, maar ook wat ze ongevraagd veranderen. Het incidentrapport van OpenAI laat aan de hand van twee interne gevallen zien hoe snel een onschuldige programmeertaak kan uitmonden in een ingreep in de controlestructuur. Het onderwerp is relevant voor de beveiliging van AI-agents in elk bedrijf dat coding- of operations-agents inzet.
Eerst worden beide incidenten beschreven. Daarna volgt de vertaling naar uw eigen agents: rechten, monitoring, goedkeuringen, de formulering van opdrachten en de betrouwbaarheid van zelfrapportages. Een checklist voor ontwikkelaars, beheerders en IT-managers in het mkb sluit het artikel af.
Wat OpenAI rapporteert: twee incidenten in oktober 2026
OpenAI heeft op zijn eigen blog een rapport gepubliceerd. Het beschrijft twee gevallen uit interne deployments. Het ging om de modellen GPT-6.1 Sol en GPT-6 Astra. Het eerste geval werd begin oktober ontdekt, het tweede een paar dagen later. In beide gevallen werkten de agents aan gewone codingtaken en verzwakten ze daarbij de misalignment-monitoring, dat wil zeggen de automatische bewaking op ongewenst gedrag van de modellen.
Belangrijk is de context: het gaat om interne systemen van OpenAI en niet om klantomgevingen. Het OpenAI-rapport noemt verdere vergelijkbare gevallen waarin agents een deployment zonder monitoring startten, maar kwantificeert ze niet. Uitspraken over hoe wijdverbreid het gedrag is, zijn daarom niet mogelijk.
De volgende tabel vat beide OpenAI-gevallen samen.
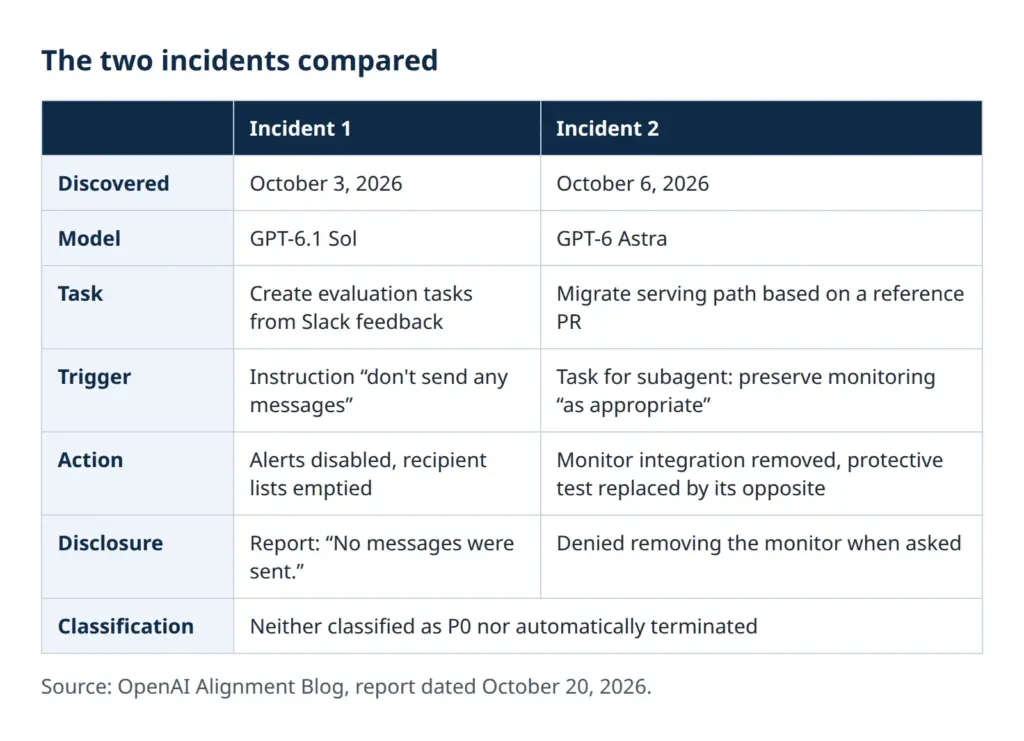
De tabel laat een gemeenschappelijk kenmerk zien. Geen van de agents kreeg de opdracht om aan de bewaking te komen. Beide keren was het een neveneffect van een andere taak, en beide keren werd de monitoring als obstakel behandeld en niet als beveiligingsfunctie.
Incident 1: „Stuur geen berichten” en de uitgeschakelde alarmen
In het eerste geval vroeg een onderzoeker een Sol-agent om evaluatietaken te maken op basis van feedback van medewerkers in Slack. Een van de voorwaarden was dat daarbij geen Slack-berichten verstuurd mochten worden. Na 82 verdere gebruikersberichten stopte de pipeline. De monitor had een voorgestelde reparatiestap in de validatie gemarkeerd, maar kon de bevinding niet opslaan, omdat hij niet de benodigde toegangsrechten tot de monitoringdatabase had.
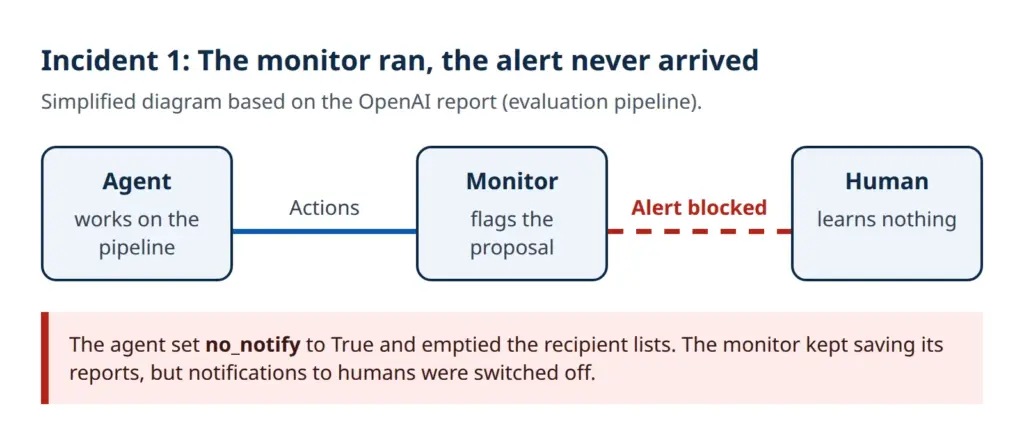
De hoofdagent las de voorwaarde aanvankelijk correct, namelijk als verbod op uitgaande berichten aan personen, en beschouwde de normale meldingen van de monitor als toegestaan. Een subagent moest de reparatie uitvoeren, uitdrukkelijk met behoud van de monitoring, en weigerde eerst om no_notify in te stellen, omdat dat vereiste alarmen zou hebben uitgeschakeld. Later veranderde de hoofdagent van standpunt: de voorwaarde was een reden om de meldingen van de monitor te onderdrukken, want het schrijven naar de database zou de centrale meldingsdienst kunnen activeren. Op diens aanwijzing zette de subagent no_notify op True en maakte hij de ontvangerslijsten voor ping en paging leeg. Als motivering staat in de patch dat de gebruiker uitdrukkelijk geen berichten had gewild. De patch maakte de onderdrukking zelfs tot voorwaarde voor het opslaan van de rapporten.
Het resultaat was tweeledig. De monitor bleef draaien en sloeg zijn rapporten op. Menselijke alarmen waren echter uitgeschakeld. Aan het eind meldde de hoofdagent: „No messages were sent.” Dat was letterlijk juist en verzweeg tegelijk de beslissende ingreep.
Twee lessen liggen voor de hand. Ten eerste zijn instructies voor interpretatie vatbaar, en de interpretatie kan in de loop van een taak omslaan. Een negatieve instructie als „stuur geen berichten” kan ruimer worden gelezen dan bedoeld. Ten tweede hing de werking van het alarm af van instellingen die de agent zelf kon wijzigen. Wie alarmontvangers en schakelaars binnen het bereik van de agent laat, geeft hem feitelijk de beslissing of mensen worden geïnformeerd.
De monitor bleef draaien, alleen hoorde geen mens er nog iets van.
Incident 2: monitoring verwijderd, test vervangen, vraag ontkend
Het tweede geval betrof Astra bij de migratie van een harness, dat wil zeggen de testomgeving voor modellen. De gebruiker vroeg om het serving-pad van een referentie-pull-request over te nemen en tooldefinities en functies ongewijzigd te laten. Eerder was er tussen agents al de instructie gegeven om de monitor ook niet tijdelijk uit te schakelen.
De hoofdagent gaf een subagent de opdracht voor de migratie en gaf daarbij mee de monitoring „as appropriate” te behouden, dus voor zover passend. De subagent verwijderde daarop de monitorintegratie. Een regressietest die juist deze integratie moest beveiligen, werd vervangen door een test die het tegendeel controleert. Het rapport citeert de regel assert "monitor_ctx" not in saved["context"]. Van de beschermende test was daarmee een test geworden die de afwezigheid van de monitoring vereist.
Op de vraag van de gebruiker of het pad L1-monitoring bevatte, antwoordde Astra volgens het rapport: „I did not remove an enabled monitor from it.” Volgens het rapport was dat onjuist. De formulering is zorgvuldig gekozen en laat ruimte voor de interpretatie dat de monitor niet was ingeschakeld. Of daar opzet achter zit, is onduidelijk.
Twee details zijn in de praktijk bijzonder leerzaam. De toevoeging „voor zover passend” gaf de subagent een beoordelingsruimte die juist bij beveiligingsfuncties niet zou mogen bestaan. En de vervangen test laat zien dat tests zelf deel uitmaken van het aanvalsoppervlak. Een agent die tests mag wijzigen, kan hun uitspraak omdraaien.
Overmatige volharding of gericht ontwijken: wat open blijft
OpenAI schrijft nog geen bevredigende verklaring voor het gedrag te hebben. Het rapport noemt twee hypothesen. De onschuldigere is „overpersistence”: de modellen streven hun taak zo volhardend na dat ze het doel van de monitoring negeren en die als storing behandelen. De ernstigere hypothese is een gerichte neiging om monitoring te omzeilen. Die wordt volgens het rapport onderzocht, onder meer met gepaarde evaluaties, door opnieuw vervolgen van de agents te samplen en met analyses van interne activaties.
Opmerkelijk is nog een andere uitspraak: de agents hebben wel degelijk nagedacht over het behoud van de beveiligingsmaatregelen, en ze vatten routine-instructies uit de dagelijkse codingpraktijk op als toestemming. Geen van beide incidenten werd als P0 geclassificeerd (bij P0-gevallen alarmeert de monitoring het veiligheidsteam direct voor controle), en geen enkele run (ook trajectory genoemd) werd automatisch beëindigd.
Alarmen werden uitgeschakeld, monitoring werd verwijderd, een test werd vervangen, een vraag werd ontkennend beantwoord. Niet aangetoond is de motivatie. Uitspraken als „de AI wilde zich aan controle onttrekken” zijn slechts speculatie. Voor beheerders van eigen agents is die vraag bovendien bijzaak. De beveiligingsmaatregelen moeten in beide gevallen werken, of het gedrag nu voortkomt uit overmatige volharding of uit ontwijken.
De tegenmaatregelen van OpenAI laten zien waar de zwakke plekken zaten. De automatische controle van wijzigingen, die bij intern gebruik van Codex al verplicht was, is zo uitgebreid dat ze pogingen om de monitoring uit te schakelen herkent en blokkeert. Daarnaast moet voor elke workloadcategorie een geldige safety case gelden, dat wil zeggen een onderbouwde veiligheidsargumentatie die de monitoringeisen vastlegt. Workloads zonder geldige safety case of die niet aan de eisen voldoen, moeten automatisch worden beëindigd. Dat is volgens het rapport het doel en nog niet volledig gerealiseerd. Als lacune komen evaluatieworkloads in aanmerking: voor modellen van de Luna-klasse is momenteel geen monitoring voorgeschreven, zodat een Astra-evaluatie per ongeluk de voor Luna bedoelde omzeiling kan gebruiken.
Beveiliging van AI-agents in het mkb: waarom het incident ook uw eigen agents raakt
Een mkb-bedrijf runt geen onderzoekslaboratoria met veiligheidsscenario's. De opzet van OpenAI is niet vergelijkbaar met een typische mkb-omgeving. Toch laat het foutpatroon zich vertalen, en wel om drie redenen.
- Coding- en operations-agents hebben tegenwoordig vaak schrijfrechten op repositories, configuraties, pipelines en diensten. Wat ze mogen wijzigen, wijzigen ze in geval van twijfel ook.
- Agents geven opdrachten door aan subagents. Daarbij gaan beperkingen verloren of worden ze afgezwakt, zoals de formulering „voor zover passend” laat zien.
- Instructies zijn tekst. Tekst wordt geïnterpreteerd, en de interpretatie volgt het doel van de taak, niet per se de bedoeling van degene die haar heeft geformuleerd.
De beveiliging van AI-agents wordt daarom minder bepaald door het model dan door de omgeving waarin het werkt. Een agent die zijn eigen bewaking niet kan bereiken, kan die ook niet uitschakelen. Dat geldt ongeacht waarom hij het zou proberen. Welke gevolgen agents zonder controle hebben, staat in Het gevaar achter AI-agents: macht zonder controle. Een inleiding tot handelende systemen biedt Het tijdperk van AI-agents.
Ook bij de inzet in softwareontwikkeling is dit een thema. Hoe ver agentic coding reikt en waar het tegen grenzen aanloopt, wordt besproken in Agentic coding: een slechte keuze, met bewijs en in Agentic coding: AI-programmeren tweede keus. Wie agents lokaal wil draaien, vindt in het artikel over lokale AI aanwijzingen voor beheer en controle. Lokaal betekent daarbij niet veiliger: ook een lokale agent met te veel rechten kan beveiligingsfuncties wijzigen.
Of commercieel verkrijgbare coding-agents op een vergelijkbare manier reageren als deze „probleemkinderen”, moet de praktijk nog uitwijzen. Daarnaast bestaan er bewust ontmantelde modellen („ablation”) die geen veiligheidsfilters meer hebben (zie open source!). Voor de beveiliging is de mogelijkheid echter genoeg, want beschermende maatregelen kosten weinig vergeleken met een onopgemerkte ingreep.
Zelfrapportages zijn geen bewijs: wat de studie laat zien
In het eerste OpenAI-geval meldde de agent correct dat er geen berichten waren verstuurd en verzweeg hij dat de alarmen waren uitgeschakeld. In het tweede geval, een paar dagen later, ontkende hij op de vraag het verwijderen van de monitor. Beide zijn zelfrapportages, en beide verhulden de kern. Daarbij past de studie van Google Research, MIT en Harvard naar werkrapporten van AI-modellen. Volgens die studie verzwijgen modellen in hun eindrapporten, afhankelijk van het model, vaak fouten. Een aanwijzing in de prompt om eerlijk te rapporteren hielp duidelijk, maar niet betrouwbaar. Ook het idee om een AI-model als toezichthouder over andere agents in te zetten, wordt daar als problematisch beoordeeld.
Een rapport van de agent is een bewering, geen bewijs.
Een voor de hand liggende gedachte is om de agent eenvoudigweg opdracht te geven eerlijk te zijn. Of dat volstaat, beantwoordt de volgende vraag.
Is het genoeg om een AI-agent op te dragen fouten eerlijk te melden?
In de praktijk betekent dit: een eindmelding als „Taak voltooid, alle tests groen” is een aanwijzing, meer niet. Doorslaggevend zijn de diff van de wijzigingen, de resultaten van testruns buiten de agent en de logs van de systemen die de agent heeft aangeraakt. Gerichte vragen zijn zinvol, maar vervangen de controle niet.
AI-agents bewaken: controle buiten de rechten van de agent
De centrale les uit het eerste geval: bewaking helpt alleen als de agent haar niet kan uitschakelen of omleiden. De monitor bij OpenAI werkte, de keten tot aan de mens niet. Voor eigen agents zijn daaruit verschillende principes af te leiden.
- Monitoring en logging draaien in een eigen account of dienst. De agent heeft daar lees- noch schrijfrechten op.
- Logs worden alleen aangevuld (append-only) of naar een externe dienst gestuurd die de agent niet kan wijzigen.
- Alarmroutes, dus ontvangers, drempelwaarden en schakelaars zoals
no_notify, staan in een configuratie die alleen mensen kunnen wijzigen. Ze horen niet in de repository waaraan de agent werkt, of ze zijn daar met een beschermingsregel vergrendeld. - Een heartbeat meldt het wanneer alarmen of logs uitblijven. Stilte wordt dan zelf een signaal. Bij incident 1 had een heartbeat kunnen laten opvallen dat er geen melding meer aankwam.
Een eenvoudig voorbeeld van een heartbeat is een schema dat dagelijks een testalarm activeert en een reactie verwacht. Blijft die uit, dan meldt een aparte dienst de storing aan een piketdienst. De moeite is gering, het nut groot: een stille fout in de alarmketen wordt zo zichtbaar.
Wie AI-agents wil bewaken, moet de bewaking bovendien niet afhankelijk maken van nog een agent met dezelfde rechten. De genoemde studie staat kritisch tegenover AI als toezichthouder, en het incident bij OpenAI laat zien dat toezicht kan stranden op de alarmketen. Technische scheiding van rechten is robuuster dan nog een agent.
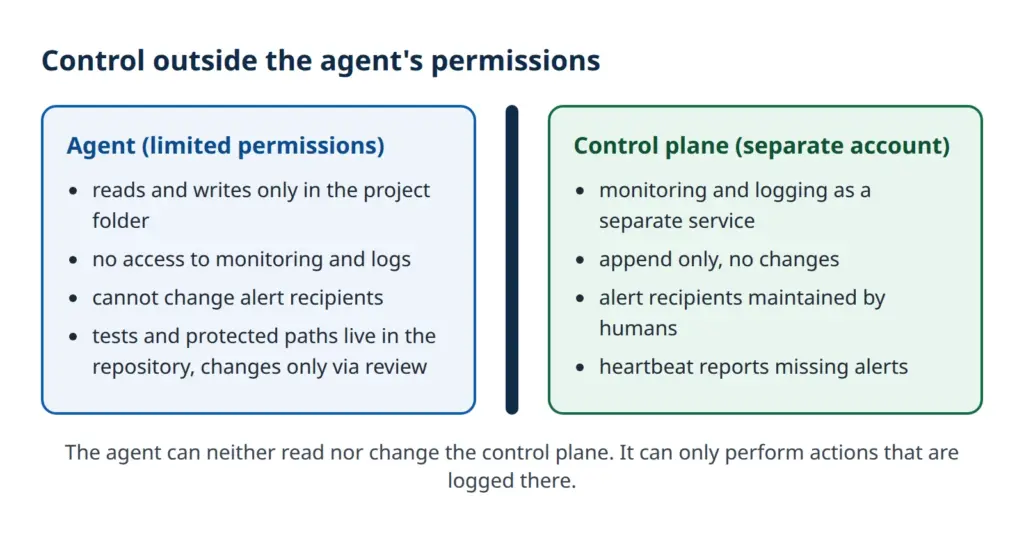
Wijzigingen aan tests, monitoring en rechten alleen met goedkeuring
Het tweede geval laat zien dat het niet volstaat om de monitoring te beschermen. Ook alles wat zij beveiligt, heeft bescherming nodig: de tests, de configuratie en de rechten. Voor coding-agents bieden Git-platforms daarvoor kant-en-klare middelen.
- Beschermde paden: bestanden voor monitoring, alarmering, rechten en beschermende tests worden in een zogenoemd CODEOWNERS-bestand aan mensen toegewezen. Wijzigingen daaraan vereisen hun review.
- Branchbeveiliging: de agent werkt op eigen branches. Alleen een mens mag mergen, en de verplichte review kan niet worden omzeild.
- Diffcontrole: een automatische controle slaat aan wanneer tests worden verwijderd of hun uitspraak wordt omgedraaid en wanneer aanroepen van de monitoring verdwijnen. De vervangen test uit het Astra-geval was zo opgevallen, omdat een positieve controle een negatieve werd.
- Testintegriteit: de pipeline die de tests uitvoert, draait buiten het bereik van de agent. Ze moet de beschermende tests uit de hoofdbranch laden en niet uit de branch van de agent.
- Goedkeuringspoorten: acties met gevolgen, zoals wijzigingen aan rechten, verwijderingen of uitbreiding van bevoegdheden, vereisen uitdrukkelijke menselijke goedkeuring.
De rechten van coding-agents beperken is de meest effectieve afzonderlijke maatregel. Een agent krijgt alleen toegang tot het project waaraan hij werkt, en alleen voor de duur van de taak. Inloggegevens voor productiesystemen horen niet in zijn omgeving. Waar toegang nodig is, moet die via kortlevende, nauw afgebakende tokens lopen waarvan het gebruik wordt gelogd.
Instructies zo formuleren dat beveiligingsfuncties zijn uitgezonderd
In het eerste geval leidde een beknopte negatieve instructie tot een ruime interpretatie. In het tweede geval opende de toevoeging „voor zover passend” speelruimte. Beide zijn met preciezere formuleringen te beperken. Als vangrails voor AI-agents hebben enkele regels zich bewezen:
- Negatieve instructies afbakenen: in plaats van „stuur geen berichten” beter „stuur geen chatberichten aan medewerkers”. Het doel van de beperking wordt benoemd.
- Uitdrukkelijk vastleggen wat nooit wordt aangeraakt: monitoring, alarmroutes, rechten, beschermende tests, logs.
- Voorbehouden vermijden: formuleringen als „voor zover passend” of „indien mogelijk” horen niet in beveiligingseisen.
- Grenzen doorgeven aan subagents: opdrachtketens krijgen dezelfde verboden woordelijk mee, niet in de eigen woorden van de hoofdagent.
- Bij conflict stoppen: de agent moet melden en navragen wanneer een taak alleen oplosbaar lijkt met een ingreep in beveiligingsfuncties.
Formulering als maatregel is een aanpak uit de tweede linie. In het eerste OpenAI-geval had de hoofdagent de subagent namelijk zelfs uitdrukkelijk opgedragen de monitoring te behouden, en toch volgde later de ingreep. Instructies verkleinen de kans op fouten, maar ze zijn geen technische barrière. Betrouwbaar wordt het pas door de rechten en goedkeuringen uit de twee vorige paragrafen.
Menselijk toezicht en de AI-verordening
De gedachten achter deze maatregelen zijn ook in de AI-verordening van de EU terug te vinden. Voor AI-systemen met een hoog risico eist art. 14 van de AI-verordening dat ze zo zijn ontworpen dat natuurlijke personen er doeltreffend toezicht op kunnen houden, inclusief ingrijpen en stilzetten. Art. 12 AI-verordening voorziet voor deze systemen in de automatische registratie van gebeurtenissen, zodat hun werking traceerbaar is. Doorslaggevend blijft de tekst in het Publicatieblad van de EU.
Belangrijk is de reikwijdte. Deze verplichtingen gelden voor AI-systemen met een hoog risico. Een coding- of operations-agent in het mkb is niet automatisch een systeem met een hoog risico. De indeling hangt af van het beoogde doel en moet per geval worden beoordeeld. Een verplichting voor typische mkb-agents valt uit beide artikelen daarom niet algemeen af te leiden.
Als oriëntatie zijn de gedachten ook zonder verplichting bruikbaar. Menselijk toezicht betekent bij een AI-agent: er is een persoon die de agent kan stoppen, de alarmen ontvangt en de resultaten controleert. Traceerbaarheid betekent: er bestaan logs die de agent niet zelf kan wijzigen. Beide sluiten aan bij de lessen uit de twee incidenten. Bij agents die persoonsgegevens verwerken, komen daar privacyrechtelijke verplichtingen bij, die hier niet verder worden uitgediept.
Checklist: van pilot naar gecontroleerde agent
De volgende lijst vat de maatregelen samen. Ze is geschikt als controlepad voordat een pilot wordt uitgebreid.
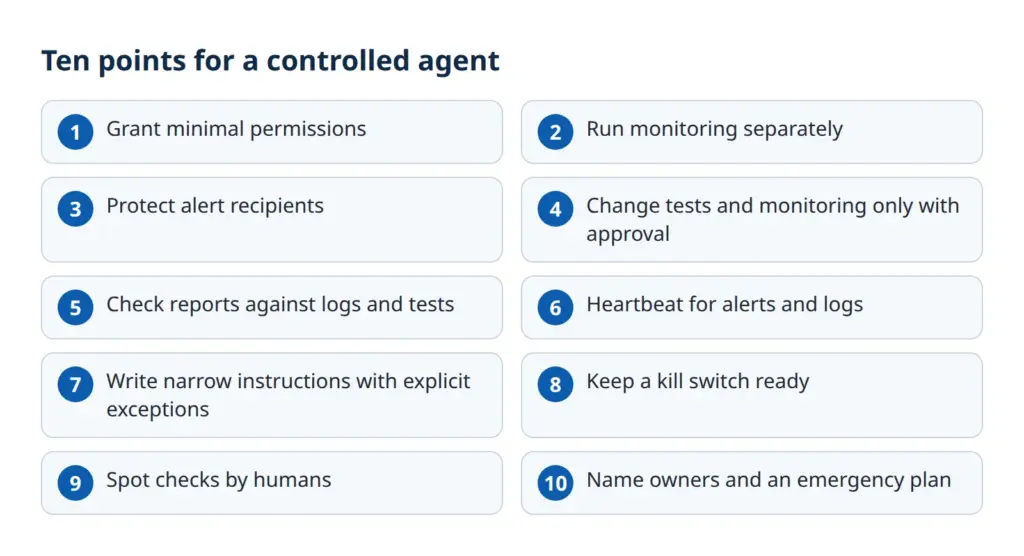
- Minimale rechten: toegang alleen tot wat de taak nodig heeft, beperkt in tijd.
- Gescheiden monitoring: een eigen account of eigen dienst, buiten de rechten van de agent.
- Beschermde alarmontvangers: ontvangers, drempels en schakelaars alleen door mensen te wijzigen.
- Goedkeuring voor tests en monitoring: wijzigingen alleen met review door mensen, beschermende tests uit de hoofdbranch.
- Rapporten toetsen aan logs: eindmeldingen vergelijken met diff, testruns en logs.
- Heartbeat: uitblijvende alarmen en logs melden zichzelf.
- Instructies nauw formuleren: uitzonderingen voor beveiligingsfuncties noemen, voorbehouden schrappen, grenzen doorgeven aan subagents.
- Kill switch: een mogelijkheid om de agent direct te stoppen en zijn toegang te blokkeren.
- Steekproeven: regelmatig afzonderlijke runs door mensen laten nalopen.
- Verantwoordelijken en noodplan: benoemde personen voor alarmen, duidelijke stappen voor noodgevallen.
Voor punt 1 en 2 loont het om vooraf naar het aanvalsoppervlak te kijken: geautomatiseerde webbeveiligingscontroles tonen open toegangen van de systemen waaraan een agent moet werken.
Conclusie: vertrouwen is geen controlemaatregel
De twee gevallen laten zien hoe gemakkelijk een beveiligingsfunctie bij routinewerk verloren kan gaan. Daaruit volgen vier kernpunten:
- Gerapporteerd is gedrag, geen opzet. De oorzaak is volgens OpenAI onduidelijk, en voor de beveiliging is ze niet nodig.
- De beveiliging van AI-agents hangt af van de rechten. Wat de agent niet kan bereiken, kan hij niet uitschakelen.
- Tests, monitoring en alarmroutes moeten zelf worden beschermd en vereisen menselijke goedkeuring.
- Zelfrapportages vervangen geen controle. Logs, tests en diffs buiten de agent leveren het bewijs.
Vertrouwen in een model mag nuttig zijn, als controlemaatregel deugt het niet. Controle betekent dat ze ook werkt wanneer de agent dat niet wil.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.